桌面上的 816B:Muse Spark Open 真正带来了什么
Meta 的开放权重模型进入高内存 Mac。比较双 Studio 展示与较小的量化检查点,观看实际演示,并选择合适的入门配置。
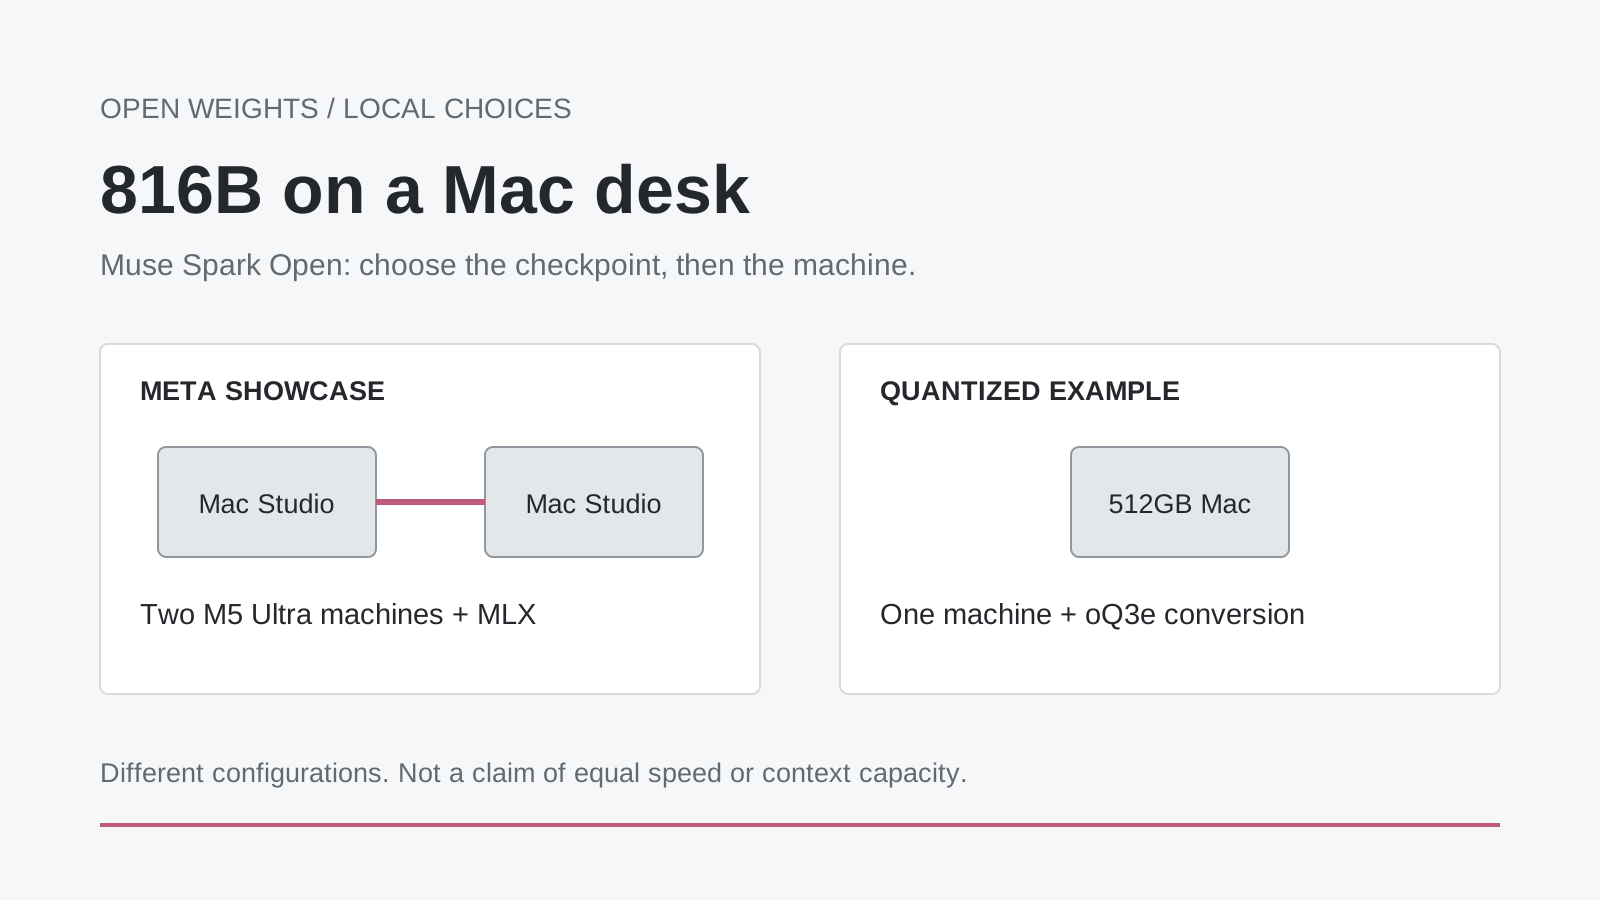
原创说明性插图。双机展示和单机量化示例采用不同配置,不能互相当作性能结果。
在桌面上运行一个 816-billion-parameter 模型,听起来像是自相矛盾。不过,Meta 在 October 15 的公告所展示的桌面上放着两台 Mac Studios,每台都配有非常大的内存。这与在你现有的笔记本电脑上运行同一个模型,是完全不同的设想。
更值得关注的进展就在这个标题之下。Muse Spark Open 向开发者开放模型权重,周边工具也提供了多种运行方式。Meta 展示了双机配置;Hugging Face 还介绍了在一台 512GB Mac 上运行经过更激进量化的版本。本地 AI 的关键,正逐渐从模型是否理论上可以下载,转向选择合适的表示方式和运行边界。
本指南将说明模型能做什么、内存数字为何不同、哪些已发布演示值得一看,以及如何迈出有用的第一步,避免不小心启动一个数百 GB 的下载。目标不是让每位读者都去购买工作站,而是更清楚地权衡本地设备、较小模型和托管服务。
突破在于获得模型,而不是让所有笔记本都升级
Meta 于 2026年10月15日 发布 Muse Spark Open,称其为一个拥有 816B 参数、每个 token 约有 42B 参数处于激活状态、上下文窗口最长可达 one million tokens 的 mixture-of-experts 模型。该版本面向编程和长时间工具调用任务。它的权重可以通过多个推理引擎部署,不必使用某一个指定的聊天应用。
这改变了谁能决定如何部署。开发者可以选择检查点、运行合适的服务栈、集成工具,并决定应用把信息发送到哪里。当项目需要可复现的模型版本或特定的数据处理安排时,这些选择很重要。但它们也带来了托管聊天订阅通常替你隐藏的责任:存储、升级、兼容性、监控和恢复。
我们的看法是,这显著扩大了选择空间,却没有让基础设施消失。拥有权重就像拥有一台发动机:你可以据此打造不同的车辆,但刹车、维修车间和道路仍然要自己准备。真正有用的问题是,你愿意维护这辆车的哪些部分。
对业余项目来说,维护这些东西本身可能就是乐趣。对需要在会议开始前得到答案的小企业来说,它可能是无谓的分心。面对同一项发布,两种选择都合理。开放权重模型把决定权交给你,却不会替你做决定。
42B 个激活参数,不会让 816B 变成小型下载
Mixture-of-experts 模型会为每个 token 只选择部分专家容量。这解释了激活参数为何远少于总参数,却不意味着普通的全模型部署可以直接省略未使用的专家:下一个 token 可能需要模型中的另一条路径。
把三种预算分开看会更清楚。第一种是检查点的存储空间;第二种是权重和运行时所需的工作内存;第三种是随工作负载增长的额外状态,包括注意力缓存和多模态输入。通过第一项检查,不代表另外两项也能装得下。
官方模型卡列出文本、图像、视频和音频输入,以及文本输出。它还列出了不同的检查点格式和可观的内存需求。这些是完整模型系列的规格,并不保证每个转换后的检查点都包含全部编码器,也不保证每台机器都能达到最长上下文。
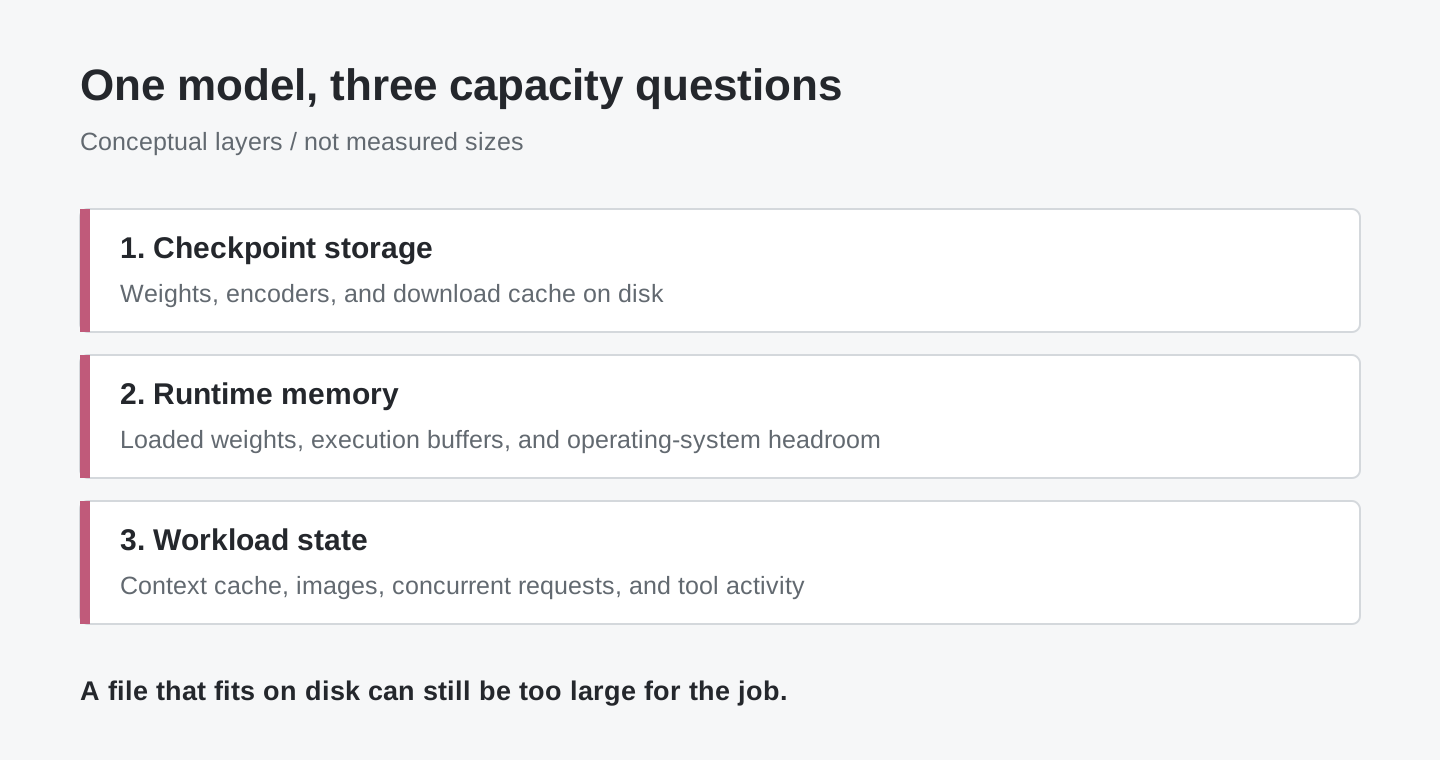
原创概念图。色带表示不同类型的内存用途,不代表实测比例。仅凭检查点大小,无法估算整台机器的容量。
视频尤其能体现这一差异。针对一张图像提出简短问题,与分析许多帧的长任务,并不会因为都使用具备视觉能力的模型就变成同一种请求。合适的首次实验应控制输入规模、限制回答长度,并先建立可用基线,再增加更大的素材库或更长的 agent 循环。
两台 Mac Studios 和一台 512GB Mac 展示的是不同路径
Meta 的展示使用两台 M5 Ultra Mac Studios 和 MLX。公告称每台机器最多有 512GB 统一内存,并展示了修改 Ice Cubes iOS 应用以及在 DaVinci Resolve 中编辑的本地工作流。这些是 Meta 的演示,不是我们桌面上的测量结果。在 Meta 的发布文章中查看配置和示例。
Hugging Face 的发布文章采用了另一条路径。文章介绍了在配备 512GB 内存的 M3 Ultra 上测试 oQ3e 量化检查点。对于 1,024-token prompt 和 128 个生成 token,作者报告 prefill 阶段约为 225 tokens per second,生成阶段为 21。该数字只对应那项短测试和那个检查点,不代表所有 Mac,也不代表双机展示。阅读工程文章中的 MLX 部分。
oQ3e 检查点卡提供了一个有用的单位校正:其 tensor 存储约为 344.152 GiB,也就是 369.531 GB。该卡在 oMLX 中将其描述为约 370GB。在内存余量至关重要时,笼统称作“344GB 模型”会混淆二进制单位和十进制单位。
| 已发布路径 | 展示的内容 | 不应据此推断 |
|---|---|---|
| Meta 的两台 M5 Ultra Mac Studios | 高内存本地部署和 agent 演示 | 所有 Muse 配置都恰好需要两台 Mac |
| Hugging Face 的 512GB M3 Ultra 与 oQ3e | 更激进量化的单机示例 | 普通 MacBook 有足够内存 |
| 托管推理 | 无需在本地维护完整检查点即可访问 | 任务必然在自己的电脑上完成 |
还有一条重要边界。oQ3e 转换版包含语言模型和视觉编码器,但不包含音频编码器。因此,使用完整模型的语音与浏览器演示,并不能证明同样的音频工作流适用于这个特定下载版本。模型名称不能代替阅读对应变体的模型卡。
oQ4e 卡让容量取舍更为明确。它列出的 tensor 存储约为 475.886GB,并警告这对于一台 512GB Mac 来说不足以保证可靠使用。更多比特可以保留不同的权重表示,却也会让实际任务剩余空间更少。把内存塞满,不等于把工作完成。
关注工具循环,而不只是最终答案
一个很有吸引力的用例,是让编程助手检查自己修改后的视觉效果。Hugging Face 的 3D 资产示例结合了量化模型、编程 agent、Three.js、浏览器渲染视图和视觉反馈。关键在这个循环:生成产物、查看产物、发现缺陷,再进行修正。
想象一下,用这种模式制作产品配置器原型。你希望 agent 能发现控件被遮挡或物体跑出摄像机画面,而不只是生成语法正确的代码。这是对该模式的示例性应用,并不表示演示已经提供可投入生产的配置器。验收标准仍由项目决定:控件正确、尺寸合适,并且在小屏幕上行为正常。
第二个示例是 Hugging Face 文章链接的 “Call your Browser”演示。它结合语音输入和浏览器视觉交互,根据描述搜索商品。工程文章中托管的演示展示了这一交互,但没有暗示只安装权重就能得到浏览器 agent。关联的 Space 可能需要访问权限;不要以为发布页的链接保证它是可公开运行的服务。尝试托管版本前,应查看其设置和数据处理方式,并使用非敏感示例。
第三个用例是检查你自己的文档和截图。例如,你可以让它比较一项书面要求与界面图片,并列出差异。这类任务能利用图像理解,却不必立即授予系统修改文件、发送消息或购买物品的权限。先从人类能够检查输入和建议答案的工作开始。
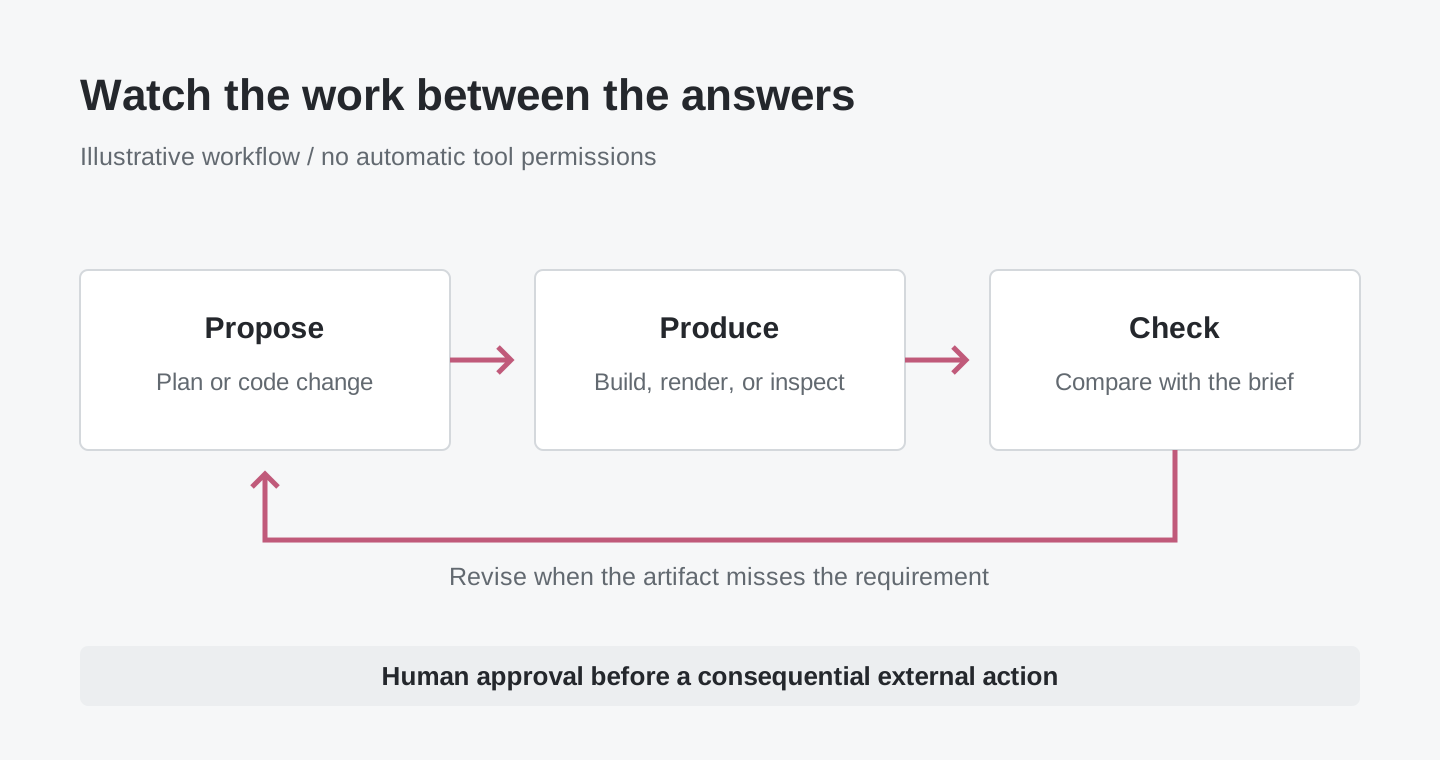
原创工作流插图。agent 框架及其工具提供操作循环;下载模型权重本身不会授予浏览器或文件系统访问权限。
对于这三种模式,都要寻找中间证据。代码任务是否通过编译?渲染页面是否符合要求?产品选择是否满足明确约束?一段润色精美的最终文字,不能代替任务原本要生成的产物。
在 Mac 上开始时,别把“下载”当作第一步
最容易犯的错误,就是先选最大模型,然后在下载到一半时才发现容量不够。把顺序倒过来:先决定一个小任务,找到受支持的检查点,再检查机器,最后才投入存储和时间。
- 检查 Mac 的内存和可用存储空间。 在 Terminal 中运行下列命令,可查看 macOS 版本、以字节表示的已安装内存,以及 home 卷的可用空间。它们不会安装软件或下载权重。
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
一起选择受支持的应用和检查点。 oMLX 项目提供 macOS 应用和安装文档。其文档列出的前提条件包括 Apple Silicon 和 macOS 15 或更高版本。写作时的最新版本是 v0.7.1rc1,这是一个 release candidate:请把实验工作与依赖它赶工期的工作站分开。
-
在模型下载界面中选择前,先阅读该转换版本的具体模型卡。 上述单机示例的标识符是
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e。除了检查点,还要为下载缓存、运行时和实际任务留出空间。256GB Mac 低于这个变体的已发布要求;把回复缩成一句话,也不能免除权重存储需求。 -
先做一个简短、可丢弃的任务。 尝试一个简短的文本问题,或一张不含敏感信息的截图,并要求简短回答。确认模型可以加载且结果有用后,再增加上下文或加入工具。成功加载只能证明兼容性,不能证明事实准确。
-
只在只读工作流正常后再添加操作。 在项目副本中工作。限制 agent 可以访问的文件和工具,并要求它在执行外部操作前先确认。让改动保持可审查,别让第一次实验修改你唯一的工作副本。
优先使用应用支持的下载和模型选择流程,不要照搬其他模型页面上的通用命令。MLX LM也提供命令行路径,但模型支持和打包版本的推进速度可能不同。选择版本时,可以参考其 Muse 支持 pull request了解兼容性;这并不意味着应该安装任意开发分支。
要了解模型是否有用,不必先购买硬件。托管端点可以帮助你确认它能否处理具有代表性的任务,再考虑本地部署。请先查看供应商价格、数据处理方式和支出控制。公开演示是学习材料,不是免费的生产后端。
衡量完成的任务,而不只是 token 计数器
Tokens per second 有助于描述推理配置,却无法告诉你助手是节省了一个下午,还是制造了一个隐蔽错误。特别是长时间运行的 agent 反复沿用错误假设时,回答更快但不正确,代价可能高于回答较慢但正确。
实际比较时,可以在候选配置上使用同一小组任务:包含一个带有现成测试的代码修改、一张已知有问题的截图,以及一个答案可以追溯到原文段落的文档问题。保持 prompt 和验收条件不变。然后记录正确性、得到审核结果所用的时间、所需人工介入程度,以及工具能够提供的峰值资源使用量。
把 prefill 和生成视为等待过程的不同部分。长输入可能让首个响应变慢,即使后续 token 输出很快。agent 还可能花时间编译、浏览或等待其他工具。比较本地配置与托管服务时,也要把这些时间算进去;即使它们不在模型内部,仍是用户实际体验的一部分。
重要的检查点或运行时更新之后,重复这项比较。你不需要构建大型 benchmark,才能发现更新破坏了日常工作流。稳定地检查少量代表性任务,比单张令人印象深刻的答案截图更有用。
开放权重带来选择,不会自动提供隐私或无限使用权
本地模型可以让推理留在你的机器上,但完整应用仍可能使用网页搜索、遥测、外部工具、远程存储或托管回退模型。在称其为私密之前,先画出实际工作流的数据路径。离线文本实验和浏览器购物 agent 的边界不同,即使两者使用同一个检查点。
Muse Model License也包含条件。它要求署名并附带使用政策,同时对某些 model-as-a-service 业务设有单独条款。这是一次采用自定义条款的开放权重发布,并不意味着所有用途都不受限制。对于计划的分发或服务,应检查当前许可证。
对团队而言,所有权既要有法律层面的答案,也要有运维层面的答案。谁批准新的模型版本?谁能恢复先前配置?prompt 和工具结果会流向哪里?变更到达客户之前由谁审核?这些问题不是反对本地推理的理由,而是让本地推理成为可靠服务、而非昙花一现演示的必要条件。
结论:本地 AI 正成为一种配置选择
真正的里程碑不是每台电脑现在都能运行庞大模型,而是用户能看到并决定更多部署选项:选择哪些权重、哪种转换、哪台机器、哪个运行时,以及哪些工具。
Muse Spark Open 让这种选择变得具体。两台高内存 Mac 展示了一种路径;较小的转换版本展示了另一种;托管推理则提供不同的取舍。选择能够可靠完成你关心任务的最小方案。下一个有用的问题不是“我能不能让它加载”,而是“我能不能信任它交付的工作结果”。
来源与演示
- Meta:Muse Spark Open 发布,2026年10月15日。
- Meta 模型卡与检查点规格。
- Hugging Face:运行时指南、MLX 测试条件与 agent 演示,2026年10月15日。
- oQ3e 转换版:存储单位、包含的编码器与用法。
- oQ4e 转换版:存储空间与单机警告。
- oMLX 安装文档和 v0.7.1rc1 发布页。
- MLX LM 的 Muse 支持。
- Muse Model License。
产品与兼容性信息截至 2026年10月16日 核查。上述性能数字均注明了发布方及其所述测试条件。
留下决策记录,而不只是模型名称
对于希望集中保存来源链接、配置记录和审核决定的读者,Telli.sh 是一个可选工作空间。创建研究笔记。