816B em uma mesa com Mac: o que o Muse Spark Open realmente possibilita
O modelo de pesos abertos da Meta chega aos Macs com muita memória. Compare a demonstração com dois Studio a um checkpoint quantizado menor, veja demos reais e escolha uma primeira configuração sensata.
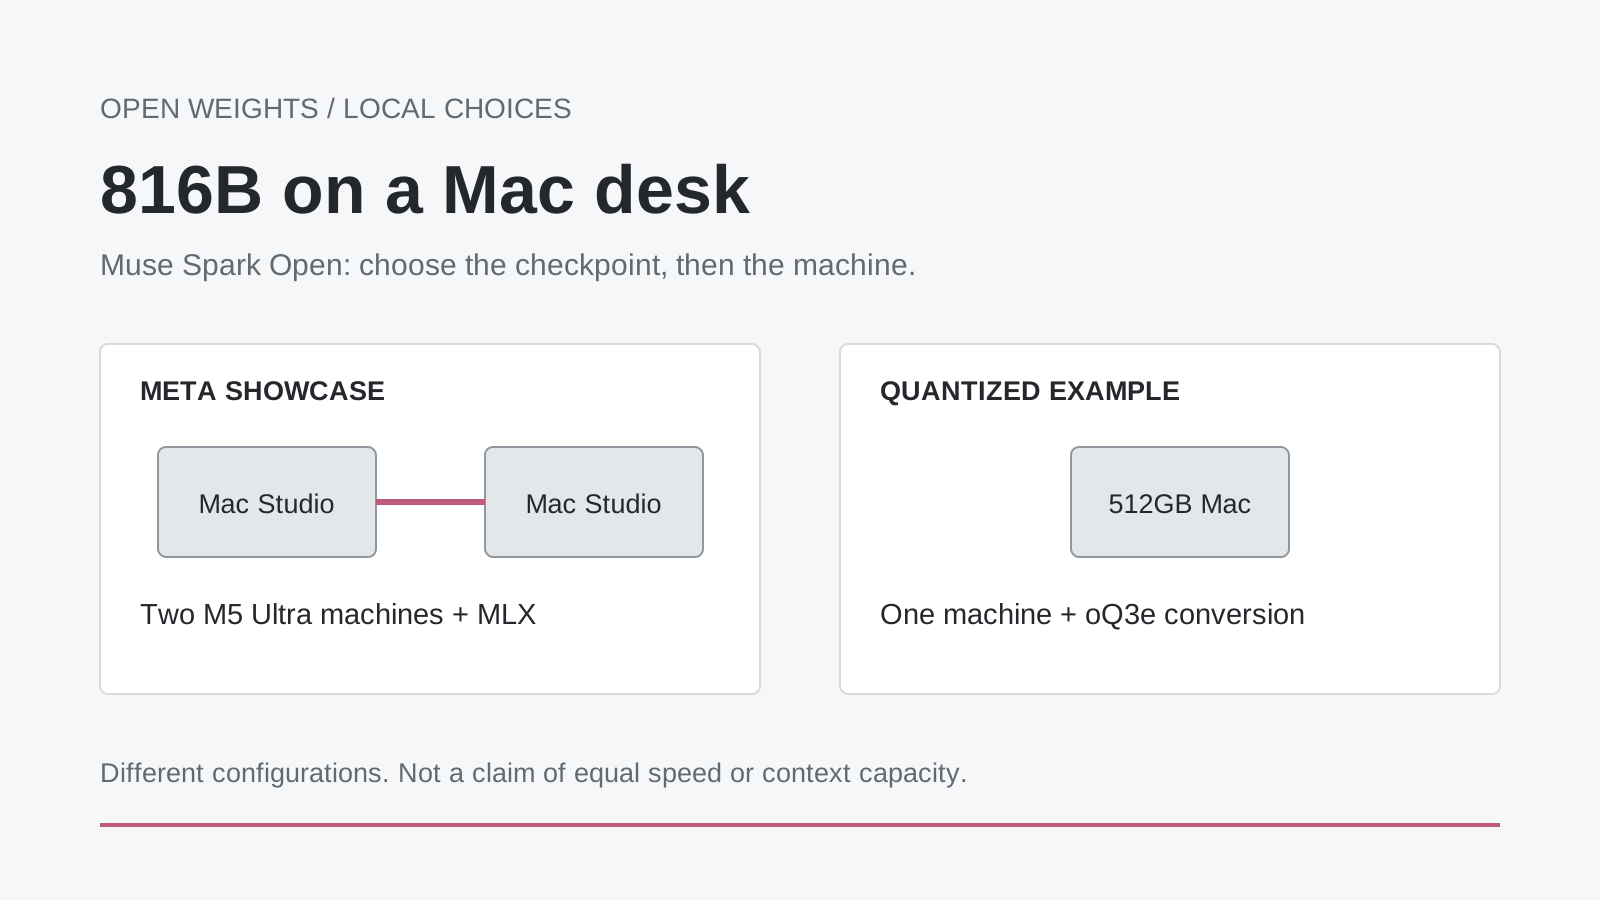
Ilustração explicativa original. A demonstração com duas máquinas e o exemplo quantizado em uma única máquina usam configurações diferentes; não são resultados de desempenho intercambiáveis.
Um modelo de 816 bilhões de parâmetros rodando em uma mesa parece uma contradição. A mesa do anúncio da Meta de 15 de outubro, porém, tem dois Mac Studios, cada um com uma enorme capacidade de memória. Isso é bem diferente de colocar o mesmo modelo no laptop que você já tem.
O desenvolvimento mais interessante está logo abaixo dessa manchete. O Muse Spark Open dá aos desenvolvedores acesso aos pesos do modelo, e as ferramentas ao redor oferecem várias maneiras de executá-lo. A Meta mostra uma configuração com duas máquinas; a Hugging Face também descreve uma versão mais quantizada em um único Mac de 512GB. A IA local está deixando de ser uma questão de saber se um modelo pode, em teoria, ser baixado e passando a envolver a escolha da representação e dos limites operacionais adequados.
Este guia explica o que o modelo pode fazer, por que os números de memória diferem, quais demonstrações publicadas vale a pena assistir e como dar um primeiro passo útil sem iniciar por engano um download de centenas de gigabytes. A meta não é transformar todo leitor em comprador de workstation. É deixar mais clara a escolha entre uma máquina local, um modelo menor e um serviço hospedado.
A novidade é o acesso ao modelo, não uma atualização universal de laptop
A Meta lançou o Muse Spark Open em 15 de outubro de 2026, descrevendo-o como um modelo mixture-of-experts de 816B parâmetros, com cerca de 42B parâmetros ativos por token e janela de contexto de até um milhão de tokens. O lançamento é voltado para programação e trabalhos prolongados com uso de ferramentas. Os pesos podem ser implantados por vários mecanismos de inferência, em vez de um único aplicativo de conversa obrigatório.
Isso muda quem pode tomar decisões de implantação. Um desenvolvedor pode escolher um checkpoint, executar uma stack de serving adequada, integrar ferramentas e decidir para onde o aplicativo envia informações. Essas escolhas podem ser importantes quando um projeto precisa de uma versão reproduzível do modelo ou de um arranjo específico para o tratamento de dados. Elas também criam responsabilidades que uma assinatura de chat gerenciado normalmente esconde: armazenamento, atualizações, compatibilidade, monitoramento e recuperação.
Nossa avaliação é que isso amplia significativamente as opções, não que a infraestrutura desapareceu. Ter os pesos é como ter um motor. Isso dá espaço para construir outro veículo, mas não fornece freios, oficina ou estrada. A pergunta útil é quais partes desse veículo você realmente quer manter.
Em um projeto de hobby, essa manutenção pode ser justamente o objetivo. Para uma pequena empresa que precisa de uma resposta antes de uma reunião, pode ser uma distração desnecessária. As duas reações são razoáveis diante do mesmo lançamento. Um modelo de pesos abertos torna a decisão possível; não a toma por você.
42B parâmetros ativos não transformam 816B em um download pequeno
Modelos mixture-of-experts selecionam apenas parte da capacidade dos especialistas para cada token. Isso ajuda a explicar por que a contagem de parâmetros ativos é muito menor que o total. Não significa que os especialistas não utilizados possam simplesmente ser omitidos em uma implantação normal do modelo completo: outro token pode precisar de um caminho diferente pelo modelo.
É útil separar três orçamentos. O primeiro é o armazenamento do checkpoint. O segundo é a memória de trabalho para os pesos e o runtime. O terceiro é o estado adicional que cresce com a carga, incluindo o cache de atenção e as entradas multimodais. Passar no primeiro teste não prova que os outros dois também cabem.
O cartão oficial do modelo lista entradas de texto, imagem, vídeo e áudio com saída de texto. Também lista diferentes formatos de checkpoint e requisitos substanciais de memória. São especificações para toda a família de modelos, não uma promessa de que todo checkpoint convertido inclua todos os encoders ou alcance o contexto máximo em qualquer máquina.
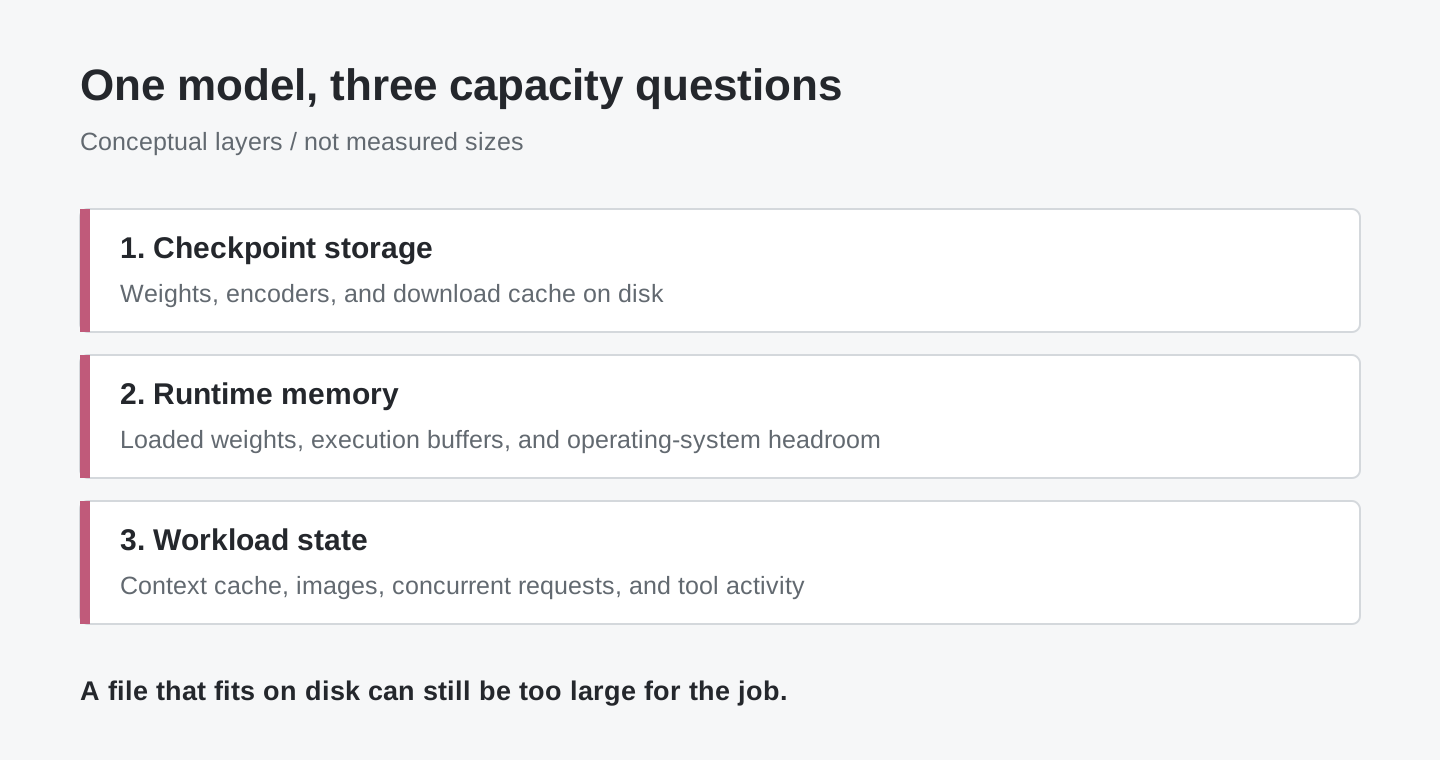
Diagrama conceitual original. As faixas identificam tipos de uso da memória, não proporções medidas. O tamanho do checkpoint, sozinho, não estima a capacidade necessária para toda a máquina.
Essa distinção é especialmente importante com vídeo. Uma pergunta curta sobre uma imagem e uma análise longa de muitos quadros não são a mesma solicitação só porque ambas usam um modelo com visão. Um primeiro experimento sensato mantém a entrada pequena, limita a resposta e estabelece uma base funcional antes de acrescentar um arquivo maior ou um ciclo mais longo de agente.
Dois Mac Studios e um Mac de 512GB contam histórias diferentes
A demonstração da Meta usa dois Mac Studios M5 Ultra e MLX. O anúncio descreve até 512GB de memória unificada por máquina e relata fluxos de trabalho locais envolvendo alterações no aplicativo iOS Ice Cubes e edição no DaVinci Resolve. Essas são demonstrações da Meta, não medições feitas na nossa mesa. Veja as configurações e os exemplos no post de lançamento da Meta.
O artigo de lançamento da Hugging Face segue outro caminho. Ele descreve testes de um checkpoint quantizado oQ3e em um M3 Ultra com 512GB de memória. Para um prompt de 1.024 tokens e 128 tokens gerados, seus autores relatam aproximadamente 225 tokens por segundo durante o prefill e 21 durante a geração. Esses números correspondem àquele teste curto e àquele checkpoint, não a todos os Macs nem à demonstração com duas máquinas. Leia a seção sobre MLX do artigo técnico.
O cartão do checkpoint oQ3e esclarece uma conversão importante de unidades: o armazenamento dos tensores é de cerca de 344.152 GiB, ou 369.531 GB. O cartão descreve aproximadamente 370GB no oMLX. Chamá-lo simplesmente de “modelo de 344GB” mistura unidades binárias e decimais justamente quando a memória restante importa.
| Caminho publicado | O que ilustra | O que não se deve concluir |
|---|---|---|
| Os dois Mac Studios M5 Ultra da Meta | Uma implantação local com muita memória e demonstrações de agentes | Que toda configuração do Muse exige exatamente dois Macs |
| M3 Ultra de 512GB da Hugging Face com oQ3e | Um exemplo mais quantizado em uma única máquina | Que um MacBook comum tenha memória suficiente |
| Inferência hospedada | Acesso sem manter o checkpoint completo localmente | Que o trabalho necessariamente permaneça no seu computador |
Há outro limite importante. A conversão oQ3e inclui o modelo de linguagem e o encoder de visão, mas não inclui o encoder de áudio. Portanto, uma demonstração de voz e navegador com o modelo completo não comprova que o mesmo fluxo de áudio funcione com esse download específico. O nome de um modelo não substitui a leitura do cartão da variante.
O cartão oQ4e deixa ainda mais explícita a troca de capacidade. Ele lista cerca de 475.886GB de armazenamento de tensores e alerta que isso é demais para uso confiável em um único Mac de 512GB. Mais bits podem preservar uma representação diferente dos pesos e, ao mesmo tempo, deixar menos espaço para o trabalho em si. Encher a memória não é o mesmo que concluir o trabalho.
Observe o ciclo das ferramentas, não apenas a resposta final
Um caso de uso atraente é um assistente de programação que consegue inspecionar a aparência das próprias alterações. O exemplo de recurso 3D da Hugging Face combina um modelo quantizado, um agente de programação, Three.js, visualizações renderizadas no navegador e feedback visual. A parte interessante é o ciclo: gerar um artefato, observá-lo, encontrar um defeito e revisá-lo.
Imagine usar esse padrão para criar um protótipo de configurador de produto. Você quer que o agente perceba um controle encoberto ou um objeto fora do enquadramento da câmera, não que apenas produza código sintaticamente válido. Esta é uma aplicação ilustrativa do padrão, não uma afirmação de que a demonstração já forneça um configurador pronto para produção. O teste de aceitação continua sendo responsabilidade do projeto: os controles certos, as dimensões certas e o comportamento adequado em uma tela pequena.
Um segundo exemplo é a demonstração “Call your Browser”, vinculada no artigo da Hugging Face. Ela combina entrada por voz com interação visual no navegador para procurar produtos que correspondam a uma descrição. A demonstração hospedada no artigo técnico mostra a interação sem insinuar que instalar os pesos, por si só, cria um agente de navegador. O Space vinculado pode exigir acesso; não suponha que o link da página de lançamento garanta um serviço público executável. Antes de experimentar uma versão hospedada, confira a configuração e o tratamento de dados e use exemplos não confidenciais.
Um terceiro caso de uso é um assistente para revisar seus documentos e capturas de tela. Por exemplo, você pode pedir que compare um requisito escrito com a imagem de uma interface e liste as discrepâncias. Essa tarefa se beneficia da compreensão de imagens sem dar imediatamente ao sistema permissão para alterar arquivos, enviar mensagens ou comprar algo. Comece com uma atividade em que uma pessoa possa inspecionar tanto a entrada quanto a resposta proposta.
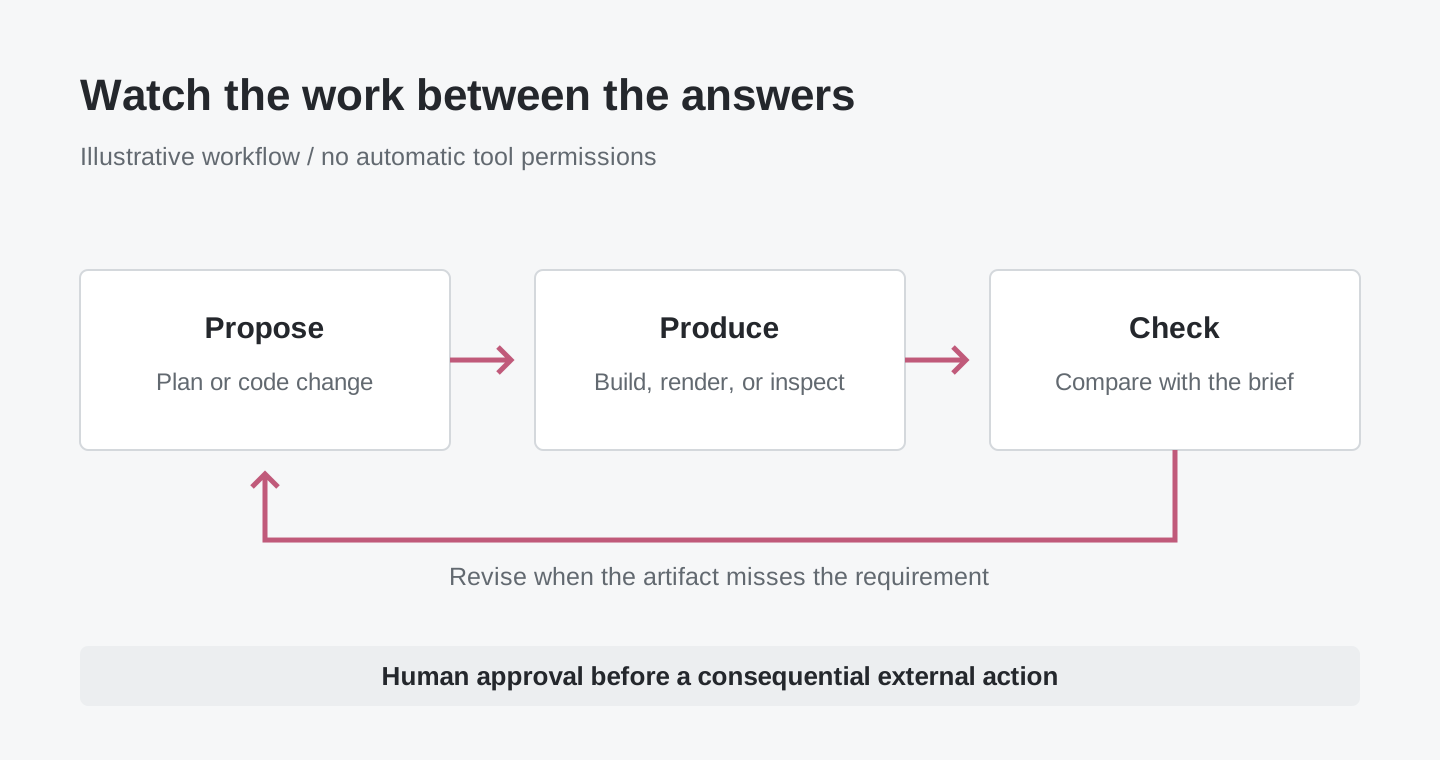
Ilustração original do fluxo de trabalho. Uma estrutura de agente e suas ferramentas fornecem o ciclo de ação; baixar os pesos do modelo não concede, por si só, acesso ao navegador ou ao sistema de arquivos.
Nos três padrões, procure evidências intermediárias. Uma tarefa de código compilou? A página renderizada corresponde ao requisito? Uma escolha de produto atende às restrições declaradas? Um parágrafo final bem escrito não substitui o artefato que a tarefa deveria criar.
Comece em um Mac sem tratar “download” como a primeira etapa
O erro mais fácil é escolher primeiro o maior modelo e descobrir o requisito de capacidade no meio do caminho. Inverta a ordem. Defina uma tarefa pequena, identifique um checkpoint compatível e confira a máquina antes de comprometer armazenamento ou tempo.
- Confira a memória e o armazenamento livre do Mac. No Terminal, os comandos abaixo exibem a versão do macOS, a memória instalada em bytes e o espaço livre no seu volume home. Eles não instalam software nem baixam pesos.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Escolha juntos um aplicativo e um checkpoint compatíveis. O projeto oMLX oferece um aplicativo para macOS e documentação de instalação. Os pré-requisitos documentados incluem Apple Silicon e macOS 15 ou posterior. Na data deste texto, a versão mais recente é v0.7.1rc1, uma release candidate: mantenha os experimentos separados de uma workstation da qual você depende para cumprir prazos.
-
Leia o cartão da conversão exata antes de selecioná-la na interface de download do modelo. Para o exemplo em uma única máquina acima, o identificador é
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Reserve espaço para o checkpoint, o cache de download, o runtime e o trabalho que você pretende fazer. Um Mac de 256GB fica abaixo do requisito publicado para essa variante; reduzir a resposta a uma frase não elimina o espaço necessário para armazenar os pesos. -
Comece com uma tarefa curta e descartável. Experimente uma pergunta textual simples ou uma captura de tela não confidencial com resposta breve. Confirme que o modelo carrega e que o resultado é útil antes de aumentar o contexto ou acrescentar ferramentas. Um carregamento bem-sucedido comprova compatibilidade, não precisão factual.
-
Acrescente ações somente depois que o fluxo somente de leitura funcionar. Trabalhe em uma cópia do projeto. Restrinja os arquivos e as ferramentas acessíveis ao agente e exija confirmação antes de qualquer ação externa. Mantenha as alterações revisáveis, em vez de permitir que o primeiro experimento modifique sua única cópia de trabalho.
Prefira o caminho de download e seleção de modelos compatível com o aplicativo a um comando genérico copiado da página de outro modelo. O MLX LM também oferece uma opção por linha de comando, mas o suporte a modelos e as versões empacotadas podem avançar em ritmos diferentes. O pull request de suporte ao Muse é uma referência útil de compatibilidade na hora de escolher uma versão, não um motivo para instalar um branch de desenvolvimento arbitrário.
Você não precisa comprar hardware para entender a utilidade do modelo. Um endpoint hospedado pode mostrar se ele lida com sua tarefa representativa antes que você investigue uma implantação local. Confira primeiro os preços, o tratamento de dados e os controles de gastos do provedor. Uma demonstração pública é um recurso de aprendizado, não um backend de produção gratuito.
Meça uma tarefa concluída, não apenas o contador de tokens
Tokens por segundo ajudam a descrever uma configuração de inferência. Não mostram se o assistente economizou uma tarde ou criou um erro sutil. Uma alteração errada feita mais rápido pode custar mais que uma correta e mais lenta, principalmente quando um agente de longa duração repete as próprias suposições equivocadas.
Uma comparação prática usa a mesma pequena coleção de tarefas em cada configuração candidata. Inclua uma alteração de código com um teste existente, uma captura de tela com um problema conhecido e uma pergunta sobre um documento cuja resposta possa ser rastreada até uma passagem. Mantenha o prompt e os critérios de aceitação estáveis. Em seguida, registre a correção, o tempo até um resultado revisado, a intervenção necessária e o pico de recursos, se suas ferramentas o mostrarem.
Trate prefill e geração como partes distintas da espera. Uma entrada longa pode deixar a primeira resposta lenta mesmo quando os tokens seguintes chegam rapidamente. Um agente também pode gastar tempo compilando, navegando ou esperando outra ferramenta. Conte esse tempo ao comparar uma configuração local com um serviço hospedado: ele faz parte da experiência do usuário mesmo quando ocorre fora do modelo.
Repita a comparação após uma atualização importante do checkpoint ou do runtime. Não é preciso um grande benchmark para descobrir que uma mudança prejudicou o fluxo de trabalho habitual. Algumas tarefas representativas, verificadas de forma consistente, são mais úteis do que uma captura de tela de uma única resposta impressionante.
Pesos abertos dão opções, não privacidade automática nem direitos ilimitados
Um modelo local pode manter a inferência na sua máquina. O aplicativo completo ainda pode usar pesquisa na web, telemetria, ferramentas externas, armazenamento remoto ou modelos de fallback hospedados. Mapeie o caminho dos dados do fluxo real antes de descrevê-lo como privado. Um experimento de texto offline e um agente de compras no navegador têm limites diferentes, mesmo quando começam pelo mesmo checkpoint.
A Muse Model License também tem condições. Ela exige atribuição e uma política de uso acompanhando o modelo, além de incluir termos separados para determinados negócios de model-as-a-service. Este é um lançamento personalizado de pesos abertos, não uma declaração geral de que todo uso é irrestrito. Confira a licença atual para a distribuição ou o serviço que você pretende oferecer.
Para uma equipe, a responsabilidade também deve incluir uma resposta operacional, além da jurídica. Quem aprova uma nova versão do modelo? Quem pode restaurar a configuração anterior? Para onde vão os prompts e os resultados das ferramentas? Quem revisa uma alteração antes que ela chegue ao cliente? Essas perguntas não são argumentos contra inferência local. São o que transforma a inferência local em um serviço confiável, em vez de uma demonstração de um dia.
Em resumo: a IA local está se tornando uma escolha de configuração
O verdadeiro marco não é que agora todo computador pode executar um modelo enorme. É que uma parte maior da decisão de implantação fica visível e disponível ao usuário: quais pesos, qual conversão, qual máquina, qual runtime e quais ferramentas.
O Muse Spark Open torna essa escolha concreta. Dois Macs com muita memória demonstram um caminho; uma conversão menor demonstra outro; a inferência hospedada oferece uma troca diferente. Escolha a configuração mais simples que conclua com confiabilidade a tarefa que importa para você. A próxima pergunta útil não é “Consigo carregá-lo?”, mas “Posso confiar no trabalho que recebo?”
Fontes e demonstrações
- Meta: lançamento do Muse Spark Open, 15 de outubro de 2026.
- Cartão do modelo e especificações dos checkpoints da Meta.
- Hugging Face: guia do runtime, condições do teste MLX e demonstrações de agentes, 15 de outubro de 2026.
- Conversão oQ3e: unidades de armazenamento, encoders incluídos e uso.
- Conversão oQ4e: armazenamento e alerta para uso em uma única máquina.
- Documentação de instalação do oMLX e versão v0.7.1rc1.
- Suporte ao Muse no MLX LM.
- Muse Model License.
Informações de produto e compatibilidade verificadas em 16 de outubro de 2026. Os números de desempenho são medições atribuídas aos editores e mantêm as condições de teste declaradas.
Guarde a decisão, não apenas o nome do modelo
Para quem reúne links de fontes, notas de configuração e decisões de revisão, o Telli.sh é um espaço de trabalho opcional. Crie uma nota de pesquisa.