816B auf dem Mac-Schreibtisch: Was Muse Spark Open wirklich ermöglicht
Metas Open-Weight-Modell erreicht Macs mit viel Arbeitsspeicher. Vergleichen Sie die Zwei-Studio-Demonstration mit einem kleineren quantisierten Checkpoint, sehen Sie echte Demos und wählen Sie einen sinnvollen Einstieg.
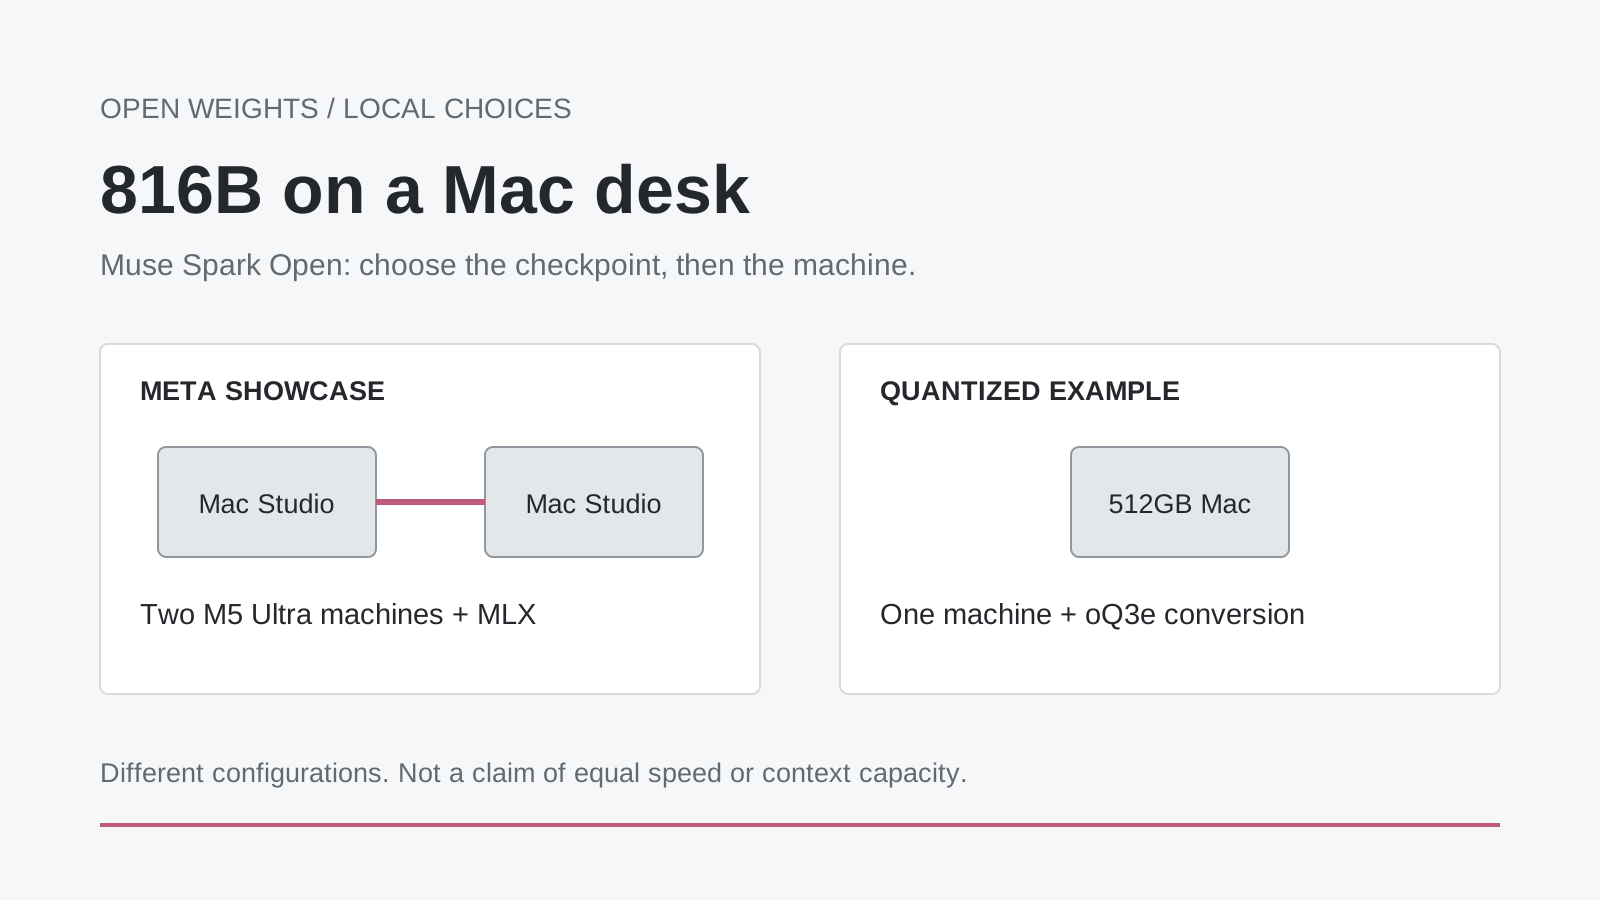
Originale erklärende Illustration. Die Demonstration mit zwei Rechnern und das quantisierte Beispiel auf einem einzelnen Rechner verwenden unterschiedliche Konfigurationen; ihre Leistungswerte sind nicht austauschbar.
Ein Modell mit 816 Milliarden Parametern auf einem Schreibtisch laufen zu lassen, klingt widersprüchlich. Auf dem Schreibtisch in Metas Ankündigung vom October 15 stehen jedoch zwei Mac Studios, jeweils mit einem sehr großen Arbeitsspeicher. Das ist etwas anderes, als dasselbe Modell auf dem Laptop auszuführen, den Sie bereits besitzen.
Die interessantere Entwicklung steckt knapp unterhalb dieser Schlagzeile. Muse Spark Open gibt Entwicklern Zugriff auf die Modellgewichte, und die verfügbaren Werkzeuge bieten mehrere Möglichkeiten, sie auszuführen. Meta zeigt eine Konfiguration mit zwei Rechnern; Hugging Face beschreibt außerdem eine stärker quantisierte Version auf einem einzelnen Mac mit 512GB. Bei lokaler KI geht es zunehmend weniger darum, ob ein Modell theoretisch heruntergeladen werden kann, sondern darum, die passende Darstellung und den passenden Betriebsrahmen zu wählen.
Dieser Leitfaden erklärt, was das Modell leisten kann, warum sich die Speicherangaben unterscheiden, welche veröffentlichten Demonstrationen sehenswert sind und wie Sie sinnvoll beginnen, ohne versehentlich einen Download von mehreren hundert Gigabyte zu starten. Nicht jeder Leser soll eine Workstation kaufen. Vielmehr soll die Entscheidung zwischen lokalem Rechner, kleinerem Modell und gehostetem Dienst klarer werden.
Der Durchbruch ist der Zugriff auf das Modell, kein allgemeines Laptop-Upgrade
Meta veröffentlichte Muse Spark Open am 15. Oktober 2026 und beschreibt es als Mixture-of-Experts-Modell mit 816B Parametern, ungefähr 42B pro Token aktiven Parametern und einem Kontextfenster von bis zu one million tokens. Die Veröffentlichung zielt auf Programmierung und längere Aufgaben mit Tool-Nutzung. Die Gewichte lassen sich mit mehreren Inferenz-Engines statt nur einer vorgeschriebenen Chat-Anwendung bereitstellen.
Dadurch können mehr Beteiligte über die Bereitstellung entscheiden. Entwickler können einen Checkpoint wählen, einen geeigneten Serving-Stack betreiben, Tools integrieren und festlegen, wohin die Anwendung Informationen sendet. Das kann wichtig sein, wenn ein Projekt eine reproduzierbare Modellversion oder einen bestimmten Umgang mit Daten benötigt. Gleichzeitig entstehen Verantwortlichkeiten, die ein verwaltetes Chat-Abo normalerweise verbirgt: Speicher, Updates, Kompatibilität, Monitoring und Wiederherstellung.
Unsere Einschätzung: Die Auswahl wird deutlich größer, aber Infrastruktur verschwindet dadurch nicht. Eigene Gewichte zu besitzen, ist wie einen Motor zu besitzen. Sie können damit ein anderes Fahrzeug bauen, aber Bremsen, Werkstatt und Straße sind nicht automatisch dabei. Die nützliche Frage lautet, welche Teile dieses Fahrzeugs Sie tatsächlich warten möchten.
Bei einem Hobbyprojekt kann genau diese Wartung der Reiz sein. Für ein kleines Unternehmen, das vor einem Meeting eine Antwort braucht, kann sie unnötig ablenken. Beides sind vernünftige Reaktionen auf dieselbe Veröffentlichung. Ein Modell mit offenen Gewichten macht die Entscheidung möglich, nimmt sie Ihnen aber nicht ab.
42B aktive Parameter machen aus 816B keinen kleinen Download
Mixture-of-Experts-Modelle wählen für jedes Token nur einen Teil ihrer Expertenkapazität aus. Das erklärt, warum die Zahl aktiver Parameter viel kleiner als die Gesamtzahl ist. Es bedeutet jedoch nicht, dass bei einer normalen Bereitstellung des vollständigen Modells die ungenutzten Experten einfach entfallen können: Ein anderes Token kann einen anderen Modellpfad benötigen.
Es hilft, drei Budgets auseinanderzuhalten. Erstens den Speicherplatz für den Checkpoint. Zweitens den Arbeitsspeicher für Gewichte und Laufzeit. Drittens den zusätzlichen, mit der Arbeitslast wachsenden Zustand, darunter Attention-Cache und multimodale Eingaben. Wer die erste Hürde nimmt, hat damit noch nicht bewiesen, dass auch die beiden anderen passen.
Die offizielle Modellkarte nennt Text-, Bild-, Video- und Audioeingaben mit Textausgabe. Sie führt auch unterschiedliche Checkpoint-Formate und beträchtliche Speicheranforderungen auf. Das sind Spezifikationen der gesamten Modellfamilie, keine Zusage, dass jeder konvertierte Checkpoint alle Encoder enthält oder auf jedem Rechner die maximale Kontextlänge erreicht.
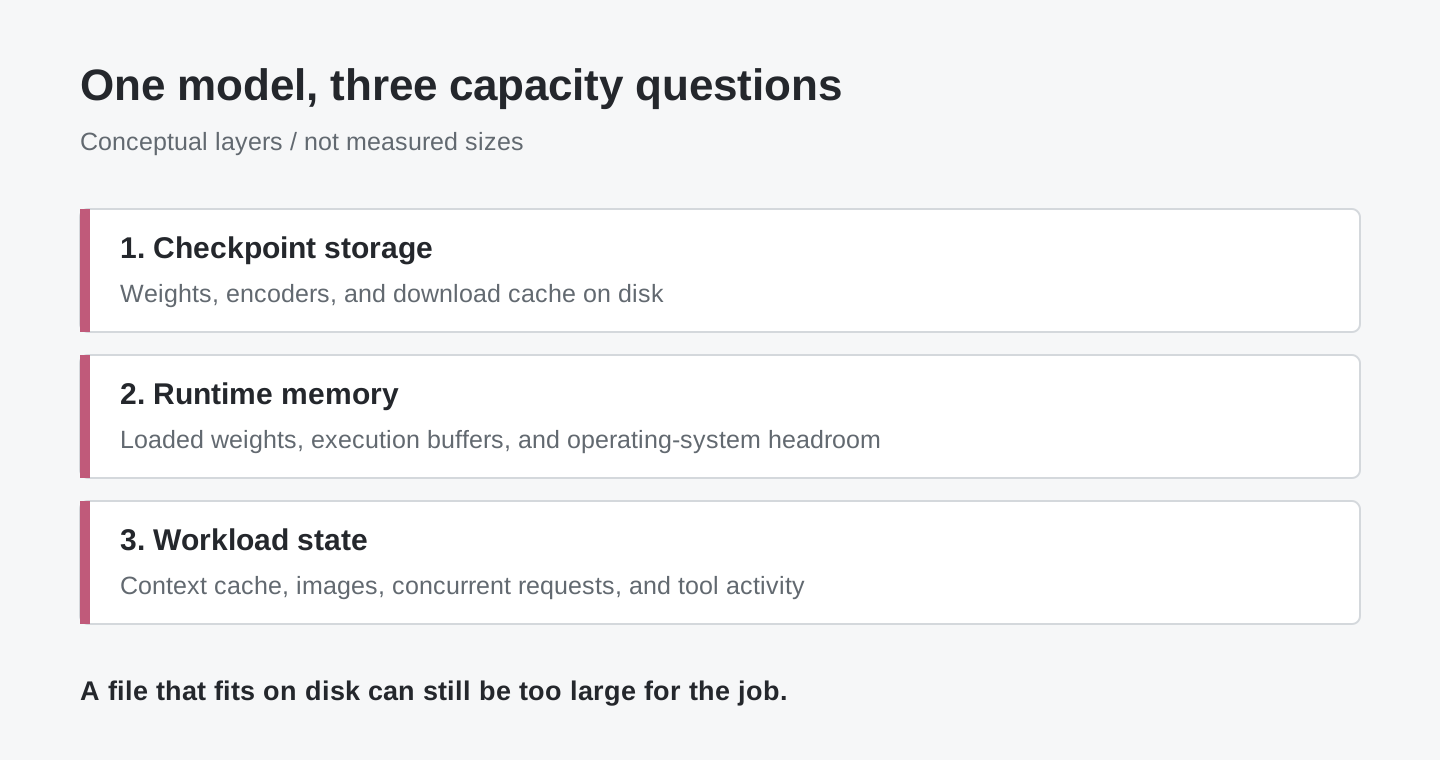
Originale Konzeptgrafik. Die Bänder zeigen Arten der Speichernutzung, keine gemessenen Anteile. Die Checkpoint-Größe allein ist keine Schätzung der Kapazität des gesamten Rechners.
Bei Video wird dieser Unterschied besonders wichtig. Eine kurze Frage zu einem Bild und eine lange Analyse vieler Frames sind nicht dieselbe Anfrage, nur weil beide ein Modell mit visuellen Fähigkeiten verwenden. Ein sinnvoller erster Versuch hält die Eingabe klein, begrenzt die Antwort und schafft zunächst eine funktionierende Basis, bevor ein größeres Archiv oder eine längere Agent-Schleife hinzukommt.
Zwei Mac Studios und ein Mac mit 512GB erzählen unterschiedliche Geschichten
Metas Demonstration verwendet zwei M5 Ultra Mac Studios und MLX. Die Ankündigung nennt bis zu 512GB Unified Memory pro Rechner und zeigt lokale Arbeitsabläufe mit Änderungen an der iOS-App Ice Cubes sowie Bearbeitung in DaVinci Resolve. Das sind Demonstrationen von Meta, keine Messungen an unserem Schreibtisch. Konfigurationen und Beispiele finden Sie in Metas Launch-Beitrag.
Der Launch-Beitrag von Hugging Face wählt einen anderen Weg. Er beschreibt Tests eines quantisierten oQ3e-Checkpoints auf einem M3 Ultra mit 512GB Arbeitsspeicher. Bei einem Prompt mit 1,024 tokens und 128 generierten tokens berichten die Autoren von ungefähr 225 tokens per second beim Prefill und 21 bei der Generierung. Diese Werte gelten für diesen kurzen Test und diesen Checkpoint, nicht für jeden Mac und nicht für die Demonstration mit zwei Rechnern. Lesen Sie den MLX-Abschnitt des Engineering-Artikels.
Die oQ3e-Checkpoint-Karte korrigiert eine wichtige Einheit: Der Tensor-Speicherbedarf beträgt etwa 344.152 GiB beziehungsweise 369.531 GB. Die Karte nennt für oMLX etwa 370GB. Das einfach als „344GB-Modell“ zu bezeichnen, vermischt binäre und dezimale Einheiten – genau dort, wo der verbleibende Speicher entscheidend ist.
| Veröffentlichter Weg | Was er veranschaulicht | Was Leser daraus nicht schließen sollten |
|---|---|---|
| Metas zwei M5 Ultra Mac Studios | Lokale Bereitstellung mit viel Arbeitsspeicher und Agent-Demonstrationen | Jede Muse-Konfiguration erfordert genau zwei Macs |
| Hugging Faces M3 Ultra mit 512GB und oQ3e | Ein stärker quantisiertes Beispiel auf einem einzelnen Rechner | Ein gewöhnliches MacBook hat genügend Arbeitsspeicher |
| Gehostete Inferenz | Zugriff ohne lokale Wartung des vollständigen Checkpoints | Die Arbeit bleibt zwangsläufig auf dem eigenen Rechner |
Eine weitere Grenze ist wichtig. Die oQ3e-Konvertierung enthält das Sprachmodell und den Vision-Encoder, aber nicht den Audio-Encoder. Eine Sprach- und Browser-Demonstration mit dem vollständigen Modell belegt daher nicht, dass derselbe Audio-Workflow mit genau diesem Download funktioniert. Der Modellname ersetzt nicht die Modellkarte der jeweiligen Variante.
Die oQ4e-Karte macht den Kapazitätskompromiss noch deutlicher. Sie nennt ungefähr 475.886GB Tensor-Speicher und warnt, dass dies für einen zuverlässigen Betrieb auf einem einzelnen Mac mit 512GB zu viel ist. Mehr Bits können eine andere Darstellung der Gewichte bewahren und zugleich weniger Platz für die eigentliche Aufgabe lassen. Voller Speicher bedeutet nicht, dass die Arbeit erledigt ist.
Achten Sie auf die Tool-Schleife, nicht nur auf die letzte Antwort
Ein attraktiver Anwendungsfall ist ein Programmierassistent, der prüfen kann, wie seine Änderungen aussehen. Hugging Faces 3D-Asset-Beispiel kombiniert ein quantisiertes Modell, einen Coding-Agent, Three.js, gerenderte Browseransichten und visuelles Feedback. Interessant ist die Schleife: ein Artefakt erzeugen, es ansehen, einen Fehler finden und es überarbeiten.
Stellen Sie sich vor, Sie würden nach diesem Muster den Prototyp eines Produktkonfigurators erstellen. Der Agent sollte ein verdecktes Steuerelement oder ein Objekt außerhalb des Kamerabilds bemerken, statt nur syntaktisch gültigen Code zu erzeugen. Das ist eine beispielhafte Anwendung des Musters, keine Behauptung, die Demo liefere bereits einen produktionsreifen Konfigurator. Die Abnahmekriterien bleiben Sache des Projekts: die richtigen Steuerelemente, die richtigen Abmessungen und das richtige Verhalten auf einem kleinen Bildschirm.
Ein zweites Beispiel ist die von Hugging Faces Artikel verlinkte Demonstration „Call your Browser“. Sie kombiniert Spracheingabe mit visueller Browser-Interaktion, um Produkte passend zu einer Beschreibung zu suchen. Die im Engineering-Artikel gehostete Demonstration zeigt die Interaktion, ohne zu behaupten, dass das Installieren der Gewichte allein einen Browser-Agent erzeugt. Der verlinkte Space kann Zugriff erfordern; gehen Sie nicht davon aus, dass der Link auf der Launch-Seite einen öffentlich nutzbaren Dienst garantiert. Prüfen Sie vor einem gehosteten Versuch Einrichtung und Datenverarbeitung und verwenden Sie nicht sensible Beispiele.
Ein dritter Anwendungsfall ist ein Assistent zur Prüfung eigener Dokumente und Screenshots. Sie könnten ihn beispielsweise bitten, eine schriftliche Anforderung mit einem Interface-Bild zu vergleichen und Abweichungen aufzulisten. Diese Aufgabe profitiert vom Bildverständnis, ohne dem System sofort die Erlaubnis zu geben, Dateien zu ändern, Nachrichten zu senden oder etwas zu kaufen. Beginnen Sie mit einer Aufgabe, bei der ein Mensch sowohl die Eingabe als auch den Vorschlag prüfen kann.
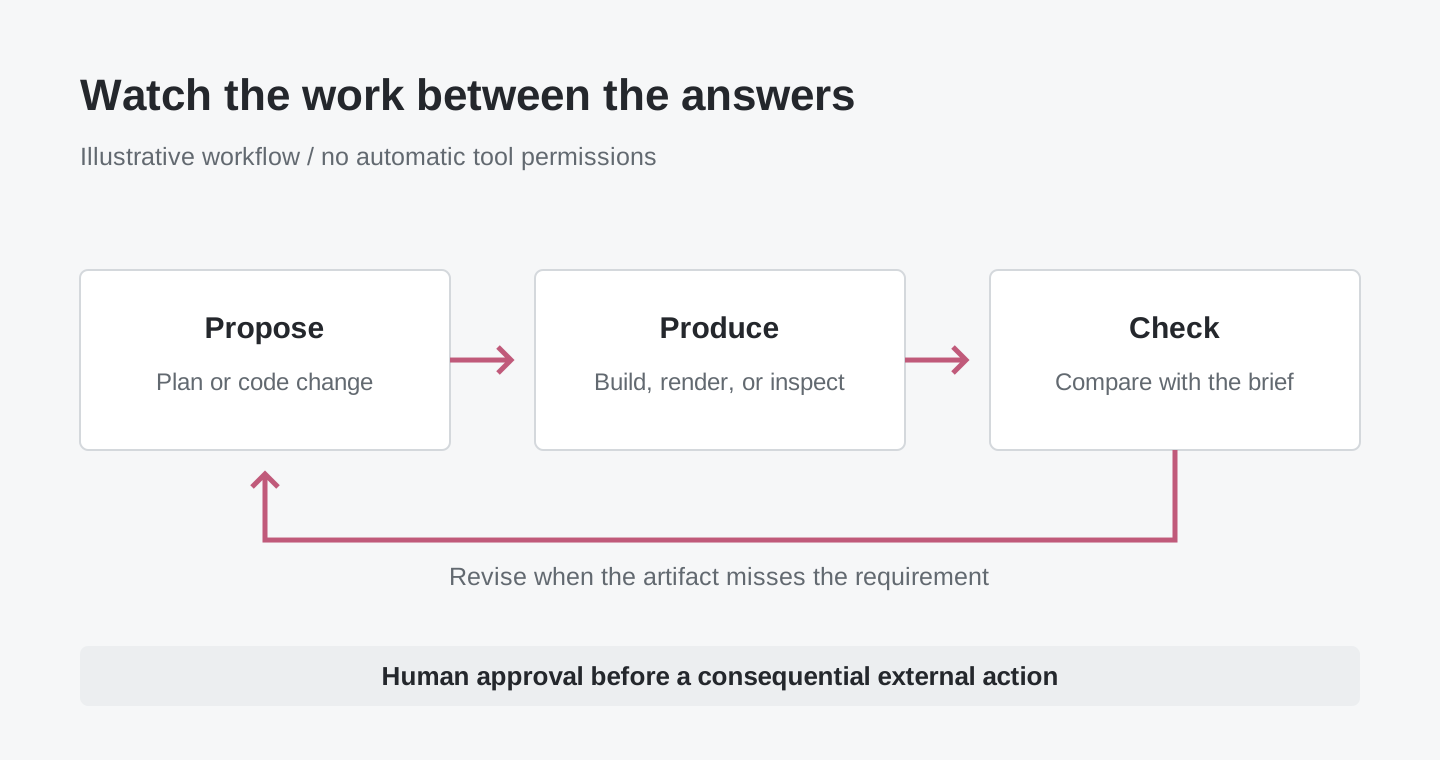
Originale Workflow-Illustration. Das Agent-Framework und seine Tools ermöglichen die Handlungsschleife; das Herunterladen von Modellgewichten gewährt für sich genommen keinen Browser- oder Dateisystemzugriff.
Suchen Sie bei allen drei Mustern nach Zwischennachweisen. Wurde eine Codeaufgabe kompiliert? Entspricht die gerenderte Seite der Anforderung? Erfüllt eine Produktauswahl die genannten Bedingungen? Ein ausgefeilter letzter Absatz ist kein Ersatz für das Artefakt, das die Aufgabe hervorbringen sollte.
Beginnen Sie auf einem Mac, ohne „Download“ zum ersten Schritt zu machen
Der naheliegendste Fehler: zuerst das größte Modell wählen und den Kapazitätsbedarf erst mitten im Download bemerken. Gehen Sie umgekehrt vor. Entscheiden Sie sich für eine kleine Aufgabe, finden Sie einen unterstützten Checkpoint und prüfen Sie den Rechner, bevor Sie Speicherplatz oder Zeit investieren.
- Prüfen Sie Arbeitsspeicher und freien Speicherplatz des Mac. Die folgenden Befehle zeigen im Terminal die macOS-Version, den installierten Speicher in Bytes und den freien Platz auf Ihrem Home-Volume. Sie installieren keine Software und laden keine Gewichte herunter.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Wählen Sie eine unterstützte Anwendung zusammen mit einem Checkpoint. Das oMLX-Projekt stellt eine macOS-Anwendung und Installationsdokumentation bereit. Die dokumentierten Voraussetzungen umfassen Apple Silicon und macOS 15 oder neuer. Zum Zeitpunkt der Erstellung ist v0.7.1rc1 die neueste Version, ein Release Candidate: Halten Sie Experimente von einer Workstation getrennt, auf die Sie bei Termindruck angewiesen sind.
-
Lesen Sie die Karte der genauen Konvertierung, bevor Sie sie in der Modelldownload-Oberfläche auswählen. Für das obige Einzelrechner-Beispiel lautet die Kennung
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Planen Sie Speicher für Checkpoint, Download-Cache, Laufzeit und Ihre eigentliche Aufgabe ein. Ein Mac mit 256GB liegt unter dem veröffentlichten Bedarf dieser Variante; eine einzeilige Antwort beseitigt nicht den Speicherbedarf der Gewichte. -
Beginnen Sie mit einer kurzen, entbehrlichen Aufgabe. Probieren Sie eine kleine Textfrage oder einen nicht sensiblen Screenshot mit kurzer Antwort. Prüfen Sie, ob das Modell lädt und das Ergebnis nützlich ist, bevor Sie den Kontext erweitern oder Tools hinzufügen. Ein erfolgreicher Ladevorgang belegt Kompatibilität, keine sachliche Richtigkeit.
-
Ergänzen Sie Aktionen erst, wenn der schreibgeschützte Ablauf funktioniert. Arbeiten Sie mit einer Projektkopie. Beschränken Sie die Dateien und Tools, auf die der Agent zugreifen kann, und verlangen Sie vor externen Aktionen eine Bestätigung. Halten Sie Änderungen überprüfbar, statt beim ersten Versuch Ihre einzige Arbeitskopie verändern zu lassen.
Bevorzugen Sie den unterstützten Download- und Modellauswahlweg der Anwendung gegenüber einem allgemeinen Befehl von einer anderen Modellseite. MLX LM bietet ebenfalls einen Kommandozeilenweg, doch Modellunterstützung und gebündelte Releases können sich unterschiedlich schnell weiterentwickeln. Der Muse-Support-Pull-Request ist eine nützliche Kompatibilitätsreferenz bei der Versionswahl, aber kein Grund, einen beliebigen Entwicklungszweig zu installieren.
Sie müssen keine Hardware kaufen, um den Nutzen des Modells einzuschätzen. Ein gehosteter Endpunkt kann zunächst zeigen, ob es Ihre repräsentative Aufgabe bewältigt, bevor Sie eine lokale Bereitstellung untersuchen. Prüfen Sie zuvor Preise, Datenverarbeitung und Ausgabenkontrollen des Anbieters. Eine öffentliche Demonstration ist Lernmaterial, kein kostenloses Produktions-Backend.
Messen Sie eine erledigte Aufgabe, nicht nur einen Token-Zähler
Tokens per second beschreiben eine Inferenzkonfiguration. Sie sagen nicht, ob der Assistent einen Nachmittag gespart oder einen subtilen Fehler erzeugt hat. Eine schnellere falsche Änderung kann mehr kosten als eine langsamere richtige, insbesondere wenn ein länger laufender Agent seine eigenen falschen Annahmen wiederholt.
Ein praktischer Vergleich nutzt dieselbe kleine Aufgabensammlung für mehrere Kandidaten. Dazu gehören eine Codeänderung mit vorhandenem Test, ein Screenshot mit bekanntem Problem und eine Dokumentfrage, deren Antwort sich auf eine Textstelle zurückführen lässt. Halten Sie Prompt und Abnahmekriterien konstant. Erfassen Sie dann Richtigkeit, Zeit bis zum geprüften Ergebnis, erforderliche Eingriffe und den Spitzenverbrauch an Ressourcen, sofern Ihre Tools ihn anzeigen.
Betrachten Sie Prefill und Generierung als unterschiedliche Teile der Wartezeit. Bei einer langen Eingabe kann die erste Antwort langsam kommen, obwohl danach die Tokens schnell folgen. Ein Agent kann auch Zeit mit Kompilieren, Browsen oder Warten auf ein anderes Tool verbringen. Zählen Sie diese Zeit beim Vergleich einer lokalen Konfiguration mit einem gehosteten Dienst mit; sie gehört zum Nutzererlebnis, auch wenn sie außerhalb des Modells anfällt.
Wiederholen Sie den Vergleich nach einem bedeutenden Checkpoint- oder Laufzeit-Update. Sie brauchen keinen großen Benchmark, um festzustellen, dass ein Update Ihren üblichen Ablauf beeinträchtigt hat. Einige repräsentative, konsequent geprüfte Aufgaben sind nützlicher als ein Screenshot mit einer einzelnen beeindruckenden Antwort.
Open Weights bedeuten Auswahl, nicht automatisch Datenschutz oder uneingeschränkte Rechte
Ein lokales Modell kann die Inferenz auf Ihrem Rechner halten. Die vollständige Anwendung kann dennoch Websuche, Telemetrie, externe Tools, Remote-Speicher oder gehostete Fallback-Modelle nutzen. Zeichnen Sie den Datenfluss des konkreten Ablaufs auf, bevor Sie ihn als privat bezeichnen. Ein Offline-Textversuch und ein Browser-Agent zum Einkaufen haben unterschiedliche Grenzen, selbst wenn beide denselben Checkpoint verwenden.
Auch die Muse Model License enthält Bedingungen. Sie verlangt Namensnennung und eine begleitende Nutzungspolitik und enthält separate Bedingungen für bestimmte Model-as-a-Service-Unternehmen. Dies ist ein Release mit individuell formulierten Open-Weight-Bedingungen, keine pauschale Zusage uneingeschränkter Nutzung. Prüfen Sie die aktuelle Lizenz für Ihre geplante Verbreitung oder Ihren Dienst.
Für ein Team braucht Eigentümerschaft neben einer rechtlichen auch eine operative Antwort. Wer genehmigt eine neue Modellversion? Wer kann die vorherige Konfiguration wiederherstellen? Wohin gelangen Prompts und Tool-Ergebnisse? Wer prüft eine Änderung, bevor sie Kunden erreicht? Diese Fragen sprechen nicht gegen lokale Inferenz. Sie machen daraus einen verlässlichen Dienst statt einer eintägigen Demonstration.
Das Fazit: Lokale KI wird zur Konfigurationsentscheidung
Der eigentliche Meilenstein ist nicht, dass nun jeder Rechner ein riesiges Modell ausführen kann. Vielmehr ist ein größerer Teil der Bereitstellungsentscheidung sichtbar und liegt bei den Nutzern: welche Gewichte, welche Konvertierung, welcher Rechner, welche Laufzeit und welche Tools.
Muse Spark Open macht diese Wahl konkret. Zwei Macs mit viel Arbeitsspeicher zeigen einen Weg, eine kleinere Konvertierung einen anderen; gehostete Inferenz bietet einen weiteren Kompromiss. Wählen Sie die kleinste Konfiguration, die Ihre Aufgabe zuverlässig erledigt. Die nächste sinnvolle Frage lautet nicht „Kann ich es laden?“, sondern „Kann ich dem Ergebnis vertrauen?“
Quellen und Demonstrationen
- Meta: Launch von Muse Spark Open, 15. Oktober 2026.
- Metas Modellkarte und Checkpoint-Spezifikationen.
- Hugging Face: Laufzeit-Leitfaden, MLX-Testbedingungen und Agent-Demonstrationen, 15. Oktober 2026.
- oQ3e-Konvertierung: Speichereinheiten, enthaltene Encoder und Nutzung.
- oQ4e-Konvertierung: Speicherbedarf und Warnung zum Einzelrechner.
- oMLX-Installationsdokumentation und Release v0.7.1rc1.
- Muse-Unterstützung in MLX LM.
- Muse Model License.
Produkt- und Kompatibilitätsinformationen wurden am 16. Oktober 2026 geprüft. Die oben genannten Leistungswerte sind den jeweiligen Herausgebern zugeordnet und an die angegebenen Testbedingungen gebunden.
Halten Sie die Entscheidung fest, nicht nur den Modellnamen
Für Leser, die Quellenlinks, Konfigurationsnotizen und Prüfentscheidungen sammeln, ist Telli.sh ein optionaler Arbeitsbereich. Forschungsnotiz erstellen.