O MiniCPM-OCR lê uma pasta de documentos digitalizados localmente. Quais páginas ainda precisam de revisão?
O SDK MiniCPM-OCR 1.0.5 processa várias entradas por execução. Guarde um resultado por documento, confira campos críticos e decida quais páginas podem entrar num arquivo pesquisável.
Três faturas antigas são legíveis para uma pessoa e difíceis de pesquisar. Uma é um PDF sem camada de texto. Outra é uma foto com um canto dobrado. A terceira é uma digitalização limpa com uma tabela de duas páginas. Uma ferramenta local de OCR converte imagens em texto, mas quem aprova o arquivo precisa saber a qual documento pertence cada resultado e se as colunas preservaram o sentido.
A OpenBMB lançou a versão 1.0.5 do SDK MiniCPM-OCR em 9 de novembro de 2026. A atualização aceita várias entradas numa execução e produz um resultado por arquivo. Uma opção separada trata imagens avulsas como documentos individuais. O modelo MiniCPM-OCR 1.0, com 1,3 bilhão de parâmetros, foi desenvolvido para documentos e PDFs em chinês e inglês. A OpenBMB já havia publicado o modelo e o SDK e oferece instruções para rodar o reconhecimento localmente. Versão no PyPI · Projeto e histórico da OpenBMB
Um primeiro teste útil é um lote pequeno cujo resultado possa ser auditado. Dê a cada entrada uma identidade estável, mantenha o resultado extraído junto da origem e confira os campos que causariam problemas se estivessem errados. É assim que se distingue um rascunho pesquisável de um registro que alguém pode usar para agir.
A ilustração oficial de lançamento do MiniCPM-OCR da OpenBMB mostra documentos se tornando texto estruturado. Apache 2.0. Rasterizada e redimensionada pela Telli.sh. Ilustração original

A atualização facilita preservar os limites de cada documento
Nas notas de 9 de novembro, a OpenBMB diz que a versão 1.0.5 retorna um resultado por arquivo quando recebe várias entradas. A opção --split-images trata imagens avulsas como documentos distintos. Isso importa em um escritório com PDFs de várias páginas e fotos de câmera. Uma fatura já montada em um único PDF normalmente deve continuar junta. Duas fotos sem relação devem continuar como registros distintos. Pacote e notas do MiniCPM-OCR 1.0.5
Para uma avaliação pequena, prepare um documento de cada tipo. Um PDF limpo estabelece a ordem de leitura esperada. Uma página fotografada mostra se dobra, rotação ou reflexo causam um trecho ruim. Uma tabela densa mostra o que ocorre quando duas colunas têm valores parecidos. Se houver duas fotos de páginas do mesmo registro, decida como agrupá-las antes de enviar ao analisador. O agrupamento pertence ao documento, enquanto o comando recebe arquivos.
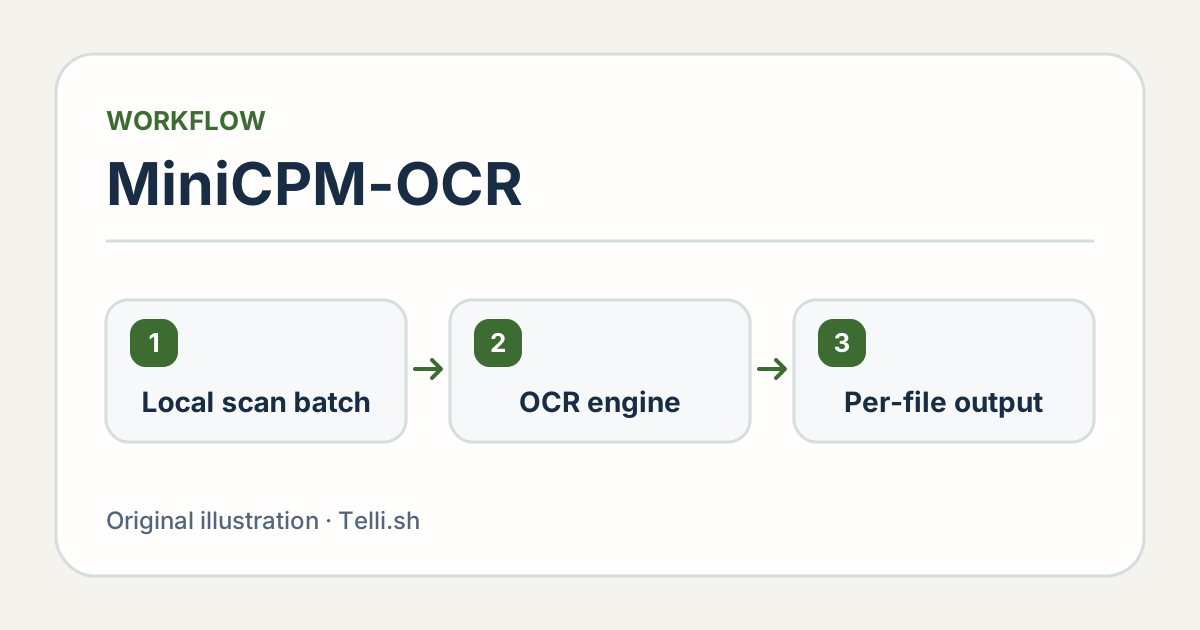
Um lote de exemplo usa uma identidade estável para cada documento e conserva a origem durante a revisão. Ilustração da Telli.sh.
Use um manifesto de entrada para identificar o original, o número de páginas e a saída esperada. Se usar uma soma de verificação para detectar alterações acidentais, gere-a do original antes de rodar o lote. Salve as saídas em outro destino, para uma tentativa posterior não sobrescrever a única fonte. Se duas pastas tiverem um arquivo chamado invoice.pdf, um identificador estável mantém os pares claros mesmo com nomes iguais.
Comece com um formato que a etapa seguinte consiga ler. O SDK da OpenBMB reúne as saídas em Markdown ou JSON, conforme a configuração. Markdown é conveniente para ler um rascunho. A saída estruturada pode ajudar um processo posterior a tratar as regiões retornadas. Quando um número ou campo embasar uma decisão, ambos os formatos ainda precisam ser conferidos com a imagem. Fluxo de extração da OpenBMB
A instalação local tem uma etapa de layout e outra de reconhecimento
A OpenBMB documenta duas partes para a análise de páginas completas no computador. O SDK usa um modelo de layout para localizar e ordenar texto, tabelas, fórmulas e outras regiões. Envia as regiões recortadas via HTTP ao serviço de reconhecimento e monta as respostas em ordem de leitura. As duas partes podem rodar em hardware sob seu controle. O serviço de reconhecimento é um ambiente separado, e o SDK também pode apontar para um serviço em outro lugar. Guia da OpenBMB para analisar páginas e instalar localmente
Esse limite importa para documentos privados. A pergunta relevante é para onde a etapa de layout envia os recortes. Um SDK local configurado para chamar um serviço hospedado ainda pode transmitir conteúdo pela rede. Na instalação local, aponte para o serviço pretendido e siga a política de armazenamento e logs da organização. Uma demonstração pública com um exemplo sintético mostra a interface sem enviar um documento real de cliente.
Em 5 de novembro, a OpenBMB publicou uma imagem Docker com SDK, vLLM e modelo. A instalação descrita requer Linux x86-64, uma GPU NVIDIA, driver compatível com CUDA 12.9 e Docker com NVIDIA Container Toolkit. A OpenBMB também documenta backends como llama.cpp e Ollama para reconhecimento. O tamanho do modelo sozinho não diz se uma máquina roda o processo inteiro com folga. Confira layout, formato do modelo, memória e volume processado na máquina de destino. Requisitos de instalação da OpenBMB
Também há um caminho no celular para documentos individuais. A OpenBMB anunciou extração offline no iOS em 2 de novembro. Uma atualização de 12 de novembro estendeu a demonstração no dispositivo a Android e HarmonyOS. As demonstrações móveis e o SDK em lote no computador são formas diferentes de usar o modelo. Escolha conforme o local dos arquivos e o modo de inspecionar os resultados. Histórico de versões móveis da OpenBMB
Confira os campos que podem estar errados sem parecer errados
Imagine uma fatura com uma linha de 10 unidades a 38,50. Na tabela extraída, 38,50 aparece na coluna de quantidade e 10 no preço unitário. Um sistema que só verifica se os números estão presentes pode aceitar a linha. Para quem usa o resultado, o que importa é o vínculo entre o valor e a coluna. Compare a linha, os cabeçalhos e os totais juntos.
Num arquivo para busca, o risco é diferente. Um erro de digitação numa nota descritiva pode ser aceitável se as pessoas encontrarem o original. Um erro no número de pedido pode levá-las ao documento errado. Defina quais campos exigem correspondência exata e confira a origem. Se houver um código, preserve os zeros iniciais na inspeção. Uma exibição numérica ou importação de planilha pode removê-los mesmo se o modelo leu certo.
| Exemplo de documento | O que conferir com a origem | O que decidir antes do uso posterior |
|---|---|---|
| Faturas | ID do fornecedor, número da fatura, moeda, totais e cabeçalhos | Quais campos exigem correspondência exata |
| Relatório em várias colunas | Títulos, ordem das colunas e legendas próximas às figuras | Se a leitura segue a sequência correta |
| Formulário girado ou fotografado | Nomes, caixas marcadas, carimbos ou registros perto de uma dobra | Quais páginas precisam de revisão manual ou nova digitalização |
| Digitalização multilíngue | Identificadores e texto dos campos em cada idioma presente | Quais idiomas cumprem os critérios de aceitação do arquivo |
A OpenBMB descreve o MiniCPM-OCR 1.0 como voltado a chinês e inglês. Equipes com páginas em coreano ou em vários idiomas devem medir o reconhecimento nesses materiais. Um teste prático inclui um documento denso, um formulário limpo e uma foto em cada idioma importante. Registre o tipo de erro em vez de tirar uma média de poucos documentos muito diferentes. Descrição do modelo pela OpenBMB
Uma nota por região ajuda a priorizar o que revisar
A OpenBMB também publica o MiniCPM-OCR Jev, um modelo separado que avalia texto, fórmulas e tabelas extraídos diante da região correspondente da imagem. O projeto descreve a nota como forma de localizar trechos que podem precisar de revisão. Num lote, ela pode ordenar a fila enquanto campos de alto impacto ainda são comparados ao original. Avalie como a nota classifica os erros que importam antes de usá-la para encaminhar revisões. Explicação da OpenBMB sobre o MiniCPM-OCR Jev
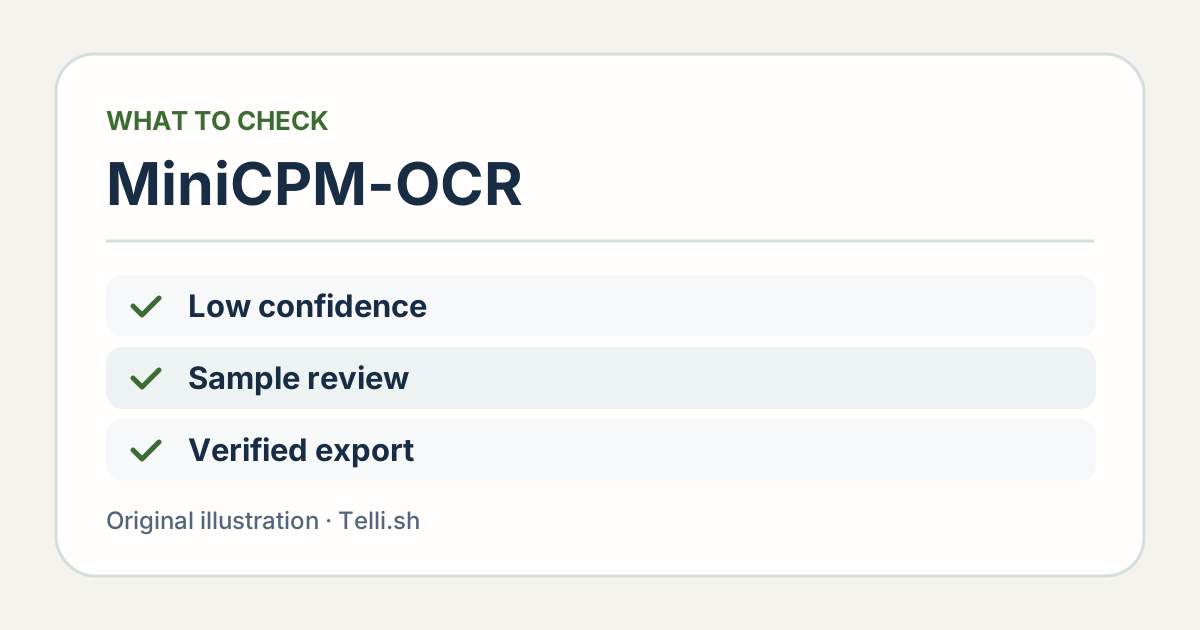
A pontuação opcional ajuda a priorizar a revisão. Campos que afetam pagamentos, identificadores ou outras decisões ainda podem exigir conferência direta. Ilustração da Telli.sh.
Para saber quando a nota ajuda, prepare um pequeno conjunto de referência com erros que a equipe já reconhece. Um caractere ausente num código de peça, uma linha desalinhada e uma frase de página limpa exercitam falhas diferentes. Inclua também trechos corretos. Examine casos em que o modelo dá nota alta a um erro ou baixa a um resultado correto. Discuta esses casos antes de adotar um limite no processo.
Mantenha divergências visíveis. Se alguém corrigir um total, preserve a saída original de OCR e registre a mudança com a referência ao documento. A equipe poderá verificar se os erros se concentram em um tipo de documento ou método de captura. Outra pessoa também poderá distinguir a correção humana do que o modelo retornou primeiro.
O tempo gasto na conferência pode decidir se o processamento em lote compensa em escala. Registre quanto demora resolver um problema e que tipos de página pedem uma segunda olhada. A ferramenta local pode poupar tempo nos documentos limpos e criar uma fila maior para os ruins. Se o mesmo formulário em papel sempre falha, melhorar a digitalização pode ser um passo melhor do que incluir outro modelo.
Use um lote pequeno que possa falhar de várias maneiras
- Reúna documentos de teste autorizados. Inclua uma digitalização limpa, uma foto girada e uma tabela de várias páginas, com idiomas e layouts representativos. Guarde cada original com um identificador estável.
- Escolha um caminho local aprovado. Para lotes no computador, siga o guia da OpenBMB e confira o endpoint do serviço de reconhecimento. Verifique hardware e ambiente antes de carregar os arquivos. Guia oficial de instalação local
- Execute o SDK e preserve um resultado por arquivo. Registre a versão do SDK, o modelo ou a quantização, o backend e o formato de saída. Escolha deliberadamente como agrupar imagens e conserve a origem de cada saída. Instruções do SDK 1.0.5
- Revise para o trabalho que o arquivo vai fazer. Confira a ordem de leitura para busca e os campos essenciais para extrações posteriores. Registre quais documentos foram aceitos, corrigidos ou rejeitados e por quê.
- Repita com outro conjunto pequeno. Aplique os mesmos critérios. Compare tempo até a revisão e rastreabilidade e resolva os casos que ainda exigem tratamento manual antes de aumentar o volume.
Mantenha o caso de uso ao alcance. Um assistente para pesquisar atas digitalizadas não exige as mesmas garantias por campo que uma ferramenta para preencher formulários de pagamento. Comece pela busca ou por outro fluxo reversível se essa for a necessidade imediata. O piloto pode mostrar quais extrações merecem conferências mais fortes depois.
Dê ao arquivo um modo simples de indicar o que indexou. Se a busca só mostrar o texto gerado, alguém pode tratar um resultado plausível como definitivo. Exiba o nome do arquivo ou ID ao lado do resultado e facilite encontrar a página correspondente. Se a extração tiver status de revisão, mostre-o junto. Assim as pessoas sabem quando consultar o original.
Há um teste de recuperação útil para lotes que compartilham uma pasta de saída. Imagine que um arquivo falhe e você execute só aquele com outra configuração. Confira se os demais resultados continuam presentes e se o manifesto indica qual saída veio da segunda execução. Isso não exige reprocessamento automático. O teste verifica se é possível melhorar um resultado sem perder o registro dos outros.
Um lote é útil quando cada resultado leva de volta à página
A atualização do SDK MiniCPM-OCR elimina parte do trabalho de enviar arquivos separadamente. O restante é uma decisão sobre o arquivo. Preserve o limite de cada documento, escolha onde as imagens serão processadas e use as necessidades da etapa seguinte para decidir quanto conferir cada campo. Quando alguém encontrar um número no mês seguinte, deve conseguir abrir a página de origem e ver o que o analisador viu.
Fontes
- SDK MiniCPM-OCR 1.0.5 no PyPI, 9 de novembro de 2026
- Repositório MiniCPM-OCR da OpenBMB, modelos, datas e guias de instalação
- Demonstração pública da OpenBMB
- Ilustração de lançamento e licença da OpenBMB
Para encontrar as decisões de revisão de um arquivo de documentos, crie uma conta na Telli.sh.