计划改了,Meta AI 能记住吗?
Meta 在 11 月开始向 Muse 和 Meta AI 推出 Active Memory,并报告 Muse 更常能在任务受阻后继续完成。可以用一次行程变更来测试助手。
你平时总是搭最早能赶上的火车。周六这趟旅行有个例外,朋友约你搭 10:40 的车,好一起走。AI 助手记住了这两件事。后来 10:40 的车取消了。当你让助手重排行程,它会悄悄沿用一个已经不存在的出发时间吗?会以为你从此都喜欢晚一点出发吗?还是会记住这次破例的原因,先问朋友究竟能赶上哪班车?
这个问题比让助手说出你喜欢什么颜色更适合测试 AI 记忆。记忆的价值在于把任务继续做下去。跨越几天的计划还要求助手区分长期偏好与临时例外,核对当前状态,并在仍该由你做决定的地方停下来。Muse 与 Meta AI 的 11 月更新,给了我们一个机会,看这些工作现在能交给助手多少。
Meta 在 11 月开始推出什么
2026 年 11 月 6 日,Meta 表示开始向 Muse 和 Meta AI 逐步部署现有模型的专门版本。Meta 使用另行介绍的研究模型系列 Muse Wonder 来训练它们。Muse 是 Meta 面向较长任务的个人智能体,Meta AI 则是通用助手。更新分阶段推出,仅凭公告无法知道哪些账户、地区或界面已收到更新。
Meta 介绍了两项应对计划变更的能力。两款产品的 Active Memory 帮助助手判断应该记住哪些上下文、这些信息在多久内有效,以及更新的信息何时改变其含义。Meta 把 Muse 的 Active Focus 描述为遇到意外障碍后继续推进用户目标的能力。对于 Meta AI,Meta 介绍的是相关的对话改进,例如追问和在用户改变方向时作出调整。在火车例子中,记忆关系到如何沿用出发时间和同伴的信息。专注则关系到原定列车取消后,怎样提出能走通的行程。
想用真正会遇到的情况评估更新,这个区别很重要。助手可能正确复述新限制,却遇到第一个障碍就放弃。它也可能热心地用上周的信息编出新行程。结果要有用,需要同时做到两点。它要使用当前的限制条件,也要以你能核对的方式调整下一步。
Meta 报告,Muse 在基准评估中正确使用关键上下文的比例从 76% 提升至 90%,增加了 14 个百分点。Meta 还称,Muse 在遭遇意外问题的日常任务中,完成率 相对提高了 67%。两项数据均来自 Meta 自己的评估。真实旅行、学习安排或工作交接各有不同的限制,需要各自验证。
Meta 在产品网站公开了 Muse 的导览。封面是 LPS.1 在 2014 年拍摄的 Facebook 门洛帕克园区历史照片,采用 CC0 发布。Telli.sh 裁切了原始照片并调整了尺寸。

一份计划里的三类上下文
有人说出行在周六,火车 10:40 出发,自己通常喜欢早点走。刚记下时,这三件事看起来一样有用,但它们会在不同时间失效。把它们分成三种角色,更容易判断计划改变时助手哪里做得好。
| 上下文类型 | 虚构示例 | 火车取消后应怎样处理 |
|---|---|---|
| 长期偏好 | 我通常喜欢早一点出发。 | 保留为偏好,用来给满足当前条件的选项排序。 |
| 本次行程限制 | 这个周六,我最早 10:15 才能在车站见到朋友。 | 将它用于本次行程,即使平时偏爱更早的车。 |
| 已被替代的细节 | 我们原来打算搭 10:40 的车。 | 从当前行程中去掉。如果需要解释为什么改计划,可作为背景保留。 |
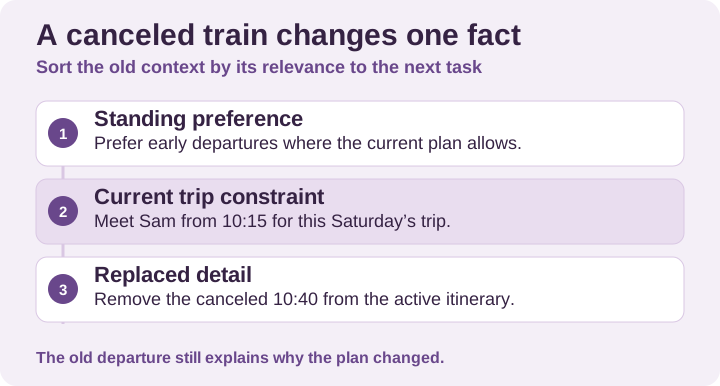
以虚构行程为例的 Telli.sh 原创图解。图中的分类是为检查回答而设,未展示 Meta 的内部记忆系统。
从行程里移除取消的火车,与忘记它曾经存在,是两回事。朋友问为什么改计划时,这段历史依然相关。问该订哪一班时,它就是已经失效的选项。答案取决于助手在用这项信息做什么。可观察的是,它能否选到与问题相符的上下文。
偏好也是如此。有人为一场会议选安静的餐馆,并不代表生日聚会也要遵循这个条件。如果一个人说座位偏好已经永久改变,那就可以合理地期待助手在另一次旅程中使用新偏好。把适用时间说明白,是提升试验质量和实际计划质量的一个简单办法。
给已经收到更新的账户做一次短测
先给出虚构信息,请助手用文字规划。第一次全用虚构资料,就能在不提交真实旅行信息、也不授权访问账户的情况下,观察助手怎样处理变化。记下原始提示和回答,以后界面有变化时可以重测。如果账户没有清楚显示更新是否可用,回答仍能说明当前界面的表现,却不能据此确定背后是哪一个模型。
- 设置长期偏好。 告诉助手:「我一般喜欢搭最早能赶上的火车。周六这趟虚构旅程我会和 Sam 一起出发,我们最早 10:15 才能碰面。」让它分别总结偏好和本次行程的限制。
- 给出一份之后会失效的计划。 告诉助手:「原计划是搭 10:40 的火车,13:00 进博物馆。假设火车要坐 75 分钟,从车站到博物馆预留 30 分钟。」请它起草行程,不搜索网页,也不预订。
- 替换一个细节,再加入障碍。 告诉助手:「10:40 的车取消了。现在只有 10:00、11:00 和 11:30 三班车。博物馆还是 13:00 入场。把这些时间作为虚构输入,告诉我哪班合适。」10:00 与碰面时间冲突。11:00 出发能在 12:45 到博物馆,11:30 出发则是 13:15 到。
- 检查理由。 问:「哪项变了,哪些条件仍然适用?改预订前会问我什么?」有依据的回答能解释为什么 11:00 合适,列出 15 分钟余量,并把改订留给单独确认。
- 测试例外的适用边界。 在同一聊天中,问它如果 Sam 不参加,另一趟虚构旅程会怎样规划。如果界面支持在新聊天里沿用上下文,而且你想测试,也可以另开聊天再问一次。分别记录结果,因为读取可见聊天记录与跨聊天使用上下文是不同的体验。
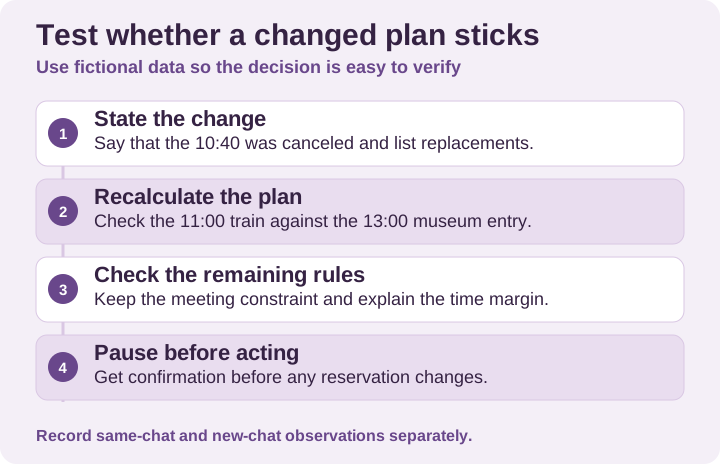
一项可以用虚构输入进行的测试。Telli.sh 原创图解。
每一步记一个简单判定。助手正确使用事实并解释结果,就标记为 通过。结果违反条件,或者重新加入已失效的选项,就标记为 失败。无法判断它用了记住的上下文、自己的推测,还是恰好能看到的信息,就标记为 不确定。判定只对应当天的那次交互。换第二个例子重做一次成功的测试,有助于看出这种表现是否稳定。
也可以反过来测,看它能否指出必须取舍的条件。把博物馆入场时间改为 12:30 再问,三班车都无法满足全部条件。有用的回答会指出冲突,并询问哪项安排可以变动。一份看起来很完整、却悄悄改了入场时间的行程,只是把问题留给了你。
同一功能还可以用在哪里
有临时例外的学习习惯。 学习者平时希望工作日安排短练习,旅行那周则要求改成两次长练习,下一周恢复原习惯。给助手一组带日期的虚构场景,请它列出两周的日历。好处是不用反复输入固定偏好。风险是只限一周的指令到期后仍然生效。可以检查学习安排是否在指定日期恢复,以及新考试日期是否正确取代旧期限。
条件变动的志愿者活动。 小组通常避开工作日晚上,但有成员提供了只在周二能用的场地,大家原本打算破例。后来场地又用不了了。提供一份虚构房间清单和可用时段,请助手提出选项并说明还需要向组织者确认什么。有用的做法是适应新场地条件,同时保留小组其余需求。在草稿里提出建议容易撤回,向全体参加者发送消息则影响更大,需要单独审核。
定期的工作交接。 设想一个小团队惯用一页状态简报。当前项目有个特殊的报告期限,一项依赖工作刚刚延期。用虚构时间表要求助手更新交接说明,标明新的预估时间,并保留一页格式。好用的助手会沿用稳定的格式,又不会让新排期埋在旧信息里。重复过期的截止日期,或把尚不确定的依赖写成定论,都会带来问题。列一张当前事实与日期的表格,读者仍然能逐项核对。
这些场景的共同机会,是在跨多轮对话的任务中少重复输入、让工作连贯。回答越流畅、越像记得你,过时信息也可能越难发现。助手的推断进一步增加了复杂度。你从未这样说过,它也可能把临时例外推断为长期偏好。适用范围很重要时,说明从何时开始、何时结束、取代哪条旧信息。然后检查下一次回答中有没有发生预期的变化。
把确认放在下一步产生实际影响之前
能应对意外的助手,可以省下起草替代方案的时间。它看起来越能干,建议就越容易不知不觉变成行动。可以先决定在哪里划界。火车例子中,查看新版行程很容易。买新票、取消旧票或把行程发给朋友,都会改变对话之外的情况。如果产品和接入的工具支持这些操作,就在每一步执行前分别确认。
把行程当作工作草稿。最终的预订和确认保留在签发它们的服务里,关键事实也去那里核对。比较助手的两次运行时,写下各自当时得到的输入。时刻表变更后产生的结果,应该对照变更后的时刻表。Meta 的发布声明和评估描述了它的目标,自己提供输入后观察到的行为,才是做下一次决策时可用的依据。
Active Memory 与 Active Focus 的早期潜力,在于即使外部情况变了,较长的任务也许不必反复解释。值得反复测试的是,助手能不能保留决策理由、去掉已过期的部分,并在还来得及解决时把冲突摆出来。如果这些行为在低风险示例中持续出现,就有理由让它多起草一些计划,并继续审核真正产生影响的步骤。
来源
关于 Telli.sh
Telli.sh 将录音、笔记和文档整理为可搜索的个人知识库,便于之后找回决策所依据的资料。想把工作笔记和相关背景放在一起,可以试用 Telli.sh。