Mercury 3 promete respostas mais rápidas. Sua tarefa terminará antes?
O novo modelo de difusão da Inception mira o trabalho interativo. Veja onde a velocidade importa, como comparar tarefas completas e por que separar o preço promocional.
Um cliente pergunta se pode alterar um pedido antes do envio. O assistente encontra o pedido, lê a política, consulta o estoque e prepara a resposta. Cada etapa parece pequena. Juntas, as esperas podem transformar uma conversa simples em uma conexão lenta com alguém muito ocupado.
A Inception lançou o Mercury 3 em 19 de outubro, direcionando seu novo modelo de linguagem por difusão a aplicações nas quais essas pausas se acumulam. A empresa informa 1.068 tokens de saída por segundo em GPUs NVIDIA e uma janela de contexto de 1 milhão de tokens. São especificações do fornecedor, e não uma garantia para uma interação completa com o cliente. Anúncio da Inception.
A questão interessante é o que um modelo mais rápido permite mudar. Um tutor pode dar uma dica enquanto o aluno ainda trabalha. Um agente de atendimento pode verificar uma exceção antes de responder. Um assistente de navegação pode concluir outra etapa útil dentro da mesma espera. Este guia explica essas possibilidades, os custos envolvidos e uma forma prática de avaliar se o Mercury 3 melhora a tarefa que você realmente precisa executar.
Hardware NVIDIA H100 como contexto para inferência em GPU. Foto: 极客湾Geekerwan, fonte Wikimedia Commons, CC BY 3.0; redimensionada e convertida para JPEG, com a marca do criador preservada. Não mostra a infraestrutura da Inception nem um benchmark nosso, e não identifica o hardware do resultado divulgado para o Mercury 3.

A difusão oferece à Inception outro caminho para acelerar o texto
A Inception é uma empresa de pesquisa e produtos de IA que vende modelos de linguagem em serviços hospedados. Sua família Mercury usa difusão, uma abordagem que refina o texto em várias posições, em vez de depender inteiramente de uma sequência da esquerda para a direita. O artigo Mercury, submetido em 17 de junho de 2025, descreve o método e a avaliação da família anterior. Ele contextualiza a abordagem, mas não é um relatório de benchmark do Mercury 3.
A implicação para o leitor é direta: a ordem em que o modelo calcula o texto pode afetar o tempo até uma aplicação obter uma resposta útil. Isso não torna qualquer resposta instantânea nem elimina o raciocínio de perguntas difíceis. Muda uma parte do trabalho de produzir a resposta. A aplicação ainda precisa obter informações, decidir como usá-las e apresentar algo que uma pessoa possa aproveitar.
Pense na latência como um orçamento de espera. O desenvolvedor pode gastá-lo com uma explicação maior, mais uma fonte ou uma resposta curta entregue antes. Um modelo mais rápido abre espaço nesse orçamento. O benefício para o usuário depende de como a aplicação o utiliza.
Isso importa especialmente quando o modelo é chamado repetidamente. Um assistente que só precisa responder uma vez oferece poucas oportunidades para recuperar tempo. Um agente que alterna leitura, escolha de ação e inspeção do resultado pode pagar pelo atraso muitas vezes. Economizar numa etapa recorrente pode mudar a experiência mesmo sem uma resposta isolada parecer extraordinária.
Tokens por segundo medem apenas um trecho da jornada
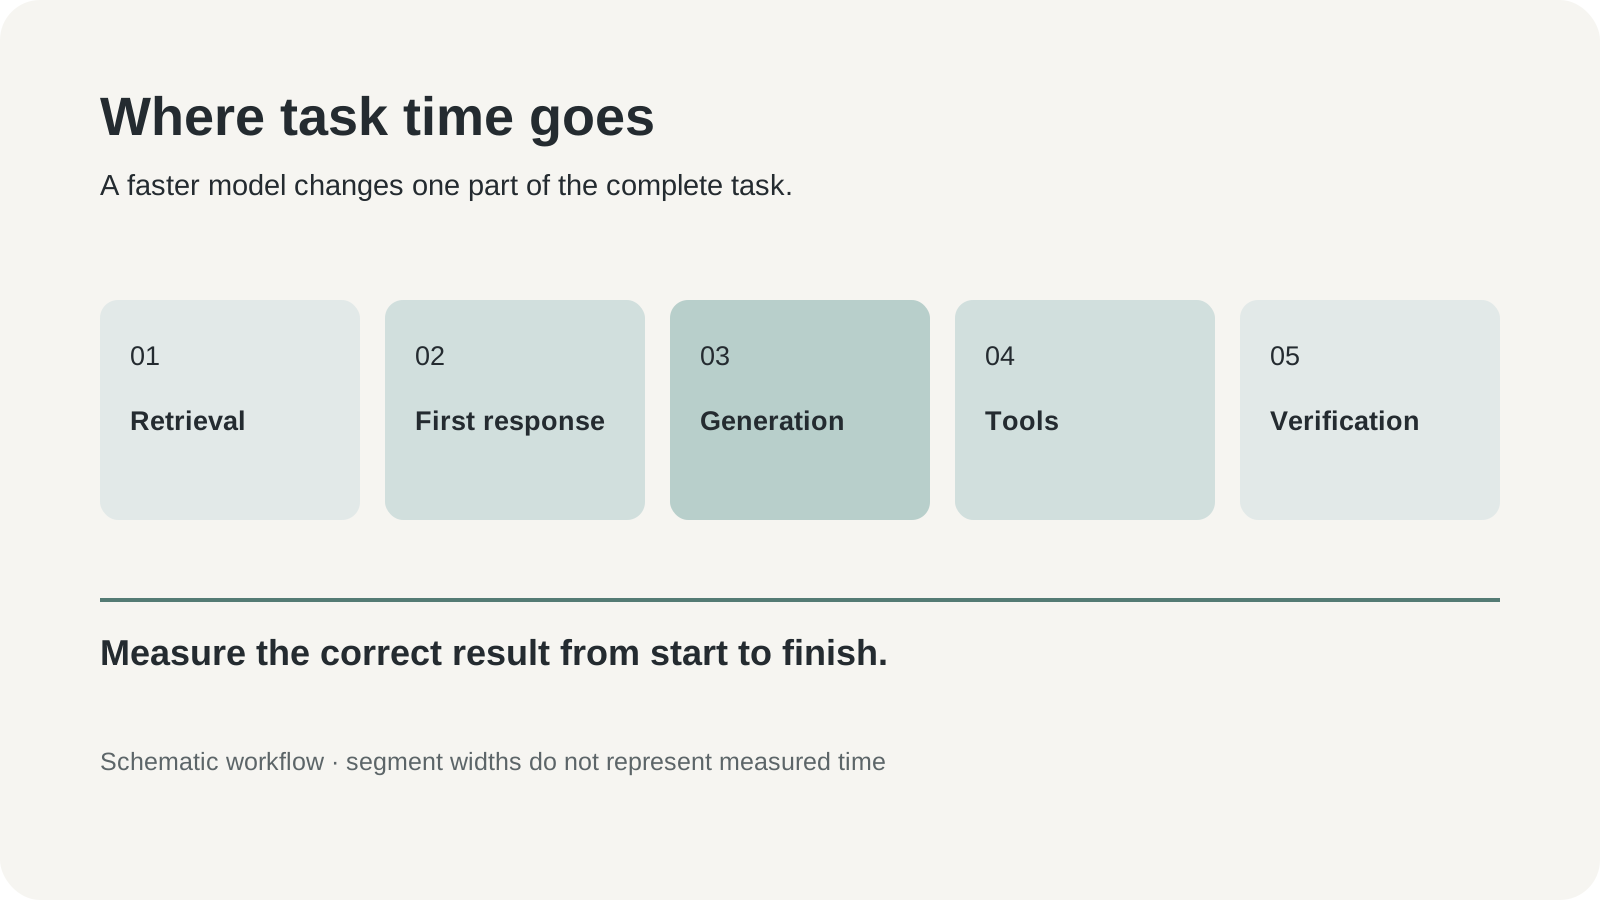
Infográfico editorial original: etapas que podem contribuir para o tempo de conclusão. Os segmentos são esquemáticos e não representam durações medidas.
Há vários relógios dentro de um recurso de IA. O tempo até a primeira resposta descreve quanto a interface parece esperar antes de acontecer algo útil. A taxa de saída mostra a rapidez do texto gerado. A latência de ferramentas cobre buscas, bancos de dados e serviços externos. O tempo de conclusão inclui as etapas necessárias a um resultado correto, inclusive novas tentativas e correções.
Esses relógios podem apontar em direções diferentes. Um sistema pode exibir as primeiras palavras imediatamente e demorar para terminar uma solicitação complexa. Outro pode esperar e devolver uma resposta compacta que dispensa correção. Um terceiro pode gerar rapidamente e passar quase toda a interação esperando pelo sistema de pedidos. A medida importante para o usuário depende do trabalho.
| Medida | O que informa ao desenvolvedor | O que não esclarece |
|---|---|---|
| Primeira resposta útil | Se a interface reconhece ou faz avançar a solicitação prontamente | Se o resultado final estará correto |
| Tokens de saída por segundo | A rapidez da produção de texto | Busca, filas de serviço e espera de ferramentas |
| Tempo da tarefa completa | Quanto demora um resultado correto | Qual componente causou lentidão |
| Tempo incluindo correções | O custo prático de chegar a um resultado aceitável | O comportamento em outra tarefa |
Nossa leitura: um modelo rápido merece espaço quando tira tempo do trabalho do usuário. Uma geração menor é valiosa quando encurta esse trabalho ou viabiliza uma checagem necessária. Vale menos quando a aplicação usa a economia para produzir texto de que ninguém precisa.
Torne o benchmark concreto. Pergunte se a tarefa ficou mais rápida com o mesmo padrão de aceitação. Depois identifique qual etapa mudou. Isso ajuda a separar uma melhoria do modelo de um prompt menor, um cache aquecido ou um serviço externo mais veloz.
O atendimento pode investir a economia em uma resposta melhor
Considere um fluxo ilustrativo de atendimento varejista. O cliente quer mudar o endereço depois de fazer o pedido. O assistente precisa do status, da política de alteração e dos dados corrigidos. A saída útil é o próximo passo correto: realizar uma mudança permitida por uma ferramenta autorizada ou explicar por que uma pessoa deve intervir.
A velocidade ajuda em vários momentos. Uma pergunta rápida pode evitar que o cliente abandone a conversa. Ler a política depressa deixa tempo para verificar a exceção de um pedido já em separação. Uma resposta final concisa confirma o que mudou e o que está pendente. Nenhuma dessas melhorias exige uma mensagem maior.
A avaliação deve incluir atritos comuns. Apresente um cliente que corrige o CEP, um pedido já enviado e uma política com uma exceção restrita. Verifique se o assistente usa o valor atual, em vez do primeiro recebido. Separe a permissão de efetuar uma alteração da capacidade de descrevê-la.
Evite a resposta rápida e confiante que cria mais trabalho. Se o cliente precisa voltar ao suporte para corrigir o resultado, a eficiência inicial foi superficial. Registre esse retorno e a transferência humana junto da velocidade inicial. Assim uma estatística atraente se torna uma decisão operacional útil.
O tutor ganha quando o feedback chega antes de a atenção mudar
Um segundo exemplo é um aplicativo de aprendizagem que reage a respostas curtas. O aluno envia uma frase em outro idioma ou uma etapa de álgebra. O aplicativo deve identificar o erro relevante e sugerir a próxima ação adequada. Responder rapidamente pode mantê-lo envolvido com a mesma questão.
A resposta nem sempre precisa ser completa. Uma pequena dica pode ser melhor que a solução inteira. Diferencie feedback correto de ajuda excessiva: o aplicativo identificou o erro, preservou a oportunidade de aprender e usou linguagem adequada? Uma explicação rápida no nível errado ainda interrompe a aula.
Monte uma amostra com várias respostas aceitáveis e algumas deliberadamente ambíguas. Peça uma dica antes da explicação completa. Inclua um aluno que altera a resposta e verifique se o aplicativo acompanha a revisão. Esses casos revelam se o modelo acompanha a interação educativa, em vez de simplesmente produzir o gabarito.
Num tutor por voz, o modelo textual é um componente. Reconhecimento de fala, gestão de turnos e síntese acrescentam tempo e erros próprios. Teste a interação falada completa antes de transformar a taxa de texto em uma promessa de agilidade conversacional. O texto rápido cria margem, mas o áudio ainda pode determinar a naturalidade da conversa.
Agentes de navegação precisam de relógio e regra de parada
O terceiro caso é um assistente que compara as condições atuais de fornecedores em páginas públicas. Ele lê uma página, escolhe um link, extrai uma condição e verifica outra fonte. Chamadas mais rápidas reduzem esperas repetidas. Também podem estimular a continuar navegando porque mais uma etapa custa pouco.
Defina a conclusão antes de medir a velocidade. A tarefa pode terminar quando há preço datado, limitação de serviço e fonte para cada candidato. O agente deve parar ao cumprir os requisitos ou informar um item ausente depois de uma busca limitada. Outra chamada é útil quando resolve uma incerteza específica.
A navegação também exige limites de ação. Ler informação pública é diferente de enviar formulários, alterar contas ou comprar. Trocar o modelo deve preservar permissões e confirmações existentes. A execução rápida faz uma ação equivocada acontecer antes; não a torna mais apropriada.
Compare tarefas bem-sucedidas e malsucedidas separadamente. Se um modelo para cedo e outro explora por mais tempo, uma média pode esconder a diferença. Registre etapas, falhas de ferramentas e evidências ausentes ao lado do tempo. O resultado deve explicar como a tarefa terminou, não apenas a duração do processo.
A tabela de preços precisa de uma coluna para depois da promoção
Na consulta de 23 de outubro, a página de modelos da Inception lista o Mercury 3 a US$ 0,20 por milhão de tokens de entrada e US$ 0,70 de saída, com desconto de lançamento para US$ 0,10 e US$ 0,35. Entrada em cache tem tarifas próprias. A página não informa o fim da promoção; mantenha no orçamento o cenário de tabela.
| Categoria da API direta | Tabela por 1 milhão de tokens | Lançamento por 1 milhão de tokens |
|---|---|---|
| Entrada | $0.20 | $0.10 |
| Entrada em cache | $0.02 | $0.01 |
| Saída | $0.70 | $0.35 |
Para uma carga ilustrativa de 100 milhões de tokens de entrada sem cache e 20 milhões de saída, a conta é US$ 34 na tabela e US$ 17 no lançamento. O exemplo assume esses volumes exatos e exclui outros serviços. Serve para comparar os dois regimes, não para estimar o gasto de uma operação real de suporte.
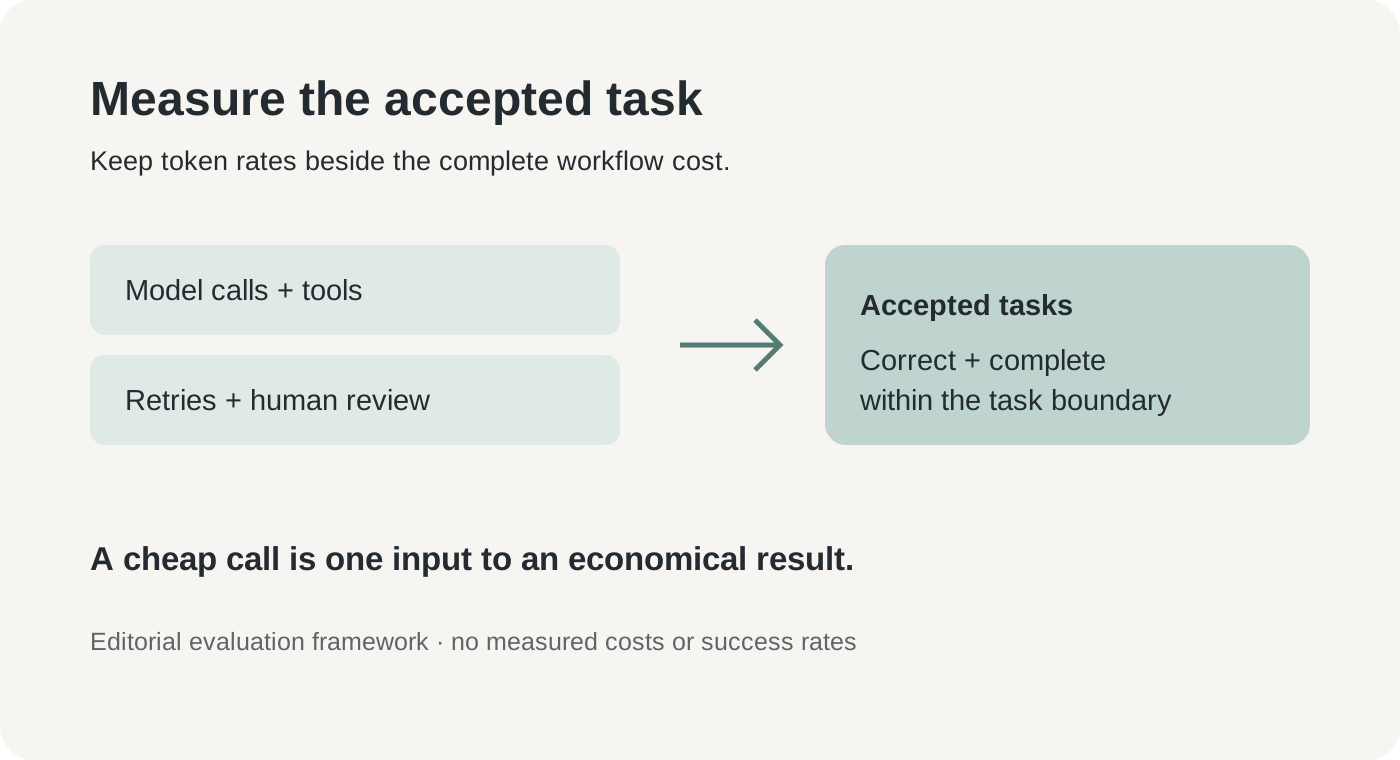
Estrutura editorial original de avaliação. Compare os recursos totais com o número de tarefas aceitas; não há custos de produto nem taxas de sucesso medidos.
Uma chamada barata pode integrar um fluxo caro. Busca, navegação, áudio, revisão humana e tentativas repetidas mudam o total. Uma chamada mais cara também pode ser econômica se evitar várias falhas. Acompanhe o custo por tarefa aceita além dos preços de tokens.
O cache exige a mesma disciplina. Não suponha que todo documento repetido recebe a tarifa reduzida. Registre o que o fornecedor cobra de fato e as condições documentadas da rota escolhida. Um modelo em várias plataformas pode ter diferentes termos, limites e preços. Preserve a rota de fornecimento no registro comparativo.
Comece com uma pequena reprodução e altere um componente
O guia inicial da Inception, consultado em 23 de outubro, identifica o modelo como mercury-3 e documenta SDK e endpoint compatível de chat-completions. Isso oferece um caminho prático para aplicações existentes. A compatibilidade facilita a primeira chamada; comportamento dos prompts e confiabilidade precisam de verificações próprias.
- Escolha uma tarefa reversível. Comece por um rascunho ou sugestão que alguém possa revisar. Reúna uma amostra autorizada com regra de aceitação para cada caso.
- Salve uma referência inicial. Registre modelo atual, prompts, tamanho das entradas, limites de saída e resultados de ferramentas. Guarde a resposta aceita e o tempo de cada caso.
- Crie conta e chave API da Inception. Armazene a chave em variável de ambiente ou gerenciador de segredos. Confira faturamento e controles de uso antes de executar um lote.
- Execute a chamada documentada com
mercury-3. Mantenha tarefa e critérios constantes. Registre configurações, esforço de raciocínio e limite de saída para repetir a comparação. - Inspecione falhas antes de ampliar o tráfego. Verifique fatos incorretos, condições omitidas, erros de esquema e chamadas desnecessárias. Repita casos representativos para entender a variabilidade.
- Faça um piloto com retorno possível. Mantenha o fornecedor anterior disponível, limite o uso e monitore tempo e custo de tarefas aceitas no tráfego normal.
Como início mínimo em Python, adapte o exemplo oficial do SDK a um prompt sem informações sensíveis:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
O próximo artefato útil é uma planilha com resultados corretos e falhas. Uma chamada bem-sucedida demonstra conectividade. Não comprova que toda configuração, esquema de ferramenta ou prompt existente terá comportamento idêntico.
Qualidade e controle dos dados devem acompanhar a velocidade
Os comparativos de lançamento da Inception são promissores para a categoria proposta, mas capacidade geral e adequação ao trabalho são questões diferentes. A página Mercury 3 da Vals AI, avaliadora independente, registra resultados em tarefas com configurações próprias, consultados em 23 de outubro. Interprete-os pelas definições desses testes, sem juntá-los à taxa do fornecedor numa classificação universal.
É mais útil observar diferenças de desempenho. Um modelo pode ser excelente em respostas curtas estruturadas e mais fraco numa tarefa especializada que sua aplicação considera rotineira. Inclua os casos difíceis cedo no piloto. Uma coleção só de sucessos informa pouco sobre onde será necessária ajuda humana.
O tratamento de dados varia conforme serviço e contrato. Os termos da Inception descrevem a exclusão do treinamento nas configurações da conta, enquanto a página enterprise oferece controles configuráveis de retenção e implantação. Revise rota e contrato antes de enviar conteúdo de clientes. Use exemplos sintéticos ou devidamente autorizados no primeiro comparativo.
Para clientes existentes há uma data prática: a página informa que usuários do Mercury 2 ou 2.5 com uso anterior a 19 de outubro mantêm acesso até 15 de novembro de 2026, com suporte enterprise regido pelos contratos. A migração merece uma reprodução programada e um plano de retorno. A familiaridade com um prompt antigo não substitui a verificação no novo modelo.
A geração rápida deve comprar um próximo passo mais útil
O Mercury 3 reforça a ideia de tratar a velocidade de inferência como uma decisão de produto. A oportunidade é usar o tempo recuperado para corrigir, verificar uma fonte ou dar feedback enquanto ele ainda ajuda. O risco é gerar mais trabalho sem revisão. A próxima evidência relevante será o desempenho confiável nas tarefas completas solicitadas pelas pessoas.
Um bom piloto termina com uma resposta específica: este fluxo ficou mais rápido no mesmo padrão, ou não. É uma afirmação menor que declarar um modelo o mais veloz em tudo. Também é aquela que uma equipe pode usar para entregar uma experiência melhor.
Fontes
- Anúncio Mercury 3 da Inception, 19 de outubro de 2026; velocidade e contexto são especificações do fornecedor.
- Comunicado de lançamento da empresa, 19 de outubro de 2026.
- Modelos, preços e migração da Inception, consulta em 23 de outubro de 2026.
- Guia inicial da API, consulta em 23 de outubro de 2026.
- Artigo Mercury, submetido em 17 de junho de 2025; contexto da família anterior.
- Benchmarks Mercury 3 da Vals AI, consulta em 23 de outubro de 2026.
- Termos da Inception e controles enterprise, consulta em 23 de outubro de 2026.
Guarde a comparação para revisão
Se você quer um espaço separado para fontes autorizadas e as notas por trás da escolha de um modelo, Telli.sh é uma opção. Comece com uma nota.