Mercury 3 verspricht schnellere Antworten. Wird Ihre KI-Aufgabe früher fertig?
Inceptions neues Diffusionssprachmodell zielt auf interaktive Arbeit. Wo Tempo hilft, wie vollständige Aufgaben verglichen werden und warum Einführungspreise eine eigene Spalte brauchen.
Ein Kunde fragt, ob eine Bestellung vor dem Versand geändert werden kann. Der Assistent findet den Auftrag, liest die Regeln, prüft den Lagerstatus und bereitet eine Antwort vor. Jeder Schritt wirkt klein. Zusammen lassen die Wartezeiten einen einfachen Austausch wie eine langsame Verbindung zu einem sehr beschäftigten Menschen erscheinen.
Inception stellte Mercury 3 am 19. Oktober vor und richtet sein neuestes Diffusionssprachmodell auf Anwendungen aus, in denen sich solche Pausen summieren. Das Unternehmen nennt 1.068 Ausgabetoken pro Sekunde auf NVIDIA-GPUs und ein Kontextfenster von einer Million Token. Das sind Anbieterangaben, keine Garantie für eine vollständige Kundeninteraktion. Inceptions Ankündigung.
Interessant ist, was ein schnelleres Modell verändert. Ein Tutor kann einen Hinweis geben, solange der Lernende noch nachdenkt. Ein Supportagent kann vor der Antwort eine Ausnahme prüfen. Ein Browserassistent kann innerhalb derselben Wartezeit einen weiteren nützlichen Schritt erledigen. Dieser Beitrag erklärt diese Möglichkeiten, ihre Kosten und eine praktische Bewertung, ob Mercury 3 Ihre tatsächliche Aufgabe verbessert.
NVIDIA-H100-Hardware als Kontext für GPU-Inferenz. Foto: 极客湾Geekerwan, Wikimedia-Commons-Quelle, CC BY 3.0; skaliert und in JPEG umgewandelt, Urheberwasserzeichen erhalten. Weder Inceptions Infrastruktur noch unser Benchmark; die Aufnahme identifiziert auch nicht die Hardware des gemeldeten Mercury-3-Ergebnisses.

Diffusion eröffnet Inception einen anderen Weg zu schnellerem Text
Inception ist ein KI-Forschungs- und Produktunternehmen, das Sprachmodelle über gehostete Dienste verkauft. Die Mercury-Familie verwendet Diffusion: Text wird über mehrere Positionen hinweg verfeinert, statt vollständig auf eine Abfolge von links nach rechts zu setzen. Das am 17. Juni 2025 eingereichte Mercury-Paper beschreibt Methode und Bewertung der früheren Familie. Es liefert Hintergrund, keinen Mercury-3-Benchmark.
Für Leser ist die Konsequenz einfach: Die Reihenfolge der Textberechnung kann beeinflussen, wie schnell eine Anwendung eine nützliche Antwort erhält. Nicht jede Antwort wird dadurch sofortig, und schwierige Fragen brauchen weiterhin Schlussfolgerungen. Es verändert einen Teil der Antworterzeugung. Die Anwendung muss weiterhin Informationen beschaffen, ihre Nutzung entscheiden und ein verwendbares Ergebnis präsentieren.
Betrachten Sie Latenz als Wartebudget. Entwickler können es für eine längere Erklärung, eine weitere Quellenprüfung oder eine frühere kurze Antwort einsetzen. Ein schnelleres Modell schafft Spielraum. Ob dieser dem Nutzer hilft, hängt davon ab, wofür die Anwendung ihn ausgibt.
Das zählt besonders bei wiederholten Modellaufrufen. Ein Assistent mit einer kurzen Antwort bietet vergleichsweise wenige Einsparmöglichkeiten. Ein Agent, der zwischen Lesen, Aktionswahl und Ergebnisprüfung wechselt, bezahlt die Verzögerung möglicherweise viele Male. Eine Einsparung an einer wiederkehrenden Stelle kann die Erfahrung verändern, auch wenn keine einzelne Antwort spektakulär schneller wirkt.
Token pro Sekunde messen nur einen Teil des Weges
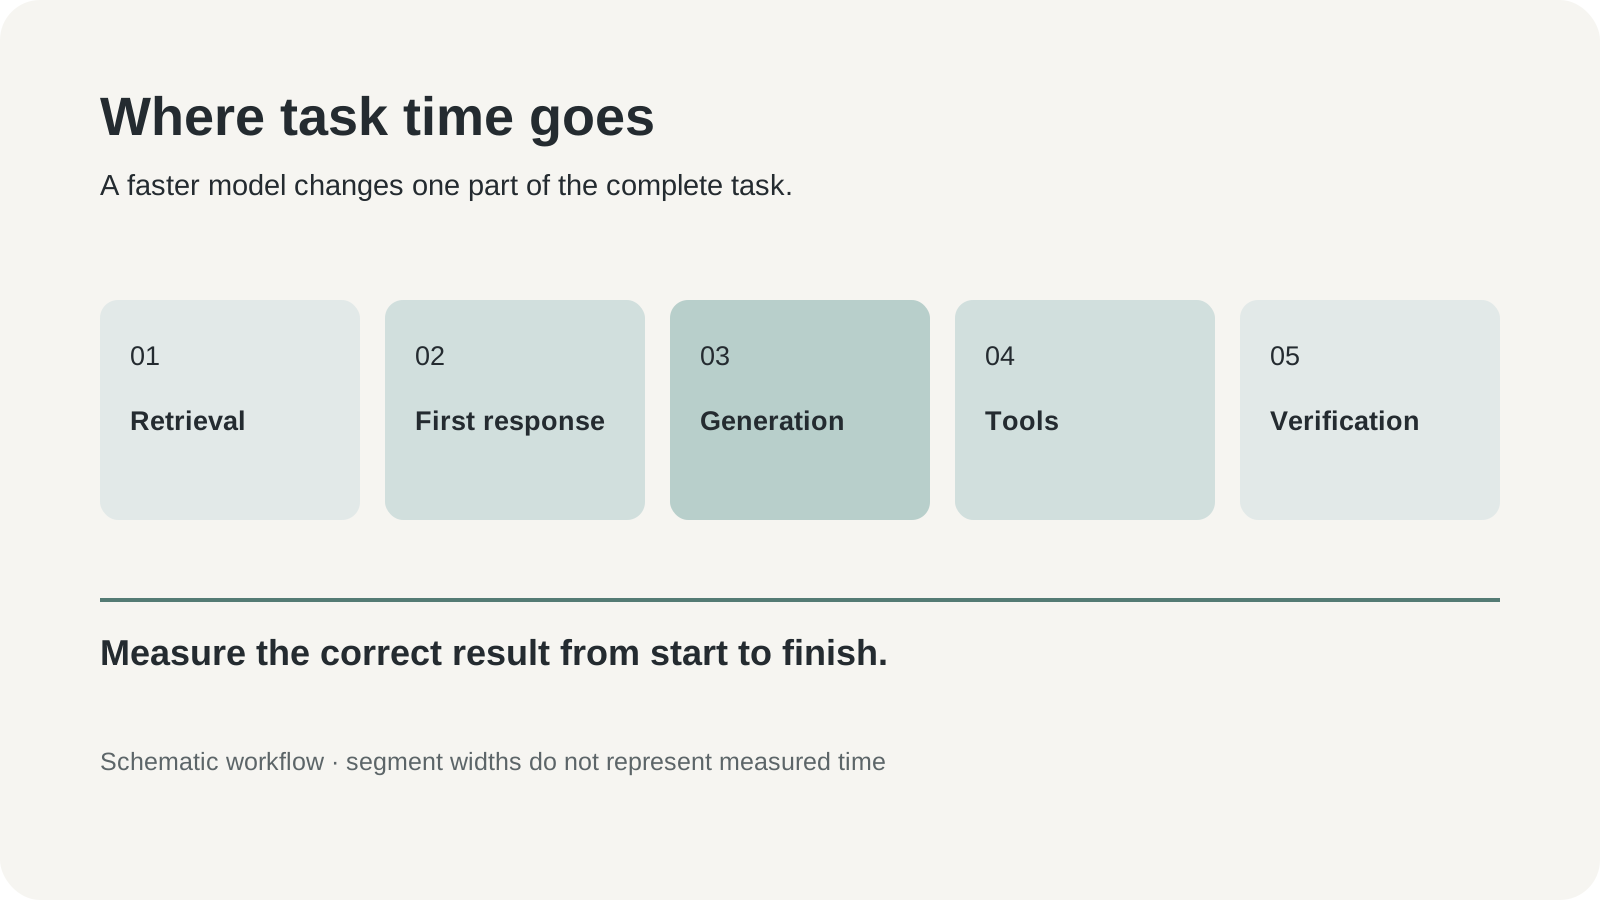
Eigene redaktionelle Infografik zu möglichen Anteilen der Aufgabendauer. Die Segmentgrößen sind schematisch und enthalten keine gemessenen Zeiten.
In einer KI-Funktion laufen mehrere Uhren. Die Zeit bis zur ersten nützlichen Reaktion beschreibt das Warten auf einen erkennbaren Fortschritt. Ausgabedurchsatz beschreibt, wie schnell erzeugter Text ankommt. Werkzeuglatenz umfasst Suche, Datenbank und externe Dienste. Die vollständige Aufgabendauer enthält alle Schritte zum richtigen Ergebnis, einschließlich Wiederholungen und Korrekturen.
Diese Uhren können unterschiedliche Richtungen zeigen. Ein System streamt sofort erste Wörter und braucht lange für einen schwierigen Auftrag. Ein anderes wartet und liefert eine kompakte Antwort ohne Korrekturbedarf. Ein drittes generiert schnell und wartet fast die ganze Zeit auf das Bestellsystem. Welche Zahl zählt, hängt von der Aufgabe ab.
| Messung | Aussage für Entwickler | Offene Frage |
|---|---|---|
| Erste nützliche Reaktion | Bestätigt oder fördert die Oberfläche die Anfrage zeitnah? | Wird das Endergebnis richtig sein? |
| Ausgabetoken pro Sekunde | Wie schnell während der Generierung Text entsteht | Suchzeit, Warteschlangen und Werkzeuglatenz |
| Vollständige Aufgabendauer | Wie lange ein richtiges Ergebnis benötigt | Welche Komponente eine Verzögerung verursacht |
| Dauer einschließlich Korrekturen | Praktischer Aufwand bis zum akzeptablen Ergebnis | Ob eine andere Aufgabe ähnlich verläuft |
Unsere Einschätzung: Ein schnelles Modell verdient seinen Platz, indem es Zeit aus der Arbeit des Nutzers entfernt. Eine kürzere Generierungsphase ist wertvoll, wenn sie diese Arbeit verkürzt oder eine notwendige Prüfung erschwinglich macht. Weniger wertvoll ist sie, wenn die Anwendung damit nur mehr ungelesenen Text erzeugt.
Formulieren Sie die Benchmarkfrage konkret. Wurde die Aufgabe bei gleichem Abnahmestandard schneller? Welche Phase hat sich verändert? So lässt sich eine Modellverbesserung von einem kürzeren Prompt, einem warmen Cache oder einem schnelleren Fremddienst unterscheiden.
Ein Supportassistent kann die Einsparung in eine bessere Antwort investieren
Ein beispielhafter Einzelhandelsablauf: Ein Kunde möchte nach der Bestellung die Lieferadresse ändern. Der Assistent benötigt Auftragsstatus, Änderungsregeln und korrigierte Kundendaten. Nützlich ist ein zutreffender nächster Schritt: eine erlaubte Änderung über ein autorisiertes Werkzeug ausführen oder erklären, warum ein Mensch übernehmen muss.
Tempo hilft an mehreren Stellen. Eine schnelle Rückfrage verhindert vielleicht den Gesprächsabbruch. Zügiges Lesen der Richtlinie lässt Zeit für die Ausnahme bei einer bereits verpackten Bestellung. Eine knappe Abschlussantwort bestätigt, was geändert wurde und was offenbleibt. Keine dieser Verbesserungen verlangt längere Nachrichten.
Die Bewertung sollte gewöhnliche Reibung einschließen. Ein Kunde korrigiert eine Postleitzahl, ein Auftrag ist bereits versandt, eine Richtlinie enthält eine enge Ausnahme. Verwendet der Assistent den aktuellen statt des zuerst gesehenen Werts? Trennen Sie die Berechtigung zur Änderung von der Fähigkeit, eine Änderung zu beschreiben.
Zu vermeiden ist eine schnelle, selbstsichere Antwort, die Mehrarbeit schafft. Muss der Kunde erneut den Support kontaktieren, war die erste Reaktion nur oberflächlich effizient. Erfassen Sie Nacharbeit und menschliche Übergabe neben dem Anfangstempo. So wird aus einer attraktiven Modellkennzahl eine brauchbare Betriebsentscheidung.
Ein Tutor hilft, wenn Feedback vor dem Aufmerksamkeitswechsel eintrifft
Ein zweiter beispielhafter Einsatz ist eine Lern-App für kurze Antworten. Lernende reichen einen fremdsprachigen Satz oder einen Zwischenschritt einer Algebraaufgabe ein. Die App muss den relevanten Fehler erkennen und einen passenden nächsten Schritt anbieten. Eine schnelle Antwort hält die Aufmerksamkeit bei derselben Frage.
Die Antwort muss nicht immer vollständig sein. Ein kleiner Hinweis kann besser sein als eine komplette Lösung. Unterscheiden Sie richtiges Feedback von übermäßiger Hilfe: Erkennt die App den Fehler, erhält sie die Lernchance und verwendet sie angemessene Sprache? Eine schnelle Erklärung auf dem falschen Niveau unterbricht ebenfalls die Lektion.
Stellen Sie Beispiele mit mehreren akzeptablen und bewusst mehrdeutigen Antworten zusammen. Verlangen Sie zunächst einen Hinweis, dann eine Erklärung. Lassen Sie einen Lernenden seine Antwort ändern und prüfen Sie, ob die App auf die Überarbeitung eingeht. Das zeigt, ob das Modell der Lerninteraktion folgt, statt lediglich einen Lösungsschlüssel auszugeben.
Bei einem Sprachtutor ist das Textmodell nur ein Bestandteil. Spracherkennung, Sprecherwechsel und Sprachsynthese bringen eigene Zeiten und Fehler mit. Testen Sie das vollständige Gespräch, bevor Textdurchsatz als Gesprächsreaktionszeit beschrieben wird. Eine schnelle Textphase schafft Spielraum, während die Audiophasen weiterhin die Natürlichkeit bestimmen können.
Browseragenten brauchen eine Uhr und eine Stoppregel
Ein dritter Fall ist ein Assistent, der aktuelle Lieferantenbedingungen auf öffentlichen Seiten vergleicht. Er liest, wählt einen Link, extrahiert eine Bedingung und prüft eine weitere Quelle. Schnellere Modellaufrufe reduzieren wiederkehrendes Warten. Sie können aber auch zum Weiterstöbern verleiten, weil der nächste Schritt wenig kostet.
Definieren Sie das Ende vor der Zeitmessung. Beispielsweise ist die Aufgabe erledigt, sobald für jeden Kandidaten ein datierter Preis, eine Leistungsgrenze und eine Quelle vorliegen. Der Agent soll dann stoppen oder nach begrenzter Suche einen fehlenden Punkt melden. Ein weiterer Aufruf ist nützlich, wenn er eine benannte Unsicherheit auflöst.
Browseraufgaben brauchen zudem Handlungsgrenzen. Öffentliches Lesen unterscheidet sich von Formularversand, Kontoveränderungen oder Käufen. Ein Modellwechsel muss bestehende Berechtigungen und Bestätigungen erhalten. Schnellere Ausführung lässt einen falschen Eingriff früher geschehen; angemessener wird er dadurch nicht.
Vergleichen Sie erfolgreiche und erfolglose Aufgaben getrennt. Stoppt ein Modell früh und recherchiert ein anderes länger, verschleiert ein gemeinsamer Durchschnitt den Unterschied. Halten Sie Schritte, Werkzeugfehler und fehlende Belege neben der Dauer fest. Das Ergebnis sollte erklären, wie die Aufgabe endete, nicht nur, wie lange der Prozess lief.
Die Preistabelle braucht eine Spalte für die Zeit nach der Aktion
Die am 23. Oktober geprüfte Modellseite nennt für Mercury 3 0,20 US-Dollar je Million Eingabetoken und 0,70 US-Dollar je Million Ausgabetoken. Der Einführungsrabatt senkt dies auf 0,10 und 0,35 US-Dollar. Für Cache-Eingaben gelten eigene Sätze. Ein Enddatum nennt die Seite nicht; die Budgetplanung sollte deshalb auch den Listenpreis enthalten.
| Tokenkategorie der direkten API | Listenpreis je Million Token | Einführungspreis je Million Token |
|---|---|---|
| Eingabe | 0,20 US-Dollar | 0,10 US-Dollar |
| Cache-Eingabe | 0,02 US-Dollar | 0,01 US-Dollar |
| Ausgabe | 0,70 US-Dollar | 0,35 US-Dollar |
Für beispielhafte 100 Millionen nicht gecachte Eingabe- und 20 Millionen Ausgabetoken ergibt die Rechnung 34 US-Dollar zum Listenpreis oder 17 US-Dollar zum Einführungspreis. Sie setzt genau diese Mengen voraus und schließt andere Dienste aus. Das vergleicht zwei Preisregime, schätzt aber keine reale Supportrechnung.
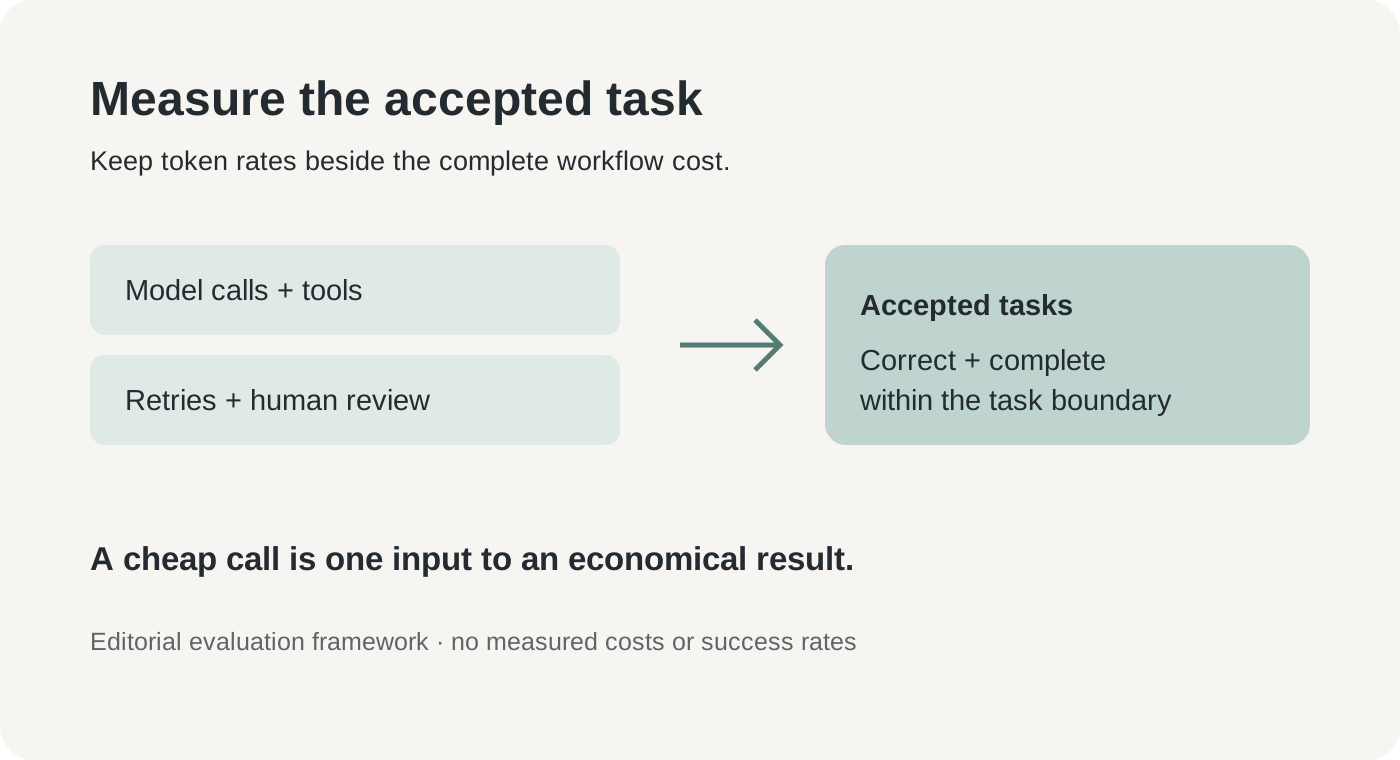
Eigener redaktioneller Bewertungsrahmen. Gesamtressourcen werden mit akzeptierten Aufgaben verglichen; keine gemessenen Produktkosten oder Erfolgsquoten.
Ein günstiger Aufruf kann Teil eines teuren Ablaufs sein. Recherche, Browserdienste, Audioverarbeitung, menschliche Prüfung und Wiederholungen verändern die Gesamtsumme. Umgekehrt kann ein teurerer Aufruf wirtschaftlich sein, wenn er mehrere Fehlversuche verhindert. Verfolgen Sie neben Tokenpreisen die Kosten je akzeptierter Aufgabe.
Für Caching gilt dieselbe Sorgfalt. Nicht jedes wiederholte Dokument erfüllt automatisch die Bedingungen des Cache-Preises. Erfassen Sie die tatsächliche Abrechnung und die dokumentierten Regeln des gewählten Anbieters. Ein Modell auf mehreren Plattformen kann unterschiedliche Betriebsbedingungen, Grenzen und Preise haben. Halten Sie den Bereitstellungsweg im Vergleich fest.
Beginnen Sie mit einer kleinen Wiederholung und ändern Sie ein Bauteil
Inceptions am 23. Oktober geprüfter Schnellstart nennt mercury-3 als Modellkennung und dokumentiert SDK sowie kompatiblen Chat-Completions-Endpunkt. Das bietet einen praktischen Integrationsweg. Kompatibilität erleichtert die erste Anfrage; Promptverhalten und Ablaufzuverlässigkeit bleiben eigenständige Prüfungen.
- Eine reversible Aufgabe wählen. Beginnen Sie mit Antwortentwürfen oder Feedbackvorschlägen, die ein Mensch prüfen kann. Sammeln Sie wenige genehmigte Beispiele mit klarer Abnahmeregel.
- Eine Vergleichsbasis sichern. Erfassen Sie Modell, Prompts, Eingabegrößen, Ausgabegrenzen und Werkzeugergebnisse. Bewahren Sie akzeptiertes Ergebnis und Dauer je Fall auf.
- Inception-Konto und API-Schlüssel erstellen. Speichern Sie den Schlüssel in einer Umgebungsvariable oder vorhandenen Geheimnisverwaltung. Prüfen Sie vor einem Batch Abrechnung und Nutzungskontrollen.
- Die dokumentierte Anfrage mit
mercury-3ausführen. Halten Sie Aufgabe und Abnahmekriterien konstant. Protokollieren Sie Denkaufwand und Ausgabegrenze für wiederholbare Vergleiche. - Vor mehr Verkehr die Fehler prüfen. Untersuchen Sie falsche Fakten, fehlende Bedingungen, Schemafehler und unnötige Aufrufe. Wiederholen Sie repräsentative Fälle, um Schwankungen zu verstehen.
- Mit Rückweg pilotieren. Halten Sie den bisherigen Anbieter bereit, setzen Sie ein Nutzungslimit und überwachen Sie Zeit und Kosten akzeptierter Aufgaben unter Normalverkehr.
Als minimaler Python-Einstieg lässt sich das offizielle SDK-Beispiel für einen nicht sensiblen Testprompt anpassen:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
Das nächste nützliche Dokument ist ein Vergleichsblatt mit richtigen Ergebnissen und Fehlerfällen. Eine erfolgreiche Beispielanfrage belegt die Verbindung. Sie belegt nicht, dass jede Einstellung, jedes Werkzeugschema und jeder bisherige Prompt identisch funktioniert.
Qualität und Datenkontrolle gehören neben das Tempo
Inceptions Startvergleiche sind für die Zielkategorie ermutigend, doch allgemeine Modellfähigkeit und Passung zur Arbeitslast sind verschiedene Fragen. Die am 23. Oktober geprüfte Mercury-3-Seite von Vals AI zeigt Ergebnisse mehrerer Aufgaben mit eigenen Einstellungen. Ihre Werte gehören in die jeweiligen Benchmarkdefinitionen, nicht zusammen mit Anbieter-Durchsatz in eine universelle Rangliste.
Nützlicher ist, die Ungleichmäßigkeit eines Modells anzusehen. Es kann bei kurzen strukturierten Antworten hervorragend und bei einer für Ihre Anwendung alltäglichen Spezialaufgabe schwächer sein. Nehmen Sie schwierige Fälle früh in den Pilot auf. Eine Sammlung ausschließlich erfolgreicher Beispiele zeigt kaum, wo Menschen Hilfe benötigen.
Auch Datenverarbeitung variiert nach Dienst und Vereinbarung. Inceptions Bedingungen beschreiben einen Trainings-Opt-out in den Kontoeinstellungen; die Unternehmensseite bietet konfigurierbare Aufbewahrung und Bereitstellungskontrollen. Prüfen Sie vor Kundendaten den tatsächlichen Weg und Vertrag. Verwenden Sie zuerst synthetische oder ausreichend autorisierte Beispiele.
Bestehende Nutzer sollten ein Datum festhalten: Laut Modellseite behalten Kunden mit Mercury-2- oder -2.5-Nutzung vor dem 19. Oktober den Zugang bis 15. November 2026; für Unternehmen gelten ihre Vereinbarungen. Migration verdient einen geplanten Probelauf und Rückweg. Vertrautheit mit einem alten Prompt ersetzt keine Prüfung am neuen Modell.
Schnellere Generierung sollte einen nützlicheren nächsten Schritt ermöglichen
Mercury 3 spricht dafür, Inferenztempo als Gestaltungsentscheidung zu behandeln. Die gewonnene Zeit lässt sich für Korrektur, Quellenprüfung oder rechtzeitiges Feedback einsetzen. Zugleich kann ein schnelleres System mehr ungeprüfte Arbeit erzeugen. Der nächste bedeutende Beleg ist zuverlässige Leistung bei den vollständigen Aufgaben, die Menschen erledigt haben möchten.
Ein guter Pilot endet mit einer konkreten Antwort: Dieser Ablauf wurde bei gleichem Standard schneller oder eben nicht. Das ist bescheidener als die Behauptung, ein Modell sei überall das schnellste. Es ist aber die Aussage, mit der ein Team ein besseres Produkt ausliefern kann.
Quellen
- Inceptions Mercury-3-Ankündigung, 19. Oktober 2026; Tempo und Kontext sind Anbieterangaben.
- Pressemitteilung des Herausgebers, 19. Oktober 2026.
- Inception-Modelle, Preise und Migrationshinweis, geprüft am 23. Oktober 2026.
- Inception-API-Schnellstart, geprüft am 23. Oktober 2026.
- Mercury-Forschungspapier, eingereicht am 17. Juni 2025; Hintergrund zur früheren Modellfamilie.
- Vals-AI-Benchmarkseite zu Mercury 3, geprüft am 23. Oktober 2026.
- Inceptions Bedingungen und Unternehmenskontrollen, geprüft am 23. Oktober 2026.
Halten Sie den Vergleich für spätere Prüfungen bereit
Wer autorisierte Quellen und die Notizen hinter einer Modellentscheidung separat aufbewahren möchte, findet in Telli.sh eine Möglichkeit. Mit einer Notiz beginnen.