Одинаковые 10,0 % ошибок, противоположное решение: как измерять точность расшифровки встреч
Word error rate оценивает слово «не» ровно так же, как слово «этот», и именно поэтому две расшифровки могут показать одинаковые 10,0 %, а пригодной окажется только одна. Здесь — полная процедура измерения: 12-минутный тестовый фрагмент, собранный по спецификации, эталонная расшифровка с замороженными правилами нормализации, точные команды cpWER и DER и оценочная карта из пяти измерений, где сырому WER отведено 10 баллов из 100.
Вот две машинные расшифровки одной и той же фразы из двадцати слов, произнесённой на продуктовой встрече.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"
(В первой: «Прия сказала, что миграция Helios сдвигается на Q3 и что нам не следует подписывать договор с подрядчиком до аудита безопасности».)
В каждой ровно две ошибки относительно того, что было сказано на самом деле. Каждая получает word error rate 10,0 %. Расшифровка A дважды потеряла артикль «the». Расшифровка B сдвинула срок на квартал вперёд и вычеркнула «not» из обязательства.
Если ваша процедура оценки ставит эти две системы на одну ступень, проблема в процедуре, а не в моделях.
Эта статья — та самая процедура измерения, которую мы вручили бы человеку, которому велели выбрать инструмент расшифровки до пятницы. Здесь разобрано, что именно считает word error rate, почему это число вводит в заблуждение именно на аудио встреч и какой протокол из пяти шагов можно пройти за один день с двумя пакетами с открытым кодом и 12-минутной записью. Отдельно мы уже доказывали, что точность расшифровки никогда не была тем, что нужно доставить пользователю. Эта статья — парная к ней: не аргумент, а метод.
Коротко:
- WER — это
(замены + пропуски + вставки) ÷ число слов в эталоне, и каждое слово весит одинаково. Отрицание «не» и артикль «the» стоят ровно столько же.- Опубликованные рейтинги сжались. В независимой таблице Artificial Analysis, просмотренной 31 августа 2026 года, первая пятёрка моделей укладывается между 1,7 % и 2,6 % AA-WER — разброс слишком узкий, чтобы выбрать победителя.
- Оценивайте вместо этого пять измерений с весами: несущие термины (30), атрибуция говорящих (25), числа и суммы (20), сегментация (15), сырой WER (10). Инструменты для самых трудных частей уже существуют —
cpWERиDERвходят в MeetEval, набор, созданный для конкурсов CHiME.
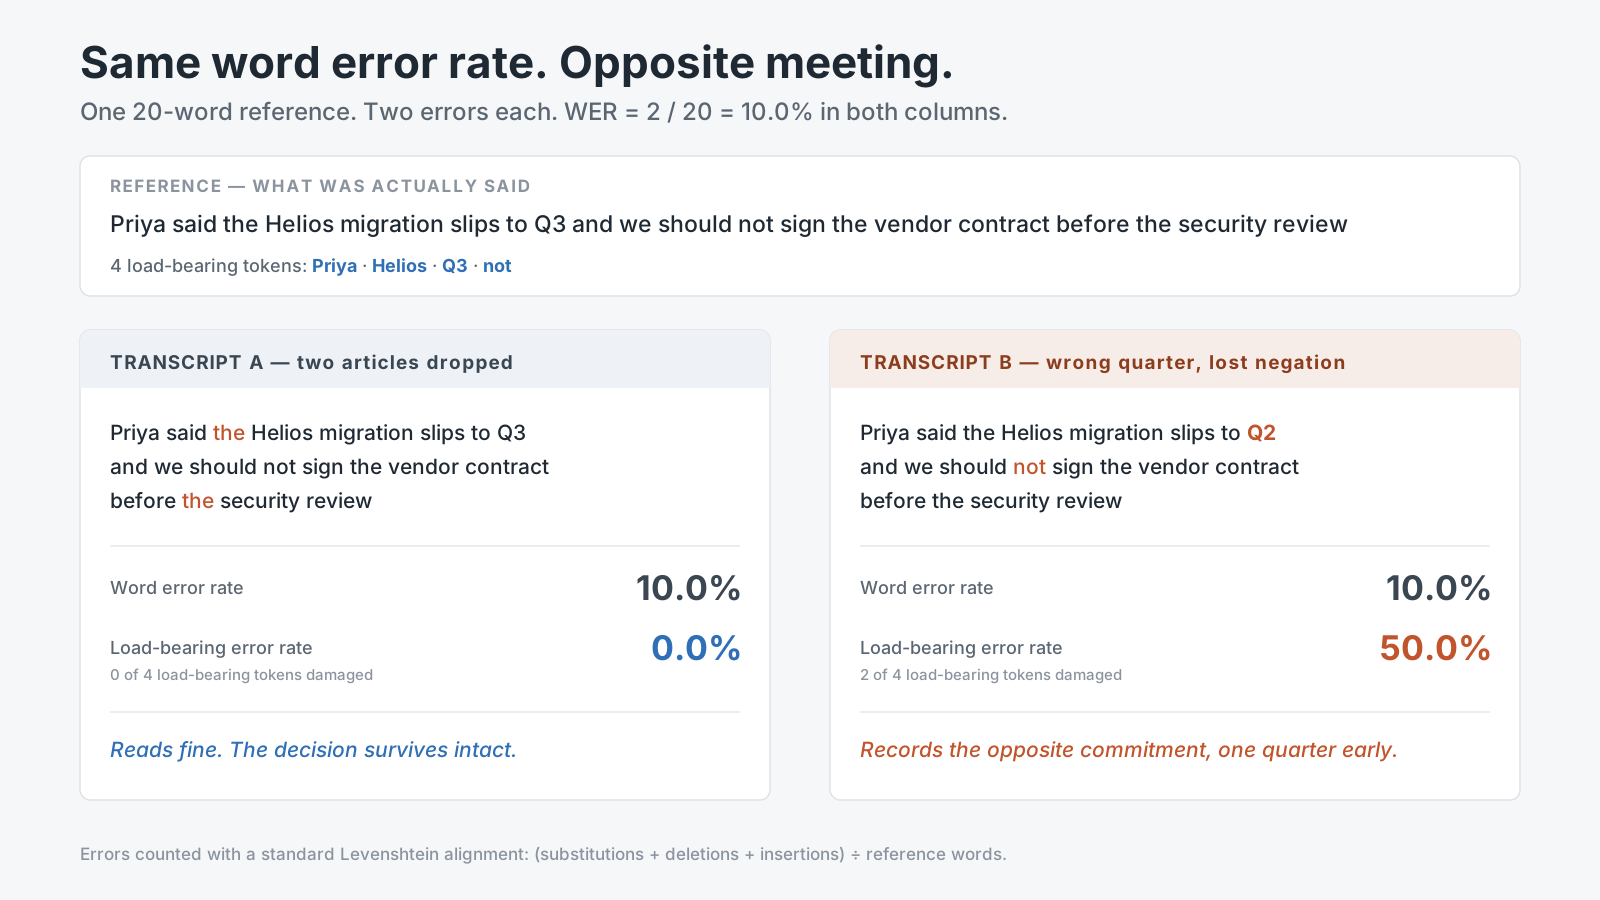
В обеих колонках по две ошибки против эталона из 20 слов. Но только одна из них по-прежнему фиксирует решение, которое комната действительно приняла.
Что именно считает word error rate, расписанное полностью
WER рождается из одного-единственного выравнивания. Возьмите эталонную расшифровку — то, о чём люди договорились как о сказанном. Возьмите вывод машины. Найдите самую дешёвую последовательность правок, превращающую одно в другое, классическим выравниванием Левенштейна, и разметьте каждую правку:
- замена, когда модель написала другое слово («deploy» услышано как «delay»),
- пропуск, когда слову эталона нет соответствия в выводе,
- вставка, когда модель выдала слово, которого никто не произносил.
Далее:
WER = (substitutions + deletions + insertions) ÷ reference words
В знаменателе длина эталона, а не гипотезы, и именно поэтому WER законно может превысить 100 %: модель, которая свободно галлюцинирует, способна набрать больше вставок, чем слов было изначально.
Разобранный пример взят из документации самого MeetEval, чтобы арифметику можно было сверить с опубликованным выводом. Эталон: "The quick brown fox jumps over the lazy dog" — девять слов. Гипотеза: "The kwick brown fox jump over lazy" — семь слов. Выравнивание находит две замены (quick→kwick, jumps→jump) и два пропуска (the, dog), вставок нет. Получается (2 + 2 + 0) ÷ 9 = 0,4444, то есть WER 44,4 %, и MeetEval печатает ровно это: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
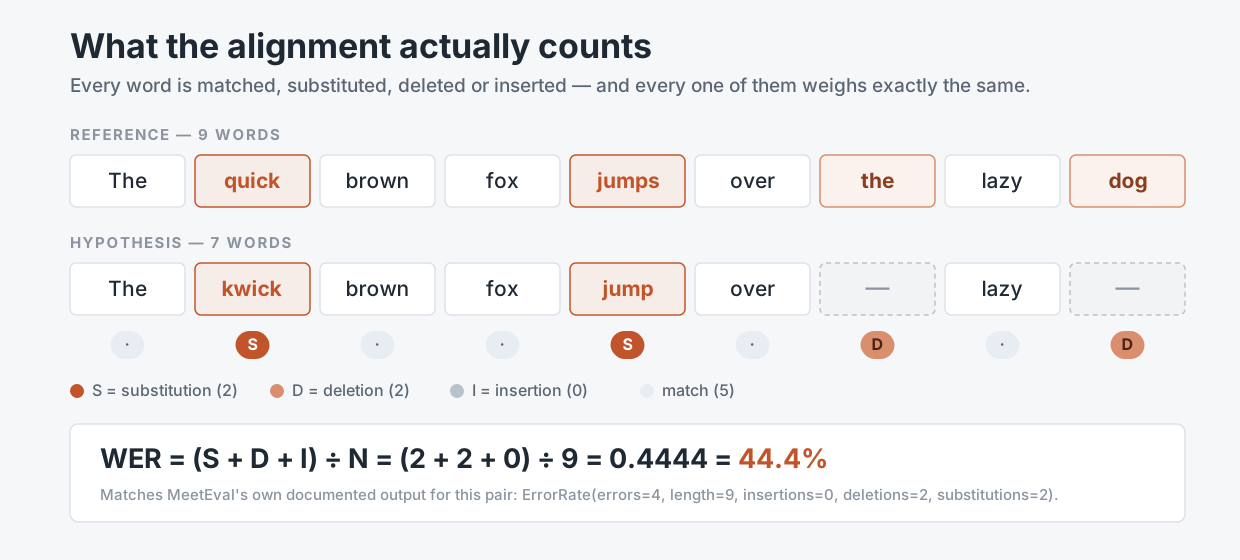
Выравнивание механическое и воспроизводимое. Чего в нём нет — так это весов. Источник: документация MeetEval, просмотрена 31 августа 2026 года.
Два свойства этой формулы важнее всего, что написано на посадочной странице любого поставщика. Первое: она плоская — метрика не подозревает, что одни слова несут встречу, а другие несут грамматику. Второе: она слепа к говорящим — стандартный WER склеивает всё в один поток, поэтому система, которая идеально расшифровала каждое слово и приписала половину не тому человеку, способна показать безупречный результат.
Почему опубликованные цифры больше не разделяют ваших кандидатов
Откройте рейтинги — и проблема становится арифметикой. Artificial Analysis, которая проводит собственные замеры вместо перепечатки заявлений поставщиков, на 31 августа 2026 года перечислила пятёрку лидеров по AA-WER так: Fun-Realtime-ASR-preview — 1,7 %, ElevenLabs Scribe v2 — 2,2 %, MAI-Transcribe-1.5 от Microsoft — 2,4 %, Smallest AI Pulse Pro — 2,4 % и Gemini 3.5 Transcribe — 2,6 %. Лучшая модель с открытыми весами, Voxtral Small от Mistral, держится на 2,8 %.
Вся верхушка рынка помещается в полосу шириной 1,1 пункта. На 45-минутной встрече примерно с 6 300 произнесёнными словами разрыв между первым и пятым местом — около 57 слов, меньше одного слова на экран расшифровки.
Есть и вторая проблема: эталонное аудио бенчмарка — не ваше аудио. AA-WER v2 — это среднее, взвешенное по длительности аудио, примерно по восьми часам из трёх источников: AA-AgentTalk — 50 %, VoxPopuli-Cleaned-AA — 25 % и Earnings22-Cleaned-AA — 25 %. Парламентские выступления и отчётные звонки записаны хорошо, произносятся по очереди и почти лишены того, что определяет внутреннюю встречу: четверо перебивают друг друга, обсуждая проект, о котором слышали только они.
Исследования по-настоящему разговорного аудио уже много лет считают это отдельной дисциплиной. Конкурс CHiME-6, опубликованный 20 апреля 2020 года Ватанабэ, Манделем, Баркером и восемнадцатью соавторами, построил свою оценку на записях званых ужинов именно потому, что естественный разговор с перекрытиями и удалёнными микрофонами ломает системы, отлично справляющиеся с читаемой речью. Корпус AMI Meeting — 100 часов записей, снятых одновременно ближними гарнитурами и микрофонами в помещении, — существует по той же причине.
Вот суть, и мы скажем её без оговорок: опубликованный WER сообщает, что модель поставщика не сломана. Он не может подсказать, у кого покупать.
Что WER ловит и чего он структурно увидеть не может
| Вид сбоя | Ловится сырым WER? | Во что обходится вам | Что действительно это измеряет |
|---|---|---|---|
| Обычное слово расслышано неверно («their»/«there») | Да, с полным весом | Почти ни во что | WER |
| Слова-паразиты и оборванные начала выброшены | Да, засчитаны как пропуски | Ни во что — часто это улучшение | WER, но обманчиво |
| Имя собственное искажено («Xochitl» → «Societal») | Да, но весом в 1 слово | Имя ответственного человека | Доля ошибок по несущим терминам |
| Неверное число или дата («Q3» → «Q2») | Да, вес 1 слово | Сорванный срок | Точность по числам, считается отдельно |
| Отрицание вычеркнуто («should not» → «should») | Да, вес 1 слово | Перевёрнутое решение | Доля ошибок по несущим терминам |
| Слова верные, говорящий не тот | Нет — WER слеп к говорящим | Никто не знает, кто взял обязательство | cpWER, DER |
| Реплики слиты в один блок | Нет | Нечитаемая стена текста | tcpWER с collar, вычитка человеком |
| Границы предложений отсутствуют | Нет — пунктуация нормализуется прочь | Резюме, угадывающее структуру | Оценка сегментации, вычитка человеком |
| Целый фрагмент выдуман в тишине | Частично — как вставки | Придуманное содержание, поданное как протокол | WER плюс отдельно прочитанное число вставок |
Нижняя половина этой таблицы — та половина, которая решает, станет ли расшифровка пригодной заметкой, и стандартный WER не видит из неё ничего. Это не изъян метрики: WER отвечает на тот вопрос, ради которого его придумали в исследованиях диктовки 1990-х. Изъян — в том, чтобы пользоваться только им в 2026 году.
Шаг 1: соберите 12-минутный фрагмент, который ведёт себя как настоящая встреча
Не оценивайте на демофайле поставщика и не оценивайте на восьми часах собственного архива. Вам нужен фрагмент, достаточно короткий, чтобы расшифровать его вручную, и достаточно плотный, чтобы что-нибудь сломать.
Целевая длительность — 12 минут. При обычном разговорном темпе около 140 слов в минуту и плотности речи порядка 75 % получается примерно 1 260 эталонных слов: достаточно, чтобы разница в 2 % по доле ошибок означала 25 слов, а не статистический шум, и достаточно мало, чтобы двое смогли аккуратно расшифровать запись за полдня-день.
Собирайте фрагмент по спецификации, а не по наитию. Наша:
- Четверо и более говорящих, включая хотя бы одного, подключённого удалённо по сжатому аудиоканалу, и хотя бы одного с неродным акцентом в рабочем языке.
- Девяносто секунд и более настоящего перекрытия речи — двое говорят одновременно, кто-то договаривает чужую фразу, кашель поверх решения. Именно на перекрёстной речи диаризация тихо разваливается, и фрагмент без неё не измеряет ничего.
- Двадцать пять и более доменных терминов: кодовые имена продуктов, внутренние аббревиатуры, названия клиентов, имена участников. Это слова с наибольшим смыслом на символ в комнате и наименьшей частотой в любом обучающем корпусе.
- Пятнадцать и более чисел: даты, кварталы, суммы в валюте, номера версий, проценты. Некоторые произнесите двусмысленно намеренно («пятнадцать» и «пятьдесят» в одну минуту).
- Три и более отрицательных решения, сформулированных естественно: «в этот релиз мы это не выкатываем», «с договором пока подождём».
- Две одновременные записи, если получится их организовать, — микрофон самого ноутбука и отдельная дорожка с гарнитуры на каждого. Это конструкция корпуса AMI, и она позволяет отделить «модель слаба» от «в комнате шумно».
Запишите один раз. Храните WAV без сжатия на 16 кГц или лучше. Каждый инструмент, который вы будете оценивать дальше, получает именно этот файл — всегда.
Шаг 2: напишите эталон, а затем заморозьте правила нормализации до того, как посчитаете хоть одну цифру
Эталонная расшифровка — это измерительный прибор, и у него есть погрешность. Artificial Analysis держит «очищенные» версии своих публичных оценочных наборов именно потому, что в исходных эталонных расшифровках были собственные ошибки; их примечание прямолинейно: очищенные версии «убирают ошибки расшифровки из эталонного текста, давая более точную ground truth для оценки моделей». Если оператору бенчмарка приходится править опубликованную ground truth, то и ваша расшифровка с первого прохода — не священное писание.
Итак: двое расшифровывают независимо, затем сверяют каждое расхождение. Заложите на пару от пяти до восьми реальных длительностей записи — то есть 12-минутный фрагмент обойдётся примерно в один рабочий день суммарных усилий. Это самая крупная статья расходов во всей процедуре, и обойти её нельзя.
Затем письменно зафиксируйте политику нормализации до того, как посчитаете хоть один балл, потому что одни только эти решения двигают итоговое число на несколько пунктов:
- Числа: «Q3» — тот же токен, что «Q три»? «сорок тысяч» равно «40 000»?
- Стяжения: считается ли «we're» совпадением с «we are»?
- Заполнители: попадают ли «э-э», «ну» и оборванные начала в эталон вообще, и оцениваются ли они?
- Регистр и пунктуация: обычно вычищаются перед подсчётом — а значит, инструмент, который расставляет знаки препинания великолепно, здесь не получает никакой заслуги, и оценивать это придётся отдельно на шаге 3.
Сохраните результат в SegLST — JSON-формате, который используют конкурсы CHiME и который принят в MeetEval по умолчанию: по одному объекту на сегмент с полями session_id, words, speaker, start_time и end_time. Поля говорящего и таймингов — именно то, что делает возможными метрики с учётом говорящих, и дописывать их задним числом мучительно.
Шаг 3: оценивайте пять измерений и дайте сырому WER десять баллов из ста
Поставьте инструменты — pip install jiwer meeteval — и оцените каждое измерение на одном и том же фрагменте. JiWER считает WER, а вместе с ним match error rate, word information lost, word information preserved и character error rate, используя реализацию минимального редакционного расстояния на RapidFuzz. MeetEval считает метрики, специфичные для встреч.
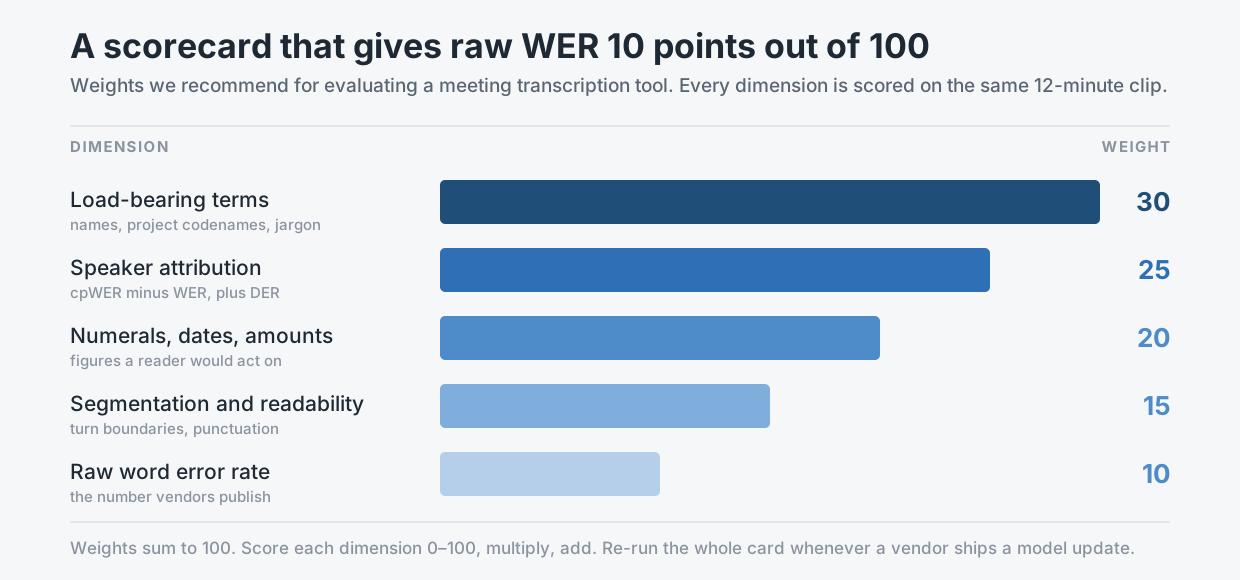
Веса, которые мы рекомендуем. Измерение, которое рекламирует каждый поставщик, стоит меньше всех остальных.
Несущие термины — 30 баллов. Разметьте в эталоне каждое имя собственное, кодовое название и кусок доменного жаргона. Затем посчитайте ту же формулу WER только по этим токенам. Результат мы называем долей ошибок по несущим терминам, и это самое предсказательное число во всём упражнении. В паре расшифровок в начале статьи несущих токенов четыре: Priya, Helios, Q3 и not. Расшифровка A не портит ни одного: 0,0 %. Расшифровка B портит два: 50,0 %. Одинаковый общий WER 10,0 % — и пятьдесят пунктов разницы по той метрике, которая имеет значение.
Атрибуция говорящих — 25 баллов. Запустите meeteval-wer cpwer -r ref.stm -h hyp.stm. Concatenated minimum-permutation WER подбирает наилучшее соответствие между говорящими эталона и гипотезы, склеивает слова каждого говорящего и оценивает результат — так что слова, приписанные не тому человеку, становятся ошибками. Затем вычтите: cpWER минус обычный WER — это разрыв атрибуции, та доля ущерба, которая возникает исключительно из-за незнания, кто говорил. Добавьте diarization error rate ради взгляда на тайминги; DER — это сумма ошибки говорящего, ложно обнаруженной речи и пропущенной речи в процентах от оцениваемого времени, определённая в разделе 6.1 плана оценки NIST RT-09 и реализованная в dscore, который MeetEval оборачивает и который читает файлы RTTM. Если ваш кандидат отдаёт таймстемпы, используйте tcpwer --collar 5 вместо cpwer, чтобы верное слово, привязанное не к тому моменту, не прощалось молча.
Числа, даты и суммы — 20 баллов. Извлеките из эталона каждый числовой токен и оцените точность точного совпадения с гипотезой, применив вашу письменно зафиксированную политику нормализации. Отчитывайтесь простой дробью — «13 из 15 верных», — а не процентом, потому что счёт мал, а процент подразумевает точность, которой у вас нет.
Сегментация и читаемость — 15 баллов. Это измерение человеческое. Пусть двое читателей, не бывших на встрече, прочтут сырой вывод и отметят, поминутно: границы предложений не на своём месте, реплики, слитые в один блок, и абзацы, которые приходится перечитывать. Пунктуацию из расчёта WER вы уже вынесли за скобки, так что это единственное место, где она вообще оценивается.
Сырой word error rate — 10 баллов. Запустите jiwer и запишите число. Это честная проверка нижней границы: всё, что выше примерно 12 % на чистом ближнем аудио, указывает на реальную акустическую проблему, которую стоит расследовать. За пределами этой границы метрика почти ничего не различает — ровно поэтому она стоит десять баллов, а не восемьдесят.
Оцените каждое измерение от 0 до 100, умножьте на его вес, сложите. Результат сопоставим между инструментами и во времени — в этом весь смысл.
Шаг 4: прогоните каждого кандидата на идентичном файле и запишите, что означало «идентичный»
Это тот шаг, который команды пропускают, и именно он обесценивает всё, что было до него.
Тот же WAV, та же частота дискретизации, никакого перекодирования между кандидатами. Тот же эталон, та же политика нормализации, применённая одним и тем же скриптом. Диаризация явно включена или явно выключена у каждого инструмента и записана в обоих случаях: инструмент, оценённый с выключенной диаризацией, несопоставим с инструментом, оценённым с включённой. Смещение по ключевым словам или сущностям выключено на первом проходе и включено на втором, оба прохода зафиксированы; Microsoft сообщает о снижении WER до 30 % при передаче списка ключевых слов в MAI-Transcribe-1.5 — величина достаточно большая, чтобы сравнение, смешивающее прогоны со смещением и без, стало бессмысленным.
Особенно следите за обработкой длинного аудио. Artificial Analysis вынуждена резать аудио Earnings22 на куски примерно по девять минут для моделей, которые не справляются надёжно с входом полной длины, и примерно по 30 секунд для моделей с более жёсткими ограничениями — в их собственном опубликованном примечании среди затронутых систем названы GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B и Qwen3 ASR Flash от Alibaba. Нарезка меняет результаты, потому что ошибки скапливаются на границах кусков. Если поставщик режет ваш файл, это свойство продукта, и его место в оценочной карте, а не в списке артефактов, которые надо исправить.
Наконец, записывайте точную строку версии модели и дату каждого прогона. «Whisper large-v3» — это не версия; whisper-large-v3, run 2026-08-31 — версия.
Шаг 5: перезапускайте карту, когда поставщик выкатывает обновление, а не когда вы вспомнили
Размещённые в облаке речевые модели меняются у вас под ногами. Имя эндпоинта остаётся прежним, а веса за ним — нет, и никто не пришлёт письмо о том, что ваши заметки по встречам стали чуть хуже справляться с именами собственными.
Три триггера должны запускать полный прогон карты — на том же фрагменте, что вы собрали на шаге 1:
- Поставщик публикует запись в changelog, затрагивающую модель, диаризатор или слой пунктуации и форматирования.
- Истёк календарный интервал — раз в квартал достаточно для большинства команд, раз в месяц, если вывод расшифровки питает что-то автоматизированное дальше по цепочке.
- Ваша доля ошибок по несущим терминам сдвинулась более чем на 5 пунктов между любыми двумя прогонами: это должно запускать расследование раньше, чем миграцию.
Держите все прогоны в одной таблице: дата, строка версии модели, пять оценок по измерениям, взвешенный итог. После трёх-четырёх прогонов у вас появится то, чего не даст ни один рейтинг, — временной ряд того, как конкретный продукт ведёт себя на аудио, звучащем как ваши настоящие встречи.
Главное: точность — это измерение вашей комнаты, а не свойство модели
Word error rate — свойство модели на корпусе. А нужно вам свойство модели на вашем аудио, для вашего словаря, с вашими людьми, говорящими друг поверх друга, — и этой величины не существует, пока вы её не измерите. Опубликовать её за вас никто не может, потому что ни у кого другого в эталонной расшифровке нет ваших кодовых имён.
Хорошая новость в том, что измерение стоит дёшево. Одна 12-минутная запись, один рабочий день аккуратной расшифровки, две команды pip install и оценочная карта, помещающаяся на страницу. Дорогая альтернатива — та, которую большинство команд выбирает по умолчанию: решить по опубликованному проценту и обнаружить разницу через полгода, в заметке, где написано, что команда согласилась на то, от чего она явно отказалась.
В чём вы предпочли бы ошибиться — в десятой доле процента или в решении?
Где здесь Telli.sh: мы строим ровно те слои, которым эта карта даёт вес. Telli.sh выполняет разделение говорящих, сегментацию, доработку текста и резюмирование поверх распознавания речи, с переводом на 44 целевых языка и интерфейсом на 15 языках, потому что те 90 баллов карты, которые не являются сырым WER, — это и есть место, где расшифровка превращается в заметку, с которой можно что-то сделать. Если вам нужна реальная точка данных, а не бенчмарк, прогоните через сервис свой 12-минутный фрагмент и оцените результат по процедуре выше.
Источники
- MeetEval — набор инструментов для оценки расшифровки встреч — команды cpWER, tcpWER, ORC-WER, MIMO-WER и DI-cpWER, формат SegLST и разобранный пример
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), просмотрено 31 августа 2026 года - JiWER — пакет для оценки распознавания речи — WER, MER, WIL, WIP и CER через минимальное редакционное расстояние RapidFuzz
- dscore — инструменты оценки диаризации — DER как сумма ошибки говорящего, ложно обнаруженной речи и пропущенной речи, по разделу 6.1 плана оценки NIST RT-09
- Рейтинг speech-to-text от Artificial Analysis — методология AA-WER v2 (~8 часов: AA-AgentTalk 50 %, VoxPopuli-Cleaned-AA 25 %, Earnings22-Cleaned-AA 25 %), цифры первой пятёрки моделей, примечание об очищенных эталонах и примечание о нарезке Earnings22 — всё просмотрено 31 августа 2026 года
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 апреля 2020 года — сегментированный и несегментированный многоголосые треки и конструкция записей званого ужина
- The AMI Meeting Corpus — 100 часов записей встреч, снятых синхронизированными ближними и удалёнными микрофонами
- MAI-Transcribe в Azure Speech — Microsoft Learn — смещение по ключевым словам и задокументированные ограничения
- Наша более ранняя статья о том, почему точность расшифровки никогда не была тем, что нужно доставить