Mesma taxa de erro de 10,0 %, decisão oposta: como medir de verdade a precisão da transcrição de reuniões
A taxa de erro de palavras pesa a palavra «não» exatamente como pesa a palavra «o», e é por isso que duas transcrições podem parar nos mesmos 10,0 % e só uma delas ser aproveitável. Aqui está o procedimento de medição completo: um clipe de teste de 12 minutos construído sob especificação, uma transcrição de referência com regras de normalização congeladas, os comandos exatos de cpWER e DER, e um placar de cinco dimensões que dá ao WER bruto 10 pontos de 100.
Aqui estão duas transcrições automáticas da mesma frase de vinte palavras, dita em uma reunião de produto.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"
(Na primeira: «Priya disse que a migração do Helios escorrega para o Q3 e que não devemos assinar o contrato com o fornecedor antes da revisão de segurança».)
Cada uma contém exatamente dois erros em relação ao que foi realmente dito. Cada uma marca uma taxa de erro de palavras de 10,0 %. A transcrição A derrubou o artigo «the» duas vezes. A transcrição B puxou um prazo um trimestre para frente e apagou o «not» de um compromisso.
Se o seu processo de avaliação classifica esses dois sistemas como iguais, o problema é o processo — não os modelos.
Este texto é o procedimento de medição que entregaríamos a alguém que recebeu a missão de escolher uma ferramenta de transcrição até sexta-feira. Ele cobre o que exatamente a taxa de erro de palavras conta, por que o número engana justamente no áudio de reuniões, e um protocolo de cinco passos que você roda em uma tarde com dois pacotes de código aberto e uma gravação de 12 minutos. Já argumentamos em outro lugar que a precisão da transcrição nunca foi a entrega. Este é o texto irmão — não a tese, o método.
Em resumo:
- WER é
(substituições + deleções + inserções) ÷ palavras de referência, e cada palavra carrega peso idêntico. A negação «não» e o artigo «o» custam o mesmo.- Os rankings publicados se comprimiram. No placar independente da Artificial Analysis, consultado em 31 de agosto de 2026, os cinco primeiros modelos ficam entre 1,7 % e 2,6 % de AA-WER — uma faixa estreita demais para tirar dela um vencedor.
- Avalie cinco dimensões, com pesos: termos que sustentam a reunião (30), atribuição de falantes (25), números e valores (20), segmentação (15), WER bruto (10). O ferramental para as partes difíceis já existe —
cpWEReDERvêm no MeetEval, o toolkit criado para os desafios CHiME.
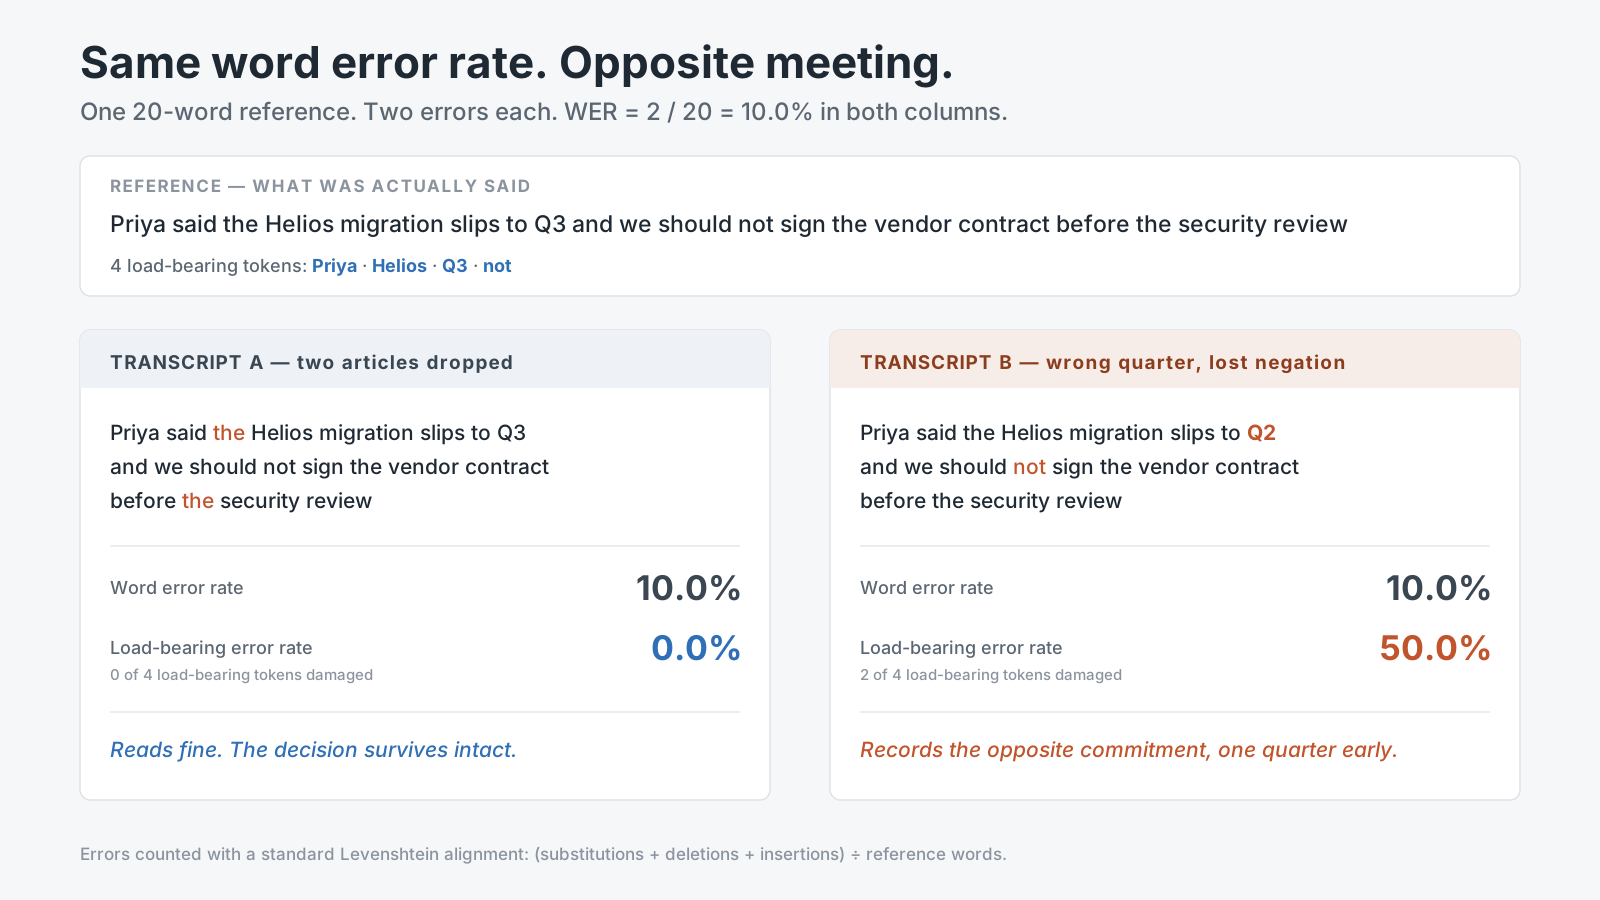
As duas colunas contêm dois erros contra uma referência de 20 palavras. Só uma delas ainda registra a decisão que a sala de fato tomou.
O que a taxa de erro de palavras conta, escrito por extenso
O WER nasce de um único alinhamento. Pegue a transcrição de referência — aquilo que humanos concordam ter sido dito. Pegue a saída da máquina. Encontre a sequência de edições mais barata que transforma uma na outra, usando o clássico alinhamento de Levenshtein, e rotule cada edição:
- uma substituição quando o modelo escreveu outra palavra («deploy» ouvido como «delay»),
- uma deleção quando uma palavra da referência não tem correspondente na saída,
- uma inserção quando o modelo produziu uma palavra que ninguém falou.
Então:
WER = (substitutions + deletions + insertions) ÷ reference words
O denominador é o comprimento da referência, não o da hipótese, e é por isso que o WER pode legitimamente passar de 100 %: um modelo que alucina à vontade acumula mais inserções do que havia palavras para começar.
Um exemplo resolvido, tirado da própria documentação do MeetEval para que a aritmética seja conferível contra uma saída publicada. Referência: "The quick brown fox jumps over the lazy dog" — nove palavras. Hipótese: "The kwick brown fox jump over lazy" — sete palavras. O alinhamento encontra duas substituições (quick→kwick, jumps→jump) e duas deleções (the, dog), nenhuma inserção. Isso dá (2 + 2 + 0) ÷ 9 = 0,4444, um WER de 44,4 %, e o MeetEval imprime exatamente isso: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
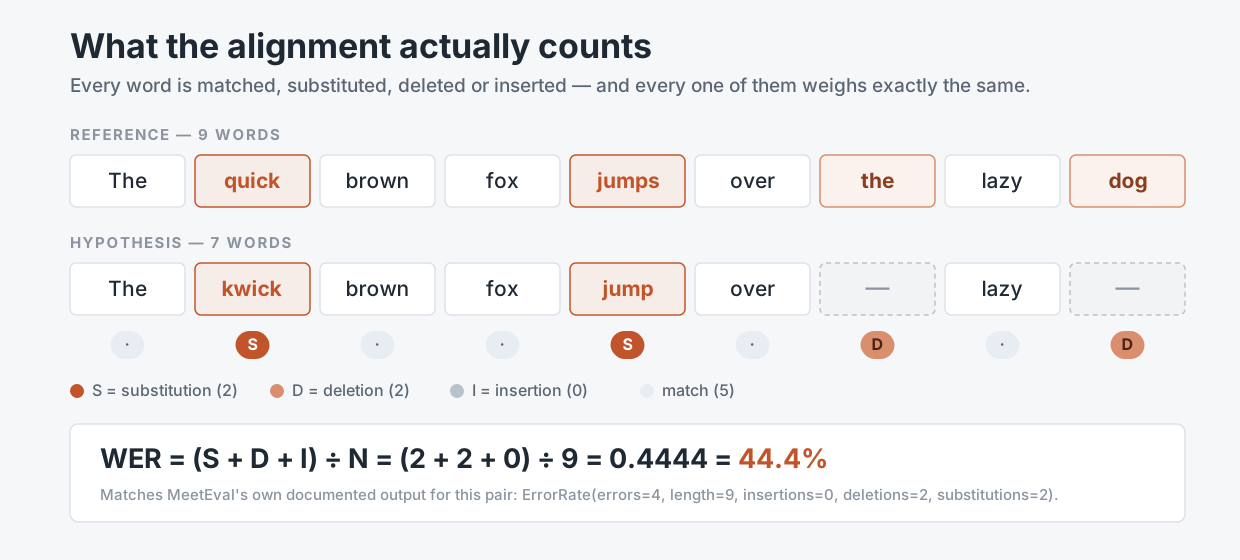
O alinhamento é mecânico e reprodutível. O que ele não é, é ponderado. Fonte: documentação do MeetEval, consultada em 31 de agosto de 2026.
Duas propriedades dessa fórmula importam mais do que qualquer coisa escrita na landing page de um fornecedor. Primeira, ela é plana: a métrica não faz ideia de que algumas palavras carregam a reunião e outras carregam a gramática. Segunda, ela é cega a falantes: o WER padrão concatena tudo em um fluxo só, então um sistema que transcreve cada palavra com perfeição e atribui metade delas à pessoa errada consegue exibir uma nota impecável.
Por que os números publicados já não separam os seus candidatos
Abra os rankings e o problema vira aritmética. A Artificial Analysis, que roda avaliações próprias em vez de reimprimir alegações de fornecedores, listou em 31 de agosto de 2026 seus cinco melhores modelos por AA-WER assim: Fun-Realtime-ASR-preview com 1,7 %, ElevenLabs Scribe v2 com 2,2 %, MAI-Transcribe-1.5 da Microsoft com 2,4 %, Smallest AI Pulse Pro com 2,4 % e Gemini 3.5 Transcribe com 2,6 %. O melhor modelo de pesos abertos, o Voxtral Small da Mistral, fica em 2,8 %.
O topo inteiro do mercado cabe dentro de uma faixa de 1,1 ponto. Em uma reunião de 45 minutos com cerca de 6.300 palavras faladas, a distância entre o primeiro e o quinto colocado é de aproximadamente 57 palavras — menos de uma palavra por tela de transcrição.
Há um segundo problema: o áudio do benchmark não é o seu áudio. O AA-WER v2 é uma média ponderada pela duração do áudio sobre cerca de oito horas vindas de três fontes: AA-AgentTalk com 50 %, VoxPopuli-Cleaned-AA com 25 % e Earnings22-Cleaned-AA com 25 %. Discursos parlamentares e teleconferências de resultados são bem gravados, ditos em turnos e praticamente livres daquilo que define uma reunião interna — quatro pessoas se interrompendo sobre um projeto do qual só elas ouviram falar.
A pesquisa sobre áudio genuinamente conversacional trata isso como disciplina separada há anos. O desafio CHiME-6, publicado em 20 de abril de 2020 por Watanabe, Mandel, Barker e dezoito coautores, construiu sua avaliação sobre gravações de jantares justamente porque conversa natural, com sobreposição e microfones distantes, quebra sistemas que vão bem em fala lida. O AMI Meeting Corpus, 100 horas de gravações capturadas tanto com headsets próximos quanto com microfones de sala, existe pelo mesmo motivo.
Aqui está o ponto, e vamos dizê-lo sem rodeios: um WER publicado diz que o modelo de um fornecedor não está quebrado. Ele não consegue dizer de qual fornecedor você deve comprar.
O que o WER captura e o que ele estruturalmente não consegue ver
| Modo de falha | Capturado pelo WER bruto? | Quanto custa a você | O que realmente mede isso |
|---|---|---|---|
| Palavra comum mal ouvida («their»/«there») | Sim, com peso total | Quase nada | WER |
| Vícios de linguagem e falsos começos descartados | Sim, contados como deleções | Nada — muitas vezes é melhoria | WER, de forma enganosa |
| Nome próprio deturpado («Xochitl» → «Societal») | Sim, mas com peso de 1 palavra | O nome da pessoa responsável | Taxa de erro nos termos que sustentam a reunião |
| Número ou data errados («Q3» → «Q2») | Sim, peso de 1 palavra | Um prazo perdido | Precisão numérica, avaliada à parte |
| Negação apagada («should not» → «should») | Sim, peso de 1 palavra | A decisão invertida | Taxa de erro nos termos que sustentam a reunião |
| Palavras certas, falante errado | Não — o WER é cego a falantes | Ninguém sabe quem se comprometeu | cpWER, DER |
| Turnos de fala fundidos em um bloco só | Não | Um paredão de texto ilegível | tcpWER com collar, leitura humana |
| Limites de frase ausentes | Não — a pontuação é normalizada fora | Um resumo que chuta a estrutura | Nota de segmentação, leitura humana |
| Trecho inteiro alucinado durante o silêncio | Em parte — como inserções | Conteúdo inventado apresentado como registro | WER mais a contagem de inserções lida à parte |
A metade de baixo dessa tabela é a metade que decide se uma transcrição vira uma nota utilizável, e o WER padrão não enxerga nada disso. Não é um defeito da métrica — o WER responde à pergunta para a qual foi projetado, na pesquisa de ditado dos anos 1990. É um defeito de usá-lo sozinho em 2026.
Passo 1: monte um clipe de 12 minutos que se comporte como uma reunião de verdade
Não avalie no arquivo de demonstração do fornecedor e não avalie em oito horas do seu próprio arquivo. Você precisa de um clipe curto o bastante para ser transcrito à mão e denso o bastante para quebrar coisas.
Mire em 12 minutos. Em um ritmo conversacional normal de cerca de 140 palavras por minuto e com densidade de fala em torno de 75 %, isso dá aproximadamente 1.260 palavras de referência — o suficiente para que uma diferença de 2 % na taxa de erro sejam 25 palavras em vez de ruído estatístico, e pouco o bastante para que duas pessoas transcrevam com cuidado em uma tarde.
Monte o clipe seguindo uma especificação, não o feeling. A nossa:
- Quatro ou mais falantes, incluindo pelo menos um entrando remotamente por um canal de áudio comprimido e pelo menos um sotaque não nativo no idioma de trabalho.
- Noventa segundos ou mais de sobreposição real — duas pessoas falando ao mesmo tempo, alguém terminando a frase de outro, uma tosse por cima de uma decisão. É na fala cruzada que a diarização se desfaz em silêncio, e um clipe sem ela não mede nada.
- Vinte e cinco ou mais termos de domínio: codinomes de produto, siglas internas, nomes de clientes, nomes dos participantes. São as palavras com maior significado por caractere na sala e a menor frequência em qualquer corpus de treino.
- Quinze ou mais numerais: datas, trimestres, valores em moeda, números de versão, porcentagens. Fale alguns deles de forma ambígua de propósito («quinze» e «cinquenta» no mesmo minuto).
- Três ou mais decisões negadas, ditas com naturalidade: «isso a gente não entrega nesta release», «vamos segurar o contrato por enquanto».
- Duas gravações simultâneas quando der para organizar — o microfone do próprio notebook e uma trilha de headset por falante. É o desenho do corpus AMI, e permite separar «o modelo é fraco» de «a sala é barulhenta».
Grave uma vez só. Guarde o WAV sem compressão a 16 kHz ou melhor. Toda ferramenta que você avaliar daqui em diante recebe este arquivo idêntico, para sempre.
Passo 2: escreva a referência — e congele as regras de normalização antes de calcular qualquer nota
A transcrição de referência é um instrumento de medição, e tem barras de erro. A Artificial Analysis mantém versões «limpas» de seus conjuntos públicos de avaliação justamente porque as transcrições de referência originais continham erros de transcrição próprios; a nota deles é direta: as versões limpas «removem erros de transcrição do texto de referência, oferecendo uma ground truth mais precisa para a avaliação de modelos». Se quem opera um benchmark precisa corrigir a ground truth publicada, a sua transcrição de primeira passada também não é evangelho.
Portanto: duas pessoas transcrevem de forma independente e depois reconciliam cada diferença. Reserve de cinco a oito vezes o tempo real para a dupla, o que coloca um clipe de 12 minutos em cerca de um dia útil de esforço combinado. Esse é o maior custo isolado de todo o procedimento e não há como contorná-lo.
Depois escreva a sua política de normalização antes de calcular uma única nota, porque essas escolhas sozinhas movem o número final em vários pontos:
- Números: «Q3» é o mesmo token que «Q três»? «quarenta mil» equivale a «40.000»?
- Contrações: «we're» casa com «we are»?
- Vícios de linguagem: «hum», «ãã» e os falsos começos aparecem na referência, e são pontuados?
- Maiúsculas e pontuação: normalmente removidas antes do cálculo — o que significa que uma ferramenta que pontua lindamente não ganha crédito nenhum aqui, e você precisa avaliar isso à parte no passo 3.
Guarde o resultado em SegLST, o formato JSON que os desafios CHiME usam e que é o padrão do MeetEval: um objeto por segmento com session_id, words, speaker, start_time e end_time. Os campos de falante e de tempo são o que torna possíveis as métricas conscientes de falante, e acrescentá-los depois é um suplício.
Passo 3: pontue cinco dimensões, e dê ao WER bruto dez pontos em cem
Instale o ferramental — pip install jiwer meeteval — e pontue cada dimensão no mesmo clipe. O JiWER calcula o WER junto com match error rate, word information lost, word information preserved e character error rate, usando uma implementação de distância mínima de edição via RapidFuzz. O MeetEval calcula as métricas específicas de reunião.
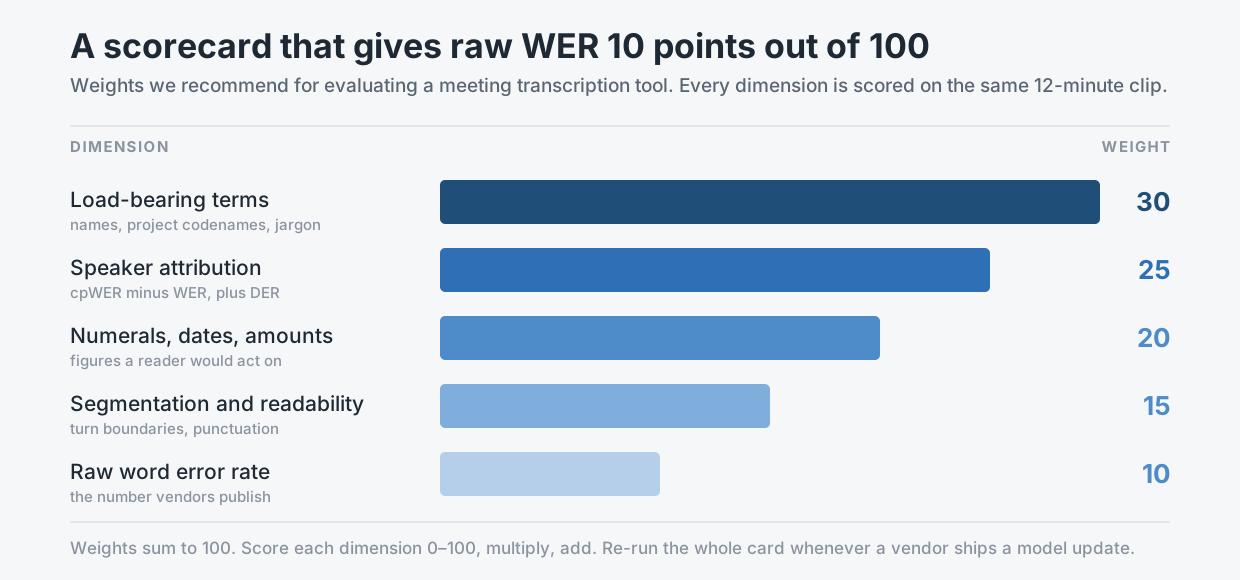
Os pesos que recomendamos. A dimensão que todo fornecedor anuncia é a que vale menos pontos.
Termos que sustentam a reunião — 30 pontos. Marque na referência cada nome próprio, codinome e jargão de domínio. Depois calcule a mesma fórmula do WER apenas sobre esses tokens. Chamamos o resultado de taxa de erro nos termos que sustentam a reunião, e é o número isolado mais preditivo do exercício inteiro. No par de transcrições no topo deste texto, os quatro tokens que sustentam a reunião são Priya, Helios, Q3 e not. A transcrição A não estraga nenhum: 0,0 %. A transcrição B estraga dois: 50,0 %. Mesmo WER geral de 10,0 %, cinquenta pontos de diferença na métrica que importa.
Atribuição de falantes — 25 pontos. Rode meeteval-wer cpwer -r ref.stm -h hyp.stm. O concatenated minimum-permutation WER encontra o melhor mapeamento entre os falantes da referência e os da hipótese, concatena as palavras de cada falante e pontua o resultado — de modo que palavras atribuídas à pessoa errada viram erros. Depois subtraia: cpWER menos o WER simples é a lacuna de atribuição, a parcela do estrago que vem puramente de não saber quem falou. Some a diarization error rate para a visão de tempo; o DER é a soma de erro de falante, fala em falso alarme e fala perdida, como porcentagens do tempo avaliado, definido na seção 6.1 do plano de avaliação NIST RT-09 e implementado no dscore, que o MeetEval encapsula e que lê arquivos RTTM. Se o seu candidato suporta timestamps, use tcpwer --collar 5 no lugar de cpwer, para que uma palavra correta grudada no momento errado não seja perdoada em silêncio.
Números, datas e valores — 20 pontos. Extraia da referência cada token numérico e pontue a precisão por correspondência exata contra a hipótese, depois de aplicar a política de normalização que você escreveu. Reporte como fração simples — «13 de 15 corretos» — e não como porcentagem, porque as contagens são pequenas e uma porcentagem sugere uma precisão que você não tem.
Segmentação e legibilidade — 15 pontos. Esta é humana. Peça a dois leitores que não participaram da reunião que leiam a saída bruta e marquem, por minuto: limites de frase no lugar errado, turnos de fala fundidos em um bloco só e parágrafos que obrigam a reler. A pontuação foi normalizada para fora do cálculo do WER, então este é o único lugar em que ela é avaliada.
Taxa de erro de palavras bruta — 10 pontos. Rode o jiwer e anote o número. É uma checagem de piso legítima: qualquer coisa acima de aproximadamente 12 % em áudio limpo e de microfone próximo indica um problema acústico real que vale investigar. Passado esse piso, ela quase não discrimina nada, que é exatamente o motivo de valer dez pontos e não oitenta.
Pontue cada dimensão de 0 a 100, multiplique pelo peso, some. O resultado é comparável entre ferramentas e ao longo do tempo, que é o objetivo inteiro.
Passo 4: rode todo candidato no arquivo idêntico, e registre o que «idêntico» significou
Este é o passo que os times pulam, e é o que invalida tudo o que veio antes.
Mesmo WAV, mesma taxa de amostragem, nenhuma recodificação entre candidatos. Mesma referência, mesma política de normalização aplicada pelo mesmo script. Diarização explicitamente ligada ou explicitamente desligada em cada ferramenta, e registrada dos dois jeitos — uma ferramenta avaliada com diarização desligada não é comparável a uma avaliada com ela ligada. Viés por palavra-chave ou entidade desligado na primeira passada e ligado numa segunda passada, ambas registradas; a Microsoft relata até 30 % de redução de WER ao fornecer uma lista de palavras-chave ao MAI-Transcribe-1.5, o que é grande o bastante para tornar sem sentido qualquer comparação que misture execuções com e sem viés.
Vigie em especial o tratamento de áudio longo. A Artificial Analysis precisa fatiar o áudio do Earnings22 em blocos de cerca de nove minutos para modelos que não lidam de forma confiável com entrada de comprimento total, e de cerca de 30 segundos para modelos com limites mais apertados — a nota publicada por eles cita GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B e o Qwen3 ASR Flash da Alibaba entre os sistemas afetados. Fatiar muda os resultados, porque os erros se concentram nas fronteiras. Se um fornecedor fatia o seu arquivo, isso é uma propriedade do produto e pertence ao placar, não um artefato a ser corrigido.
Por fim, registre a string exata da versão do modelo e a data de cada execução. «Whisper large-v3» não é uma versão; whisper-large-v3, run 2026-08-31 é.
Passo 5: refaça o placar quando o fornecedor publica, não quando você lembra
Modelos de fala hospedados mudam debaixo de você. O nome do endpoint continua constante enquanto os pesos por trás dele não continuam, e ninguém manda um e-mail avisando que as suas notas de reunião ficaram um pouco piores em nomes próprios.
Três gatilhos devem disparar uma nova rodada do placar completo, no mesmo clipe montado no passo 1:
- O fornecedor publica uma entrada de changelog que toca no modelo, no diarizador ou na camada de pontuação e formatação.
- Passa um intervalo de calendário — trimestral basta para a maioria dos times, mensal se a saída da transcrição alimenta algo automatizado adiante.
- A sua taxa de erro nos termos que sustentam a reunião varia mais de 5 pontos entre duas execuções quaisquer, o que deve disparar uma investigação antes de disparar uma migração.
Guarde toda execução em uma única tabela: data, string de versão do modelo, as cinco notas dimensionais, o total ponderado. Depois de três ou quatro rodadas você é dono de algo que ranking nenhum pode lhe dar — uma série temporal de como um produto específico se comporta em áudio que soa como as suas reuniões reais.
A conclusão: precisão é uma medida da sua sala, não uma propriedade do modelo
A taxa de erro de palavras é uma propriedade de um modelo sobre um corpus. O que você precisa de fato é de uma propriedade de um modelo no seu áudio, para o seu vocabulário, com as suas pessoas falando por cima umas das outras — e essa grandeza não existe até você medi-la. Ninguém pode publicá-la por você, porque ninguém mais tem os seus codinomes na transcrição de referência.
A boa notícia é que a medição é barata. Uma gravação de 12 minutos, um dia útil de transcrição cuidadosa, dois pip installs e um placar que cabe em uma página. A alternativa cara é aquela que a maioria dos times escolhe por inércia: decidir por uma porcentagem publicada e descobrir a diferença seis meses depois, em uma nota que diz que o time concordou com algo que recusou explicitamente.
Sobre qual número você preferiria estar errado — uma casa decimal ou uma decisão?
Onde a Telli.sh entra: construímos justamente as camadas que este placar pondera. A Telli.sh roda separação de falantes, segmentação, refinamento e sumarização em cima do reconhecimento de fala, com tradução para 44 idiomas de destino e uma interface em 15, porque os 90 pontos daquele placar que não são WER bruto são onde uma transcrição vira uma nota sobre a qual alguém consegue agir. Se você quer um dado real em vez de um benchmark, passe o seu clipe de 12 minutos por ela e pontue o resultado com o procedimento acima.
Fontes
- MeetEval — um toolkit de avaliação de transcrição de reuniões — comandos cpWER, tcpWER, ORC-WER, MIMO-WER e DI-cpWER, o formato SegLST e o exemplo resolvido
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), consultado em 31 de agosto de 2026 - JiWER — pacote de avaliação de reconhecimento de fala — WER, MER, WIL, WIP e CER via distância mínima de edição do RapidFuzz
- dscore — ferramentas de pontuação de diarização — o DER como erro de falante mais fala em falso alarme mais fala perdida, conforme a seção 6.1 do plano de avaliação NIST RT-09
- Ranking de speech-to-text da Artificial Analysis — metodologia AA-WER v2 (~8 horas entre AA-AgentTalk 50 %, VoxPopuli-Cleaned-AA 25 %, Earnings22-Cleaned-AA 25 %), os números dos cinco primeiros modelos, a nota sobre referências limpas e a nota sobre o fatiamento do Earnings22, todas consultadas em 31 de agosto de 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 de abril de 2020 — as trilhas multifalante segmentada e não segmentada, e o desenho das gravações de jantar
- The AMI Meeting Corpus — 100 horas de gravações de reunião capturadas com microfones próximos e de sala sincronizados
- MAI-Transcribe no Azure Speech — Microsoft Learn — o viés por palavra-chave e as limitações documentadas
- Nosso texto anterior sobre por que a precisão da transcrição nunca foi a entrega