Même taux d'erreur de 10,0 %, décision opposée : comment mesurer la précision de transcription d'une réunion
Le taux d'erreur sur les mots accorde exactement le même poids au mot « ne… pas » qu'au mot « le ». C'est pourquoi deux transcriptions peuvent toutes deux afficher 10,0 % et une seule être exploitable. Voici la procédure de mesure complète : un extrait de test de 12 minutes construit selon un cahier des charges de réunion, une transcription de référence avec des règles de normalisation figées, les commandes cpWER et DER exactes, et une grille à cinq dimensions qui n'accorde au WER brut que 10 points sur 100.
Voici deux transcriptions automatiques de la même phrase de vingt mots, prononcée en réunion produit.
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review" (en substance : Priya a dit que la migration Helios glisse au T3 et que nous ne devrions pas signer le contrat fournisseur avant la revue de sécurité.)
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review" (en substance : Priya a dit que la migration Helios glisse au T2 et que nous devrions signer le contrat fournisseur avant la revue de sécurité.)
Chacune contient exactement deux erreurs par rapport à ce qui a réellement été dit. Chacune obtient un taux d'erreur sur les mots de 10,0 %. La transcription A a perdu deux fois l'article "the". La transcription B a avancé une échéance d'un trimestre et supprimé le mot "not" d'un engagement.
Si votre procédure d'évaluation classe ces deux systèmes à égalité, le problème est la procédure — pas les modèles.
Ce billet est la procédure de mesure que nous remettrions à quelqu'un chargé de choisir un outil de transcription d'ici vendredi. Il détaille ce que le taux d'erreur sur les mots compte exactement, pourquoi ce chiffre induit en erreur sur l'audio de réunion en particulier, et un protocole en cinq étapes que vous pouvez dérouler en un après-midi avec deux paquets open source et un enregistrement de 12 minutes. Nous avons soutenu ailleurs que la précision de transcription seule n'a jamais été le livrable. Ceci en est le pendant — non pas l'argument, mais la méthode.
En bref :
- Le WER vaut
(substitutions + deletions + insertions) ÷ reference words, et chaque mot y pèse identiquement. La négation « pas » et l'article « le » coûtent le même prix.- Les classements publiés se sont resserrés. Sur le tableau indépendant d'Artificial Analysis, consulté le 31 août 2026, les cinq meilleurs modèles se tiennent entre 1,7 % et 2,6 % d'AA-WER — un écart bien trop étroit pour y désigner un vainqueur.
- Évaluez plutôt cinq dimensions, pondérées : termes porteurs de sens (30), attribution des locuteurs (25), nombres et montants (20), segmentation (15), WER brut (10). L'outillage pour les parties difficiles existe déjà —
cpWERetDERsont livrés dans MeetEval, la boîte à outils née des défis CHiME.
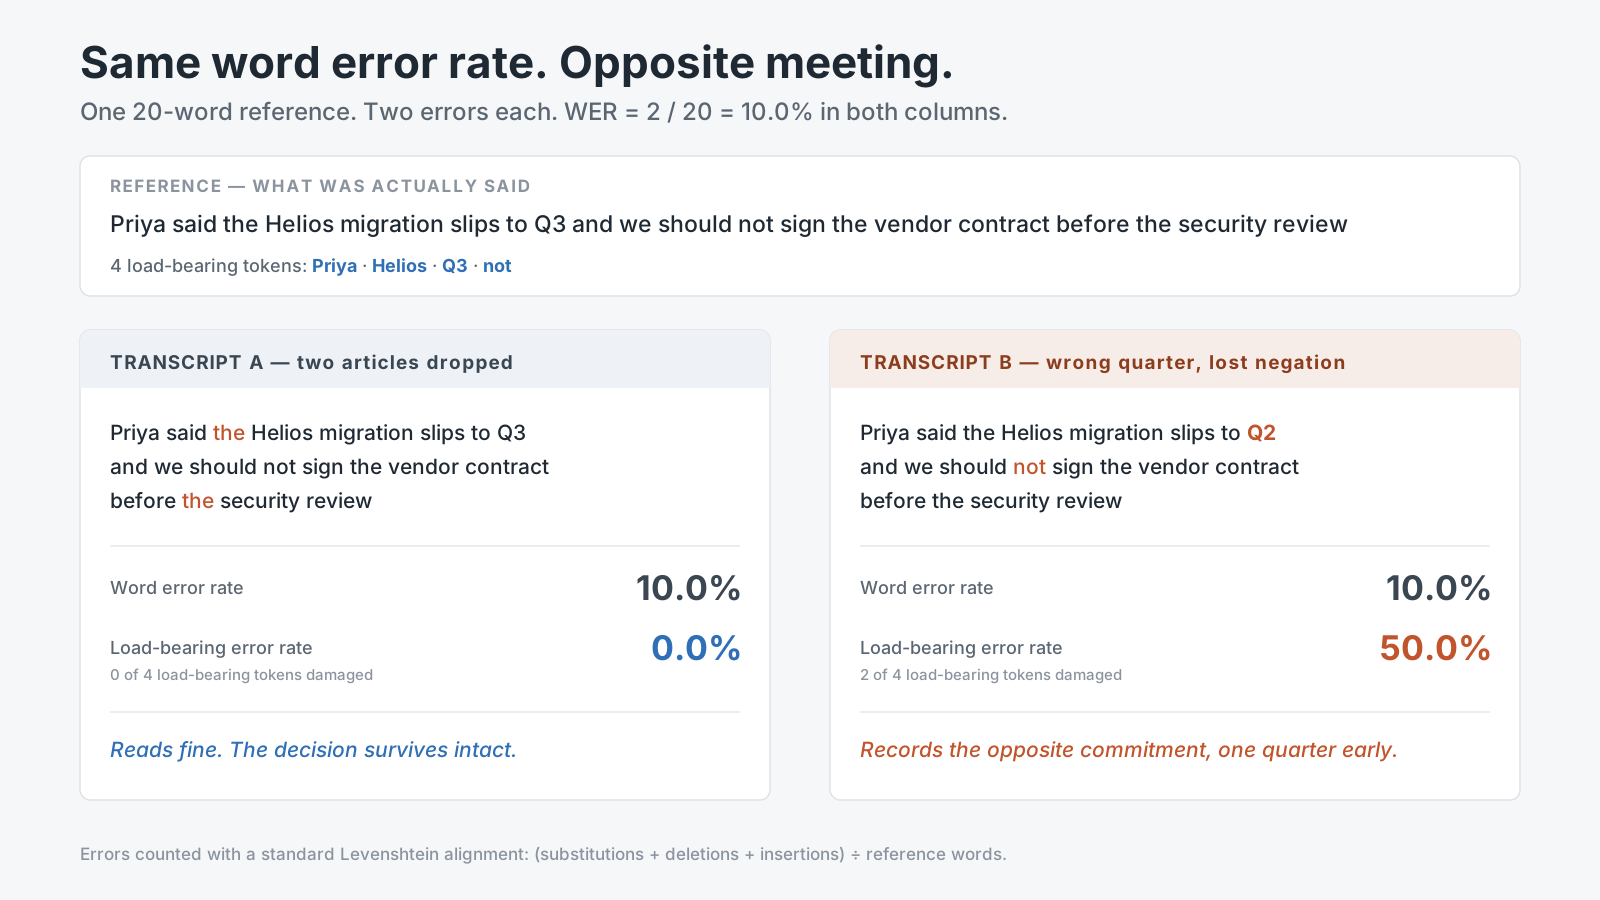
Les deux colonnes contiennent deux erreurs face à une référence de 20 mots. Une seule consigne encore la décision que la salle a réellement prise.
Ce que compte le taux d'erreur sur les mots, écrit en entier
Le WER découle d'un unique alignement. Prenez la transcription de référence — ce dont des humains conviennent qu'il a été dit. Prenez la sortie de la machine. Cherchez la suite d'éditions la moins coûteuse qui transforme l'une en l'autre, via l'alignement de Levenshtein classique, et étiquetez chaque édition :
- une substitution quand le modèle a écrit un autre mot (« deploy » entendu « delay »),
- une suppression quand un mot de la référence n'a aucun équivalent dans la sortie,
- une insertion quand le modèle a produit un mot que personne n'a prononcé.
Puis :
WER = (substitutions + deletions + insertions) ÷ reference words
Le dénominateur est la longueur de la référence, pas celle de l'hypothèse, et c'est pourquoi le WER peut légitimement dépasser 100 % — un modèle qui hallucine librement peut accumuler plus d'insertions qu'il n'y avait de mots au départ.
Un exemple travaillé, tiré de la documentation de MeetEval afin que le calcul reste vérifiable contre une sortie publiée. Référence : "The quick brown fox jumps over the lazy dog" — neuf mots. Hypothèse : "The kwick brown fox jump over lazy" — sept mots. L'alignement trouve deux substitutions (quick→kwick, jumps→jump) et deux suppressions (the, dog), aucune insertion. Cela donne (2 + 2 + 0) ÷ 9 = 0,4444, un WER de 44,4 %, et MeetEval affiche exactement cela : ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
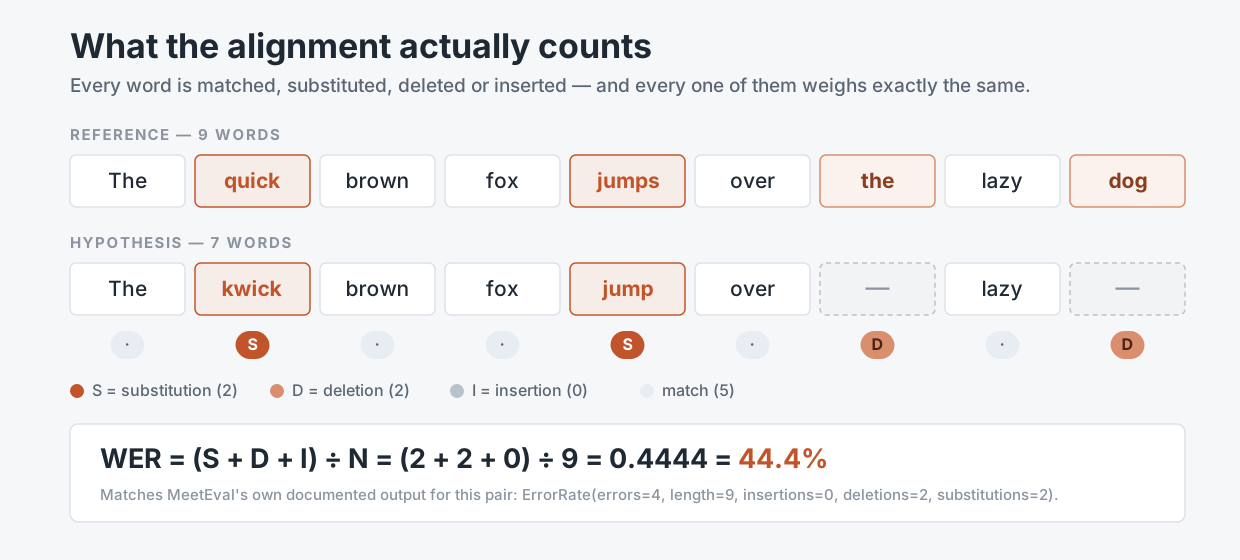
L'alignement est mécanique et reproductible. Ce qu'il n'est pas, c'est pondéré. Source : documentation MeetEval, consultée le 31 août 2026.
Deux propriétés de cette formule comptent plus que tout ce qui figure sur la page d'accueil d'un fournisseur. D'abord, elle est plate : la métrique n'a aucune notion du fait que certains mots portent la réunion et d'autres la grammaire. Ensuite, elle est aveugle aux locuteurs : le WER standard concatène tout en un seul flux, si bien qu'un système qui transcrit chaque mot parfaitement et en attribue la moitié à la mauvaise personne peut afficher un score impeccable.
Pourquoi les chiffres publiés ne séparent plus vos candidats
Sortez les classements et le problème devient arithmétique. Artificial Analysis, qui mène ses propres évaluations plutôt que de réimprimer les déclarations des fournisseurs, listait le 31 août 2026 ses cinq meilleurs modèles par AA-WER : Fun-Realtime-ASR-preview à 1,7 %, ElevenLabs Scribe v2 à 2,2 %, MAI-Transcribe-1.5 de Microsoft à 2,4 %, Smallest AI Pulse Pro à 2,4 % et Gemini 3.5 Transcribe à 2,6 %. Le meilleur modèle à poids ouverts, Voxtral Small de Mistral, se situe à 2,8 %.
Tout le haut du marché tient dans une bande de 1,1 point. Sur une réunion de 45 minutes comptant environ 6 300 mots prononcés, l'écart entre le premier et le cinquième représente à peu près 57 mots — moins d'un mot par écran de transcription.
Il y a un second problème : l'audio du benchmark n'est pas votre audio. AA-WER v2 est une moyenne pondérée par la durée audio sur environ huit heures issues de trois sources : AA-AgentTalk pour 50 %, VoxPopuli-Cleaned-AA pour 25 % et Earnings22-Cleaned-AA pour 25 %. Les discours parlementaires et les conférences de résultats sont bien enregistrés, prononcés chacun son tour, et largement dépourvus de ce qui définit une réunion interne — quatre personnes qui se coupent la parole à propos d'un projet dont elles seules ont entendu parler.
La recherche sur l'audio réellement conversationnel traite cela comme une discipline distincte depuis des années. Le défi CHiME-6, publié le 20 avril 2020 par Watanabe, Mandel, Barker et dix-huit co-auteurs, a bâti son évaluation sur des enregistrements de dîners entre amis précisément parce que la conversation naturelle, avec ses chevauchements et ses micros éloignés, met en pièces des systèmes qui brillent sur de la parole lue. Le corpus AMI Meeting, 100 heures d'enregistrements captés à la fois par casques de proximité et par micros de salle, existe pour la même raison.
Voici le point, et nous l'énonçons sans détour : un WER publié vous dit que le modèle d'un fournisseur n'est pas cassé. Il ne peut pas vous dire chez quel fournisseur acheter.
Ce que le WER attrape et ce qu'il ne peut structurellement pas attraper
| Type de défaillance | Attrapé par le WER brut ? | Ce que cela vous coûte | Ce qui le mesure vraiment |
|---|---|---|---|
| Mot courant mal entendu (« their »/« there ») | Oui, à plein poids | Presque rien | WER |
| Hésitations et faux départs supprimés | Oui, comptés comme suppressions | Rien — souvent une amélioration | WER, de façon trompeuse |
| Nom propre massacré (« Xochitl » → « Societal ») | Oui, mais pour le poids d'un mot | Le nom de la personne responsable | Taux d'erreur sur les termes porteurs de sens |
| Nombre ou date erroné (« Q3 » → « Q2 ») | Oui, poids d'un mot | Une échéance manquée | Exactitude des nombres, évaluée à part |
| Négation supprimée (« should not » → « should ») | Oui, poids d'un mot | La décision inversée | Taux d'erreur sur les termes porteurs de sens |
| Mots corrects, mauvais locuteur | Non — le WER est aveugle aux locuteurs | Personne ne sait qui s'est engagé | cpWER, DER |
| Tours de parole fondus en un seul bloc | Non | Un mur de texte illisible | tcpWER avec collar, relecture humaine |
| Frontières de phrases absentes | Non — la ponctuation est normalisée | Un résumé qui devine la structure | Score de segmentation, relecture humaine |
| Passage entier halluciné pendant un silence | En partie — comme insertions | Du contenu inventé présenté comme compte rendu | WER plus le nombre d'insertions lu à part |
La moitié basse de ce tableau est celle qui décide si une transcription devient une note exploitable, et le WER standard n'en voit rien. Ce n'est pas un défaut de la métrique — le WER répond à la question pour laquelle il a été conçu dans la recherche sur la dictée des années 1990. C'est un défaut de l'usage qui consiste à l'employer seul en 2026.
Étape 1 : construisez un extrait de 12 minutes qui se comporte comme une vraie réunion
N'évaluez pas sur un fichier de démonstration fourni par l'éditeur, et n'évaluez pas sur huit heures de vos propres archives. Il vous faut un extrait assez court pour être transcrit à la main et assez dense pour casser les systèmes.
Visez 12 minutes. À un débit conversationnel normal d'environ 140 mots par minute et une densité de parole d'environ 75 %, cela donne autour de 1 260 mots de référence — assez pour qu'un écart de 2 points de taux d'erreur représente 25 mots plutôt que du bruit statistique, et assez peu pour que deux personnes le transcrivent soigneusement en un après-midi.
Construisez l'extrait selon un cahier des charges, pas au feeling. Le nôtre :
- Quatre locuteurs ou plus, dont au moins une personne connectée à distance par un canal audio compressé, et au moins un accent non natif dans la langue de travail.
- Quatre-vingt-dix secondes ou plus de véritable chevauchement — deux personnes qui parlent en même temps, quelqu'un qui finit la phrase d'un autre, une toux par-dessus une décision. C'est dans la parole superposée que la diarisation s'effondre discrètement, et un extrait qui en est dépourvu ne mesure rien.
- Vingt-cinq termes métier ou plus : noms de code produit, acronymes internes, noms de clients, noms des participants. Ce sont les mots à la plus forte densité de sens par caractère dans la salle, et à la plus faible fréquence dans n'importe quel corpus d'entraînement.
- Quinze nombres ou plus : dates, trimestres, montants, numéros de version, pourcentages. Prononcez-en certains de façon ambiguë à dessein (« quinze » et « cinquante » dans la même minute).
- Trois décisions négatives ou plus, formulées naturellement : « on ne livre pas ça dans cette version », « on met le contrat en attente ».
- Deux enregistrements simultanés quand c'est faisable — le micro intégré de l'ordinateur portable et une piste casque par locuteur. C'est la conception du corpus AMI, et elle permet de séparer « le modèle est faible » de « la salle est bruyante ».
Enregistrez une fois. Stockez le WAV non compressé en 16 kHz ou mieux. Chaque outil que vous évaluerez désormais recevra ce fichier identique, pour toujours.
Étape 2 : écrivez la référence — puis figez les règles de normalisation avant tout calcul
La transcription de référence est un instrument de mesure, et elle a des barres d'erreur. Artificial Analysis maintient des versions « nettoyées » de ses jeux d'évaluation publics précisément parce que les transcriptions de référence d'origine contenaient elles-mêmes des erreurs de transcription ; leur note est sans ambiguïté : les versions nettoyées "remove transcription errors from the reference text, providing a more accurate ground truth for model evaluation." Si l'opérateur d'un benchmark doit corriger une vérité terrain publiée, votre transcription de premier jet n'est pas parole d'évangile non plus.
Donc : deux personnes transcrivent indépendamment, puis réconcilient chaque divergence. Comptez cinq à huit fois le temps réel pour le binôme, ce qui place un extrait de 12 minutes autour d'une journée de travail d'effort cumulé. C'est de loin le poste le plus coûteux de toute cette procédure, et il n'y a aucun moyen de le contourner.
Ensuite, consignez votre politique de normalisation avant de calculer le moindre score, car ces choix déplacent à eux seuls le chiffre final de plusieurs points :
- Les nombres : « Q3 » est-il le même jeton que « Q trois » ? « quarante mille » vaut-il « 40 000 » ?
- Les contractions : « we're » correspond-il à « we are » ?
- Les hésitations : « euh », « hum » et les faux départs figurent-ils dans la référence, et sont-ils comptés ?
- La casse et la ponctuation : normalement retirées avant l'évaluation — ce qui signifie qu'un outil qui ponctue admirablement n'en tire aucun crédit ici, et que vous devez l'évaluer séparément à l'étape 3.
Stockez le résultat en SegLST, le format JSON utilisé par les défis CHiME et adopté par défaut par MeetEval : un objet par segment avec session_id, words, speaker, start_time et end_time. Ce sont les champs de locuteur et de temps qui rendent possibles les métriques sensibles aux locuteurs, et les rajouter après coup est un calvaire.
Étape 3 : évaluez cinq dimensions, et n'accordez au WER brut que dix points sur cent
Installez l'outillage — pip install jiwer meeteval — et évaluez chaque dimension sur le même extrait. JiWER calcule le WER ainsi que le match error rate, le word information lost, le word information preserved et le character error rate, à partir d'une implémentation de distance d'édition minimale fondée sur RapidFuzz. MeetEval calcule les métriques propres aux réunions.
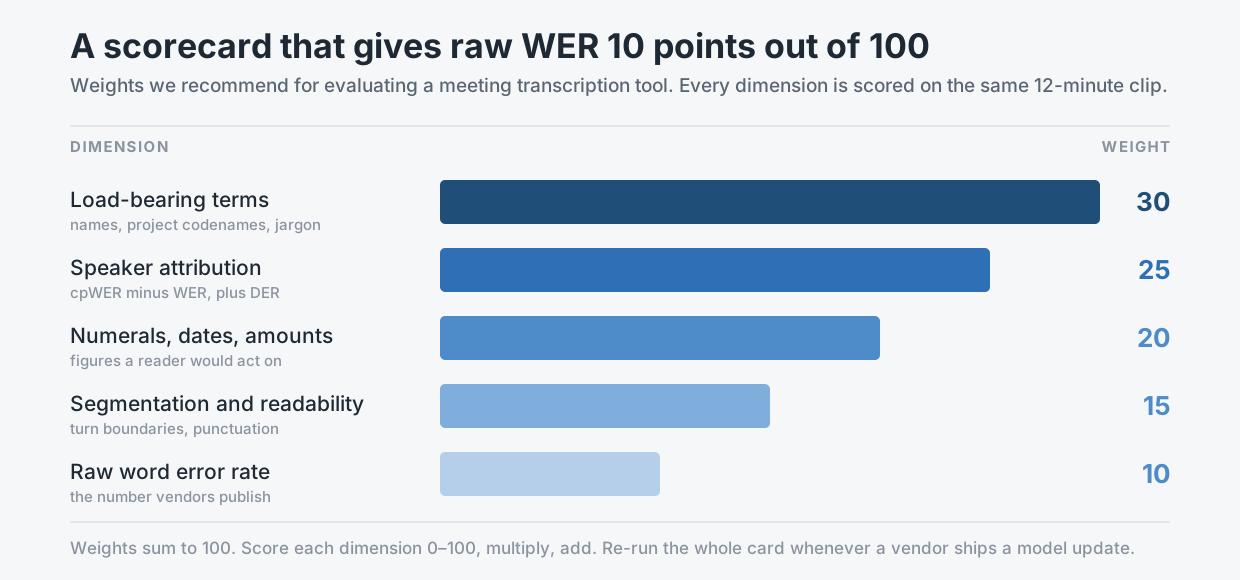
Nos pondérations recommandées. La dimension que tous les fournisseurs mettent en avant est celle qui vaut le moins de points.
Termes porteurs de sens — 30 points. Marquez dans la référence chaque nom propre, chaque nom de code et chaque élément de jargon métier. Puis appliquez la même formule de WER à ces seuls jetons. Nous appelons le résultat le taux d'erreur sur les termes porteurs de sens, et c'est le chiffre le plus prédictif de tout l'exercice. Dans la paire de transcriptions en tête de ce billet, les quatre jetons porteurs de sens sont Priya, Helios, Q3 et not. La transcription A n'en abîme aucun : 0,0 %. La transcription B en abîme deux : 50,0 %. Même WER global de 10,0 %, cinquante points d'écart sur la métrique qui compte.
Attribution des locuteurs — 25 points. Lancez meeteval-wer cpwer -r ref.stm -h hyp.stm. Le concatenated minimum-permutation WER trouve la meilleure correspondance entre les locuteurs de la référence et ceux de l'hypothèse, concatène les mots de chaque locuteur et évalue le résultat — de sorte que les mots attribués à la mauvaise personne deviennent des erreurs. Puis soustrayez : le cpWER moins le WER simple donne l'écart d'attribution, la part des dégâts qui provient uniquement de l'ignorance de qui a parlé. Ajoutez le diarization error rate pour la vue temporelle ; le DER est la somme de l'erreur de locuteur, de la parole en fausse alarme et de la parole manquée, en pourcentage du temps évalué, défini à la section 6.1 du plan d'évaluation NIST RT-09 et implémenté dans dscore, que MeetEval encapsule et qui lit des fichiers RTTM. Si votre candidat gère les horodatages, utilisez tcpwer --collar 5 au lieu de cpwer, afin qu'un mot correct rattaché au mauvais moment ne soit pas silencieusement pardonné.
Nombres, dates et montants — 20 points. Extrayez chaque jeton numérique de la référence et évaluez la correspondance exacte avec l'hypothèse, après application de votre politique de normalisation écrite. Rapportez-le comme une fraction simple — « 13 sur 15 corrects » — et non comme un pourcentage, car les effectifs sont petits et un pourcentage suggère une précision dont vous ne disposez pas.
Segmentation et lisibilité — 15 points. Cette dimension-ci est humaine. Faites lire la sortie brute par deux personnes qui n'ont pas assisté à la réunion et demandez-leur de marquer, par minute : les frontières de phrase mal placées, les tours de parole fondus en un seul bloc, et les paragraphes qu'il faut relire. La ponctuation a été normalisée hors de votre calcul de WER ; c'est donc le seul endroit où elle est évaluée.
Taux d'erreur brut sur les mots — 10 points. Lancez jiwer et notez le chiffre. C'est un véritable contrôle de plancher : tout ce qui dépasse environ 12 % sur un audio propre en prise rapprochée signale un vrai problème acoustique à investiguer. Au-delà de ce plancher, il ne discrimine presque rien, et c'est exactement pour cela qu'il vaut dix points et non quatre-vingts.
Notez chaque dimension de 0 à 100, multipliez par son poids, additionnez. Le résultat est comparable d'un outil à l'autre et d'une date à l'autre, ce qui est tout l'objet de l'exercice.
Étape 4 : faites tourner chaque candidat sur le fichier identique, et écrivez ce que « identique » voulait dire
C'est l'étape que les équipes sautent, et elle invalide tout ce qui la précède.
Même WAV, même fréquence d'échantillonnage, aucun réencodage entre candidats. Même référence, même politique de normalisation appliquée par le même script. Diarisation explicitement activée ou explicitement désactivée sur chaque outil, et consignée dans les deux cas — un outil évalué diarisation coupée n'est pas comparable à un outil évalué diarisation active. Biais par mots-clés ou par entités désactivé pour la première passe et activé pour une seconde, les deux consignées ; Microsoft rapporte jusqu'à 30 % de réduction du WER sur MAI-Transcribe-1.5 rien qu'en fournissant une liste de mots-clés, ce qui est assez large pour qu'une comparaison mêlant runs biaisés et non biaisés ne veuille plus rien dire.
Surveillez en particulier le traitement des longs audios. Artificial Analysis doit découper son audio Earnings22 en tranches d'environ neuf minutes pour les modèles incapables de traiter de façon fiable une entrée de pleine longueur, et d'environ 30 secondes pour les modèles aux limites plus strictes — leur propre note publiée cite GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B et Qwen3 ASR Flash d'Alibaba parmi les systèmes concernés. Le découpage change les résultats, parce que les erreurs se concentrent aux frontières. Si un fournisseur découpe votre fichier, c'est une propriété du produit et cela appartient à la grille de notation, pas à la liste des artefacts à corriger.
Enfin, consignez la chaîne de version exacte du modèle et la date de chaque exécution. « Whisper large-v3 » n'est pas une version ; whisper-large-v3, run 2026-08-31 en est une.
Étape 5 : rejouez la grille quand l'éditeur livre, pas quand vous y pensez
Les modèles de parole hébergés changent sous vos pieds. Le nom du point d'entrée reste constant, les poids derrière ne le restent pas, et personne ne vous envoie de courriel quand vos comptes rendus deviennent un peu moins bons sur les noms propres.
Trois déclencheurs doivent lancer une réexécution complète de la grille, sur l'extrait même que vous avez construit à l'étape 1 :
- L'éditeur publie une entrée de changelog touchant au modèle, au module de diarisation ou à la couche de ponctuation et de mise en forme.
- Un intervalle calendaire s'écoule — le trimestre suffit à la plupart des équipes, le mois si la sortie de transcription alimente quoi que ce soit d'automatisé en aval.
- Votre taux d'erreur sur les termes porteurs de sens bouge de plus de 5 points entre deux exécutions, ce qui doit déclencher une enquête avant de déclencher une migration.
Gardez chaque exécution dans un seul tableau : date, chaîne de version du modèle, les cinq scores de dimension, le total pondéré. Après trois ou quatre exécutions, vous possédez quelque chose qu'aucun classement ne peut vous donner — une série temporelle de la performance d'un produit précis sur un audio qui ressemble à vos vraies réunions.
Le fond de l'affaire : la précision est une mesure de votre salle, pas une propriété du modèle
Le taux d'erreur sur les mots est une propriété d'un modèle sur un corpus. Ce dont vous avez réellement besoin, c'est d'une propriété d'un modèle sur votre audio, pour votre vocabulaire, avec vos collègues qui se coupent la parole — et cette grandeur n'existe pas tant que vous ne l'avez pas mesurée. Personne ne peut la publier à votre place, parce que personne d'autre n'a vos noms de code dans sa transcription de référence.
La bonne nouvelle, c'est que la mesure coûte peu. Un enregistrement de 12 minutes, une journée de travail de transcription soignée, deux installations pip et une grille qui tient sur une page. L'alternative coûteuse est celle que la plupart des équipes choisissent par défaut : trancher sur un pourcentage publié, et découvrir la différence six mois plus tard, dans un compte rendu affirmant que l'équipe a accepté ce qu'elle avait explicitement refusé.
Sur quel chiffre préférez-vous vous tromper — une décimale, ou une décision ?
Où Telli.sh s'inscrit : nous construisons précisément les couches que cette grille pondère. Telli.sh fait tourner la séparation des locuteurs, la segmentation, le raffinement et le résumé par-dessus la reconnaissance vocale, avec la traduction vers 44 langues cibles et une interface en 15 langues, parce que les 90 points de cette grille qui ne sont pas du WER brut sont exactement là où une transcription devient une note sur laquelle quelqu'un peut agir. Si vous voulez un vrai point de mesure plutôt qu'un benchmark, passez-y votre propre extrait de 12 minutes et notez le résultat avec la procédure ci-dessus.
Démarrer une note IA en direct
Sources
- MeetEval — une boîte à outils d'évaluation de la transcription de réunions — les commandes cpWER, tcpWER, ORC-WER, MIMO-WER et DI-cpWER, le format SegLST et l'exemple travaillé
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), consulté le 31 août 2026 - JiWER — paquet d'évaluation de la reconnaissance vocale — WER, MER, WIL, WIP et CER via la distance d'édition minimale de RapidFuzz
- dscore — outils de notation de la diarisation — le DER comme somme de l'erreur de locuteur, de la parole en fausse alarme et de la parole manquée, selon la section 6.1 du plan d'évaluation NIST RT-09
- Classement speech-to-text d'Artificial Analysis — méthodologie AA-WER v2 (~8 heures réparties entre AA-AgentTalk 50 %, VoxPopuli-Cleaned-AA 25 %, Earnings22-Cleaned-AA 25 %), les chiffres des cinq premiers modèles, la note sur les références nettoyées et la note sur le découpage d'Earnings22, le tout consulté le 31 août 2026
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 avril 2020 — les pistes multilocuteurs segmentées et non segmentées, et la conception des enregistrements de dîners
- The AMI Meeting Corpus — 100 heures d'enregistrements de réunions captés avec des micros de proximité et de champ lointain synchronisés
- MAI-Transcribe dans Azure Speech — Microsoft Learn — le biais par mots-clés et les limitations documentées
- Notre billet précédent sur les raisons pour lesquelles la précision de transcription n'a jamais été le livrable