Mantenha o agente de programação. Leve o modelo dele para o seu Mac.
O macMLX 0.11.0 conecta a inferência local no Apple Silicon ao Codex e ao Claude Code. Veja como caminhos de API, aliases de modelos, memória e permissões de ferramentas mudam o experimento.
A interface que edita seu repositório e o modelo que decide o que editar não precisam vir do mesmo lugar. Um agente de programação pode manter seu fluxo de trabalho familiar e enviar parte das solicitações de inferência para um modelo executado no seu próprio Mac.
O macMLX 0.11.0, lançado em 17 de novembro de 2026, oferece caminhos de API concretos para essa configuração. O Codex pode usar seu endpoint Responses, enquanto o Claude Code pode usar os endpoints Messages e de contagem de tokens. O backend funciona no Apple Silicon com macOS 14 ou posterior.
O atrativo é controlar onde ocorre a inferência de determinados modelos. A decisão exige mais do que substituir uma URL: capacidade do modelo, gerenciamento da conversa, serialização das solicitações e permissões da própria ferramenta de programação continuam determinando se a configuração será útil.
Antes de começar: escolha um modelo local compatível que consiga chamar ferramentas, reserve memória unificada para os pesos e o contexto e trate uma resposta de chat bem-sucedida como o primeiro teste, não como prova de que o fluxo de programação funciona.
O agente continua na frente; uma API local fica por trás
O macMLX é um aplicativo e servidor de inferência local desenvolvido em Swift em torno do ecossistema MLX da Apple. Seu caminho de inferência padrão roda no processo Swift, em vez de exigir um ambiente Python. Isso descreve o mecanismo padrão, sem afirmar que vale para toda integração opcional ou subprocesso que o projeto possa oferecer.
A nova versão importa porque agentes de programação fazem mais do que uma interação simples de receber um prompt e devolver texto. Eles podem pedir ao modelo uma chamada de ferramenta, executar uma operação permitida, retornar o resultado e solicitar a próxima etapa. O servidor precisa transportar o histórico e as estruturas de solicitação relevantes ao longo desse ciclo.
A versão 0.11.0 adiciona uma interface /v1/responses compatível com OpenAI para o Codex, além de mudanças para o Claude Code por meio de /v1/messages e /v1/messages/count_tokens. O registro de suporte da versão também descreve a reinserção de raciocínios anteriores no template de chat do modelo e a reutilização do histórico de turnos do agente em modelos híbridos e de janela deslizante. São detalhes de integração com uma consequência prática: um backend capaz de responder a uma saudação não é necessariamente capaz de sustentar o próximo turno com ferramentas.
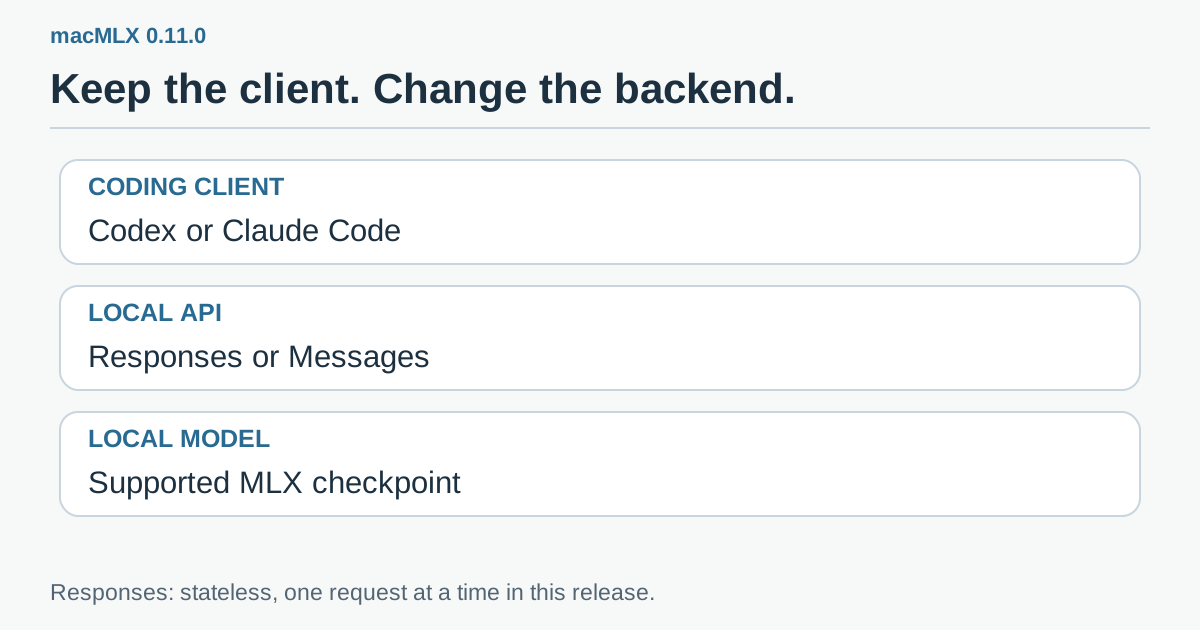 Diagrama explicativo original: o cliente de programação controla seu fluxo, o macMLX atende às solicitações de API compatíveis e o modelo local selecionado realiza a inferência. A execução de ferramentas tem um limite de permissão separado.
Pense na API como um adaptador de tomada. Ela conecta dois componentes, mas não torna sua potência, capacidade ou comportamento idênticos. A interface familiar do Codex ou do Claude Code não transforma um modelo local menor no modelo remoto que você usava antes.
Um endpoint Responses sem estado muda a questão da escala
O endpoint Responses da versão 0.11.0 não mantém estado entre solicitações. O cliente precisa enviar a conversa necessária para o próximo turno. O README da versão informa que o Codex faz isso, enquanto previous_response_id é rejeitado em vez de ser usado para recuperar uma resposta armazenada no servidor.
Processar solicitações sem estado não significa que o ambiente de execução não tenha cache. O estado da conversa e um cache de inferência reutilizável resolvem problemas diferentes. O cliente continua fornecendo o histórico necessário; um cache compatível pode reduzir o trabalho quando parte dessa entrada corresponde a um prefixo anterior.
Também há um limite explícito de concorrência nesse novo endpoint: ele atende a uma solicitação por vez. O README explica que os subagentes do Codex, portanto, entram em uma fila. Iniciar vários agentes pode alongar a fila em vez de multiplicar a capacidade útil do Mac. O projeto oferece outros recursos de processamento em lote, mas eles não devem ser atribuídos a um caminho de solicitação cujo limite documentado é a execução serial.
Isso afeta o planejamento do primeiro teste. É mais fácil avaliar um assistente executando uma tarefa delimitada no repositório do que um enxame abrindo várias conversas longas. Registre o tempo da tarefa completa, incluindo espera, carregamento e execução de ferramentas. A taxa de tokens por segundo durante uma geração ativa representa apenas parte desse tempo.
Comece com uma tarefa pequena no repositório cuja resposta seja conhecida
Um primeiro trabalho ilustrativo é pedir ao agente que explique um módulo pequeno e proponha um teste unitário sem alterar arquivos. Você pode verificar se a explicação corresponde ao código e se o teste proposto cobre um contrato real. Isso cria uma referência antes de conceder permissões de escrita ou de shell.
Um segundo trabalho poderia permitir uma mudança em uma branch descartável: renomear um símbolo interno claramente delimitado, ajustar seus chamadores e executar um teste específico já existente. Os critérios de sucesso são concretos. O agente alterou somente os arquivos pretendidos, preservou o contrato público e informou o resultado real do teste? Uma explicação longa e confiante não substitui essas verificações.
Um terceiro cenário é trabalhar com foco em operação offline sobre um rascunho sensível ou um trecho de código privado. A inferência local pode manter a solicitação ao modelo no Mac, dependendo da configuração do cliente, mas o agente inteiro não fica automaticamente offline. Operações no repositório, gerenciadores de pacotes, ferramentas de busca, servidores MCP e outras integrações ainda podem se conectar a outros serviços. Revise esses itens separadamente antes de prometer onde os dados permanecerão.
Esses exemplos são tarefas sugeridas para avaliação. Os resultados de compatibilidade apresentados na versão são testes de integração do próprio desenvolvedor, não resultados de uma instalação nossa.
Configure o endpoint sem perder o provedor que já funciona
Use um Mac com Apple Silicon e macOS 14 ou mais recente, instale a versão identificada pelo procedimento documentado do projeto e siga suas orientações atuais para o Gatekeeper. Não desative controles de segurança de todo o sistema apenas para abrir o aplicativo. Selecione um modelo entre os caminhos compatíveis do projeto e confira a licença do próprio modelo antes de baixá-lo para o uso pretendido.
O README da versão 0.11.0 documenta macmlx serve e uma API local na porta 8000. Use o identificador do modelo realmente presente na sua máquina. Os exemplos de clientes a seguir reproduzem a estrutura de configuração documentada pelo projeto; não comprovam que o checkpoint de exemplo já esteja instalado no seu Mac.
- Inicie o backend e verifique sua lista de modelos. Execute o comando de servidor documentado ou carregue o modelo no aplicativo. Confira o endereço real do servidor e os IDs expostos por
/v1/models. - Guarde uma cópia da configuração atual do cliente. Adicione um provedor local de forma deliberada, sem sobrescrever uma configuração funcional que talvez queira comparar ou restaurar.
- Conecte um único cliente. Comece com o Codex ou o Claude Code, sem usar os dois ao mesmo tempo. Confirme uma solicitação curta de texto antes de tentar uma tarefa com ferramentas.
- Restrinja as permissões iniciais. Comece permitindo leitura e propostas de mudança. Amplie o acesso somente quando o fluxo exigir.
Para o Codex, o exemplo de provedor do README é:
model = "Qwen3.6-27B-4bit"
model_provider = "macmlx"

[model_providers.macmlx]
name = "macMLX"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
Se você habilitar a autenticação bearer do backend, siga a orientação do README para env_key e mantenha a chave na variável de ambiente indicada. Um exemplo em localhost não é uma recomendação para expor um serviço de inferência sem autenticação à rede.
A conexão documentada do Claude Code usa uma URL base sem o sufixo /v1 e mapeia seus aliases de modelos:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_API_KEY=sk-local
export ANTHROPIC_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_SMALL_FAST_MODEL=Qwen3.6-27B-4bit
claude
Aqui, sk-local é o marcador de exemplo do projeto para um servidor sem autenticação bearer, não uma credencial real de serviço. Quando a autenticação bearer está habilitada, o README orienta usar ANTHROPIC_AUTH_TOKEN com a chave configurada. As instruções sobre aliases importam: um alias sem mapeamento pode enviar um nome de modelo claude-* a um servidor que só possui checkpoints locais, produzindo um erro 404.
A compatibilidade de modelos exige uma resposta mais precisa do que “compatível com MLX”
As verificações completas declaradas pela versão incluem o Xcode 27 com Qwen3.6-27B e o cliente Foundation Models da Apple com esse modelo e com Gemma 4 E4B. Essas verificações cobriram texto. Não devem ser apresentadas como prova de que todo cliente de programação, variante de modelo ou solicitação com imagem funciona.
O registro de suporte descreve separadamente a entrada de imagens para checkpoints Gemma 4 com a estrutura E4B compatível e checkpoints densos Qwen3.5/3.6 que incluem seu módulo de visão. Ele também informa que uma solicitação com imagem não grava uma entrada no cache de prompts. Um modelo aparecer em uma lista de arquiteturas detectadas não garante o funcionamento do processador, dos pesos ou do caminho multimodal de qualquer checkpoint.
Para uma tarefa de programação que inclua uma captura de tela, teste o caminho de imagem de forma independente. Peça uma descrição com uma resposta visível conhecida antes de solicitar que o agente redesenhe um componente com base nela. Mantenha uma tarefa alternativa apenas com texto para distinguir um problema de carregamento de visão de um problema geral no ciclo de ferramentas.
A mesma disciplina vale para formatos de saída e ferramentas. Um checkpoint precisa emitir as estruturas de ferramentas esperadas pelo cliente, e não apenas mencionar um comando em prosa. Verifique uma chamada de ferramenta, o resultado retornado e uma resposta útil no turno seguinte. Uma falha no segundo turno pode revelar mais sobre a adequação da integração do que uma primeira resposta bem-sucedida.
A memória unificada transforma o contexto em um orçamento real
A CPU e a GPU do Mac compartilham memória física. Isso evita algumas transferências explícitas, mas não elimina o custo dos pesos do modelo, das ativações, do cache KV e dos aplicativos executados junto dele. Um editor, um navegador e um modelo local podem disputar a mesma capacidade.
Não estime os requisitos somente pelo número de parâmetros. Precisão dos pesos, tamanho real do checkpoint, comprimento do contexto e comportamento do ambiente de execução importam. Comece com um checkpoint compatível que deixe espaço para seu trabalho habitual e depois meça a pressão de memória e a capacidade de resposta durante uma tarefa representativa.
Há um detalhe específico da atualização que merece atenção: o registro da versão informa que uma solicitação de conclusão de chat sem limite explícito de tokens pode agora chegar a 32.768 tokens, em vez de 2.048. Isso se refere ao comportamento documentado de conclusão de chat; não é uma garantia universal de saída para todas as rotas de API. Ainda assim, limites explícitos facilitam o controle de tarefas exploratórias. Uma solicitação que gere acidentalmente muito mais texto do que o previsto consome tempo e pode atrapalhar o trabalho que você queria realizar no Mac.
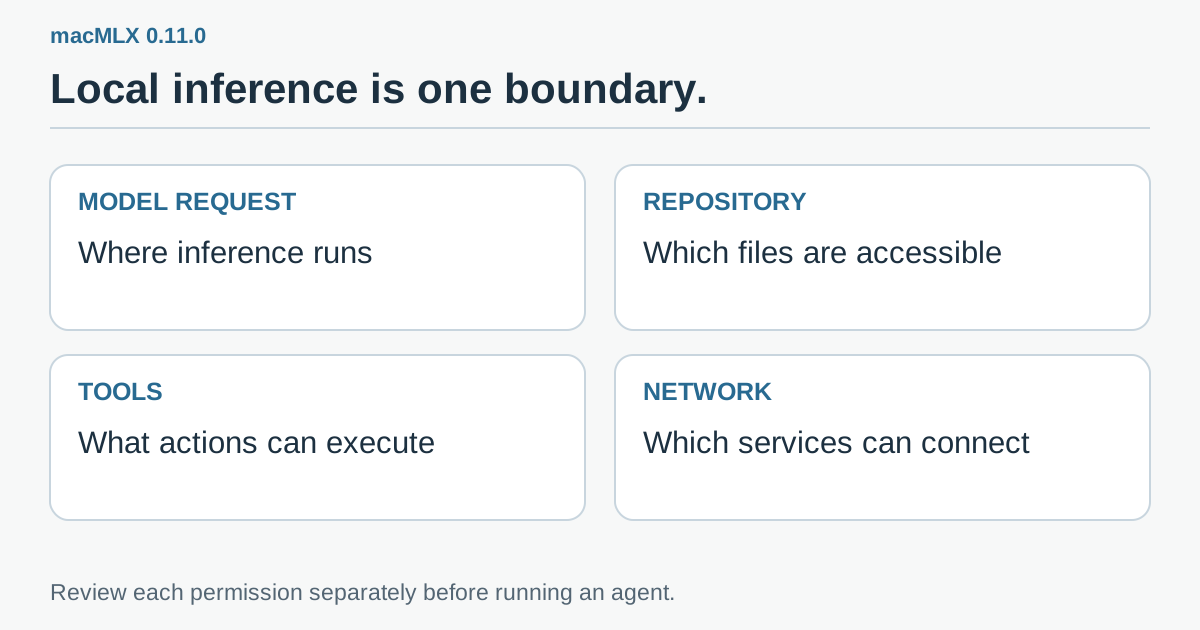 Lista de verificação original: solicitações ao modelo, acesso ao repositório, execução de ferramentas e conexões externas exigem decisões separadas. Um endpoint de modelo local não restringe automaticamente os outros três itens.
Compare tarefas completas antes de comparar assinaturas
O atrativo evidente é reduzir a dependência da inferência remota em determinados trabalhos. O custo menos evidente é o tempo de quem opera o sistema. Carregar um modelo, esperar em uma fila serial, corrigir uma alteração inadequada e manter o ambiente saudável fazem parte da comparação.
Use a mesma tarefa delimitada e os mesmos testes de aceitação para comparar seu provedor atual com o backend local. Registre o carregamento a frio, a primeira resposta, a duração total da tarefa, os turnos com ferramentas bem-sucedidos, os resultados finais dos testes e a quantidade de correção humana. Guarde as versões do modelo, do contexto e do cliente na nota para permitir a comparação com uma atualização futura.
Para uma tarefa frequente e modesta, uma configuração local pode ser conveniente mesmo que perca na velocidade. Para uma mudança difícil que exija várias rodadas sem sucesso, um modelo remoto ainda pode custar menos em atenção total. Essa é uma decisão por tarefa, não uma afirmação de que um local de execução vence em todos os trabalhos.
O hardware que você já tem é um bom ponto de partida para experimentar. Um teste de compatibilidade bem-sucedido é motivo para ampliar um fluxo controlado, não para comprar imediatamente um Mac maior.
Uma ferramenta de programação conhecida pode virar uma bancada mais flexível
O macMLX 0.11.0 facilita experimentar a inferência local sem substituir toda a interface de programação. Sua contribuição mais valiosa é a conexão explícita entre clientes, estruturas de API e caminhos de modelos compatíveis.
Comece com um cliente, um modelo e uma tarefa cujo resultado você consiga verificar. Mantenha o endpoint local, trate as permissões de ferramentas como uma decisão separada e inclua espera e correção nas medições. O resultado útil é uma bancada capaz de escolher o backend adequado para cada trabalho, em vez de uma interface familiar que esconde uma suposição não testada.
Fontes e mídia oficial
- Lançamento do macMLX 0.11.0, em 17 de novembro de 2026.
- README da versão 0.11.0: instalação, servidor local e configuração dos clientes.
- Registro oficial de compatibilidade e histórico de versões.
- Imagem oficial de apresentação do macMLX. O material sobre o produto é oferecido como link; os diagramas deste artigo são explicações originais.
As verificações de compatibilidade são atribuídas ao projeto. Os exemplos de tarefas e o procedimento de comparação são exercícios propostos aos leitores.
Recomendação Telli.sh: Guarde o modelo, as configurações do cliente e os resultados das tarefas em um único lugar para que cada experimento com IA local tenha um ponto de partida reproduzível. Crie sua primeira nota com o Telli.sh.