Behalten Sie den Coding-Agenten. Verlagern Sie sein Modell auf Ihren Mac.
macMLX 0.11.0 verbindet lokale Inferenz auf Apple Silicon mit Codex und Claude Code. Wie API-Pfade, Modellaliase, Arbeitsspeicher und Werkzeugrechte den Versuch beeinflussen.
Die Oberfläche, die Ihr Repository bearbeitet, und das Modell, das über Änderungen entscheidet, müssen nicht aus derselben Quelle stammen. Ein Coding-Agent kann seinen vertrauten Arbeitsablauf behalten und ausgewählte Inferenzanfragen an ein Modell auf Ihrem eigenen Mac senden.
macMLX 0.11.0, veröffentlicht am 17. November 2026, gibt dieser Anordnung konkrete API-Pfade. Codex kann den Responses-Endpunkt verwenden, Claude Code die Endpunkte für Messages und Tokenzählung. Das Backend läuft auf Apple Silicon mit macOS 14 oder neuer.
Der Reiz liegt in der Kontrolle darüber, wo ausgewählte Modellinferenz stattfindet. Die Entscheidung geht aber über den Austausch einer URL hinaus: Modellfähigkeiten, Gesprächsverarbeitung, die nacheinander erfolgende Anfrageverarbeitung und die Berechtigungen des Coding-Werkzeugs bestimmen weiterhin, ob die Konfiguration nützlich ist.
Bevor Sie beginnen: Wählen Sie ein unterstütztes lokales Modell mit Werkzeugaufrufen, planen Sie für Gewichte und Kontext im gemeinsamen Speicher und behandeln Sie eine erfolgreiche Chatantwort als ersten Test, nicht als Nachweis eines funktionierenden Coding-Arbeitsablaufs.
Der Agent bleibt vorn; dahinter sitzt eine lokale API
macMLX ist eine Swift-basierte Anwendung mit Server für lokale Inferenz auf Grundlage von Apples MLX-Ökosystem. Der standardmäßige Inferenzpfad läuft im Swift-Prozess und benötigt keine Python-Laufzeit. Das beschreibt die Standard-Engine, nicht zwangsläufig jede optionale Integration oder jeden Unterprozess, den das Projekt unterstützen könnte.
Die neue Version ist relevant, weil Coding-Agenten mehr als einfache Textanfragen und Textantworten verwenden. Sie können vom Modell einen Werkzeugaufruf anfordern, einen erlaubten Vorgang ausführen, das Ergebnis zurückgeben und den nächsten Schritt erfragen. Der Server muss den relevanten Verlauf und die Anfragestrukturen durch diese Schleife transportieren.
Version 0.11.0 ergänzt eine OpenAI-kompatible Schnittstelle /v1/responses für Codex sowie Änderungen für Claude Code über /v1/messages und /v1/messages/count_tokens. Die Dokumentation zur Versionsunterstützung beschreibt außerdem die erneute Einbindung früherer Reasoning-Inhalte in die Chatvorlage und die Wiederverwendung des Agentenverlaufs bei Hybridmodellen und Modellen mit gleitendem Aufmerksamkeitsfenster. Diese Integrationsdetails haben eine praktische Folge: Ein Backend, das eine Begrüßung beantworten kann, übersteht nicht unbedingt den nächsten Werkzeugschritt.
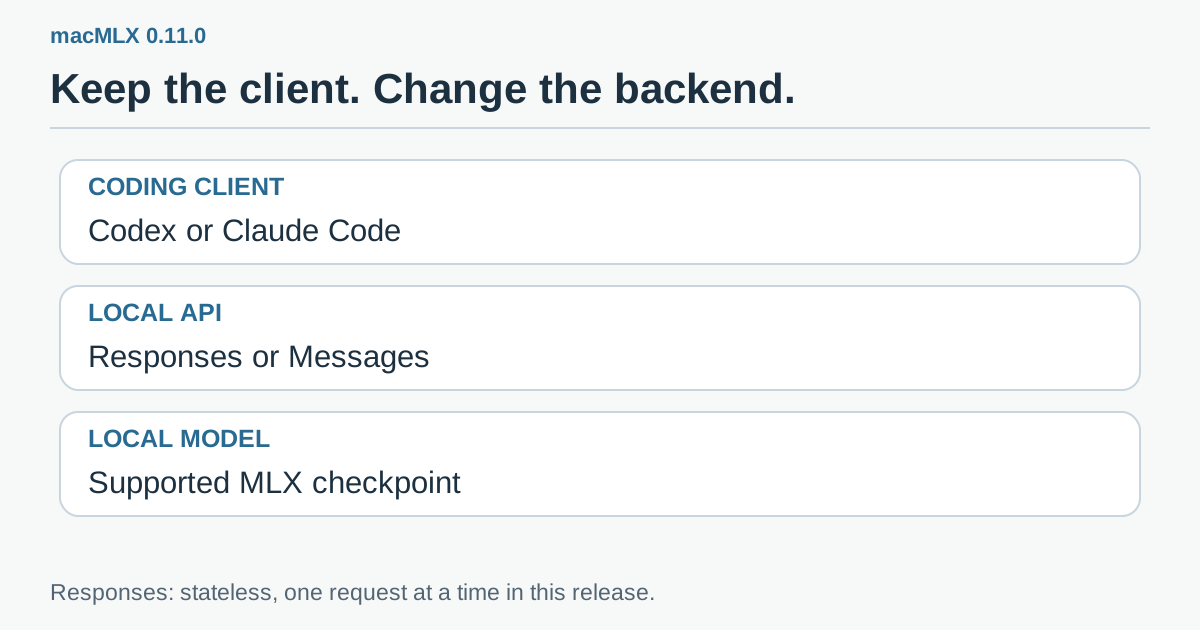 Eigene Erklärungsgrafik: Der Coding-Client verantwortet seinen Arbeitsablauf, macMLX bedient kompatible API-Anfragen, und das ausgewählte lokale Modell übernimmt die Inferenz. Die Werkzeugausführung bildet eine eigene Berechtigungsgrenze.
Betrachten Sie die API wie einen Adapterstecker. Er verbindet zwei Komponenten, macht aber ihre Leistung, Kapazität und ihr Verhalten nicht identisch. Die vertraute Oberfläche von Codex oder Claude Code verwandelt ein kleineres lokales Modell nicht in das zuvor genutzte entfernte Modell.
Ein zustandsloser Responses-Endpunkt verändert die Skalierung
Der Responses-Endpunkt von 0.11.0 ist zwischen Anfragen zustandslos. Der Client muss das für den nächsten Schritt benötigte Gespräch mitsenden. Laut README der markierten Version tut Codex dies, während previous_response_id zurückgewiesen wird, statt damit eine gespeicherte Serverantwort abzurufen.
Zustandslose Anfrageverarbeitung bedeutet nicht, dass die Laufzeit keinerlei Caching hat. Gesprächszustand und wiederverwendbarer Inferenzcache lösen unterschiedliche Probleme. Der Client liefert weiterhin den nötigen Verlauf; ein kompatibler Cache kann Arbeit sparen, wenn ein Teil dieser Eingabe einem früheren Präfix entspricht.
Für diesen neuen Endpunkt gilt außerdem eine ausdrückliche Nebenläufigkeitsgrenze: Er bearbeitet jeweils eine Anfrage. Die README erklärt, dass Codex-Unteragenten deshalb warten müssen. Mehrere gestartete Agenten können eine längere Schlange erzeugen, statt den nützlichen Durchsatz des Macs zu vervielfachen. Das Projekt verfügt über weitere Fähigkeiten zur Stapelverarbeitung; diese sollten aber keinem Anfragepfad zugeschrieben werden, für den eine serielle Ausführung dokumentiert ist.
Das beeinflusst den ersten Versuch. Ein Assistent mit einer begrenzten Repository-Aufgabe lässt sich leichter bewerten als ein Schwarm mit mehreren langen Gesprächen. Erfassen Sie die Zeit für die gesamte Aufgabe, einschließlich Warten, Laden und Werkzeugausführung. Die Tokenrate einer einzelnen aktiven Generierung ist nur ein Teil davon.
Beginnen Sie mit einer kleinen Repository-Aufgabe mit überprüfbarem Ergebnis
Eine beispielhafte erste Aufgabe ist, ein kleines Modul erklären und einen Unit-Test vorschlagen zu lassen, ohne Dateien zu ändern. Sie können prüfen, ob die Erklärung zum Code passt und der Test einen echten Vertrag abdeckt. So entsteht eine Vergleichsbasis, bevor Sie Schreib- oder Shell-Rechte vergeben.
Eine zweite Aufgabe könnte auf einem entbehrlichen Branch eine Änderung erlauben: ein klar abgegrenztes internes Symbol umbenennen, seine Aufrufer anpassen und einen vorhandenen gezielten Test ausführen. Die Erfolgskriterien sind konkret. Wurden nur die vorgesehenen Dateien geändert, der öffentliche Vertrag erhalten und das tatsächliche Testergebnis gemeldet? Eine lange, selbstbewusste Erklärung ersetzt diese Prüfungen nicht.
Ein drittes Szenario ist möglichst offline ausgeführte Arbeit an einem sensiblen Entwurf oder privaten Codeauszug. Lokale Inferenz kann die Modellanfrage je nach Clientkonfiguration auf dem Mac halten; der gesamte Agent ist dadurch aber nicht automatisch offline. Repository-Vorgänge, Paketmanager, Suchwerkzeuge, MCP-Server und weitere Integrationen können weiterhin externe Verbindungen herstellen. Prüfen Sie diese separat, bevor Sie Zusagen zum Verarbeitungsort machen.
Diese Beispiele sind vorgeschlagene Bewertungsaufgaben. Die Kompatibilitätsergebnisse der Veröffentlichung sind Integrationstests des Entwicklers, keine Ergebnisse unserer Installation.
Konfigurieren Sie den Endpunkt, ohne Ihren funktionierenden Anbieter zu verlieren
Verwenden Sie einen Mac mit Apple Silicon und macOS 14 oder neuer, installieren Sie die markierte Version über den dokumentierten Weg und beachten Sie die aktuellen Gatekeeper-Hinweise des Projekts. Schalten Sie nicht die systemweiten Sicherheitskontrollen ab, nur um die Anwendung zu öffnen. Wählen Sie ein Modell über die unterstützten Projektpfade und prüfen Sie vor dem Download die eigene Lizenz des Modells für Ihren Zweck.
Die README zu Version 0.11.0 dokumentiert macmlx serve und eine lokale API auf Port 8000. Verwenden Sie die Modellkennung, die tatsächlich auf Ihrem Rechner vorhanden ist. Die folgenden Clientbeispiele geben die dokumentierte Konfigurationsform wieder; sie belegen nicht, dass der Beispiel-Checkpoint bereits auf Ihrem Mac installiert ist.
- Starten Sie das Backend und prüfen Sie seine Modellliste. Führen Sie den dokumentierten Serverbefehl aus oder laden Sie das Modell in der Anwendung. Prüfen Sie die tatsächliche Serveradresse und die unter
/v1/modelsangebotenen Kennungen. - Sichern Sie die aktuelle Clientkonfiguration. Ergänzen Sie den lokalen Anbieter bewusst, statt eine funktionierende Konfiguration zu überschreiben, die Sie später vergleichen oder wiederherstellen möchten.
- Verbinden Sie einen Client. Beginnen Sie entweder mit Codex oder Claude Code, nicht gleichzeitig mit beiden. Prüfen Sie eine kurze Textanfrage, bevor Sie eine Werkzeugaufgabe versuchen.
- Halten Sie die ersten Berechtigungen eng. Beginnen Sie mit Lesen und Änderungsvorschlägen. Erweitern Sie den Zugriff erst, wenn der Arbeitsablauf ihn benötigt.
Für Codex lautet das Anbieterbeispiel der README:
model = "Qwen3.6-27B-4bit"
model_provider = "macmlx"

[model_providers.macmlx]
name = "macMLX"
base_url = "http://127.0.0.1:8000/v1"
wire_api = "responses"
Wenn Sie die Bearer-Authentifizierung des Backends aktivieren, befolgen Sie die env_key-Hinweise der README und bewahren Sie den Schlüssel in der vorgesehenen Umgebungsvariable auf. Ein localhost-Beispiel empfiehlt nicht, einen ungeschützten Inferenzdienst im Netzwerk bereitzustellen.
Die dokumentierte Verbindung für Claude Code verwendet eine Basis-URL ohne /v1-Suffix und ordnet seine Modellaliase zu:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_API_KEY=sk-local
export ANTHROPIC_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3.6-27B-4bit
export ANTHROPIC_SMALL_FAST_MODEL=Qwen3.6-27B-4bit
claude
Hier ist sk-local der Beispielplatzhalter des Projekts für einen Server ohne Bearer-Authentifizierung, kein echter Zugangsschlüssel. Bei aktivierter Bearer-Authentifizierung verweist die README stattdessen auf ANTHROPIC_AUTH_TOKEN mit dem konfigurierten Schlüssel. Die Aliashinweise sind wichtig: Ein nicht zugeordneter Alias kann einen Modellnamen wie claude-* an einen Server senden, der nur lokale Checkpoints kennt, und damit eine 404-Antwort auslösen.
Modellunterstützung braucht eine genauere Antwort als „MLX-kompatibel“
Die angegebenen Ende-zu-Ende-Prüfungen der Veröffentlichung umfassen Xcode 27 mit Qwen3.6-27B und Apples Foundation-Models-Client mit diesem Modell sowie Gemma 4 E4B. Diese Prüfungen betrafen Text. Sie belegen nicht, dass jeder Coding-Client, jede Modellvariante oder jede Bildanfrage funktioniert.
Die Unterstützungsdokumentation beschreibt separat Bildeingaben für Gemma-4-Checkpoints mit der unterstützten E4B-Struktur und dichte Qwen3.5/3.6-Checkpoints mit enthaltenem Vision-Tower. Sie sagt außerdem, dass Bildanfragen keinen Prompt-Cache-Eintrag aufzeichnen. Ein Modell in einer Liste erkannter Architekturen garantiert nicht den Prozessor, die Gewichte oder den multimodalen Pfad eines beliebigen Checkpoints.
Testen Sie bei einer Coding-Aufgabe mit Screenshot den Bildpfad eigenständig. Fragen Sie zuerst nach einer Beschreibung mit bekannter sichtbarer Antwort, bevor der Agent daraus eine Komponente neu gestalten soll. Halten Sie eine reine Textaufgabe als Rückfall bereit, um ein Problem beim Laden der Bildverarbeitung von einem allgemeinen Werkzeugschleifenproblem unterscheiden zu können.
Dasselbe gilt für Ausgabeformate und Werkzeuge. Ein Checkpoint muss die vom Client erwarteten Werkzeugstrukturen erzeugen, statt einen Befehl nur im Fließtext zu erwähnen. Prüfen Sie einen Werkzeugaufruf, dessen zurückgeliefertes Ergebnis und eine nützliche Folgeantwort. Ein Fehler im zweiten Schritt kann mehr über die Eignung der Integration zeigen als eine erfolgreiche erste Antwort.
Gemeinsamer Speicher macht Kontext zu einem echten Budget
CPU und GPU des Macs teilen sich physischen Speicher. Das vermeidet einige explizite Übertragungen, beseitigt aber nicht den Speicherbedarf von Modellgewichten, Aktivierungen, KV-Cache und anderen Anwendungen. Editor, Browser und lokales Modell können um dieselbe Kapazität konkurrieren.
Schätzen Sie den Bedarf nicht allein anhand der Parameterzahl. Gewichtspräzision, tatsächliche Checkpoint-Größe, Kontextlänge und Laufzeitverhalten sind relevant. Beginnen Sie mit einem unterstützten Checkpoint, der Platz für Ihre übliche Arbeit lässt, und messen Sie Speicherdruck und Reaktionsfähigkeit während einer typischen Aufgabe.
Ein bestimmtes Updatedetail verdient Beachtung: Laut Versionsdokumentation kann eine Chat-Completion-Anfrage ohne explizites Tokenlimit jetzt bis zu 32,768 statt 2,048 Token laufen. Das betrifft das dokumentierte Chat-Completion-Verhalten und garantiert nicht dieselbe Ausgabe für jeden API-Pfad. Trotzdem erleichtern ausdrückliche Grenzen die Kontrolle von Erkundungsaufgaben. Eine versehentlich viel längere Generierung verbraucht Zeit und kann die Arbeit behindern, die der Mac eigentlich erledigen sollte.
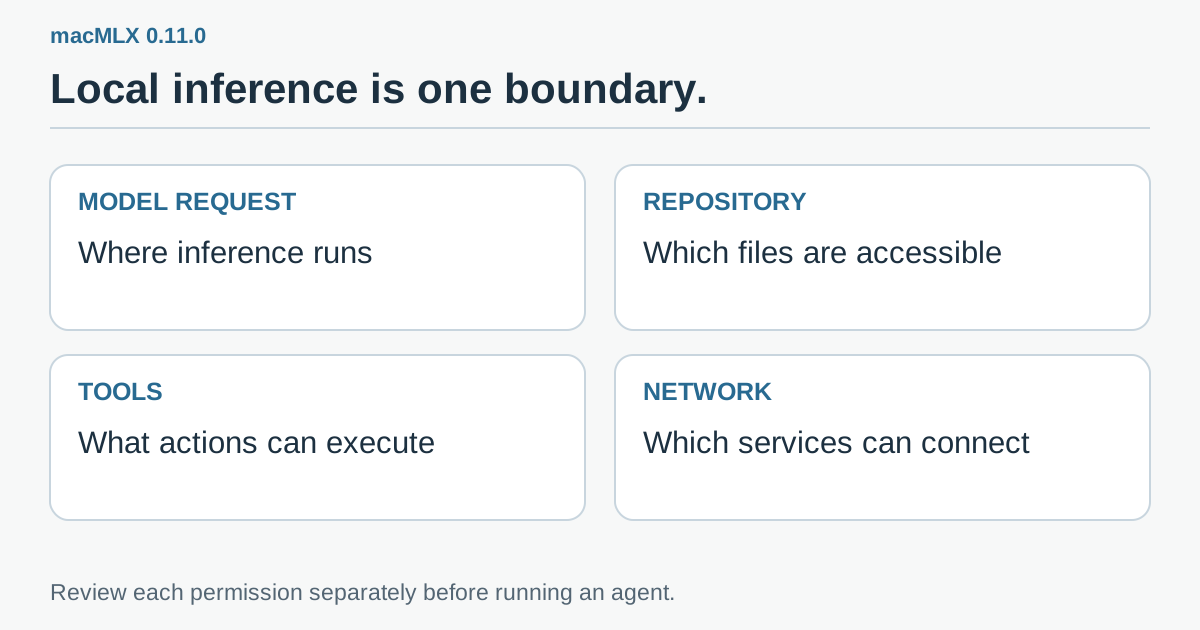 Eigene Prüfliste: Modellanfragen, Repository-Zugriff, Werkzeugausführung und externe Verbindungen benötigen getrennte Entscheidungen. Ein lokaler Modellendpunkt begrenzt die anderen drei Bereiche nicht automatisch.
Vergleichen Sie ganze Aufgaben, bevor Sie Abonnements vergleichen
Der offensichtliche Reiz ist eine geringere Abhängigkeit von entfernter Inferenz bei ausgewählten Arbeiten. Weniger offensichtlich ist der Zeitaufwand des Betreibers. Modellladen, Warten in einer seriellen Schlange, die Korrektur ungeeigneter Änderungen und die Pflege der Umgebung gehören alle in den Vergleich.
Verwenden Sie beim Vergleich Ihres bisherigen Anbieters mit dem lokalen Backend dieselbe begrenzte Aufgabe und dieselben Abnahmetests. Erfassen Sie kaltes Laden, erste Antwort, Gesamtdauer, erfolgreiche Werkzeugschritte, abschließende Testergebnisse und den menschlichen Korrekturaufwand. Halten Sie Modell, Kontext und Clientversionen in der Notiz fest, damit spätere Updates vergleichbar sind.
Für eine häufige, überschaubare Aufgabe kann eine lokale Konfiguration praktisch sein, selbst wenn sie im Geschwindigkeitsvergleich verliert. Bei einer schwierigen Änderung mit mehreren erfolglosen Runden kann ein entferntes Modell insgesamt weniger Aufmerksamkeit kosten. Das ist eine Entscheidung für eine Aufgabe, keine Behauptung, dass ein Verarbeitungsort bei jeder Arbeit gewinnt.
Die bereits vorhandene Hardware ist ein guter Ort zum Experimentieren. Ein erfolgreicher Kompatibilitätstest rechtfertigt die Erweiterung eines kontrollierten Arbeitsablaufs, nicht sofort den Kauf eines größeren Macs.
Ein vertrautes Coding-Werkzeug kann zur flexibleren Werkbank werden
macMLX 0.11.0 erleichtert den Versuch mit lokaler Inferenz, ohne die gesamte Coding-Oberfläche zu ersetzen. Sein wertvollster Beitrag ist die ausdrückliche Verbindung zwischen Clients, API-Formaten und unterstützten Modellpfaden.
Beginnen Sie mit einem Client, einem Modell und einer Aufgabe mit überprüfbarem Ergebnis. Halten Sie den Endpunkt lokal, entscheiden Sie separat über Werkzeugrechte und beziehen Sie Wartezeit und Korrekturen in Ihre Messungen ein. Das nützliche Ergebnis ist eine Werkbank, die das passende Backend für eine Aufgabe wählen kann, statt einer vertrauten Oberfläche mit verborgenen ungeprüften Annahmen.
Quellen und offizielle Medien
- macMLX 0.11.0 vom 17. November 2026.
- README zu 0.11.0: Installation, lokaler Serverbetrieb und Clientkonfiguration.
- Offizielle Dokumentation zu Kompatibilität und früheren Versionen.
- Offizielles Einführungsbild zu macMLX. Das tatsächliche Produkt ist verlinkt; die Diagramme in diesem Artikel sind eigene Erklärungen.
Die Kompatibilitätsprüfungen werden dem Projekt zugeschrieben. Aufgabenbeispiele und Vergleichsverfahren sind vorgeschlagene Übungen für Leser.
Telli.sh-Empfehlung: Halten Sie Modell, Clienteinstellungen und Aufgabenergebnisse gemeinsam fest, damit jedes lokale KI-Experiment einen reproduzierbaren Ausgangspunkt hat. Erstellen Sie Ihre erste Notiz mit Telli.sh.