Anthropic начала помечать тексты Claude водяным знаком — и 1922 судебных дела показывают, чего это не решает
Как текстовый водяной знак Claude указывает на вероятное участие модели, но не подтверждает фактическую точность: ограничения проверки, ложные обвинения и 1922 зафиксированных случая галлюцинаций показывают разницу между происхождением и истиной.
14 августа 2026 года Anthropic объяснила, как будет работать текстовый водяной знак в будущих моделях Claude. В FAQ запуск связывается с требованиями прозрачности Регламента ЕС об ИИ, которые начали применяться 2 августа. Модели, выпущенные раньше этой даты, будут обновлять в течение переходного периода; это не означает, что каждый ответ Claude уже помечен.
Полезная идея — встроить сигнал в выбор слов моделью. При подходящих условиях он может помочь определить участие модели, не меняя вид текста для читателя.
Это различие важно, когда сгенерированный текст содержит вымышленные доказательства. В рассматриваемом ниже снимке общедоступной базы числится 1922 судебных дела, связанных с контентом, содержащим ИИ-галлюцинации. Это не испытания обнаружения водяного знака и не доказательство того, что какой-либо конкретный детектор распознал бы этот текст. Они показывают другую проблему: сигнал происхождения не может подтвердить, что процитированное дело, исследование или факт существуют. Понимание этой разницы помогает использовать результат проверки с пользой и не злоупотреблять им.
Коротко:
- В текст ничего не добавляется. Секретный ключ меняет случайность выбора слов, но не видимый формат. Anthropic планирует глобальное развертывание, постепенно добавляя более старые модели.
- Положительный результат — слабая улика, отрицательный — почти никакая. Anthropic сама пишет, что метка не отличает «Claude это написал» от «Claude это сильно отредактировал», слаба на коротких текстах, коде и чисто фактических фрагментах и стирается переписыванием. В 2024 году исследователи показали, что меньше чем за 50 долларов можно и удалить такие метки, и подделать их на тексте, написанном человеком.
- Происхождение — не проверка. Результат может указывать на вероятное участие модели, но не подтверждает существование дела, ссылки или книги, названных в тексте.
Изображение: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Страница, полная знаков подлинности. Каждый доказывает, что границу пересекли. Ни один не говорит ни слова о том, сказал ли путешественник правду.
Что Anthropic на самом деле изменила, а что нет
Начнём с механизма, потому что почти все дальнейшие недоразумения растут из ошибки именно здесь.
Когда языковая модель пишет, она выдаёт по одному слову, и в большинстве позиций единственно верного выбора нет. «Встреча была продуктивной» и «Встреча была полезной» одинаково годятся. Модель держит список допустимых следующих слов и выбирает одно случайной жеребьёвкой. Именно поэтому один и тот же запрос дважды даёт немного разные ответы.
Текстовый водяной знак заменяет эту жеребьёвку псевдослучайной, управляемой секретным ключом. Модель по-прежнему выбирает только среди слов, которые сама сочла равноценными, поэтому качество не страдает. Но на протяжении нескольких сотен слов картина того, какое допустимое слово побеждало каждый раз, перестаёт выглядеть совпадением, и владелец ключа может её измерить.
Нет скрытых символов или удаляемых текстовых метаданных. Сигнал создаётся выбором слов; Anthropic сообщает, что он не добавляет токены и почти не влияет на скорость. Политика запуска глобальная, а не региональная, но охват моделей зависит от хода внедрения. Сама политика не доказывает, что конкретный ответ помечен водяным знаком.
Ничего научно нового здесь нет. Скотт Ааронсон предложил подход в 2022 году, Кирхенбауэр с коллегами опубликовали рабочую схему на ICML в 2023-м, а Google DeepMind опубликовала SynthID-Text в Nature в октябре 2024 года — реализация Anthropic является её вариантом. Google крутит это в Gemini с 2024 года, сообщая примерно о 20 миллионах реальных ответов без заметной разницы в качестве, и с тех пор заявляет о более чем 10 миллиардах помеченных единиц контента.
Обновление, 12 октября 2026 года: в обновлённом 1 сентября FAQ Anthropic описывает API обнаружения в закрытом предварительном доступе для организаций, отвечающих требованиям; более широкий доступ планируется позднее. Это заменяет статус «скоро» из исходного текста за август. Водяной знак оценивает вероятность участия Claude, но не проверяет истинность текста.
Метка переживает копирование. Переписывание она не переживает.
Сигнал живёт в том, какие слова были выбраны. Значит, всё, что сохраняет выбор слов, сохраняет и метку, а всё, что его заменяет, метку разрушает. Anthropic формулирует потолок прямо: «полное переписывание, в котором каждое слово заменено» её удалит. Два случая ломают эту закономерность так, что многих застают врасплох.
Короткие и фактические тексты почти ничего не несут. Водяному знаку нужен выбор, в котором можно спрятаться. Одна-две фразы не дают достаточно решений, чтобы сложилась картина, а насыщенное фактами содержание может вовсе не оставлять выбора: пример Anthropic — после «Principia Ньютона» следующим словом будет «Mathematica», и никакой ключ тут права голоса не имеет. По той же логике слаб код, где синтаксис задаёт большинство токенов, и корректура, где модель меняет слишком мало слов, чтобы оставить сигнал.
Перевод несёт полноценный водяной знак. Это против интуиции. Попросите Claude перевести документ на японский — и японский текст будет заново сгенерирован Claude, слово за словом, с обычной свободой выбора, а значит выйдет полностью помеченным, хотя мысли пришли из непомеченного человеческого оригинала. Это противоположно тому, что исследователи DeepMind описывают в Nature, где перевод уже помеченного текста на другой язык сильно снижает уверенность обнаружения. Верно и то, и другое, потому что это разные сценарии: перевести помеченный текст на стороне — значит смыть метку, а заставить переводить саму модель — значит поставить новую.
| Что вы делаете с текстом | Метка сохраняется? |
|---|---|
| Копирование и вставка куда угодно | Да — там нет ничего встроенного, что вставка могла бы отсечь |
| Лёгкая правка: опечатки, заголовки, сокращения | Да — большинство выборов слов не тронуто |
| Попросить модель перевести | Да — перевод генерируется заново и потому помечен полностью |
| Глубокий пересказ своими словами | Нет — вы заменяете сами выборы, которые несли сигнал |
| Полное переписывание, каждое слово заменено | Нет — Anthropic указывает, что это её удаляет |
| Короткая выдержка в одну-две фразы | Слабо или никак — слишком мало выборов для картины |
| Код или чисто фактические фрагменты | Слабо — синтаксис и факты не оставляют модели свободы |
| Дать модели вычитать ваш черновик | Слабо или никак — меняется слишком мало слов |
Поведение по описанию Anthropic в FAQ от 14 августа 2026 года и авторов SynthID-Text в Nature, октябрь 2024 года.
Положительный результат — слабая улика. Отрицательный — почти никакая.
Если детектор выдал результат, какой вывод можно обоснованно сделать?
Если результат положительный: что часть этого текста прошла через модель данного поставщика. И всё. Anthropic прямо заявляет, что метка не отличает «Claude это написал» от «Claude это сильно отредактировал», ничего не говорит об истинности хотя бы одного утверждения внутри и не распознаёт текст другого ИИ, потому что знает только свой ключ.
Если результат отрицательный, он не узнал почти ничего. Чистый результат — ровно то же, что вы получите от глубокого пересказа, короткой выдержки, блока кода, модели конкурента или модели с открытыми весами, работающей у кого-то на ноутбуке вообще без маркировки.
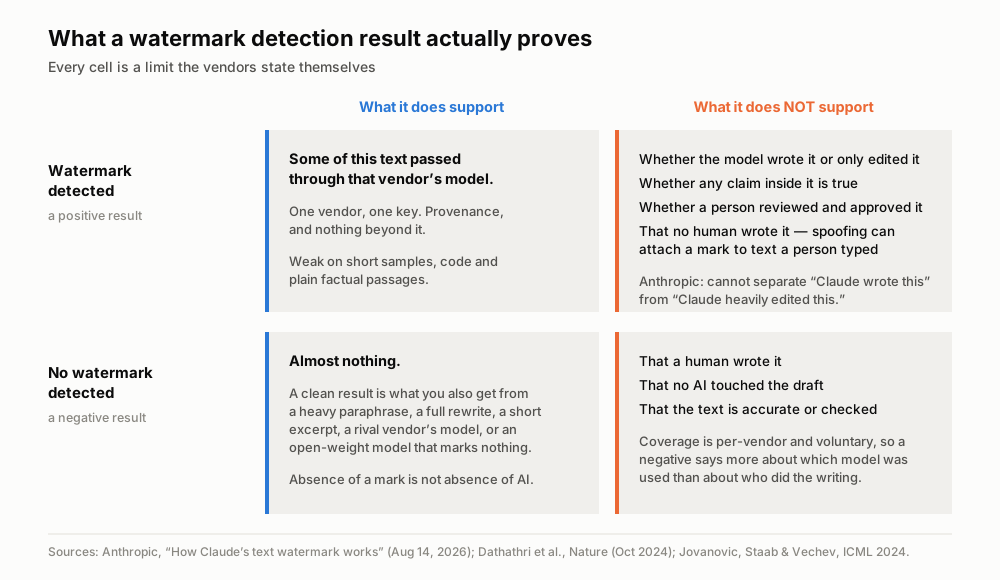
Каждая ячейка здесь — ограничение, опубликованное самими поставщиками. Источники: FAQ Anthropic о водяном знаке (14 августа 2026 года, обновлён 1 сентября); Dathathri et al., Nature (октябрь 2024 года); Jovanović, Staab и Vechev, ICML 2024.
Атака, под которую никто не закладывает бюджет, направлена в другую сторону
Стирание — риск, который представляют себе все: кто-то отмывает текст ИИ, чтобы скрыть происхождение. Хорошо. Но есть вторая атака со стрелкой в обратную сторону, и тревожиться стоит именно из-за неё.
Подделка — это когда текст, написанный человеком, заставляют нести чужой водяной знак. Никто ничего не прячет: наоборот, подбрасывают. Мишень — человек, которого затем обвинят в использовании ИИ, или поставщик, на которого повесят вывод, которого он никогда не производил.
На ICML 2024 Йованович, Штааб и Вечев продемонстрировали обе атаки против передовых схем с успехом более 80% и затратами менее 50 долларов на вычисления. Авторы DeepMind признают то же самое в собственной статье в Nature: водяные знаки «не дают полного решения», для самого своего существования требуют сотрудничества поставщика модели, неисполнимы для моделей с открытыми весами, которые любой может запустить как есть, и «уязвимы к атакам кражи, подделки и стирания». Последняя оговорка и есть весь аргумент, написанный командой, создавшей эту технологию.
Ранние ИИ-детекторы обвиняли не тех студентов
Инструменты обнаружения уже существуют, и это другая технология с задокументированной историей вреда. Водяной знак ставит владелец модели в момент генерации, с помощью ключа. Классификатор гадает постфактум по признакам самого текста: насколько предсказуем выбор слов, насколько разнообразна лексика. Первый что-то знает. Второй сопоставляет шаблоны стиля. Это разница между измерением и профилированием.
OpenAI запустила AI Text Classifier 31 января 2023 года и закрыла его 20 июля того же года «из-за низкой точности». Её собственные цифры: поймано 26% текста ИИ, ошибочно помечено 9% человеческого текста.
Затем в июле 2023 года Лян с коллегами опубликовали в Patterns результат, который должен был закрыть всю категорию. На семи детекторах, применённых к эссе TOEFL, написанным неносителями английского, средняя доля ложных срабатываний составила 61,3%; один детектор пометил 97,8% из них. А когда те же эссе попросили переписать более богатой лексикой, доля упала до 11,6%. Детекторы никогда не измеряли авторство: они измеряли беглость и наказывали тех, чей английский проще.
16 августа 2023 года Университет Вандербильта отключил ИИ-детектор Turnitin. В своём объяснении университет привёл гипотетический расчёт: если применить заявленную долю ложных срабатываний в 1% примерно к 75 000 поданных работ, ошибочно помечены могут быть около 750 работ. Это оценка риска, а не число студентов, действительно обвинённых в использовании ИИ. Объявление Университета Вандербильта.
Проверка водяного знака ищет заданный шаблон генерации, а не выводит авторство из стиля письма. Результат всё равно вероятностный, а короткие или сильно отредактированные фрагменты могут не дать определённого ответа. Результат об участии модели не должен превращаться в обвинение конкретного человека; исследования подделки также показывают, почему одной проверки недостаточно, чтобы установить авторство.
Регулирование пришло раньше инструментов
Всё это скучилось в одну неделю потому, что законодатели двинулись первыми.
Регламент ЕС об ИИ делит обязанность надвое. Статья 50(2) связывает поставщиков: тот, кто строит генеративную систему, обязан помечать её вывод машиночитаемо, включая текст. Статья 50(4) связывает вас: тот, кто публикует сгенерированный ИИ текст, «информирующий общественность по вопросам, представляющим общественный интерес», обязан это раскрыть.
И у второй нормы есть исключение, которое для большинства читателей и составляет практическую суть всего режима. Обязанность не применяется, если контент прошёл человеческую проверку или редакционный контроль и есть лицо, несущее за него редакционную ответственность. Перечитайте. Ответ Европы на сгенерированный ИИ текст — не детектор. Это названный поимённо человек, который его проверил и за него отвечает.
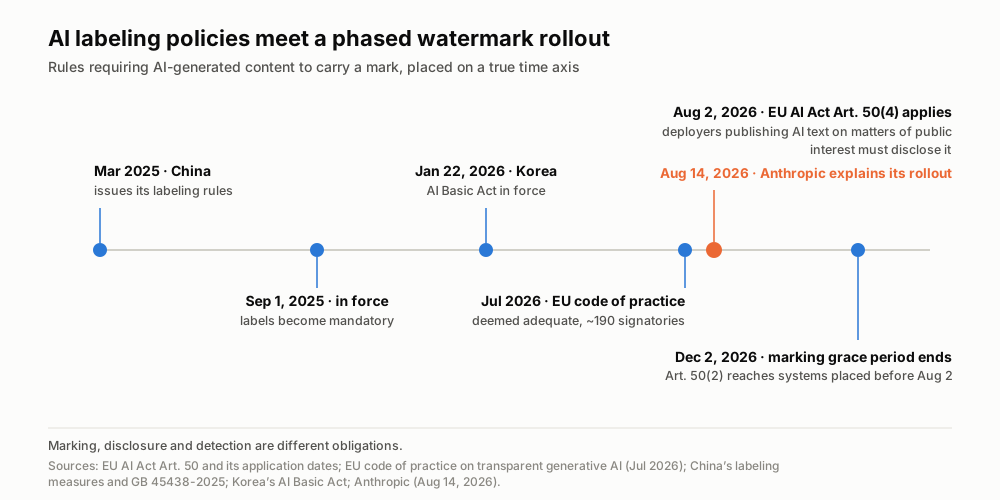
Обязанности маркировки пришли по расписанию, пригодное обнаружение — нет. Источники: Регламент ЕС об ИИ и даты его применения, европейский кодекс практики по прозрачности (июль 2026 года), китайские меры по маркировке и стандарт GB 45438-2025, корейский Базовый закон об ИИ и объявление Anthropic.
Комиссия описывает кодекс прозрачности как добровольную основу для соблюдения требований, а не замену закона; к концу июля 2026 года его подписали около 190 организаций. В FAQ Комиссии для систем, выведенных на рынок до 2 августа, предусмотрен переходный период до 2 декабря 2026 года. Важно различать график внедрения у подписантов и юридическую обязанность: это не одно и то же. Обзор Комиссии, FAQ Комиссии.
В других юрисдикциях действуют другие правила. Китайские меры по маркировке вступили в силу 1 сентября 2025 года и предусматривают видимые и встроенные метки по стандарту GB 45438-2025. Корейский Базовый закон об ИИ вступил в силу 22 января 2026 года. При оценке соблюдения требований нужно учитывать конкретную юрисдикцию и тип контента, а не исходить из единого якобы глобального правила маркировки.
Сюда же относится ещё одно отсутствие. The Wall Street Journal сообщала в 2024 году, что OpenAI разработала метод текстового водяного знака, который внутри компании описывали как точный примерно на 99,9%. Относитесь к этому как к сообщению прессы, а не к факту: цифра никогда независимо не проверялась, и OpenAI никогда не выпускала маркировку текста. Её собственная запись от 11 июня 2026 года о соответствии требованиям ЕС документирует только происхождение изображений и признаёт общее ограничение своими словами: «метаданные могут быть удалены, водяные знаки могут деградировать».
Водяной знак не проверяет достоверность выдуманной цитаты
Дамьен Шарлотен ведёт публичную базу судебных решений по всему миру, в которых суду пришлось разбираться со сгенерированным ИИ содержимым, содержащим галлюцинации. На момент обращения 16 августа 2026 года она показывала 1922 решения. Траектория: около 200 в середине 2025 года, 719 к январю 2026-го, 1227 к апрелю, 1598 на 9 июня и 1922 сегодня — 324 добавились только за последние десять недель.
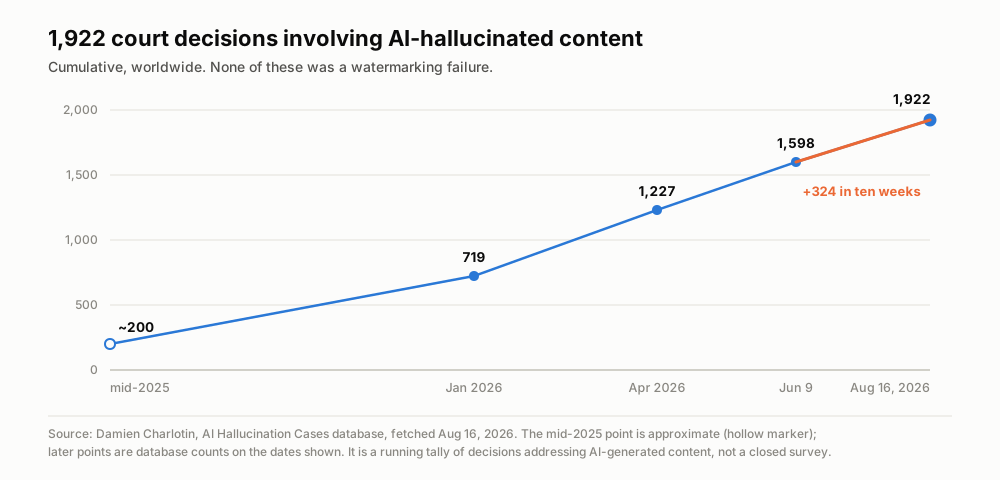
В этих случаях зафиксированы галлюцинации, а не результаты проверки водяного знака. Метка происхождения не подтверждает достоверность утверждений. Источник: база данных дел об ИИ-галлюцинациях Дамьена Шарлотена, обращение 16 августа 2026 года.
Архетип — Mata v. Avianca, решение Южного округа Нью-Йорка от 22 июня 2023 года: состязательная бумага со ссылками на шесть несуществующих судебных решений и санкция в 5000 долларов.
Но самый показательный пример связан с Anthropic. В мае 2025 года по делу Concord Music v. Anthropic юристы компании подали заключение эксперта со ссылкой на исследование, которое Claude выдумал. Ручная проверка это пропустила, и представитель компании извинился перед судом. Компания, выпускающая текстовый водяной знак, сама столкнулась с некритичным цитированием вывода собственной модели в собственном судебном деле, проверенном собственными юристами. Даже положительный результат проверки не доказал бы, что процитированное исследование существует.
Это выходит за пределы судов. Deloitte Australia в октябре 2025 года согласилась частично вернуть деньги за правительственный отчёт стоимостью 440 000 австралийских долларов, содержавший несуществующие ссылки и выдуманную цитату из судебного решения. 18 мая 2025 года Chicago Sun-Times и Philadelphia Inquirer опубликовали синдицированный список летнего чтения, в котором из пятнадцати книг реальными оказались пять. Лян с коллегами, проанализировав 950 965 статей в arXiv:2404.01268, обнаружили изменённое LLM содержание вплоть до 17,5% в аннотациях по информатике против 6,3% и менее в математике и в портфеле журналов Nature.
Вопрос объёма тоже заслуживает честной цифры, а не пугающей. Анализ Common Crawl, выполненный Graphite и опубликованный в октябре 2025 года, показал, что около 51,7% новых статей в выборке были написаны ИИ в мае 2025 года, — и Axios, сообщая об этом, добавила важную оговорку: доля вышла на плато около половины, а не продолжила расти. Это не потоп. Это новая норма.
Вот в чём суть. Ничто в этом списке не является сбоем водяного знака. В каждом случае происхождение не вызывало сомнений: все знали, что участвовала модель, или сразу бы это приняли. Провалилось то, что никто не открыл ссылку и не проверил, существует ли то дело, то исследование, та книга.
Итог: происхождение — не проверка
Назовём это заблуждением почтового штемпеля. Штемпель доказывает, какое отделение обработало письмо. Он никогда не имел мнения о том, правдиво ли письмо. Мы только что вложили немало инженерных сил в очень хороший почтовый штемпель, и часть публичной дискуссии вот-вот примет его за проверяющего факты.
Важно учитывать сразу три вещи. Положительный результат указывает на вероятное участие модели, но не доказывает авторство или истинность текста. Отрицательный результат не доказывает, что текст написал человек. Охват зависит от поставщика, его ключа и моделей, использующих его водяной знак; он не универсален. Обновлённый API Anthropic доступен в закрытом предварительном режиме организациям, отвечающим требованиям, а не всем желающим.
Проверку по-настоящему выдерживает не метка на выводе, а запись, которую можно заново вывести из источника: сохранившаяся аудиозапись, расшифровка с отметками времени, в которую можно вернуться в нужный момент, реплика, приписанная тому, кто её действительно произнёс, утверждение, прослеживаемое до первичного документа, который можно открыть. Мы уже отстаивали это, говоря о синхронном переводе, где проверяемая заметка важнее гладкого вывода, и о расшифровке полицейских допросов, где запись должна выдержать, когда её оспаривают. Эпоха водяных знаков не меняет этот довод, а обостряет его: когда маркировка станет всеобщей, фраза «тут участвовал ИИ» перестанет что-либо различать.
Водяные знаки отвечают, откуда взялся текст. То, что отвечало бы, правдив ли он, ещё никто не построил, потому что это не детектор. Это источник, к которому можно вернуться.
Где здесь Telli.sh: мы строим именно тот источник, к которому можно вернуться. Telli.sh записывает встречу, делает расшифровку с отметками времени и разделением говорящих и держит резюме привязанным к аудио, из которого оно выросло, — так что любую строку в ваших заметках можно и через месяцы проследить до той секунды, когда кто-то это сказал. Это не заявление об обнаружении ИИ. Это вторая половина задачи: когда резюме что-то утверждает, вы можете сверить это с записью, а не верить фразе.
Источники
- Anthropic, "How Claude's text watermark works" (август 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (октябрь 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (июль 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, база данных дел об ИИ-галлюцинациях
- Европейская комиссия, статья 50 Акта об ИИ: требования прозрачности
- Страница изображения на Wikimedia Commons
