Anthropic marca o texto do Claude: o que 1.922 casos judiciais realmente demonstram
A marca d'água textual do Claude pode indicar possível participação do modelo, mas não verifica a exatidão factual. Entenda o que uma detecção permite concluir, quais são seus limites e o que 1.922 casos documentados de alucinação mostram sobre a diferença entre procedência e verdade.
Em 14 de agosto de 2026, a Anthropic explicou como a marca d'água textual funcionará em futuros modelos Claude. O FAQ relaciona o lançamento aos requisitos de transparência da Lei de IA da UE, em vigor desde 2 de agosto. Modelos lançados antes dessa data estão sendo atualizados durante um período de transição; o anúncio não significa que todas as respostas do Claude já tenham marca d'água.
A ideia útil é um sinal nas palavras escolhidas pelo modelo. Nas condições certas, ele pode ajudar a identificar o envolvimento de um modelo sem mudar a aparência do texto para quem lê.
A distinção importa quando um texto gerado contém evidências inventadas. Um registro de um banco de dados público, citado adiante, contabilizou 1.922 casos judiciais envolvendo conteúdo alucinado por IA. Esses casos não são testes de detecção de marca d'água e não demonstram se algum detector específico teria identificado os textos. Eles mostram outro problema: um sinal de procedência não comprova que o caso, estudo ou fato citado exista. Entender essa diferença torna o resultado da marca d'água muito mais útil e muito mais difícil de usar indevidamente.
Resumo:
- Nada é acrescentado ao texto. Uma chave secreta altera a aleatoriedade da escolha das palavras, não o formato visível. A Anthropic prevê um lançamento global, com a inclusão de modelos mais antigos ao longo do tempo.
- Um positivo é prova fraca e um negativo quase não é prova. A própria Anthropic diz que a marca não distingue "o Claude escreveu isto" de "o Claude editou muito isto", que é fraca em textos curtos, em código e em trechos puramente factuais, e que uma reescrita a apaga. Em 2024, pesquisadores mostraram que menos de 50 dólares bastam tanto para remover essas marcas quanto para forjá-las em texto escrito por uma pessoa.
- Procedência não é verificação. Um resultado de detecção pode indicar provável participação do modelo, mas não validar um caso, uma citação ou um livro mencionado no texto.
Imagem: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Uma página cheia de marcas de autenticidade. Cada uma prova que uma fronteira foi cruzada. Nenhuma diz uma palavra sobre se o viajante falou a verdade.
O que a Anthropic mudou de fato, e o que não mudou
Comece pelo mecanismo, porque quase todo mal-entendido depois disso nasce de errar aqui.
Quando um modelo de linguagem escreve, ele produz uma palavra por vez, e na maioria das posições não existe uma única escolha certa. "A reunião foi produtiva" e "A reunião foi útil" servem igualmente. O modelo mantém uma lista de próximas palavras aceitáveis e escolhe uma por sorteio aleatório. É por isso que o mesmo prompt devolve respostas ligeiramente diferentes duas vezes.
Uma marca d'água textual troca esse sorteio por um sorteio pseudoaleatório governado por uma chave secreta. O modelo continua escolhendo apenas entre palavras que já julgava igualmente boas, então a qualidade não muda. Mas ao longo de algumas centenas de palavras, o padrão de qual palavra aceitável venceu a cada vez deixa de parecer coincidência, e quem tem a chave consegue medi-lo.
Não há caracteres ocultos nem metadados textuais removíveis. O sinal vem das palavras escolhidas e, segundo a Anthropic, não acrescenta tokens e tem impacto insignificante na velocidade. A política de lançamento é global, não regional, mas a cobertura depende da implantação; a política, por si só, não comprova que uma resposta específica tenha marca d'água.
Nada disso é ciência nova. Scott Aaronson propôs a abordagem em 2022, Kirchenbauer e colegas publicaram um esquema funcional no ICML em 2023, e o Google DeepMind publicou o SynthID-Text na Nature em outubro de 2024 — a implementação da Anthropic é uma versão daquilo. O Google roda isso no Gemini desde 2024, relatando cerca de 20 milhões de respostas em produção sem diferença de qualidade detectável, e desde então afirma ter marcado mais de 10 bilhões de conteúdos.
Atualização, 12 de outubro de 2026: a atualização de 1º de setembro do FAQ da Anthropic descreve uma API de detecção em prévia privada para organizações elegíveis, com ampliação do acesso planejada. Isso substitui o status de API futura da versão original de agosto. A marca estima a participação do Claude; não verifica se o texto é verdadeiro.
A marca sobrevive a um copiar e colar. Não sobrevive a uma reescrita.
O sinal mora em quais palavras foram escolhidas, então tudo que preserva essas escolhas preserva a marca, e tudo que as substitui a destrói. A Anthropic enuncia o teto sem rodeios: "uma reescrita completa em que cada palavra é substituída" vai removê-la. Dois casos quebram esse padrão de um jeito que pega muita gente de surpresa.
Texto curto e texto factual quase não carregam nada. A marca d'água precisa de escolhas onde se esconder. Uma ou duas frases não oferecem decisões suficientes para formar um padrão, e conteúdo muito factual pode não oferecer escolha nenhuma — o exemplo da Anthropic é que depois de "os Principia de Newton" a próxima palavra vai ser "Mathematica", e nenhuma chave tem voto. A mesma lógica enfraquece código, onde a sintaxe dita a maior parte dos tokens, e a revisão de texto, em que o modelo muda poucas palavras demais para deixar sinal.
A tradução carrega uma marca d'água completa. Esta vai contra a intuição. Peça ao Claude para traduzir um documento para o japonês e esse texto em japonês é gerado do zero pelo Claude, palavra por palavra, com a liberdade de escolha de sempre — então sai plenamente marcado, mesmo que as ideias venham de um original humano sem marca. É o oposto do que os pesquisadores do DeepMind descrevem na Nature, onde traduzir texto marcado para outro idioma reduz muito a confiança de detecção. As duas coisas são verdadeiras porque são cenários diferentes: traduzir em outro lugar um texto marcado lava a marca, enquanto fazer o próprio modelo traduzir imprime uma nova.
| O que você faz com o texto | A marca sobrevive? |
|---|---|
| Copiar e colar em qualquer lugar | Sim — não há nada embutido que colar consiga arrancar |
| Edição leve: erros de digitação, títulos, cortes | Sim — a maioria das escolhas de palavra fica intacta |
| Pedir ao modelo que traduza | Sim — a tradução é gerada do zero, portanto vai plenamente marcada |
| Parafrasear pesado com suas palavras | Não — você substitui justamente as escolhas que carregavam o sinal |
| Reescrita completa, cada palavra trocada | Não — a Anthropic afirma que isso remove a marca |
| Um trecho curto, uma ou duas frases | Fraco a nulo — escolhas de menos para formar um padrão |
| Código, ou trechos puramente factuais | Fraco — sintaxe e fatos não deixam liberdade ao modelo |
| Deixar o modelo revisar o seu rascunho | Fraco a nulo — poucas palavras mudam |
Comportamento conforme declarado pela Anthropic no FAQ de 14 de agosto de 2026 e pelos autores do SynthID-Text na Nature, outubro de 2024.
Um positivo é prova fraca. Um negativo quase não é prova.
Se um detector retorna um resultado, o que é razoável concluir?
Se for positivo: que parte desse texto passou pelo modelo daquele fornecedor. É só isso. A Anthropic afirma com todas as letras que a marca não distingue "o Claude escreveu isto" de "o Claude editou muito isto", não diz nada sobre a veracidade de nenhuma afirmação ali dentro, e não reconhece texto de outra IA, porque só conhece a própria chave.
Se for negativo, essa pessoa não ficou sabendo quase nada. Um resultado limpo é exatamente o que você também obtém de uma paráfrase pesada, de um trecho curto, de um bloco de código, do modelo de um concorrente ou de um modelo de pesos abertos rodando no notebook de alguém sem marcação nenhuma.
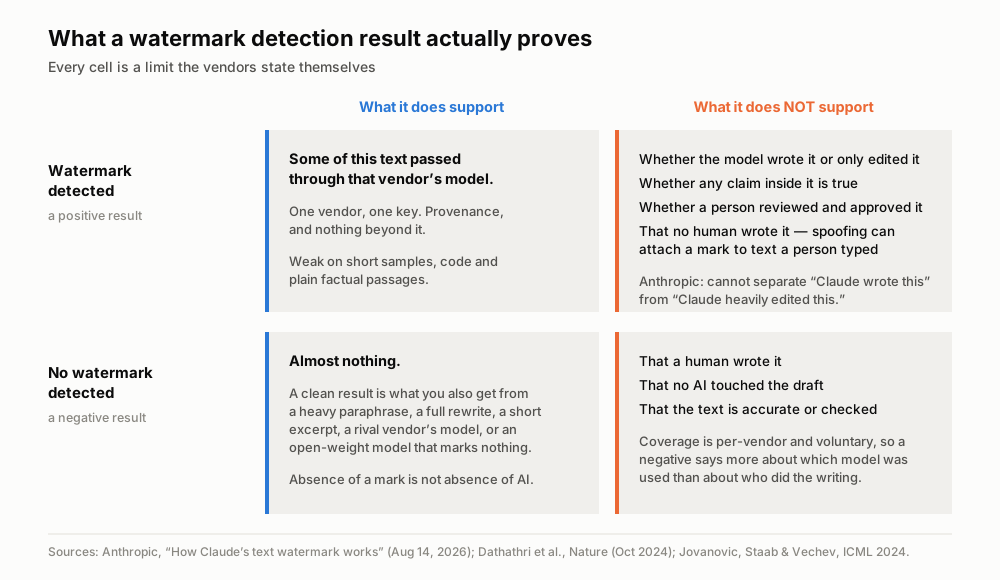
Cada célula aqui é um limite publicado pelos próprios fornecedores. Fontes: FAQ da Anthropic sobre a marca d'água (14 de agosto de 2026, atualizado em 1º de setembro); Dathathri et al., Nature (outubro de 2024); Jovanović, Staab e Vechev, ICML 2024.
O ataque para o qual ninguém reserva orçamento corre no sentido inverso
Apagar é o risco que todo mundo imagina: alguém lava um texto de IA para esconder a origem. Tudo bem. Mas existe um segundo ataque com a seta apontando para o outro lado, e é ele que deveria preocupar você.
Falsificação é fazer um texto escrito por uma pessoa carregar a marca d'água de outra. Ninguém está escondendo nada; está plantando. O alvo é alguém que depois será acusado de usar IA, ou um fornecedor culpado por saídas que nunca produziu.
No ICML de 2024, Jovanović, Staab e Vechev demonstraram os dois ataques contra esquemas de ponta com mais de 80% de sucesso e menos de 50 dólares de computação. Os autores do DeepMind admitem o mesmo terreno no próprio artigo da Nature: marcas d'água "não oferecem uma solução completa", precisam da cooperação do fornecedor do modelo para sequer existir, não são exigíveis em modelos de pesos abertos que qualquer um roda como estão, e são "vulneráveis a ataques de roubo, falsificação e remoção". Essa última oração é o argumento inteiro, escrita pela equipe que construiu a tecnologia.
Os primeiros detectores de IA acusaram os alunos errados
Ferramentas de detecção já existem, e são outra tecnologia, com um histórico documentado de danos. Uma marca d'água é plantada no momento da geração pelo dono do modelo, com uma chave. Um classificador chuta depois do fato, a partir de características do próprio texto: quão previsíveis são as escolhas de palavras, quão variado é o vocabulário. O primeiro sabe alguma coisa. O segundo faz reconhecimento de padrão de estilo. É a diferença entre medir e traçar perfil.
A OpenAI lançou um AI Text Classifier em 31 de janeiro de 2023 e o encerrou em 20 de julho do mesmo ano "devido à sua baixa taxa de acurácia". Os números dela mesma: pegou 26% do texto de IA e sinalizou erroneamente 9% do texto humano.
Depois, Liang e colegas publicaram na Patterns em julho de 2023 o achado que deveria ter encerrado a categoria. Com sete detectores aplicados a redações de TOEFL escritas por falantes não nativos de inglês, a taxa média de falsos positivos foi de 61,3%; um detector sinalizou 97,8% delas. Ao pedir que as mesmas redações fossem reescritas com vocabulário mais rico, a taxa caiu para 11,6%. Os detectores nunca estavam medindo autoria: mediam fluência, e penalizavam quem tivesse o inglês mais simples.
A Universidade Vanderbilt desativou o detector de IA do Turnitin em 16 de agosto de 2023. Sua explicação usou um cálculo hipotético: aplicar uma taxa anunciada de falsos positivos de 1% a cerca de 75.000 trabalhos enviados poderia sinalizar incorretamente aproximadamente 750 trabalhos. Era uma estimativa de risco, não uma contagem de estudantes realmente acusados. Anúncio da Vanderbilt.
A detecção de marca d'água testa um padrão definido de geração, em vez de inferir autoria pelo estilo de escrita. O resultado ainda é probabilístico, e trechos curtos ou muito editados podem ser inconclusivos. Um resultado sobre a participação do modelo não deve virar uma acusação contra uma pessoa específica; pesquisas sobre falsificação também mostram por que a detecção, por si só, não pode estabelecer autoria.
A regulação chegou antes das ferramentas
Tudo isso se acumula em uma quinzena porque os legisladores se moveram primeiro.
A Lei de IA da UE divide o dever em dois. O artigo 50(2) vincula os fornecedores: quem constrói um sistema generativo precisa marcar as saídas de forma legível por máquina, texto incluído. O artigo 50(4) vincula você: quem publica texto gerado por IA que "informa o público sobre assuntos de interesse público" precisa divulgar isso.
E esse segundo item traz uma isenção que é, para a maioria dos leitores, o coração prático de todo o regime. O dever não se aplica quando o conteúdo passou por revisão humana ou controle editorial e uma pessoa detém a responsabilidade editorial por ele. Leia duas vezes. A resposta da Europa ao texto gerado por IA não é um detector. É uma pessoa com nome que revisou aquilo e responde por isso.
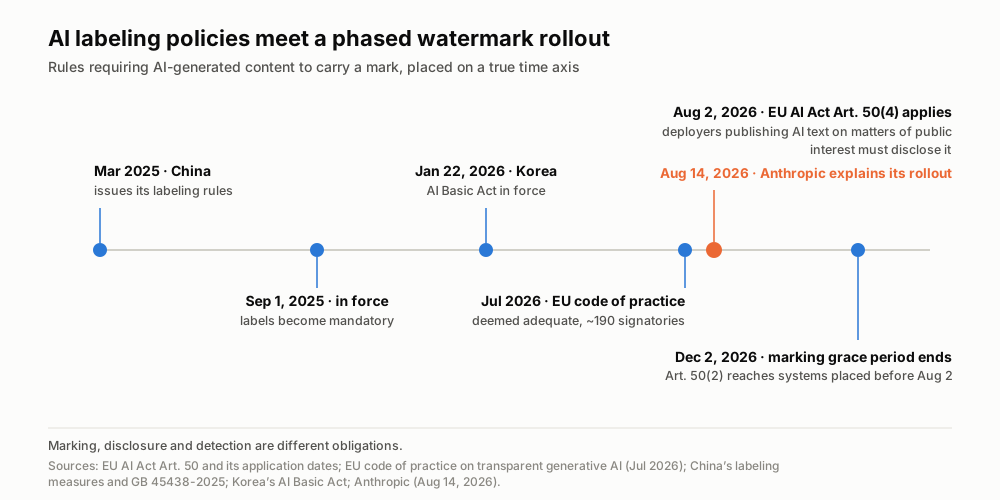
As obrigações de rotulagem chegaram no cronograma; uma detecção utilizável, não. Fontes: a Lei de IA da UE e suas datas de aplicação, o código de conduta europeu sobre transparência (julho de 2026), as medidas chinesas de rotulagem e a norma GB 45438-2025, a Lei Básica de IA da Coreia e o anúncio da Anthropic.
A Comissão descreve seu código de transparência como uma estrutura voluntária de conformidade, não como substituto da lei; cerca de 190 organizações haviam assinado até o fim de julho de 2026. O FAQ prevê um período de transição até 2 de dezembro de 2026 para sistemas colocados no mercado antes de 2 de agosto. A distinção importa: o cronograma de implementação de um signatário e uma obrigação legal não são intercambiáveis. Visão geral da Comissão, FAQ da Comissão.
Outras jurisdições têm regras diferentes. As medidas de rotulagem da China entraram em vigor em 1º de setembro de 2025, com rótulos visíveis e embutidos sob a norma GB 45438-2025. A Lei Básica de IA da Coreia entrou em vigor em 22 de janeiro de 2026. Para avaliar a conformidade, é preciso considerar a jurisdição aplicável e o tipo de conteúdo, não uma suposta regra global única.
Mais uma ausência cabe aqui. O Wall Street Journal noticiou em 2024 que a OpenAI havia construído um método de marca d'água textual descrito internamente como de cerca de 99,9% de acurácia. Trate isso como reportagem, não como fato: o número nunca foi verificado de forma independente e a OpenAI nunca lançou marcação de texto. O próprio post dela de 11 de junho de 2026 sobre conformidade na UE documenta apenas procedência de imagens, e admite o limite geral com as próprias palavras: "metadados podem ser removidos, marcas d'água podem se degradar".
Uma marca d'água não valida uma citação alucinada
Damien Charlotin mantém um banco de dados público de decisões judiciais no mundo todo em que um juiz teve de lidar com conteúdo gerado por IA contendo alucinações. Consultado em 16 de agosto de 2026, marcava 1.922 decisões. A trajetória: cerca de 200 em meados de 2025, 719 em janeiro de 2026, 1.227 em abril, 1.598 em 9 de junho e 1.922 hoje — 324 acrescentadas só nas últimas dez semanas.
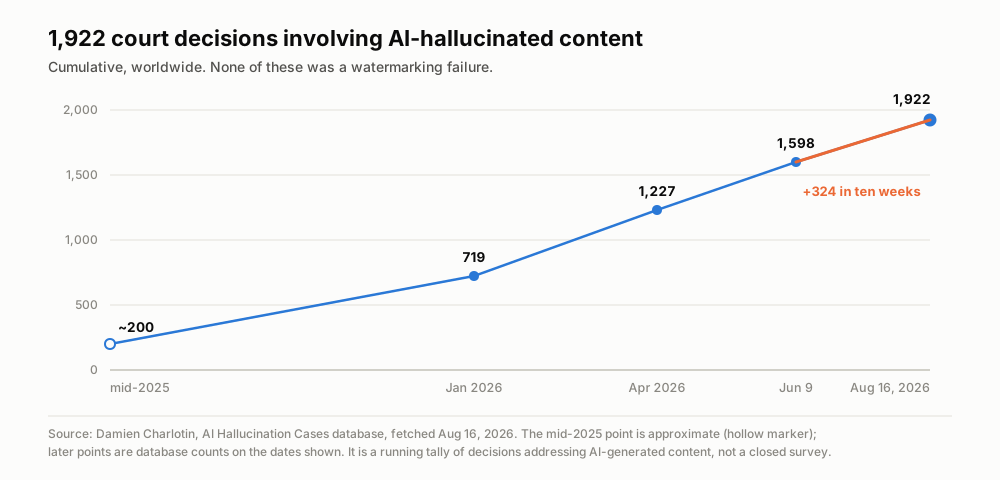
Esses casos documentam alucinações, não resultados testados de detecção de marca d'água. Uma marca de procedência não valida as afirmações factuais. Fonte: banco de dados de casos de alucinação de IA de Damien Charlotin, consultado em 16 de agosto de 2026.
O arquétipo é Mata v. Avianca, decidido no Distrito Sul de Nova York em 22 de junho de 2023: uma petição citando seis decisões judiciais que não existiam, e uma sanção de 5.000 dólares.
Mas o exemplo que deveria pesar mais pertence à Anthropic. Em maio de 2025, em Concord Music v. Anthropic, os próprios advogados da empresa protocolaram uma declaração pericial citando um estudo que o Claude havia alucinado. Uma conferência manual deixou passar; o advogado se desculpou com o tribunal. A empresa que agora lança uma marca d'água textual se queimou justamente citando sem espírito crítico a saída do próprio modelo, no próprio processo, com os próprios advogados revisando. Uma marca d'água naquela declaração não teria estabelecido se o estudo citado existia.
Isso vai além dos tribunais. A Deloitte Austrália concordou em outubro de 2025 em reembolsar parcialmente um relatório de governo de 440.000 dólares australianos com referências inexistentes e uma citação inventada de uma sentença. Em 18 de maio de 2025, o Chicago Sun-Times e o Philadelphia Inquirer publicaram uma lista de leituras de verão distribuída por sindicalização em que só cinco dos quinze livros existiam. Liang e colegas, analisando 950.965 artigos em arXiv:2404.01268, encontraram conteúdo modificado por LLM chegando a 17,5% dos resumos de ciência da computação, contra 6,3% ou menos em matemática e no portfólio da Nature.
A questão do volume também merece um número honesto em vez de um alarmante. Uma análise do Common Crawl feita pela Graphite e publicada em outubro de 2025 encontrou cerca de 51,7% dos novos artigos amostrados escritos por IA em maio de 2025 — e o Axios, ao noticiar, acrescentou a ressalva que importa: essa fatia estabilizou perto da metade em vez de continuar subindo. Não é uma enxurrada. É uma nova normalidade.
Aqui está o ponto. Nada nessa lista é uma falha de marca d'água. Em todos os casos a procedência nunca esteve em dúvida: todo mundo sabia que havia um modelo envolvido, ou aceitaria na hora. O que falhou foi ninguém abrir a referência e conferir se aquele caso, aquele estudo, aquele livro existia.
Conclusão: procedência não é verificação
Vamos chamar isso de falácia do carimbo postal. Um carimbo prova qual agência processou a carta. Ele nunca teve opinião sobre se a carta é verdadeira. Acabamos de investir bastante engenharia para construir um carimbo postal muito bom, e uma parte do debate público está prestes a confundi-lo com um verificador de fatos.
Tenha três pontos em mente. Uma detecção positiva é um indício fraco de possível participação do modelo; não comprova autoria nem verdade. Um resultado negativo não prova que uma pessoa escreveu o texto. A cobertura depende do fornecedor, de sua chave e dos modelos que usam sua marca d'água; não é universal. A API da Anthropic em prévia privada também exige critérios de elegibilidade, em vez de oferecer acesso público irrestrito.
O que de fato resiste ao escrutínio não é uma marca na saída. É um registro que você consegue rederivar a partir da fonte: uma gravação que ainda existe, uma transcrição com marcação de tempo em que você pode voltar ao momento em questão, uma frase atribuída a quem realmente a disse, uma afirmação rastreável até um documento primário que você pode abrir. Já defendemos isso ao falar de tradução ao vivo, em que a nota revisável importa mais do que a saída fluente, e de transcrição de interrogatórios policiais, em que o registro precisa aguentar quando alguém o contesta. A era da marca d'água não muda esse argumento, ela o afia: quando a marcação for universal, "houve IA envolvida" deixa de distinguir qualquer coisa.
Marcas d'água respondem de onde o texto veio. Ninguém construiu ainda a coisa que responde se ele é verdadeiro, porque essa coisa não é um detector. É uma fonte à qual você pode voltar.
Onde a Telli.sh entra: nós construímos exatamente essa fonte à qual voltar. A Telli.sh grava a reunião, produz uma transcrição com marcação de tempo e falantes identificados, e mantém o resumo ancorado no áudio de onde ele veio — de modo que qualquer linha das suas notas pode ser rastreada, meses depois, até o segundo em que alguém a disse. Isso não é uma promessa sobre detectar IA. É a outra metade do problema: quando um resumo afirma algo, você pode conferir contra a gravação em vez de confiar na frase.
Começar uma nota de IA ao vivo
Fontes
- Anthropic, "How Claude's text watermark works" (agosto de 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (outubro de 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (julho de 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, banco de dados de casos de alucinação de IA
- Comissão Europeia, artigo 50 da Lei de IA: obrigações de transparência
- Página da imagem no Wikimedia Commons
