Anthropic filigrane les textes de Claude — et 1 922 décisions de justice montrent ce que cela ne règle pas
Comment le filigrane textuel de Claude signale une probable intervention du modèle sans vérifier l'exactitude des faits : limites de la détection, fausses accusations et enseignements de 1 922 cas d'hallucinations documentés sur la différence entre provenance et vérité.
Le 14 août 2026, Anthropic a expliqué comment le filigrane textuel fonctionnerait dans les futurs modèles Claude. Sa FAQ relie le déploiement aux exigences de transparence de l'AI Act européen, applicables depuis le 2 août. Les modèles publiés avant cette date sont mis à jour pendant une période de transition ; l'annonce ne signifie pas que chaque réponse de Claude porte déjà un filigrane.
L'idée utile est celle d'un signal inscrit dans les choix de mots du modèle. Dans de bonnes conditions, il peut aider à repérer l'intervention d'un modèle sans changer l'apparence du texte pour le lecteur.
La distinction compte lorsque du texte généré contient des éléments inventés. L'instantané d'une base publique évoqué plus loin recensait 1 922 décisions de justice liées à des contenus hallucinés par l'IA. Il ne s'agit pas de tests de détection par filigrane, et ces chiffres ne permettent pas de savoir si un détecteur donné aurait repéré le texte. Ils illustrent un autre problème : un signal de provenance ne peut pas établir qu'une affaire, une étude ou un fait cité existe. Comprendre cet écart rend un résultat de détection plus utile et beaucoup plus difficile à détourner.
L'essentiel :
- Rien n'est ajouté au texte. Une clé secrète modifie l'aléatoire qui intervient dans le choix des mots, pas le format visible. Anthropic prévoit un déploiement mondial ; les anciens modèles seront ajoutés progressivement.
- Un résultat positif est une preuve faible, un négatif n'en est presque pas une. Anthropic écrit elle-même que la marque ne permet pas de distinguer « Claude a écrit ceci » de « Claude a fortement retravaillé ceci », qu'elle est faible sur les textes courts, le code et les passages purement factuels, et qu'une réécriture l'efface. En 2024, des chercheurs ont montré que moins de 50 dollars suffisent à la fois pour effacer ces marques et pour les falsifier sur un texte écrit par un humain.
- La provenance n'est pas la vérification. Un résultat de détection peut indiquer une probable intervention du modèle, mais ne valide ni une décision, ni une citation, ni un livre mentionné dans le texte.
Image : Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Une page pleine de marques d'authenticité. Chacune prouve qu'une frontière a été franchie. Aucune ne dit un mot sur la sincérité du voyageur.
Ce qu'Anthropic a réellement changé, et ce qu'elle n'a pas changé
Commençons par le mécanisme, car presque tous les malentendus qui suivent viennent d'une erreur à cette étape.
Quand un modèle de langue écrit, il produit un mot à la fois, et à la plupart des positions il n'existe pas un seul choix correct. « La réunion a été productive » et « La réunion a été utile » se valent. Le modèle dispose d'une liste de mots suivants acceptables et en choisit un par tirage aléatoire. C'est pour cela que la même consigne vous donne deux réponses légèrement différentes.
Un filigrane textuel remplace ce tirage aléatoire par un tirage pseudo-aléatoire piloté par une clé secrète. Le modèle ne choisit toujours que parmi des mots qu'il jugeait déjà équivalents, la qualité reste donc intacte. Mais sur quelques centaines de mots, le motif indiquant quel mot acceptable l'a emporté à chaque fois cesse de ressembler à une coïncidence, et quiconque détient la clé peut le mesurer.
Il n'y a ni caractère caché ni métadonnée textuelle amovible. Le signal vient des choix de mots ; Anthropic indique qu'aucun jeton n'est ajouté et que l'effet sur la vitesse est négligeable. La politique de lancement est mondiale plutôt que régionale, mais la couverture des modèles dépend toujours du déploiement. La politique seule ne permet pas d'établir qu'une réponse donnée est filigranée.
Rien de tout cela n'est neuf sur le plan scientifique. Scott Aaronson a proposé l'approche en 2022, Kirchenbauer et ses collègues ont publié un schéma fonctionnel à l'ICML en 2023, et Google DeepMind a publié SynthID-Text dans Nature en octobre 2024 — l'implémentation d'Anthropic en est une variante. Google le fait tourner dans Gemini depuis 2024, rapportant environ 20 millions de réponses en production sans différence de qualité détectable, et revendique depuis plus de 10 milliards de contenus filigranés.
Mise à jour du 12 octobre 2026 : la FAQ mise à jour le 1er septembre par Anthropic décrit une API de détection en préversion privée pour les organisations éligibles, avec un accès plus large prévu. Cette information remplace le statut « API à venir » de l'instantané d'août. Le filigrane estime la participation de Claude ; il ne vérifie pas si le texte est vrai.
La marque survit à un copier-coller. Elle ne survit pas à une réécriture.
Le signal réside dans les mots qui ont été choisis. Tout ce qui préserve ces choix préserve donc la marque, et tout ce qui les remplace la détruit. Anthropic énonce le plafond sans détour : « une réécriture complète où chaque mot est remplacé » la supprimera. Deux cas rompent ce schéma d'une manière qui prend les gens de court.
Les textes courts et factuels ne portent presque rien. Le filigrane a besoin de choix où se loger. Une ou deux phrases n'offrent pas assez de décisions pour former un motif, et un contenu très factuel peut n'offrir aucun choix réel — l'exemple d'Anthropic est parlant : après « les Principia de Newton », le mot suivant sera « Mathematica », et aucune clé n'a voix au chapitre. La même logique affaiblit le code, où la syntaxe impose l'essentiel des jetons, et la relecture, où le modèle modifie trop peu de mots pour laisser un signal.
La traduction porte un filigrane complet. Celui-ci va contre l'intuition. Demandez à Claude de traduire un document en japonais : ce texte japonais est nouvellement généré par Claude, mot après mot, avec la liberté de choix habituelle. Il ressort donc pleinement marqué, alors même que les idées venaient d'un original humain non marqué. C'est l'inverse de ce que décrivent les chercheurs de DeepMind dans Nature, où traduire un texte filigrané vers une autre langue réduit fortement la confiance de détection. Les deux sont vrais, ce sont deux scénarios différents : traduire ailleurs un texte marqué délave la marque, tandis que faire traduire le modèle lui-même en appose une nouvelle.
| Ce que vous faites au texte | La marque survit-elle ? |
|---|---|
| Copier-coller n'importe où | Oui — rien n'est intégré qu'un collage pourrait retirer |
| Édition légère : fautes, titres, coupes | Oui — l'essentiel des choix de mots reste intact |
| Demander au modèle de le traduire | Oui — la traduction est générée à neuf, donc pleinement marquée |
| Paraphrase profonde avec vos propres mots | Non — vous remplacez les choix qui portaient le signal |
| Réécriture complète, chaque mot remplacé | Non — Anthropic indique que cela la supprime |
| Un extrait court, une ou deux phrases | Faible à nul — trop peu de choix pour former un motif |
| Du code, ou des passages purement factuels | Faible — syntaxe et faits ne laissent aucune liberté au modèle |
| Faire relire votre brouillon par le modèle | Faible à nul — trop peu de mots modifiés |
Comportement tel qu'indiqué par Anthropic dans sa FAQ du 14 août 2026 et par les auteurs de SynthID-Text dans Nature, octobre 2024.
Un positif est une preuve faible. Un négatif n'en est presque pas une.
Si un détecteur renvoie un résultat, que peut-on raisonnablement en conclure ?
S'il est positif : qu'une partie de ce texte est passée par le modèle de ce fournisseur. C'est tout. Anthropic précise clairement que la marque ne permet pas de distinguer « Claude a écrit ceci » de « Claude a fortement retravaillé ceci », qu'elle ne dit rien de la véracité de la moindre affirmation, et qu'elle ne reconnaît pas un texte venu d'une autre IA, puisqu'elle ne connaît jamais que sa propre clé.
S'il est négatif, il n'a presque rien appris. Un résultat propre est exactement ce que vous obtenez aussi avec une paraphrase, un extrait court, un bloc de code, le modèle d'un concurrent, ou un modèle à poids ouverts tournant sur l'ordinateur de quelqu'un sans aucun marquage.
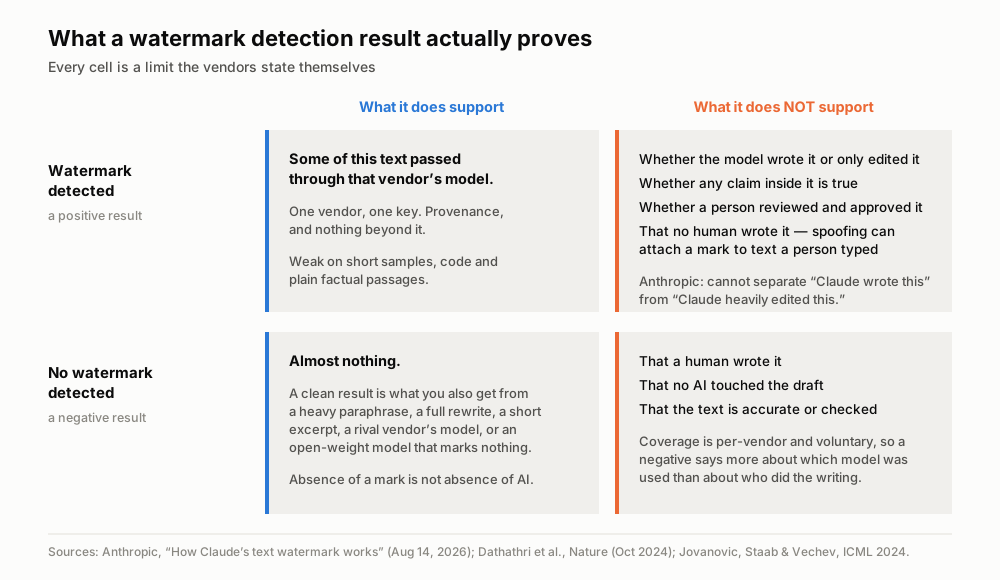
Chaque case ici est une limite que les fournisseurs ont publiée eux-mêmes. Sources : FAQ filigrane d'Anthropic (14 août 2026, mise à jour le 1er septembre) ; Dathathri et al., Nature (octobre 2024) ; Jovanović, Staab et Vechev, ICML 2024.
L'attaque que personne ne budgète va dans l'autre sens
L'effacement est le risque que tout le monde imagine : quelqu'un blanchit un texte d'IA pour en masquer l'origine. Soit. Mais il existe une seconde attaque dont la flèche pointe dans l'autre sens, et c'est celle-là qui devrait vous inquiéter.
L'usurpation consiste à faire porter à un texte écrit par un humain le filigrane de quelqu'un d'autre. Personne ne cache rien : on plante quelque chose. La cible est une personne qui se retrouvera accusée d'avoir utilisé l'IA, ou un fournisseur à qui l'on imputera des sorties qu'il n'a jamais produites.
À l'ICML 2024, Jovanović, Staab et Vechev ont démontré les deux attaques contre des schémas à l'état de l'art avec plus de 80 % de réussite, pour moins de 50 dollars de calcul. Les auteurs de DeepMind concèdent le même terrain dans leur propre article de Nature : les filigranes « n'offrent pas une solution complète », ils exigent la coopération du fournisseur du modèle pour seulement exister, ils sont inapplicables aux modèles à poids ouverts que chacun peut faire tourner tels quels, et ils sont « vulnérables aux attaques de vol, d'usurpation et d'effacement ». Cette dernière proposition résume tout le débat, écrite par l'équipe qui a construit la technologie.
Les premiers détecteurs d'IA ont accusé des étudiants à tort
Les outils de détection existent déjà, et ils relèvent d'une autre technologie avec un historique de dommages documenté. Un filigrane est apposé au moment de la génération par le propriétaire du modèle, avec une clé. Un classifieur devine après coup, à partir des caractéristiques du texte lui-même : à quel point les choix de mots sont prévisibles, à quel point le vocabulaire est varié. Le premier sait quelque chose. Le second fait de la reconnaissance de style. C'est la différence entre mesurer et profiler.
OpenAI a lancé un AI Text Classifier le 31 janvier 2023 et l'a retiré le 20 juillet de la même année « en raison de son faible taux d'exactitude ». Ses propres chiffres : 26 % des textes d'IA détectés, 9 % des textes humains signalés à tort.
Puis Liang et ses collègues ont publié dans Patterns en juillet 2023 le résultat qui aurait dû clore la catégorie. Sur sept détecteurs appliqués à des essais TOEFL rédigés par des locuteurs non natifs de l'anglais, le taux moyen de faux positifs atteignait 61,3 % ; un détecteur en a signalé 97,8 %. En demandant de reformuler les mêmes essais avec un vocabulaire plus riche, ce taux tombait à 11,6 %. Les détecteurs ne mesuraient jamais la paternité du texte : ils mesuraient l'aisance, et pénalisaient quiconque avait un anglais plus simple.
L'université Vanderbilt a désactivé le détecteur d'IA de Turnitin le 16 août 2023. Son explication reposait sur un calcul hypothétique : appliquer un taux annoncé de 1 % de faux positifs à environ 75 000 copies soumises pouvait conduire à signaler à tort près de 750 copies. Il s'agissait d'une estimation du risque, et non du nombre d'étudiants effectivement accusés. Annonce de Vanderbilt.
La détection par filigrane teste un motif de génération défini au lieu de déduire la paternité du style d'écriture. Le résultat reste probabiliste et peut être inconclusif sur des passages courts ou fortement remaniés. Un résultat concernant l'intervention d'un modèle ne doit pas devenir une accusation visant une personne ; les recherches sur l'usurpation montrent aussi pourquoi la détection seule ne peut pas établir la paternité.
La réglementation est arrivée avant les outils
Si tout cela atterrit en une même quinzaine, c'est que le législateur a bougé le premier.
Le règlement européen sur l'IA scinde l'obligation en deux. L'article 50, paragraphe 2 vise les fournisseurs : celui qui construit un système génératif doit marquer ses sorties de façon lisible par machine, texte compris. L'article 50, paragraphe 4 vous vise, vous : le déployeur qui publie un texte généré par IA « informant le public sur des questions d'intérêt public » doit le divulguer.
Ce second point s'accompagne d'une exemption qui constitue, pour la plupart des lecteurs, le cœur pratique du dispositif. L'obligation ne s'applique pas lorsque le contenu a fait l'objet d'un contrôle humain ou éditorial et qu'une personne assume la responsabilité éditoriale. Relisez-le. La réponse européenne au texte généré par IA n'est pas un détecteur. C'est une personne nommée qui l'a relu et qui en répond.
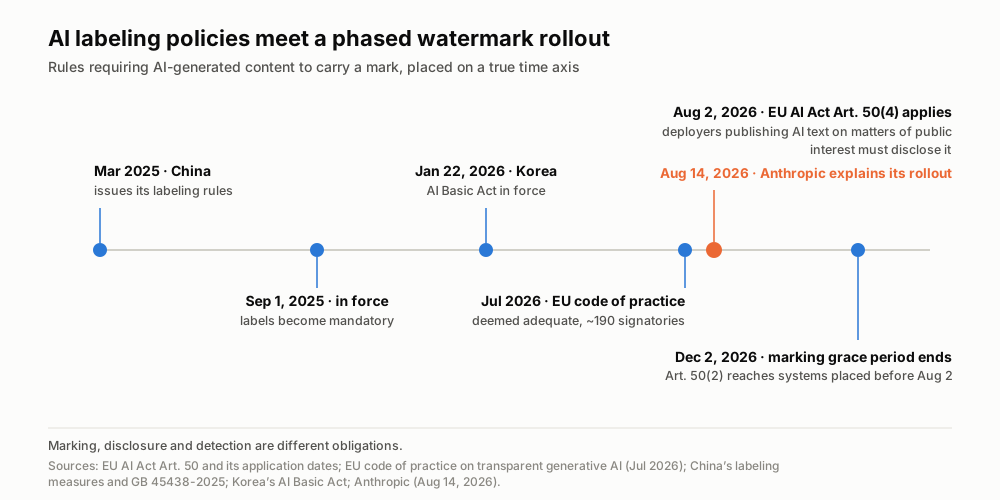
Les obligations d'étiquetage sont arrivées à l'heure ; une détection utilisable, non. Sources : le règlement européen sur l'IA et ses dates d'application, le code de bonnes pratiques européen sur la transparence (juillet 2026), les mesures chinoises d'étiquetage et la norme GB 45438-2025, la loi-cadre coréenne sur l'IA, et l'annonce d'Anthropic.
La Commission présente son code de transparence comme un cadre volontaire de conformité, et non comme un remplacement de la loi ; environ 190 organisations l'avaient signé fin juillet 2026. Sa FAQ accorde aux systèmes mis sur le marché avant le 2 août une période de transition jusqu'au 2 décembre 2026. La distinction compte : le calendrier de mise en œuvre d'un signataire et une obligation légale ne sont pas interchangeables. Présentation de la Commission, FAQ de la Commission.
D'autres juridictions appliquent des règles différentes. Les mesures chinoises d'étiquetage sont entrées en vigueur le 1er septembre 2025 et prévoient des étiquettes visibles et intégrées selon la norme GB 45438-2025. La loi-cadre coréenne sur l'IA est entrée en vigueur le 22 janvier 2026. Pour évaluer la conformité, il faut tenir compte de la juridiction applicable et du type de contenu, plutôt que d'une règle unique prétendument mondiale.
Une autre absence a sa place ici. Le Wall Street Journal a rapporté en 2024 qu'OpenAI avait mis au point une méthode de filigrane textuel décrite en interne comme précise à environ 99,9 %. À traiter comme une information de presse, pas comme un fait : le chiffre n'a jamais été vérifié de façon indépendante et OpenAI n'a jamais déployé de marquage de texte. Son propre billet du 11 juin 2026 sur la conformité européenne ne documente que la provenance des images, et concède la limite générale avec ses propres mots : « les métadonnées peuvent être supprimées, les filigranes peuvent se dégrader ».
Un filigrane ne peut pas valider une citation hallucinée
Damien Charlotin tient une base publique de décisions de justice, dans le monde entier, où un juge a dû traiter d'un contenu généré par IA contenant des hallucinations. Consultée le 16 août 2026, elle affichait 1 922 décisions. La trajectoire : environ 200 à la mi-2025, 719 en janvier 2026, 1 227 en avril, 1 598 au 9 juin et 1 922 aujourd'hui — 324 ajoutées sur les dix dernières semaines seulement.
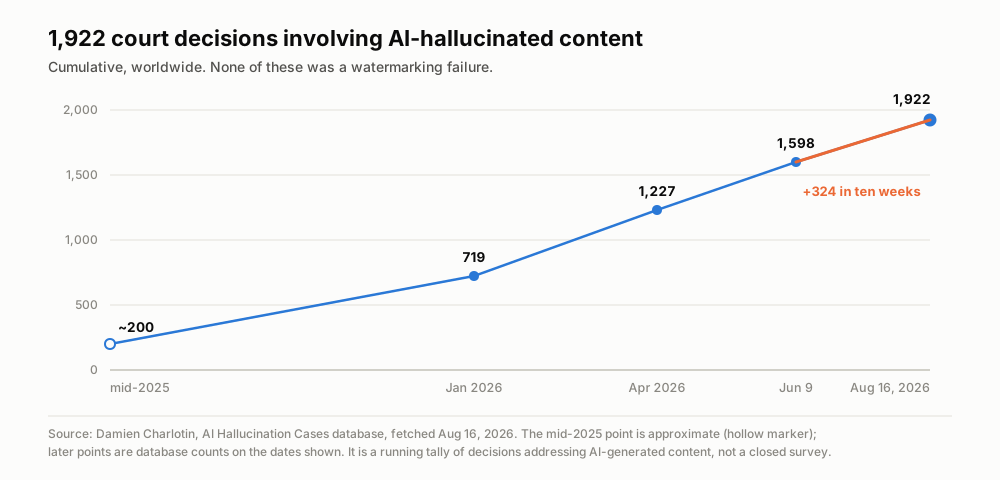
Ces affaires documentent des hallucinations, pas des résultats de tests de filigrane. Une marque de provenance ne peut pas valider leurs affirmations factuelles. Source : base de données des affaires d'hallucination d'IA de Damien Charlotin, consultée le 16 août 2026.
L'archétype est Mata v. Avianca, tranchée le 22 juin 2023 dans le district sud de New York : un mémoire citant six décisions judiciaires inexistantes, et une sanction de 5 000 dollars.
Mais l'exemple qui devrait peser le plus appartient à Anthropic. En mai 2025, dans Concord Music v. Anthropic, les avocats de l'entreprise ont déposé une déclaration d'expert citant une étude que Claude avait hallucinée. Une vérification manuelle est passée à côté, le conseil a présenté ses excuses au tribunal. L'entreprise qui déploie aujourd'hui un filigrane textuel s'est elle-même brûlée à citer sans esprit critique — la sortie de son propre modèle, dans son propre contentieux, avec ses propres avocats en relecture. Même un résultat positif du filigrane n'aurait pas permis d'établir si l'étude citée existait.
Cela déborde du prétoire. Deloitte Australie a accepté en octobre 2025 de rembourser partiellement un rapport gouvernemental de 440 000 dollars australiens contenant des références inexistantes et une citation fabriquée tirée d'un jugement. Le 18 mai 2025, le Chicago Sun-Times et le Philadelphia Inquirer ont publié une liste de lectures d'été diffusée en syndication où seuls cinq des quinze livres existaient. Liang et ses collègues, analysant 950 965 articles dans arXiv:2404.01268, ont relevé jusqu'à 17,5 % de contenu modifié par LLM dans les résumés d'informatique, contre 6,3 % ou moins en mathématiques et dans le portefeuille Nature.
La question du volume mérite elle aussi un chiffre honnête plutôt qu'alarmant. Une analyse de Common Crawl par Graphite publiée en octobre 2025 a trouvé qu'environ 51,7 % des nouveaux articles échantillonnés étaient écrits par IA en mai 2025 — et Axios, en la relayant, a ajouté la nuance qui compte : cette part a plafonné autour de la parité au lieu de continuer à grimper. Ce n'est pas un déluge. C'est une nouvelle normalité.
Voilà le point. Rien dans cette liste n'est un échec du filigrane. Dans chaque cas, la provenance n'a jamais fait débat : tout le monde savait qu'un modèle était impliqué, ou l'aurait admis aussitôt. Ce qui a échoué, c'est que personne n'a ouvert la référence pour vérifier si l'arrêt, l'étude ou le livre existait.
En résumé : la provenance n'est pas la vérification
Appelons cela le sophisme du cachet postal. Un cachet prouve quel bureau a traité la lettre. Il n'a jamais eu d'avis sur la véracité de son contenu. Nous venons de consacrer beaucoup d'ingénierie à fabriquer un très bon cachet, et une partie du débat public s'apprête à le prendre pour un vérificateur de faits.
Gardez trois idées à l'esprit. Un résultat positif indique une probable intervention du modèle, pas l'identité de l'auteur ni la véracité du texte. Un résultat négatif ne prouve pas qu'une personne a écrit le texte. La couverture dépend du fournisseur, de sa clé et des modèles qui utilisent son filigrane ; elle n'est pas universelle. L'API Anthropic, encore en préversion privée, est elle aussi soumise à des critères d'éligibilité et n'est pas accessible librement au public.
Ce qui résiste vraiment à l'examen n'est pas une marque sur la sortie. C'est un enregistrement que vous pouvez redériver depuis sa source : un audio qui existe encore, une transcription horodatée où vous pouvez revenir au moment précis, une phrase attribuée à la personne qui l'a réellement dite, une affirmation remontant à un document primaire que vous pouvez ouvrir. Nous l'avons déjà défendu à propos de la traduction en direct, où la note relisible compte plus que la sortie fluide, et de la transcription des auditions de police, où le compte rendu doit tenir quand quelqu'un le conteste. L'ère du filigrane ne change pas cet argument, elle l'aiguise : dès lors que le marquage devient universel, « une IA était impliquée » ne distingue plus rien.
Les filigranes répondent à la question de l'origine du texte. Ce qui répondrait à celle de sa véracité, personne ne l'a construit, parce que cette chose n'est pas un détecteur. C'est une source à laquelle vous pouvez revenir.
Ce que Telli.sh apporte : nous construisons précisément cette source à laquelle revenir. Telli.sh enregistre la réunion, produit une transcription horodatée avec les intervenants identifiés, et maintient le résumé ancré à l'audio dont il est issu — n'importe quelle ligne de vos notes peut donc être remontée, des mois plus tard, à la seconde où quelqu'un l'a dite. Ce n'est pas une promesse de détection d'IA. C'est l'autre moitié du problème : quand un résumé affirme quelque chose, vous pouvez le confronter à l'enregistrement au lieu de croire la phrase.
Démarrer une note IA en direct
Sources
- Anthropic, "How Claude's text watermark works" (août 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (octobre 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (juillet 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, base de données des affaires d'hallucination d'IA
- Commission européenne, article 50 de la loi sur l'IA : obligations de transparence
- Page de l'image sur Wikimedia Commons
