Llama Windows:无需终端配置,开始你的首次本地 AI 对话
安全安装 Llama Windows,选择适合电脑的 GGUF 模型,试用三个实用提示词,并连接本地 API,同时避免将服务器暴露到网络。
你的第一个本地 AI 任务应该很简单:把六条虚构会议记录整理成三项待办。你不该为了确认电脑能不能回答问题,就先编译推理引擎、猜十几个启动参数,或者上传私人文件。
Hugging Face 于 2026 年 10 月 13 日发布了 Llama Windows,将 llama.cpp 运行时封装在一款 Windows 系统托盘应用中。它负责发现和下载模型,然后提供本地聊天界面,以及供其他应用使用的 API。这个名称指的是应用本身,并不表示它只能运行 Meta 的 Llama 模型。发布公告
本指南将带你安全安装应用、选择合适的首个模型,并进行一次可以核对的对话。之后我们还会逐步尝试三项实用任务,以及一个可选的本地 API 请求。请先使用公开或虚构文本;完整了解工作流后,再考虑输入敏感材料。
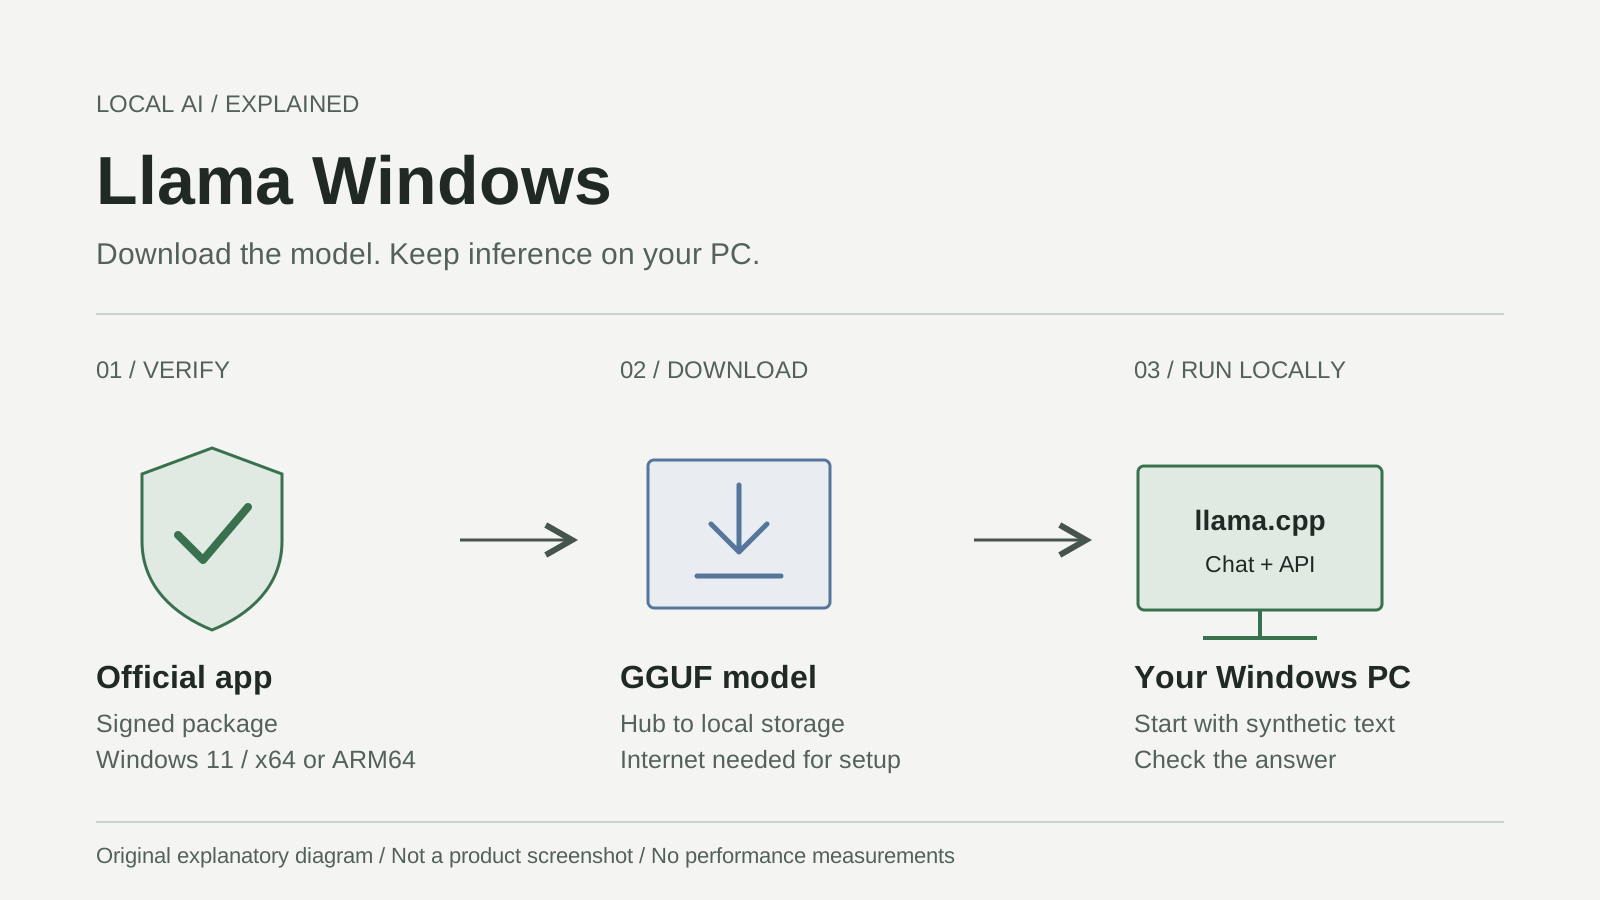
原创说明图,并非产品截图。设置下载模型与本地推理是两个不同阶段。依据:Windows 官方安装指南。
选择模型前,先核对 Windows 版本
截至 10 月 20 日,最新发布的 Windows 版本是 v0.12.0。其软件包清单要求 Windows.Desktop 10.0.26100.0 或更高版本。内部版本 26100 对应 Windows 11 24H2;请使用目前仍受支持的 Windows 版本,而不只是刚好满足安装条件的最低版本。版本发布页、版本清单、Microsoft 版本信息
在 Windows 搜索中运行 winver,检查系统版本。在 Windows 设置中打开 系统 > 关于,查看系统类型和已安装内存。官方 .msixbundle 包含 x64 和 ARM64 版本:Intel/AMD Windows 电脑通常使用 x64;Windows on Arm 设备则使用 ARM64。软件包会自动选择架构。当前发布资源中没有 32 位 x86 安装包。Windows 代码仓库、软件包配置
Windows 安装文档没有规定统一的 RAM、VRAM 或独立显卡最低要求。实际需求取决于模型和上下文长度。llama.cpp 支持 CPU 推理和若干 GPU 后端,但这不代表每台电脑都能获得相同的加速效果。你也不必专门使用 RTX Spark。llama.cpp 功能说明
Mac 用户应通过 llama.app 单独选择 Download for Mac。不要安装 Windows 软件包或照搬 Windows 驱动说明。网站上 Mac 应用的体积数据,也不是 Windows 安装程序的要求。
安装已签名应用,不要削弱 Windows 安全保护
常规的软件包安装方式不需要编译任何内容,也不需要安装 .NET SDK。源码构建的前置条件是给开发者看的,不属于首次聊天的安装流程。官方安装文档
- 打开 llama.app,选择 Download for Windows 11,或进入代码仓库的 Releases 页面。确认发布者是
ggml-org/Llama-Windows,而不是名称相似的下载站。 - 选择当前的
.msixbundle,不要下载 GitHub 源代码压缩包。本文核对的版本对应文件名为LlamaApp-v0.12.0.msixbundle。安装时保留它的发布页面以供对照。 - 使用 Windows App Installer 打开软件包。选择 安装前,检查发布者和签名信息。v0.12.0 清单中的签名身份是 Hugging Face,而发布者显示名称为 Morgan Funtowicz。只看到熟悉的显示名称并不等于验证了签名;Windows 必须信任该软件包的签名。软件包身份信息
- 如果 Windows 提示发布者未知、签名无效或组织策略不允许安装,请停止操作。重新核对官方文件,通过 Microsoft 渠道更新 Windows/App Installer,或联系管理员。不要停用 Defender 或 SmartScreen、绕过执行策略,或导入陌生证书来强行安装。Microsoft App Installer 故障排查
- 启动 Llama,在时钟旁边的通知区域找到它的图标;必要时检查隐藏图标箭头。如果缺少运行时,应用可以安装其管理的 llama.cpp 运行时,因此首次启动时可能需要联网。Windows 下载步骤、运行时设置
不要更改网络共享设置。在 v0.12.0 中,设置 > Llama > Listen On 用于控制服务器地址;默认值是 localhost。首次聊天不需要创建入站网络例外,也不需要配置其他电脑可访问的地址。版本安全说明
模型文件能存进磁盘,不代表内存也放得下
GGUF 是一种模型文件格式,包含供 llama.cpp 等推理引擎使用的权重和元数据。它不是聊天机器人品牌,也不是质量评级。对话入门应选择经过指令微调或聊天微调的模型;基础模型的用途不同。请阅读模型卡,而不要只按下载量挑选。Hugging Face GGUF 文档、模型卡指南
参数量描述模型学习到的数值:3B 大约表示 30 亿个参数,不等于下载文件有 3GB。量化以更紧凑的形式存储这些数值。Q4_K_M 和 Q8_0 等名称代表不同的量化方案,而不是应用版本。较低精度可以降低存储和内存需求,但质量与速度的取舍取决于模型和硬件;它并不自动意味着最快或最好。llama.cpp 量化指南
请把以下四项分开考虑:
| 项目 | 需要预留什么 | 初学者该怎么做 |
|---|---|---|
| 磁盘空间 | 下载的模型文件、运行时和临时下载空间 | 下载前检查目标磁盘 |
| 系统 RAM | Windows、其他应用、模型数据和运行时工作空间 | 为日常电脑使用留出余量 |
| GPU VRAM | 分配给独立显卡的工作 | 不要把它和系统 RAM 混为一谈 |
| 上下文 | 为指令、对话和生成内容保留的 token | 先从较短上下文开始,不要直接选最大值 |
上下文就是对话的工作台面。台面越大,能放下的材料越多,但也会占用更多内存。Token 是文本片段,并不对应固定数量的词;不同语言和代码的分词方式也不同。模型权重只是内存分配的一部分,键值缓存和运行时缓冲区同样重要。llama.cpp 服务器参数
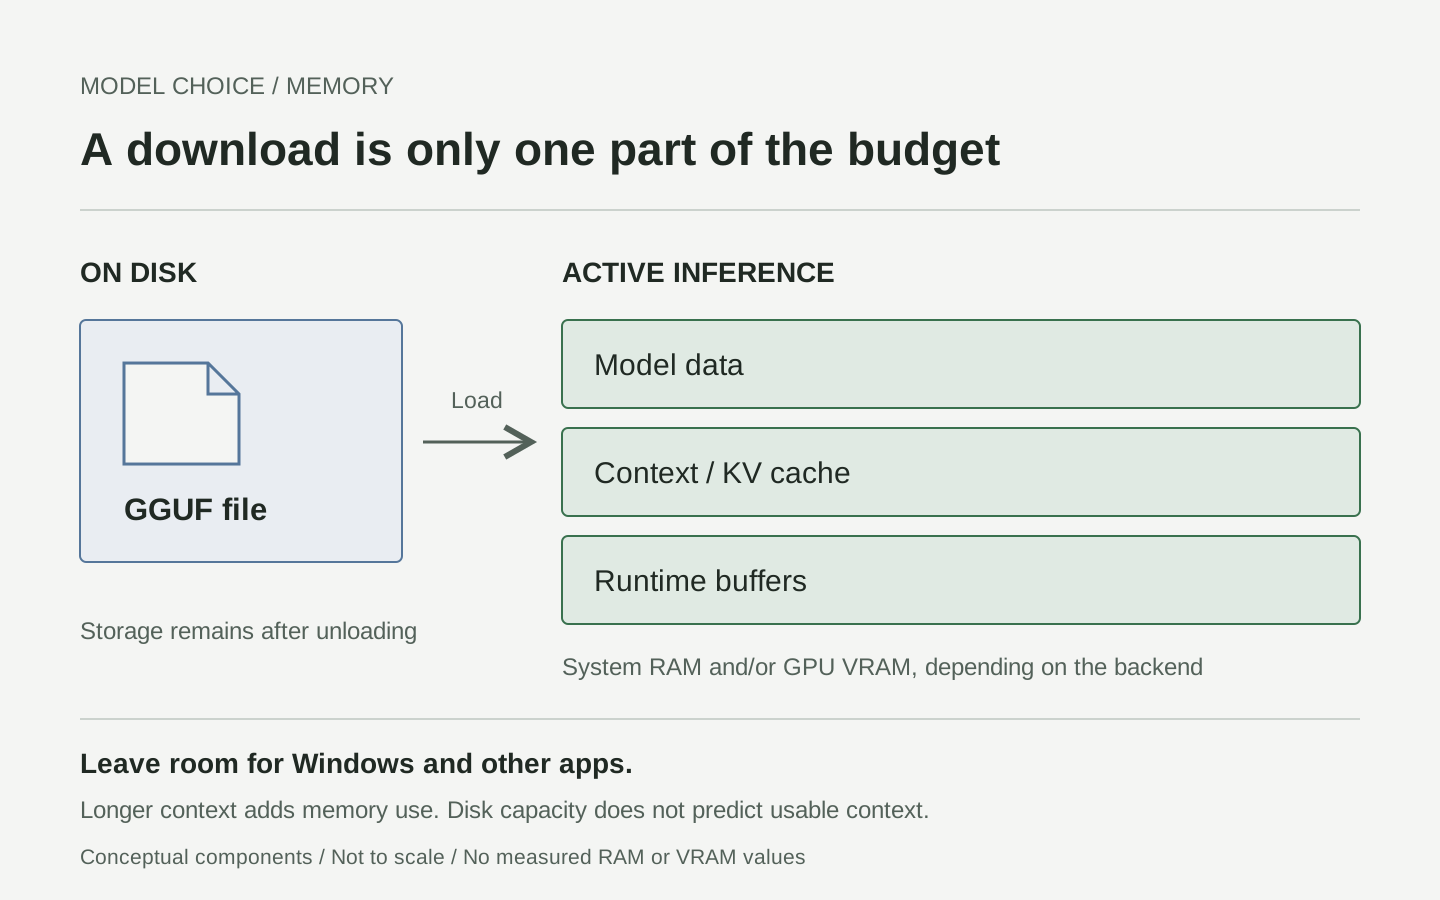
原创概念图,并非实测内存分配。本文模型详情来源估算模型与上下文的内存;整台电脑的占用还包括其他部分。
打开模型详情,查看上下文长度对应的内存估算。选择一个体积较小、建议用于聊天的模型,以及能留出余量的较短上下文。假设一个 4GB 的模型文件放进了 16GB 内存的电脑,并不能证明长对话一定能运行。之后若比较不同量化版本,请固定模型、提示词和上下文,这样才能判断变化来自哪里。商业用途前还要检查模型本身的许可证;应用的 MIT 许可证并不涵盖所有可下载模型。
让第一次对话刻意保持简单,方便核验
发布文章使用了 Recommended Models 和 Available 两个面板名称;而本文核对的 v0.12.0 源码使用 Models、Browse more 分隔项,以及 Download model、Load model、Open WebUI 和 Stop model 等图标提示。请按自己安装版本中的实际控件操作,不必一直寻找旧面板名称。指定版本的 Windows 界面源码
- 打开托盘弹出面板,查看推荐模型的大小和详情。首次运行请选择不需要申请访问权限的公开模型。
- 使用下载控件,等待下载完成。下载完成只表示文件已保存,不表示推理已经启动。
- 在模型详情中选择较短的上下文,然后点击 Load model。模型加载后,选择 Open WebUI 打开本地聊天。官方快速入门也说明了应在开始聊天前选择上下文。快速入门
- 粘贴下面的合成提示词并发送。请对照给定事实检查回答,不要只看是否生成了文字。
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
有用的回答应保留两个日期,并说明 Sam 的截止日期未指定。编造截止日期就是准确性问题,即使安装完全正常也一样。保存提示词和模型 ID 以供对比,结束后选择 Stop model。应用还说明了 Alt+Space 聊天浮层,但它是可选功能,不是使用前提。Windows README
三个小任务可以看出本地模型适合做什么
以下是使用虚构输入进行的说明性练习,并非记录下来的模型输出。每个练习都包括任务、后续追问和明确的验收标准。
把零散笔记整理成交接材料,但不要捏造决定
假设一个志愿者团队正在筹备周末活动。粘贴以下请求:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
关键是区分承诺和提议。接着追问:“哪些行动是明确指派的,哪些只是提议?”只有在结果中 June 的任务被明确指派、Omar 的提议仍是暂定、开始时间没有被擅自补上时,才算通过。请将原始笔记和交接材料一起保留,让其他人能够检查依据。
根据原文学习,并确保问题不超出来源
选用一段公版文章或自己撰写的合成说明。下面是一项独立练习:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
逐条核对引用,不要只看答案听起来是否合理。一个合适的无从作答问题可以询问温度阈值,但模型不能编造阈值。第二轮可以要求简化措辞,同时保留所有事实。这样,改写就能做到逐句核查,而不是让模型借题发挥,写出一篇泛泛的温室科普。
起草客服回复,但别随意承诺
在使用真实客户内容前,先用虚构工单练习:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
如果草稿声称退款已经处理,或保证当天就能完成,就应退回。让模型标出自己作出的每项承诺,再由你逐一核实。只有能够访问实际客服系统的人,才能确认账户操作。本地运行改变的是起草发生的位置,并不会赋予模型退款权限。
同一个模型也可以通过本地 API 调用
你完全可以只使用聊天界面。如果要从编辑器、脚本或原型调用模型,文档说明受管服务器位于 http://localhost:9931,兼容 OpenAI 格式的请求路径在 /v1 下。这是本地兼容接口,不是向 OpenAI 云端发送请求。若在设置中更改过端口,请以实际配置为准。Llama API 文档
保持应用运行并加载好模型,然后打开 PowerShell。先列出路由器可用的模型;/models 包含加载状态,而 /v1/models 是兼容 OpenAI 格式的元数据端点。复制你主动加载的模型准确 ID。不要随便选列表第一项,否则可能触发加载其他模型。
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
运行第二段之前,把下面的占位符替换成刚才找到的准确 ID。此请求只发送合成文本,不需要额外的 SDK:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
请求格式和返回字段遵循 llama.cpp 官方服务器参考文档。让 Listen On 保持在 localhost;不要把云端 API 密钥粘贴进此示例。收到 401 时应检查本地身份验证,而不是移除保护。在 v0.12.0 中,选择非回环地址会触发应用生成密钥,并要求确认。Windows 安全行为
本地推理不等于所有网络活动都会消失
Windows README 声明,提示词和推理都留在本地,应用也不发送遥测数据。该文档同时说明,模型下载和检查版本更新会发出网络请求,User-Agent 中含有应用版本、Windows 内部版本和系统架构。这些活动各不相同,“离线”不应被理解成它们互相矛盾。隐私声明
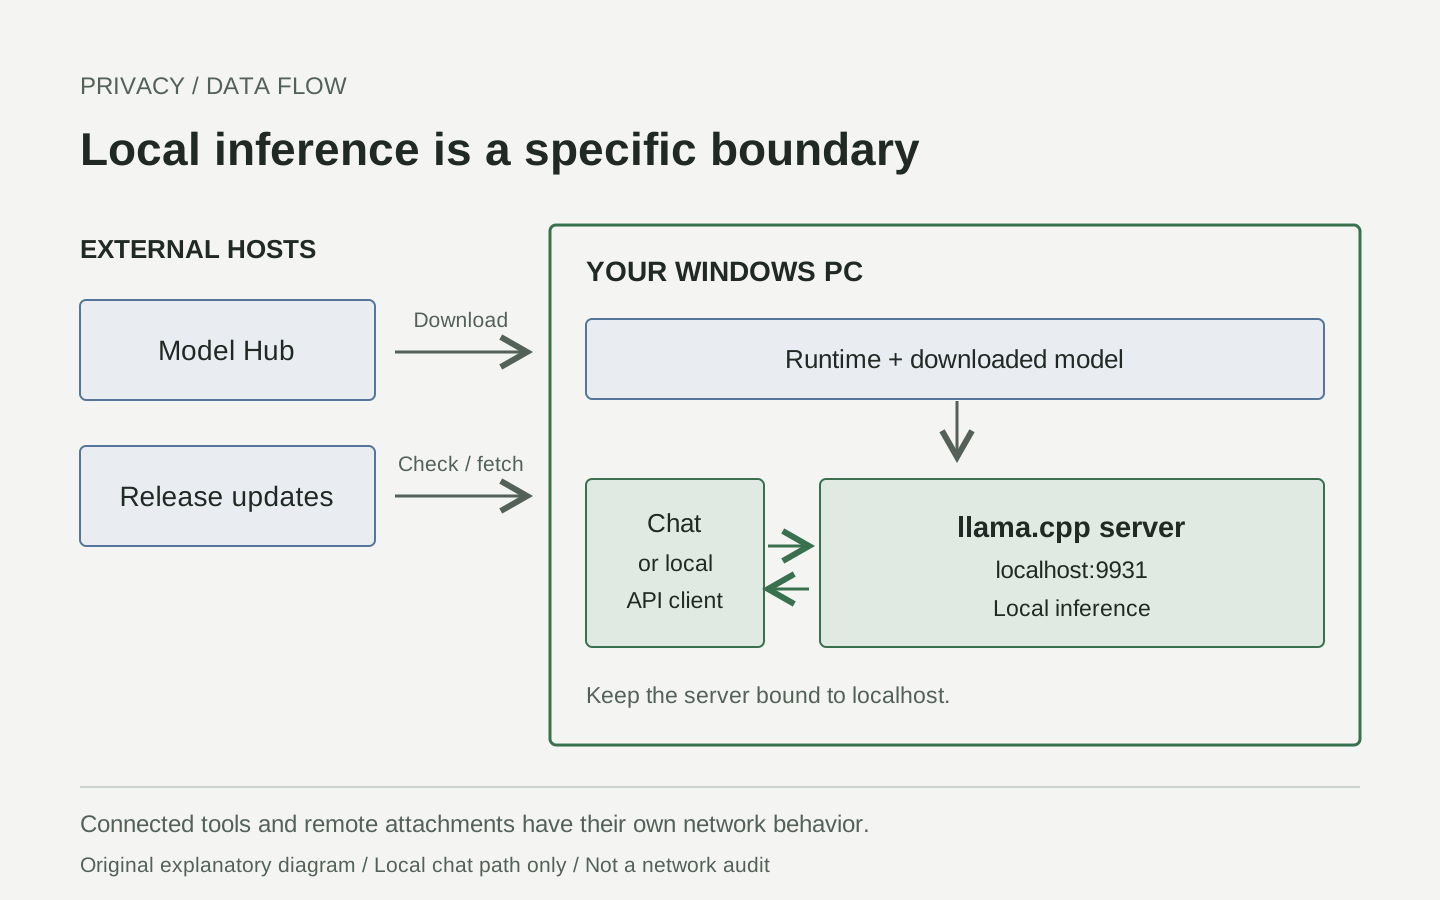
原创数据流示意图。下载主机位于外部,图示聊天路径则在本地。来源:Windows 隐私文档和 API 参考。
已下载且受支持的模型可以在没有互联网连接时执行推理,但下载新模型仍需要联网。连接到应用的编辑器、浏览器扩展、远程附件 URL 或启用的外部工具,都有各自的网络行为。不要假定它们自动沿用服务器的仅本地边界。
处理机密内容前,请检查对话存储、浏览器扩展、备份/同步位置和组织规定。设置完成后进行一次离线合成对话,是有用的功能检查,但不能证明所有组件都经过审计。不要把令牌或私人提示词放进公开诊断日志。
针对发生故障的阶段排查,而不是重装一切
| 现象 | 先检查 | 下一步该怎么做 |
|---|---|---|
| 软件包无法安装 | 至少 26100 的内部版本、架构、签名、设备策略 | 保留完整的 App Installer 错误;使用官方更新渠道或联系管理员 |
| 找不到应用窗口 | 通知区域和隐藏图标 | 打开托盘图标;应用不会固定显示为任务栏窗口 |
| 模型下载失败 | 目标磁盘空间、网络连接、访问门槛和显示的错误 | 先排除原因再试;从公开模型开始 |
| 下载完成但加载失败 | 上下文估算、可用内存、运行时错误 | 停止其他已加载模型,并缩短上下文或换小一些的模型 |
| 回复很慢 | 模型大小、上下文长度、实际使用的 CPU/GPU 后端 | 对比一个简短提示词;目录推荐不保证速度 |
| API 无法连接 | 应用是否运行、配置端口、本地地址 | 先查看服务器状态,不要马上启动第二个服务器 |
| 回答流畅却包含错误细节 | 来源文本和模型是否适合任务 | 缩小任务范围,并要求引用支持内容 |
当前 README 将设置和日志放在 %LOCALAPPDATA%\Llama;发布文章列出的日志路径则不同。请通过应用内的日志文件夹控件查找,不要猜路径。文档中的 /health 端点有助于区分服务器已就绪还是仍在加载,但路由器运行正常并不能证明你选的模型已经加载。当前存储文档、服务器健康状态说明
通过这些检查,才算首次安装成功
- 官方签名软件包可以安装,过程中没有停用安全控制。
- 有意选择的一个模型完成下载并成功加载。
- 聊天界面通过本地地址打开,并能回答合成任务。
- 日期、姓名和缺失信息都与提供的文本一致。
- 你能够停止模型,再次加载它。
- 如果使用 API,目标模型能正常回答,服务器仍仅监听本机。
归根结底:本地 AI 是一套可以检查的工作流
我们的看法是,真正的进步不只是少敲一条终端命令,而是让模型选择、内存使用、来源材料和最终回答都清晰到可以重复。先从一项答案能核实的小任务开始。只有当你知道成功的标准是什么,再逐步扩大使用范围。
来源与媒体
核对日期:2026 年 10 月 20 日。本指南介绍有文档支持的工作流;不声称进行过安装试用、模型运行、付费请求或基准测试。三张 SVG 均为原创说明图,并非界面复刻。实际界面可查看发布者的官方托盘截图和浮层演示。这些素材仅提供链接,未重新发布。
- Hugging Face 公告,10 月 13 日
- Windows 版本、软件包与安全更改
- 官方安装指南与快速入门
- GGUF 格式与元数据
- 本地 API 与端点文档
- llama.cpp 运行时与服务器参考
让你的实验便于复用
把来源链接、提示词、模型 ID 和审核备注放在一起,而不只是保存最终答案。Telli.sh 可以帮助整理研究笔记;它不是 Llama Windows 集成,也不代表你的笔记一定保持离线。创建 Telli.sh 账户