Llama Windows: seu primeiro chat local com IA, sem configurar o terminal
Instale o Llama Windows com segurança, escolha um modelo GGUF adequado ao seu PC, experimente três prompts práticos e conecte-se à API local sem expor o servidor.
Sua primeira tarefa com IA local deve ser pequena: transformar seis notas fictícias de reunião em três itens de ação. Você não deveria precisar compilar um mecanismo de inferência, adivinhar uma dúzia de parâmetros de inicialização nem enviar um documento privado só para descobrir se seu computador consegue responder.
O Llama Windows, anunciado pela Hugging Face em 13 de outubro de 2026, coloca o runtime llama.cpp por trás de um app na bandeja do sistema do Windows. Ele encontra e baixa modelos e, em seguida, oferece uma interface de chat local e uma API para outros apps. O nome descreve o app; não o limita aos modelos Llama da Meta. Anúncio de lançamento
Este guia mostra como fazer uma instalação segura, escolher um primeiro modelo adequado e iniciar uma conversa que você consiga verificar. Depois, vamos percorrer três tarefas úteis e uma solicitação opcional à API local. Comece com texto público ou inventado; use material sensível somente depois de entender o fluxo completo.
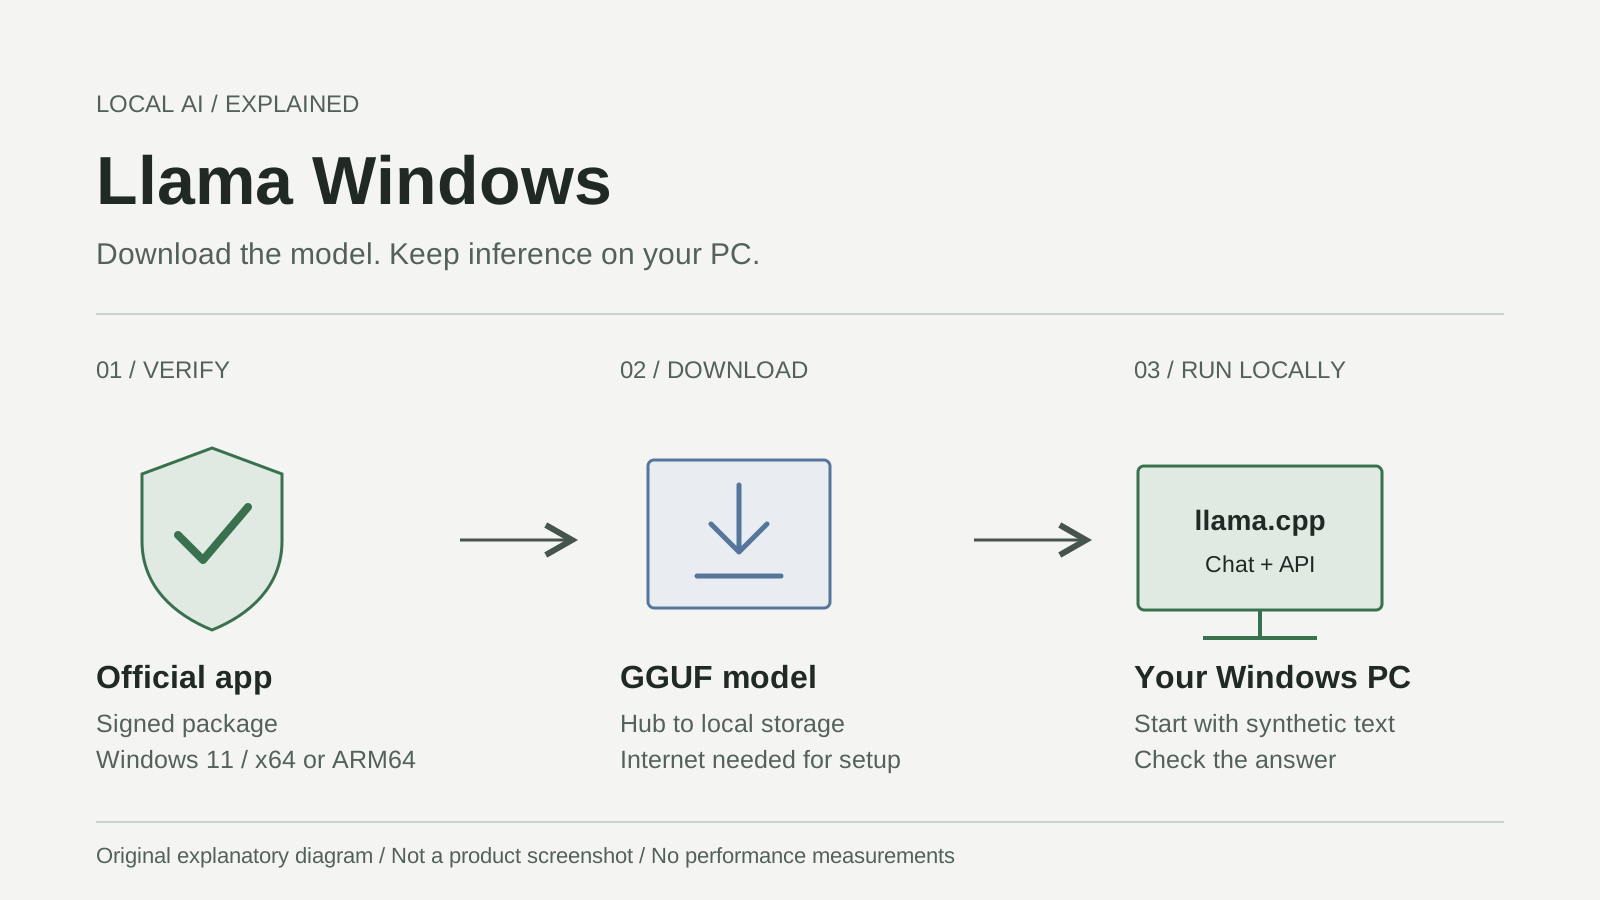
Ilustração explicativa original, não uma captura de tela do produto. O download durante a configuração e a inferência local são etapas diferentes. Baseada no guia oficial de instalação para Windows.
Confira a versão do Windows antes de escolher um modelo
Na verificação de 20 de outubro, a versão mais recente publicada para Windows era a v0.12.0. O manifesto do pacote exige Windows.Desktop 10.0.26100.0 ou posterior. O build 26100 corresponde ao Windows 11 versão 24H2; use uma versão do Windows que ainda receba suporte, não apenas a mais antiga que permita instalar. Versão, manifesto da versão, informações de versões da Microsoft
Pesquise winver no Windows para verificar o build. Em Configurações, abra Sistema > Sobre para conferir o tipo de sistema e a RAM instalada. O .msixbundle oficial contém builds x64 e ARM64: x64 costuma ser a opção para PCs Windows com Intel/AMD; ARM64 é para Windows em Arm. O próprio bundle seleciona a arquitetura. Os arquivos atuais da versão não incluem um pacote x86 de 32 bits. Repositório do Windows, empacotamento do bundle
A documentação de instalação do Windows não especifica um mínimo universal de RAM, VRAM ou GPU dedicada. As necessidades dependem do modelo e do contexto. O llama.cpp oferece suporte à inferência em CPU e a vários backends de GPU, mas isso não garante a mesma aceleração em todos os PCs. Você não precisa especificamente de um RTX Spark. Recursos do llama.cpp
No Mac, use a opção separada Download for Mac em llama.app. Não instale o bundle para Windows nem reutilize instruções de drivers do Windows. Os valores de tamanho do app para Mac no site também não são requisitos do instalador para Windows.
Instale o app assinado sem enfraquecer a segurança do Windows
A instalação normal pelo pacote não exige compilar nada nem instalar o .NET SDK. Os pré-requisitos para compilar a partir do código-fonte são para desenvolvedores, não para este procedimento de primeiro chat. Documentação oficial de instalação
- Abra llama.app e escolha Download for Windows 11, ou siga o link Releases do repositório. Confirme que a versão pertence a
ggml-org/Llama-Windows, não a um site de download com nome semelhante. - Escolha o
.msixbundleatual, não o arquivo de código-fonte do GitHub. Na versão verificada, o arquivo éLlamaApp-v0.12.0.msixbundle. Deixe a página da versão aberta durante a instalação. - Abra o bundle com o Windows App Installer. Confira as informações do editor e da assinatura antes de selecionar Install. No manifesto da v0.12.0, a identidade de assinatura é Hugging Face, enquanto o nome de exibição do editor é Morgan Funtowicz. Um nome conhecido exibido na tela, por si só, não verifica a assinatura; o Windows precisa confiar na assinatura do pacote. Identidade do pacote
- Se o Windows informar que o editor é desconhecido, a assinatura é inválida ou há uma restrição da organização, pare. Confira novamente o arquivo oficial, atualize o Windows/App Installer por canais da Microsoft ou peça ajuda ao administrador. Não desative o Defender ou o SmartScreen, não contorne a política de execução nem importe um certificado desconhecido para forçar a instalação. Solução de problemas do App Installer da Microsoft
- Inicie o Llama e localize o ícone na área de notificação ao lado do relógio; se necessário, confira a seta de ícones ocultos. Se estiver faltando, o app pode instalar seu runtime llama.cpp gerenciado, por isso a primeira inicialização talvez precise de acesso à internet. Passo a passo de download para Windows, configuração do runtime
Não altere as configurações de compartilhamento de rede. Na v0.12.0, Settings > Llama > Listen On controla o endereço do servidor; o padrão é localhost. Seu primeiro chat não precisa de uma exceção para conexões de entrada nem de um endereço acessível por outro computador. Notas de segurança da versão
Um modelo que cabe no disco talvez não caiba na memória
GGUF é um formato de arquivo de modelo que contém pesos e metadados para mecanismos de inferência como o llama.cpp. Não é uma marca de chatbot nem uma classificação de qualidade. Para conversar, comece com um modelo ajustado para instruções ou chat; um modelo base tem outra finalidade. Leia o cartão do modelo, em vez de escolher apenas pelo número de downloads. Documentação GGUF da Hugging Face, orientações sobre cartões de modelo
A contagem de parâmetros descreve os valores numéricos aprendidos pelo modelo: 3B significa aproximadamente três bilhões de parâmetros, não um download de 3 GB. A quantização armazena esses valores de forma mais compacta. Nomes como Q4_K_M e Q8_0 identificam diferentes métodos de quantização, não versões do app. Uma precisão menor pode reduzir as necessidades de armazenamento e memória, com compromissos de qualidade e velocidade que dependem do modelo e do hardware. Não é automaticamente a opção mais rápida ou melhor. Guia de quantização do llama.cpp
Mantenha quatro quantidades distintas:
| Quantidade | O que você está estimando | Decisão para iniciantes |
|---|---|---|
| Espaço em disco | Arquivos de modelo baixados, runtime e espaço temporário para downloads | Confira a unidade de destino antes de baixar |
| RAM do sistema | Windows, outros apps, dados do modelo e trabalho do runtime | Reserve espaço para o uso normal do PC |
| VRAM da GPU | Trabalho atribuído a uma GPU dedicada | Não a confunda com a RAM do sistema |
| Contexto | Tokens mantidos para instruções, conversa e texto gerado | Comece com um valor curto, em vez do máximo |
O contexto é a mesa de trabalho da conversa. Uma mesa maior comporta mais material, mas também ocupa mais memória. Tokens são partes de texto, não uma quantidade fixa de palavras; idiomas e códigos diferentes são tokenizados de formas diferentes. Os pesos do modelo são apenas parte da alocação: o cache de chave/valor e os buffers do runtime também importam. Parâmetros do servidor llama.cpp
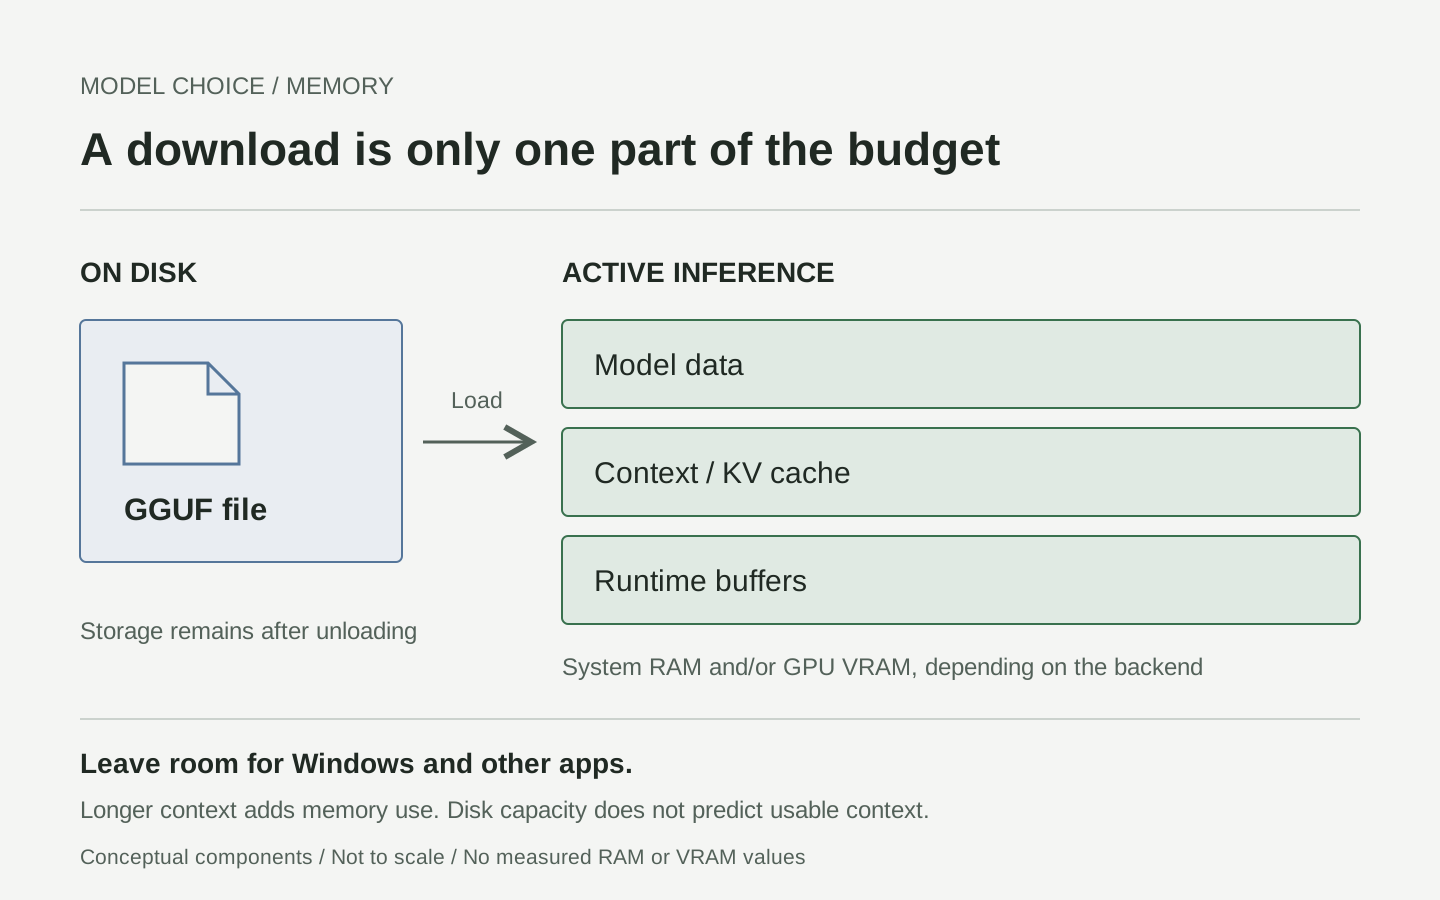
Diagrama conceitual original, não uma medição de alocação. A fonte de detalhes do modelo estima a memória do modelo e do contexto; o uso total do PC inclui outros componentes.
Abra os detalhes do modelo e examine as estimativas de memória para cada tamanho de contexto. Escolha um modelo de chat recomendado e pequeno, com uma opção de contexto curta que deixe folga. Um arquivo hipotético de 4 GB em um PC com 16 GB não prova que uma conversa longa vai caber. Se depois comparar quantizações, mantenha constantes o modelo, o prompt e o contexto para identificar o que mudou. Confira a licença do próprio modelo antes do uso comercial; a licença MIT do app não licencia todos os modelos disponíveis para download.
Deixe a primeira conversa especialmente fácil de verificar
O artigo de lançamento chama os painéis de Recommended Models e Available. Já o código-fonte verificado da v0.12.0 usa Models, um separador Browse more e dicas nos ícones, incluindo Download model, Load model, Open WebUI e Stop model. Use os controles que aparecem na sua versão, em vez de procurar indefinidamente o nome antigo de um painel. Código-fonte da interface do Windows, versão identificada
- Abra o painel da bandeja e confira o tamanho e os detalhes de um modelo recomendado. Para este primeiro uso, escolha um modelo público sem requisito de acesso restrito.
- Use o controle de download e aguarde a conclusão. O download concluído significa que o arquivo chegou, não que a inferência esteja em execução.
- Selecione um contexto curto nos detalhes do modelo e use Load model. Depois de carregado, escolha Open WebUI para acessar o chat local. O início rápido oficial também descreve a escolha do contexto antes de começar o chat. Início rápido
- Cole o prompt sintético abaixo e envie. Compare a resposta com os fatos fornecidos; não avalie o sucesso apenas pela presença de texto na tela.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Uma resposta útil mantém as duas datas e deixa sem especificação o prazo de Sam. Inventar um prazo é uma falha de precisão, mesmo que a instalação funcione perfeitamente. Guarde o prompt e o ID do modelo para comparação e, ao terminar, use Stop model. O app também documenta a sobreposição de chat Alt+Space; ela é opcional, não um pré-requisito. README do Windows
Três pequenas tarefas mostram para que serve um modelo local
Estes são exercícios ilustrativos com dados inventados, não resultados registrados de modelos. Cada um apresenta uma tarefa, uma pergunta de acompanhamento e um critério concreto de aceitação.
Transforme notas soltas em um repasse sem inventar decisões
Imagine que um grupo de voluntários esteja preparando um evento de fim de semana. Cole este pedido:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
A distinção útil é entre um compromisso e uma sugestão. Faça uma pergunta de acompanhamento: "Which actions were explicitly assigned, and which are only proposals?" Aceite o resultado somente se a tarefa de June estiver atribuída, a oferta de Omar continuar sendo uma possibilidade e nenhum horário de início for inventado. Mantenha as notas originais junto ao repasse para que outra pessoa possa examinar as evidências.
Estude um trecho com perguntas limitadas ao conteúdo da fonte
Use um trecho curto em domínio público ou uma explicação sintética que você tenha escrito. Veja um exercício completo:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Confira cada citação, não apenas se a resposta parece plausível. Uma boa pergunta sem resposta talvez trate dos limites de temperatura, mas o modelo não pode inventar um limite. Em uma segunda etapa, peça uma formulação mais simples sem alterar nenhum fato. Assim, você terá uma reescrita que pode conferir frase por frase, em vez de abrir espaço para uma explicação genérica sobre estufas.
Redija uma resposta de atendimento sem assumir compromissos indevidos
Antes de usar texto real de um cliente, pratique com um chamado fictício:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Rejeite uma resposta que diga que o reembolso já foi processado ou garanta um resultado no mesmo dia. Peça ao modelo que destaque cada promessa feita e depois confira essas promessas por conta própria. Somente alguém com acesso ao sistema de suporte real pode confirmar uma ação na conta. A execução local muda onde o texto é redigido; não dá ao modelo autoridade para emitir reembolsos.
A API local pode reutilizar o mesmo modelo
Você pode ficar só no chat. Para usar um editor, script ou protótipo, o servidor gerenciado está documentado em http://localhost:9931, com solicitações compatíveis com OpenAI em /v1. Essa compatibilidade é local, não uma solicitação à nuvem da OpenAI. Confira em Configurações se a porta foi alterada. Documentação da API do Llama
Com o app em execução e o modelo já carregado, abra o PowerShell. Primeiro, liste os modelos disponíveis no roteador; /models inclui o status de carregamento, enquanto /v1/models é o endpoint de metadados compatível com OpenAI. Copie o ID exato do modelo que você carregou intencionalmente. Não escolha uma entrada aleatória no início da lista, pois isso pode carregar outro modelo.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Antes de executar o segundo bloco, substitua o marcador abaixo pelo ID exato. Ele envia somente texto sintético e não exige SDK adicional:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
O formato da solicitação e o campo de saída seguem a referência oficial do servidor llama.cpp. Mantenha Listen On em localhost; nunca cole uma chave de API da nuvem neste exemplo. Um erro 401 indica que você deve conferir a autenticação local, não remover a proteção. Na v0.12.0, selecionar um endereço que não seja de loopback adiciona uma chave gerada pelo app e exige confirmação. Comportamento de segurança no Windows
A inferência local não elimina todas as operações de rede
O README do Windows afirma que os prompts e a inferência permanecem locais e que o app não envia telemetria. Também documenta solicitações de rede para baixar modelos e verificar atualizações de versões, com um User-Agent que contém a versão do app, o build do Windows e a arquitetura. São atividades distintas, não sentidos contraditórios de “offline”. Declaração de privacidade
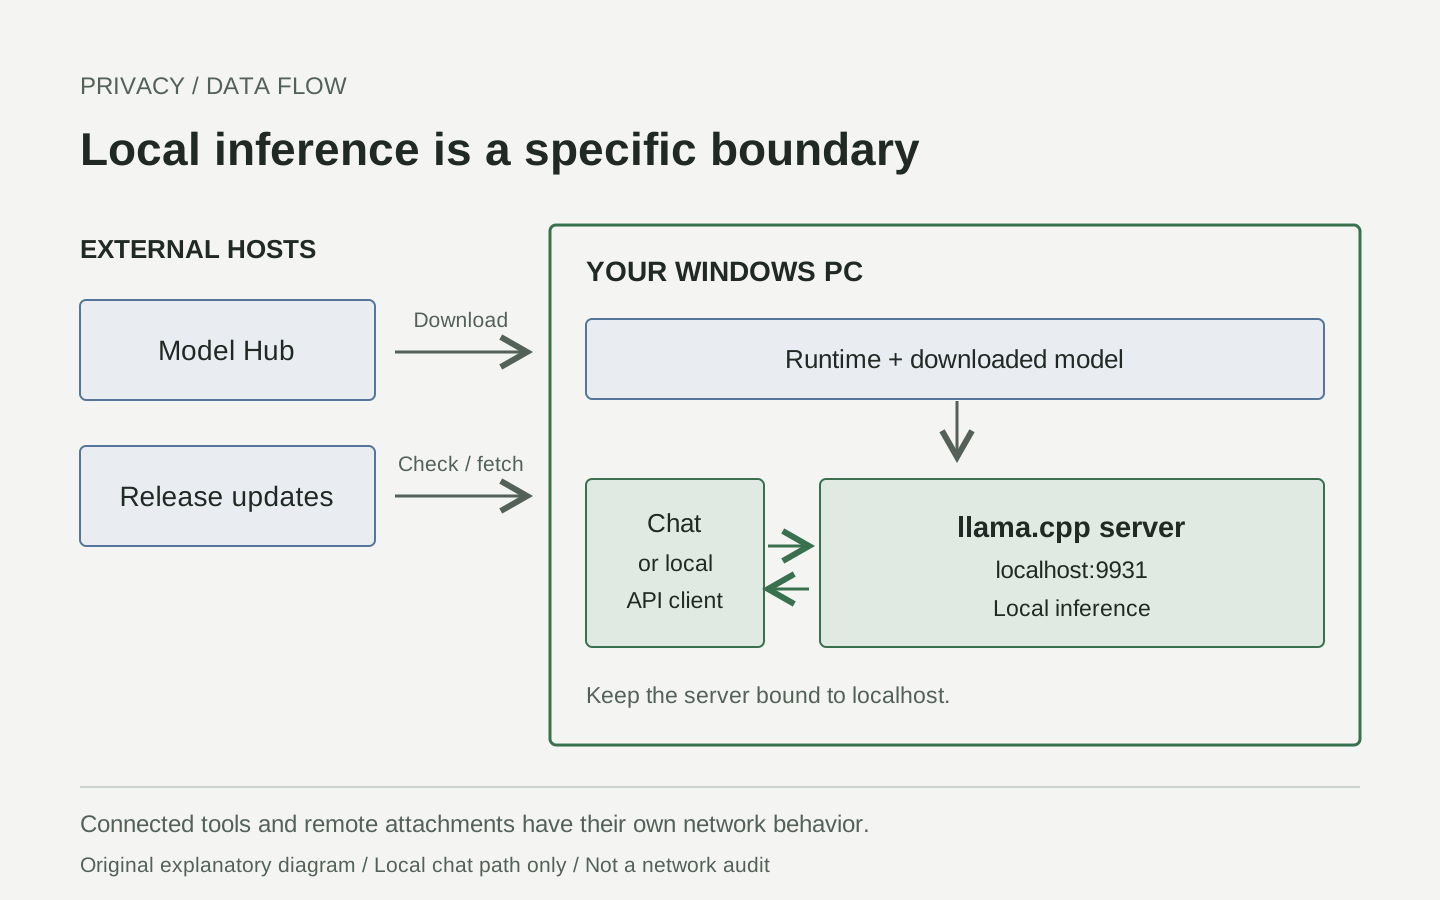
Explicação original do fluxo de dados. Os hosts de download são externos; o caminho de chat ilustrado é local. Fontes: documentação de privacidade do Windows e referência da API.
Um modelo compatível, depois de baixado, pode fazer inferência sem conexão com a internet, mas um modelo novo ainda precisa ser baixado. Um editor conectado, extensão de navegador, URL de anexo remoto ou ferramenta externa ativada tem seu próprio comportamento de rede. Não presuma que esses componentes herdem o limite local do servidor.
Antes de trabalhar com material confidencial, confira onde as conversas são armazenadas, as extensões do navegador, os locais de backup e sincronização e as regras da sua organização. Um chat offline com texto sintético é uma verificação funcional útil depois da configuração, não prova que todos os componentes foram auditados. Nunca inclua tokens nem prompts privados em logs de diagnóstico públicos.
Solucione o problema na etapa que falhou, não na instalação inteira
| Sintoma | O que verificar primeiro | Próxima medida útil |
|---|---|---|
| O bundle não instala | Build mínimo 26100, arquitetura, assinatura, política do dispositivo | Guarde o erro exato do App Installer; use atualizações oficiais ou o suporte do administrador |
| Nenhuma janela do app aparece | Área de notificação e ícones ocultos | Abra o ícone da bandeja; não é esperado que haja uma janela permanente na barra de tarefas |
| O download do modelo falha | Espaço no destino, conectividade, acesso restrito, mensagem de falha | Resolva a causa antes de tentar de novo; comece com um modelo público |
| O download termina, mas o carregamento falha | Estimativa de contexto, memória livre, erro do runtime | Pare outros modelos carregados e reduza o contexto ou o tamanho do modelo |
| As respostas são lentas | Tamanho do modelo, comprimento do contexto, backend de CPU/GPU realmente em uso | Compare um prompt curto; não trate a recomendação do catálogo como garantia de velocidade |
| A API não conecta | App em execução, porta configurada, endereço local | Verifique o status do servidor antes de iniciar um segundo servidor |
| Uma resposta fluente contém detalhes falsos | Texto-fonte e adequação do modelo | Encurte a tarefa e exija citações de apoio |
O README atual localiza as configurações e os logs em %LOCALAPPDATA%\Llama; a publicação de lançamento indicava outro caminho para os logs. Use o controle de pasta de logs do app em vez de adivinhar. O endpoint documentado /health ajuda a distinguir um servidor de modelos pronto de outro ainda em carregamento, embora o roteador estar ativo não prove que o modelo escolhido foi carregado. Documentação atual de armazenamento, comportamento de saúde do servidor
Considere a primeira configuração bem-sucedida somente quando estas verificações passarem
- O pacote oficial assinado é instalado sem desativar controles de segurança.
- O download de um modelo escolhido intencionalmente termina e ele é carregado.
- O chat abre em um endereço local e responde à tarefa sintética.
- Datas, nomes e informações ausentes correspondem ao texto fornecido.
- Você consegue parar o modelo e carregá-lo novamente.
- Se usar a API, o modelo pretendido responde e o servidor continua restrito a localhost.
Em resumo: IA local é um fluxo de trabalho que você pode inspecionar
Na nossa avaliação, a melhoria importante não é evitar um comando de terminal. É tornar a escolha do modelo, o uso de memória, o material de origem e a resposta compreensíveis o bastante para repetir o processo. Comece com uma tarefa pequena cuja resposta você consiga verificar. Amplie somente quando souber como é o sucesso.
Fontes e mídia
Verificado em 20 de outubro de 2026. Este guia descreve fluxos de trabalho documentados; não afirma que houve teste de instalação, execução de modelo, solicitação paga ou benchmark. Os três SVGs são ilustrações explicativas originais, não reproduções da interface. Para ver a interface real, consulte a captura oficial da bandeja e a demonstração da sobreposição do publicador. Esses recursos estão vinculados, não republicados.
- Anúncio da Hugging Face, 13 de outubro
- Versão para Windows, pacote e alterações de segurança
- Instalação oficial e início rápido
- Formato GGUF e metadados
- Documentação da API local e dos endpoints
- Referência do runtime e servidor llama.cpp
Mantenha seus experimentos reutilizáveis
Guarde links das fontes, prompts, IDs dos modelos e notas de revisão juntos, em vez de salvar apenas a resposta final. O Telli.sh pode ajudar a organizar essas notas de pesquisa; não é uma integração com o Llama Windows nem uma afirmação de que suas notas permaneçam offline. Crie uma conta no Telli.sh