Llama Windows: Ihr erster lokaler KI-Chat ohne Terminal-Einrichtung
Installieren Sie Llama Windows sicher, wählen Sie ein GGUF-Modell, das zu Ihrem PC passt, probieren Sie drei praktische Eingaben aus und verbinden Sie die lokale API, ohne Ihren Server offenzulegen.
Ihre erste lokale KI-Aufgabe sollte klein sein: Aus sechs fiktiven Besprechungsnotizen drei Aufgaben machen. Sie sollten weder eine Inferenz-Engine kompilieren noch ein Dutzend Startoptionen erraten oder ein privates Dokument hochladen müssen, nur um herauszufinden, ob Ihr Computer eine Antwort geben kann.
Llama Windows, das Hugging Face am 13. Oktober 2026 angekündigt hat, stellt die llama.cpp-Laufzeit hinter einer Windows-App im Infobereich bereit. Die App kümmert sich um das Auffinden und Herunterladen von Modellen und bietet anschließend eine lokale Chatoberfläche sowie eine API für andere Anwendungen. Der Name bezeichnet die App und beschränkt sie nicht auf Metas Llama-Modelle. Ankündigung zur Einführung
Dieser Leitfaden führt Sie durch eine sichere Installation, ein passendes erstes Modell und ein erstes Gespräch, das Sie überprüfen können. Anschließend sehen wir uns drei nützliche Aufgaben und optional eine lokale API-Anfrage an. Beginnen Sie mit öffentlichen oder erfundenen Texten und verwenden Sie sensible Inhalte erst, wenn Sie den gesamten Ablauf kennen.
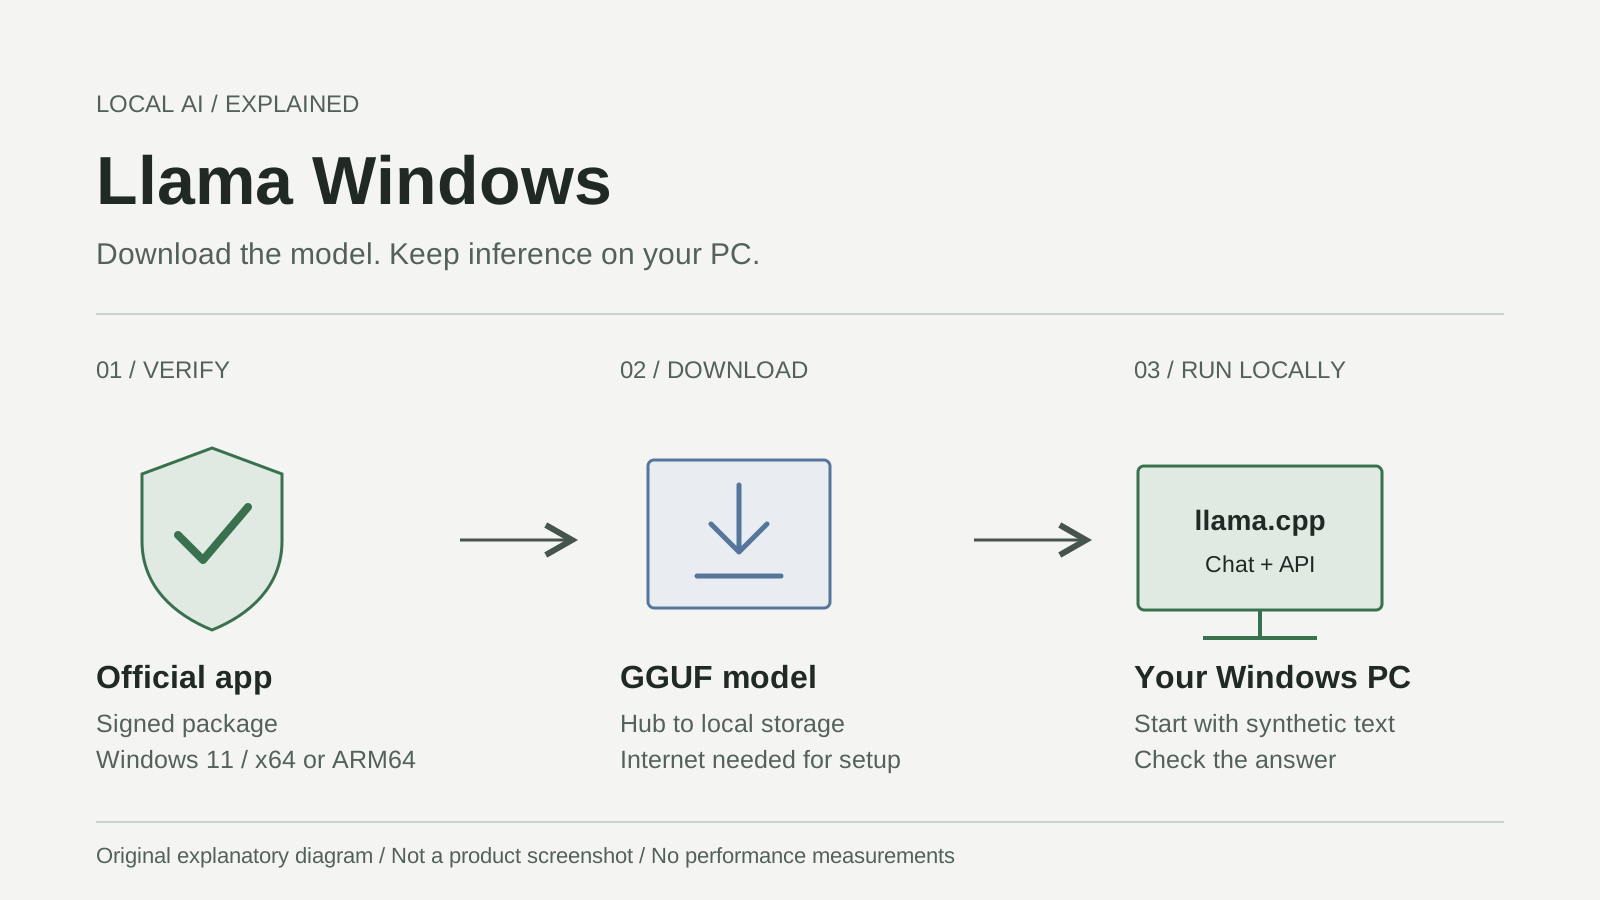
Originalgrafik zur Erklärung, kein Produktscreenshot. Downloads zur Einrichtung und lokale Inferenz sind zwei verschiedene Schritte. Grundlage ist die offizielle Windows-Installationsanleitung.
Prüfen Sie den Windows-Build, bevor Sie ein Modell wählen
Stand 20. Oktober ist v0.12.0 die neueste veröffentlichte Windows-Version. Das Paketmanifest verlangt Windows.Desktop 10.0.26100.0 oder höher. Build 26100 entspricht Windows 11, Version 24H2. Verwenden Sie eine aktuell unterstützte Windows-Version und nicht lediglich die älteste Version, die die Installation zulässt. Version, Manifest der Version, Microsoft-Informationen zu Versionen
Führen Sie winver über die Windows-Suche aus, um Ihren Build zu prüfen. Öffnen Sie in den Windows-Einstellungen System > Info, um Systemtyp und installierten Arbeitsspeicher zu prüfen. Das offizielle .msixbundle enthält x64- und ARM64-Builds: x64 ist der übliche Weg für Intel-/AMD-Windows-PCs; ARM64 ist für Windows auf Arm gedacht. Das Bundle wählt die passende Architektur. Ein 32-Bit-x86-Installationspaket gehört nicht zu den aktuellen Versionsdateien. Windows-Repository, Paketierung des Bundles
Die Windows-Installationsdokumentation nennt keinen universellen Mindestwert für RAM, VRAM oder eine dedizierte GPU. Der Bedarf hängt von Modell und Kontext ab. llama.cpp unterstützt Inferenz auf der CPU und mehrere GPU-Backends; das garantiert jedoch keine identische Beschleunigung auf jedem PC. Eine RTX Spark ist nicht erforderlich. Funktionen von llama.cpp
Verwenden Sie auf einem Mac den separaten Weg Download for Mac auf llama.app. Installieren Sie weder das Windows-Bundle noch Windows-Treiberanleitungen. Auch die Größenangaben zur Mac-App auf der Website sind keine Installationsanforderungen für Windows.
Installieren Sie die signierte App, ohne die Windows-Sicherheit abzuschwächen
Für die normale Paketinstallation müssen Sie nichts kompilieren und auch nicht das .NET SDK installieren. Voraussetzungen für einen Build aus dem Quellcode betreffen Entwickler und nicht diesen Ablauf für den ersten Chat. Offizielle Installationsdokumentation
- Öffnen Sie llama.app und wählen Sie Download for Windows 11, oder folgen Sie dem Link Releases im Repository. Vergewissern Sie sich, dass die Version von
ggml-org/Llama-Windowsstammt und nicht von einer ähnlich benannten Downloadseite. - Wählen Sie das aktuelle
.msixbundleund nicht das GitHub-Quellcodearchiv. Bei der geprüften Version heißt die DateiLlamaApp-v0.12.0.msixbundle. Lassen Sie die Versionsseite während der Installation geöffnet. - Öffnen Sie das Bundle mit Windows App Installer. Prüfen Sie Herausgeber- und Signaturinformationen, bevor Sie Installieren wählen. Die Signaturidentität im Manifest von v0.12.0 lautet Hugging Face, der angezeigte Herausgebername ist Morgan Funtowicz. Ein vertrauter Anzeigename allein verifiziert keine Signatur; Windows muss der Paketsignatur vertrauen. Paketidentität
- Meldet Windows einen unbekannten Herausgeber, eine ungültige Signatur oder eine organisatorische Einschränkung, brechen Sie ab. Prüfen Sie erneut die offizielle Datei, aktualisieren Sie Windows oder App Installer über Microsoft-Kanäle oder fragen Sie Ihre Administration. Deaktivieren Sie weder Defender noch SmartScreen, umgehen Sie keine Ausführungsrichtlinie und importieren Sie kein unbekanntes Zertifikat, um die Installation zu erzwingen. Problembehandlung für Microsoft App Installer
- Starten Sie Llama und suchen Sie das Symbol im Infobereich neben der Uhr. Prüfen Sie bei Bedarf den Pfeil für ausgeblendete Symbole. Fehlt die verwaltete llama.cpp-Laufzeit, kann die App sie installieren; beim ersten Start ist deshalb möglicherweise eine Internetverbindung erforderlich. Anleitung zum Windows-Download, Einrichtung der Laufzeit
Lassen Sie die Einstellungen zur Netzwerkfreigabe unverändert. In v0.12.0 steuert Settings > Llama > Listen On die Serveradresse; standardmäßig ist es localhost. Für Ihren ersten Chat benötigen Sie weder eine eingehende Netzwerkausnahme noch eine Adresse, die von einem anderen Computer erreichbar ist. Sicherheitshinweise zur Version
Ein Modell, das auf die Festplatte passt, passt nicht zwangsläufig in den Arbeitsspeicher
GGUF ist ein Modelldateiformat mit Gewichten und Metadaten für Inferenz-Engines wie llama.cpp. Es ist weder eine Chatbot-Marke noch eine Qualitätsbewertung. Für Gespräche eignet sich ein anweisungsoptimiertes Chatmodell; ein Basismodell erfüllt einen anderen Zweck. Lesen Sie die Modellkarte, statt allein nach der Zahl der Downloads zu wählen. GGUF-Dokumentation von Hugging Face, Hinweise zu Modellkarten
Die Parameterzahl bezeichnet die erlernten numerischen Werte eines Modells: 3B bedeutet ungefähr drei Milliarden Parameter, nicht einen Download von 3 GB. Quantisierung speichert diese Werte kompakter. Bezeichnungen wie Q4_K_M und Q8_0 benennen verschiedene Quantisierungsverfahren, keine App-Versionen. Geringere Genauigkeit kann Speicher- und RAM-Bedarf senken; die Abwägung bei Qualität und Geschwindigkeit hängt vom Modell und der Hardware ab. Das ist nicht automatisch die schnellste oder beste Wahl. Quantisierungsleitfaden von llama.cpp
Halten Sie vier Größen auseinander:
| Größe | Wofür Sie Ressourcen einplanen | Entscheidung für Einsteiger |
|---|---|---|
| Festplattenspeicher | Heruntergeladene Modelldateien, Laufzeit und temporärer Downloadspeicher | Prüfen Sie vor dem Download das Ziellaufwerk |
| System-RAM | Windows, andere Anwendungen, Modelldaten und Arbeit der Laufzeit | Lassen Sie genug Platz für den normalen PC-Betrieb |
| GPU-VRAM | Arbeit, die einer dedizierten GPU zugewiesen ist | Setzen Sie ihn nicht mit dem System-RAM gleich |
| Kontext | Tokens für Anweisungen, Gespräch und generierte Ausgabe | Beginnen Sie kurz, statt gleich das Maximum auszuwählen |
Der Kontext ist der Arbeitstisch eines Gesprächs. Auf einem größeren Tisch liegt mehr Material, aber er beansprucht auch mehr Speicher. Tokens sind Texteinheiten und entsprechen keiner festen Wortzahl; verschiedene Sprachen und Code werden unterschiedlich tokenisiert. Die Modellgewichte sind nur ein Teil des Speicherbedarfs: Auch der Key-Value-Cache und Laufzeitpuffer zählen. Parameter des llama.cpp-Servers
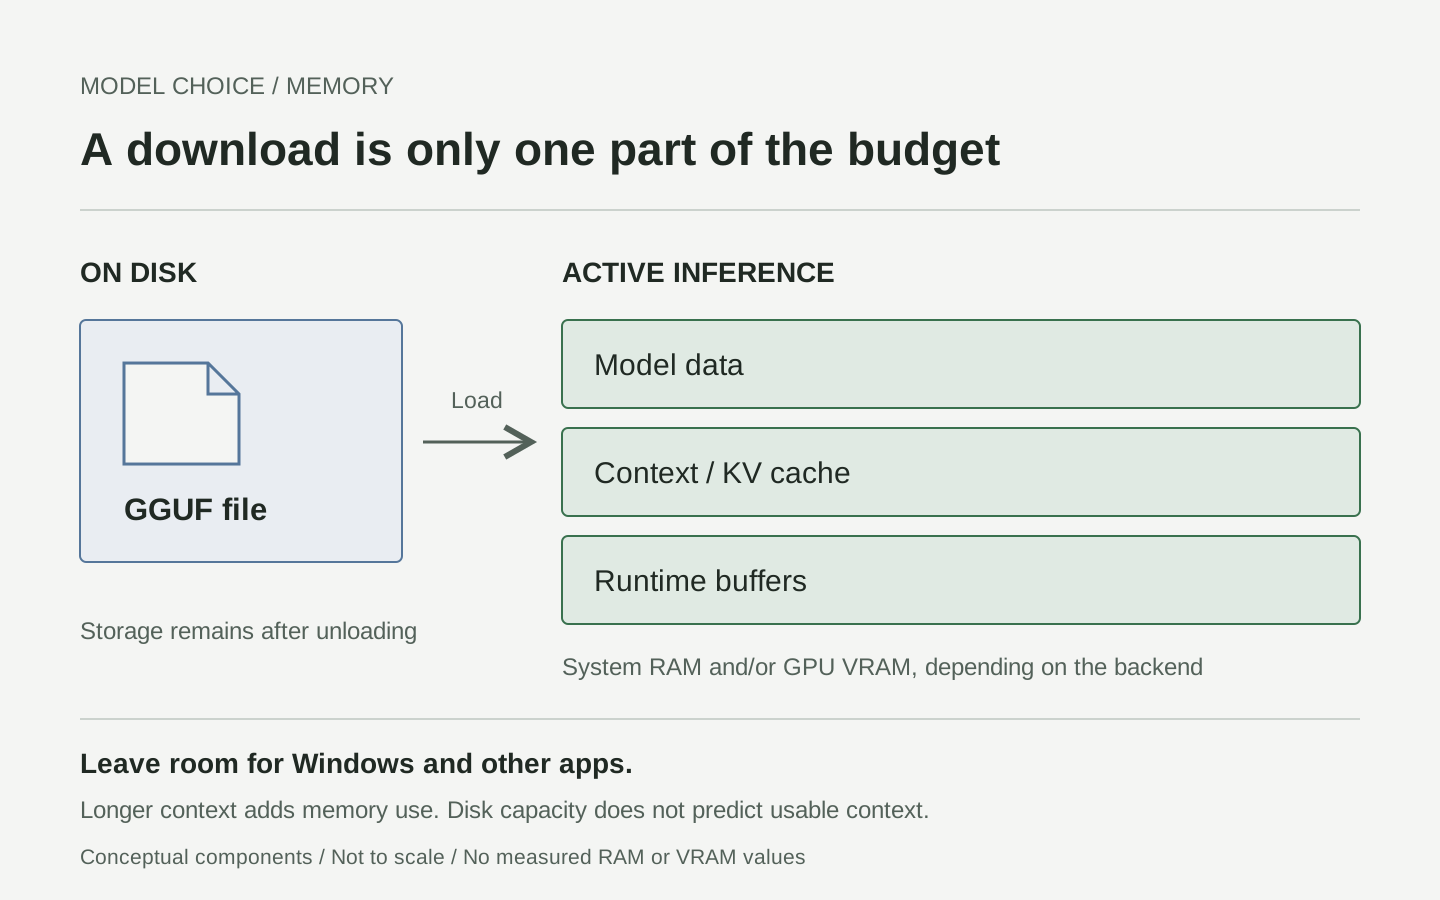
Originalgrafik zum Konzept, keine gemessene Speicheraufteilung. Die Quelle zu Modelldetails schätzt den Speicherbedarf für Modell und Kontext; der gesamte PC-Verbrauch umfasst mehr.
Öffnen Sie die Details eines Modells und prüfen Sie die Speicherschätzungen für die Kontextlänge. Wählen Sie ein kleines empfohlenes Chatmodell und eine kurze Kontextoption, die noch Reserven lässt. Eine hypothetische 4-GB-Datei auf einem PC mit 16 GB beweist nicht, dass ein langes Gespräch hineinpasst. Wenn Sie später Quantisierungen vergleichen, lassen Sie Modell, Eingabe und Kontext unverändert, damit der Unterschied nachvollziehbar bleibt. Prüfen Sie vor einer kommerziellen Nutzung die Lizenz des Modells; die MIT-Lizenz der App gilt nicht für jedes herunterladbare Modell.
Machen Sie den ersten Chat bewusst leicht überprüfbar
Der Einführungsbeitrag nennt die Bereiche Recommended Models und Available. Im geprüften Quellcode von v0.12.0 stehen stattdessen Models, eine Trennzeile Browse more und Symbol-Tooltips wie Download model, Load model, Open WebUI und Stop model. Orientieren Sie sich an den Steuerelementen Ihrer Version, statt endlos nach einem älteren Bereichsnamen zu suchen. Versionsgebundener Windows-Oberflächencode
- Öffnen Sie das Menü im Infobereich und prüfen Sie Größe und Details eines empfohlenen Modells. Wählen Sie für den ersten Durchlauf ein öffentliches Modell ohne Zugangsbeschränkung.
- Verwenden Sie die Downloadsteuerung und warten Sie, bis der Download abgeschlossen ist. Ein abgeschlossener Download bedeutet, dass die Datei angekommen ist, nicht dass die Inferenz läuft.
- Wählen Sie in den Modelldetails einen kurzen Kontext und dann Load model. Nach dem Laden wählen Sie Open WebUI, um zum lokalen Chat zu gelangen. Auch die offizielle Kurzanleitung beschreibt, den Kontext vor dem Chatstart auszuwählen. Kurzanleitung
- Fügen Sie die synthetische Eingabe unten ein und senden Sie sie ab. Vergleichen Sie die Antwort mit den vorgegebenen Fakten; bewerten Sie den Erfolg nicht allein danach, ob Text erscheint.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Eine brauchbare Antwort übernimmt beide Termine und lässt Sams Frist als nicht angegeben offen. Eine erfundene Frist ist ein Genauigkeitsfehler, selbst wenn die Installation einwandfrei funktioniert. Speichern Sie Eingabe und Modell-ID für Vergleiche und wählen Sie danach Stop model. Die App dokumentiert außerdem ein Chat-Overlay über Alt+Space; es ist optional und keine Voraussetzung. Windows-README
Drei kleine Aufgaben zeigen, wofür sich ein lokales Modell eignet
Dies sind beispielhafte Übungen mit erfundenen Eingaben, keine dokumentierten Modellausgaben. Jede enthält eine Aufgabe, eine Rückfrage und ein konkretes Abnahmekriterium.
Machen Sie aus Notizen eine Übergabe, ohne Entscheidungen zu erfinden
Angenommen, eine Freiwilligengruppe bereitet eine Wochenendveranstaltung vor. Geben Sie diese Anfrage ein:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
Wichtig ist die Unterscheidung zwischen einer Zusage und einem Vorschlag. Fragen Sie nach: „Welche Aufgaben wurden ausdrücklich zugewiesen, und welche sind lediglich Vorschläge?“ Akzeptieren Sie das Ergebnis nur, wenn Junes Aufgabe zugewiesen ist, Omars Angebot vorläufig bleibt und keine Startzeit auftaucht. Bewahren Sie die Originalnotizen zusammen mit der Übergabe auf, damit eine andere Person die Belege prüfen kann.
Lernen Sie einen Text mit Fragen, die sich auf die Quelle beschränken
Verwenden Sie einen kurzen gemeinfreien Text oder eine selbst verfasste synthetische Erklärung. Hier ist eine in sich geschlossene Übung:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Prüfen Sie jedes Zitat, nicht nur die Plausibilität der Antwort. Eine gute unbeantwortbare Frage könnte sich auf Temperaturschwellen beziehen; das Modell darf aber keine Schwelle erfinden. Bitten Sie in einem zweiten Durchgang um einfachere Formulierungen bei unveränderten Fakten. So wird eine Überarbeitung Satz für Satz überprüfbar, statt eine allgemeine Einführung zum Gewächshaus anzufordern.
Formulieren Sie eine Servicenachricht, ohne unerlaubte Versprechen zu machen
Üben Sie vor echten Kundentexten mit einem fiktiven Ticket:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Lehnen Sie einen Entwurf ab, der behauptet, die Rückerstattung sei verarbeitet worden, oder ein Ergebnis am selben Tag garantiert. Bitten Sie das Modell, jedes gegebene Versprechen zu markieren, und prüfen Sie diese Stellen selbst. Eine Kontomaßnahme kann nur eine Person mit Zugriff auf das tatsächliche Supportsystem bestätigen. Lokale Ausführung verlagert den Ort der Texterstellung, gibt dem Modell aber keine Befugnis, Rückerstattungen auszulösen.
Die lokale API kann dasselbe Modell verwenden
Sie können es beim Chat belassen. Für einen Editor, ein Skript oder einen Prototyp ist der verwaltete Server unter http://localhost:9931 dokumentiert; OpenAI-kompatible Anfragen laufen unter /v1. Diese lokale Kompatibilität ist keine Anfrage an die OpenAI-Cloud. Prüfen Sie in den Einstellungen, falls der Port geändert wurde. Llama-API-Dokumentation
Starten Sie bei laufender App und bereits geladenem Modell PowerShell. Listen Sie zuerst die verfügbaren Modelle des Routers auf: /models enthält den Ladestatus, /v1/models ist der OpenAI-kompatible Metadatenendpunkt. Kopieren Sie die genaue ID des Modells, das Sie bewusst geladen haben. Wählen Sie nicht willkürlich den ersten Eintrag aus, da dadurch ein anderes Modell geladen werden könnte.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Ersetzen Sie den Platzhalter unten durch genau diese ID, bevor Sie den zweiten Block ausführen. Er sendet ausschließlich synthetischen Text und benötigt kein zusätzliches SDK:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
Form und Ausgabefeld der Anfrage entsprechen der offiziellen llama.cpp-Serverreferenz. Lassen Sie Listen On auf localhost und fügen Sie in diesem Beispiel niemals einen Cloud-API-Schlüssel ein. Bei einer Antwort 401 prüfen Sie die lokale Authentifizierung, statt den Schutz zu entfernen. In v0.12.0 erzeugt die Auswahl einer Nicht-Loopback-Adresse einen appgenerierten Schlüssel und erfordert eine Bestätigung. Sicherheitsverhalten unter Windows
Lokale Inferenz lässt nicht alle Netzwerkvorgänge verschwinden
Laut Windows-README bleiben Eingaben und Inferenz lokal und die App sendet keine Telemetrie. Außerdem dokumentiert es Netzwerkanfragen für Modelldownloads und Versionsprüfungen mit einem User-Agent, der App-Version, Windows-Build und Architektur enthält. Das sind unterschiedliche Vorgänge und keine widersprüchlichen Bedeutungen von „offline“. Datenschutzhinweis
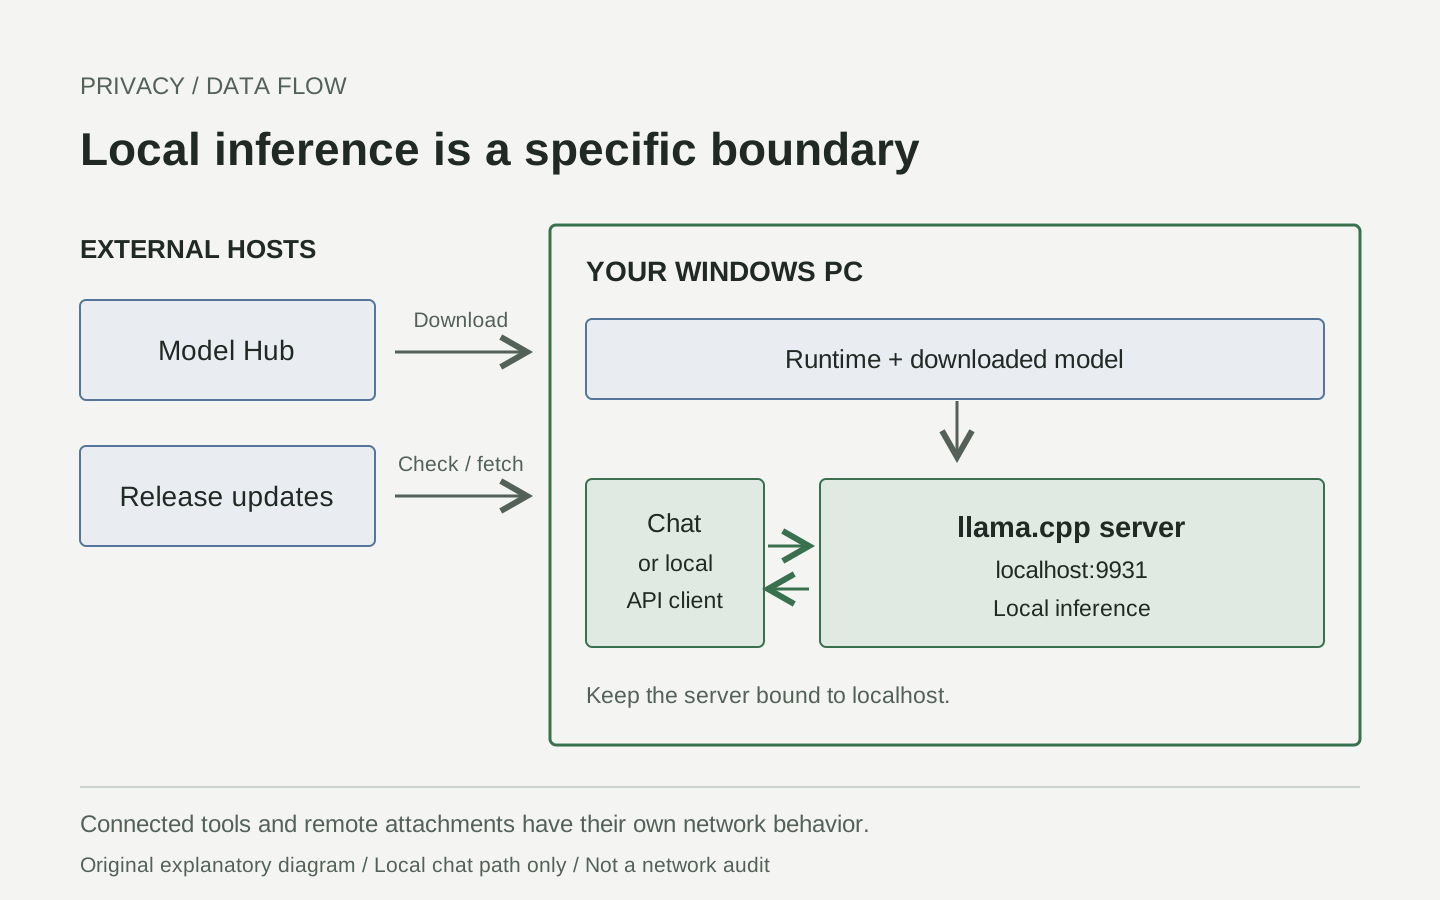
Originalgrafik zum Datenfluss. Download-Hosts liegen extern; der dargestellte Chat-Ablauf ist lokal. Quellen: Windows-Datenschutzdokumentation und API-Referenz.
Ein heruntergeladenes, unterstütztes Modell kann ohne Internetverbindung Inferenz ausführen; ein neues Modell muss aber zunächst heruntergeladen werden. Ein verbundener Editor, eine Browser-Erweiterung, eine entfernte Anhangs-URL oder ein aktiviertes externes Werkzeug hat eigenes Netzwerkverhalten. Nehmen Sie nicht an, dass es die lokale Grenze des Servers übernimmt.
Prüfen Sie vor vertraulichen Aufgaben Gesprächsspeicherung, Browser-Erweiterungen, Sicherungs- und Synchronisierungsorte sowie die Regeln Ihrer Organisation. Ein synthetischer Offline-Chat ist nach der Einrichtung eine nützliche Funktionsprüfung, aber kein Beleg dafür, dass jede Komponente geprüft wurde. Nehmen Sie Tokens oder private Eingaben niemals in öffentliche Diagnoseprotokolle auf.
Beheben Sie den fehlerhaften Schritt statt der gesamten Installation
| Symptom | Zuerst prüfen | Sinnvoller nächster Schritt |
|---|---|---|
| Das Bundle lässt sich nicht installieren | Mindest-Build 26100, Architektur, Signatur, Gerätevorgaben | Den genauen App-Installer-Fehler festhalten; offizielle Updates oder Administrationshilfe verwenden |
| Kein App-Fenster sichtbar | Infobereich und ausgeblendete Symbole | Das Symbol im Infobereich öffnen; ein dauerhaftes Taskleistenfenster ist nicht zu erwarten |
| Modelldownload schlägt fehl | Speicherplatz am Ziel, Verbindung, Zugangsbeschränkung, angezeigter Fehler | Ursache vor einem erneuten Versuch klären; mit einem öffentlichen Modell beginnen |
| Download beendet, Laden schlägt fehl | Kontextschaetzung, freier Speicher, Laufzeitfehler | Andere geladene Modelle stoppen und Kontext oder Modellgröße reduzieren |
| Antworten sind langsam | Modellgröße, Kontextlänge, tatsächlich verwendetes CPU-/GPU-Backend | Eine kurze Eingabe vergleichen; eine Katalogempfehlung nicht als Geschwindigkeitsgarantie verstehen |
| API kann keine Verbindung herstellen | App läuft, konfigurierter Port, lokale Adresse | Serverstatus prüfen, bevor Sie einen zweiten Server starten |
| Flüssig formulierte Antwort enthält falsche Details | Quelltext und Modelleignung | Aufgabe verkürzen und Belegzitate verlangen |
Das aktuelle README nennt %LOCALAPPDATA%\Llama als Speicherort für Einstellungen und Protokolle; der Einführungsbeitrag nannte einen anderen Protokollpfad. Verwenden Sie die Steuerung der App zum Öffnen des Protokollordners, statt den Pfad zu erraten. Der dokumentierte Endpunkt /health hilft, einen einsatzbereiten Modellserver von einem noch ladenden zu unterscheiden. Ein aktiver Router beweist jedoch nicht, dass das gewählte Modell geladen ist. Aktuelle Dokumentation zum Speicherort, Verhalten des Serverstatus
Der erste Einrichtungslauf ist erst erfolgreich, wenn diese Prüfungen bestanden sind
- Das offizielle signierte Paket wird installiert, ohne Sicherheitsfunktionen zu deaktivieren.
- Ein bewusst gewähltes Modell wird vollständig heruntergeladen und geladen.
- Der Chat öffnet sich unter einer lokalen Adresse und beantwortet die synthetische Aufgabe.
- Termine, Namen und fehlende Angaben stimmen mit dem vorgegebenen Text überein.
- Sie können das Modell stoppen und erneut laden.
- Falls Sie die API verwenden, antwortet das gewünschte Modell und der Server bleibt auf localhost beschränkt.
Das Fazit: Lokale KI ist ein überprüfbarer Arbeitsablauf
Unsere Einschätzung: Die wichtige Verbesserung besteht nicht darin, einen Terminalbefehl zu vermeiden. Sie besteht darin, Modellauswahl, Speicherbedarf, Quellmaterial und Antwort so verständlich zu machen, dass Sie den Ablauf wiederholen können. Beginnen Sie mit einer kleinen Aufgabe, deren Antwort Sie überprüfen können. Erweitern Sie den Einsatz erst, wenn klar ist, woran Erfolg zu erkennen ist.
Quellen und Medien
Geprüft am 20. Oktober 2026. Dieser Leitfaden beschreibt dokumentierte Abläufe; es werden weder ein Installationstest noch ein Modelllauf, eine bezahlte Anfrage oder ein Benchmark behauptet. Alle drei SVGs sind originale Erläuterungsgrafiken und keine Nachbildungen der Oberfläche. Der Herausgeber zeigt den tatsächlichen Ablauf im offiziellen Screenshot des Infobereichs und in der Overlay-Demonstration. Diese Assets sind verlinkt und nicht erneut veröffentlicht.
- Ankündigung von Hugging Face, 13. Oktober
- Windows-Version, Paket und Sicherheitsänderungen
- Offizielle Installation und Kurzanleitung
- GGUF-Format und Metadaten
- Lokale API und Endpunktdokumentation
- Laufzeit und Serverreferenz von llama.cpp
Machen Sie Ihre Experimente wiederverwendbar
Bewahren Sie Quelllinks, Eingaben, Modell-IDs und Prüfnnotizen zusammen auf, statt nur die endgültige Antwort zu speichern. Telli.sh kann diese Recherchenotizen ordnen; es ist weder eine Llama-Windows-Integration noch eine Zusage, dass Ihre Notizen offline bleiben. Telli.sh-Konto erstellen