本地 AI 应用升级到 llama.cpp 1.0,原有流程还能照常运行吗?
llama.cpp 1.0 会用版本号标记公共 C 接口的不兼容变更。替换正常使用的版本前,可以分别检查库、本地服务器和应用安装包。
一个小型工程团队把离线文档助手带到网络不稳定的现场。助手会读入维护手册的一段内容,返回引用页码和简短答案。在开发笔记本上,新版 llama.cpp 启动并返回了文字。到了现场的笔记本,已保存的启动配置仍传入旧选项。再往后,应用还依赖某个响应字段,而开发人员手动试用时没有检查它。三处都涉及升级 llama.cpp,却各自依赖不同的接口。
2026 年 11 月 13 日,ggml-org 发布了 llama.cpp 和 ggml 1.0.0。llama.cpp 运行语言模型,以 libllama 的形式提供推理库。ggml 提供张量运算和硬件后端,对应的库叫 libggml。维护者宣布,今后若公共 C 接口出现不兼容变更,将通过主版本号标明。llama.cpp 1.0.0 已删除弃用的调用和一个退役的命令行选项。维护者 11 月 13 日发布的版本策略 · llama.cpp 1.0.0 发布说明 · ggml 1.0.0 发布说明
替换运行时之前,先判断应用属于哪类集成。有些应用构建并链接 C 库,有些启动本地 HTTP 服务器并发送请求,还有些把运行时放进可直接安装的应用程序。一款应用可能横跨多类。分别做几项小检查,比在开发电脑上演示成功一次更能说明升级是否可行。
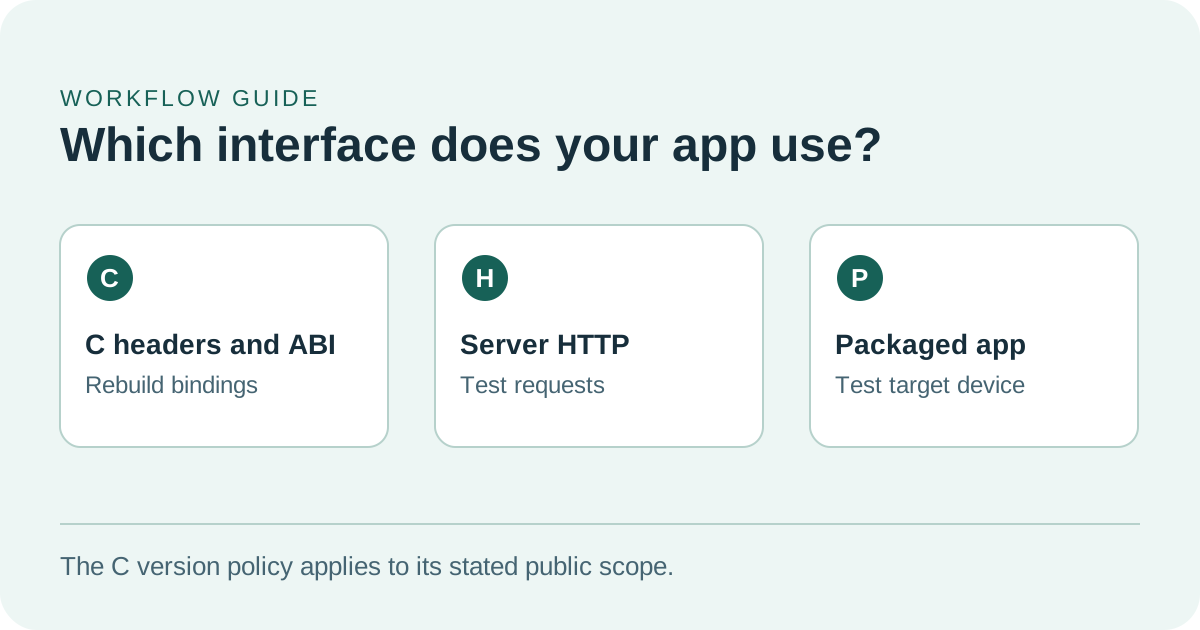
C 兼容性、HTTP 响应和打包版本各有不同的检查方式。
1.0 给原生集成提供了更清楚的变更信号
C 头文件描述源代码怎么调用库,编译器由此知道哪些函数和数据类型可用。二进制接口通常称为 ABI,规定编译后的代码怎样与编译后的库配合。重新构建可以提早发现源代码引用的声明已经删除。启动链接完成的应用,才能看到它和目标机器上安装的库实际如何运行。应用若自行加载原生依赖,两项都值得检查。
维护者在 11 月 13 日公布的策略中说明,项目 include 目录内的公共 C API 若有破坏兼容性的修改,就会提升主版本号。兼容的新功能、后端更新和模型支持属于次版本,不改动 API 的修复归于补丁版本。这对发布原生绑定的人有参考价值。发布命令行启动器或 HTTP 客户端的团队,仍需要检查用户已经依赖的选项和请求。维护者的版本策略公告
标签版本里的改动就是具体例子。llama.cpp 1.0.0 发布说明记录了从 llama.h 删除 35 个已弃用函数,还单独列出了移除 llama_set_warmup 和退役的碎片整理控制项。用于推测解码的 NextN API 被移到 llama.h,文档还记录了一处状态相关的重命名。从应用实际用到的调用查起。如果编译器提示某个函数缺失,先看发布说明和当前公共头文件,再决定怎样替换原有行为。1.0.0 的 API 变更 · 1.0.0 标签的公共头文件
对那款离线手册助手,可以做一次原生集成的冒烟测试:加载已知的模型文件,发送一段短摘录和一个问题,读取生成的答案,再正常关闭模型。用用户真正运行的应用进程重复加载和关闭。如果还要单独编译语言绑定,要确认构建用的是预期头文件,安装后的运行时加载的也是预期的库。解读结果前,记下实际使用的构建产物。对着开发电脑上的库编译成功,并不能说明现场笔记本里随应用一起打包的那份库也会正常运行。
测试用户实际依赖的那一层
项目还提供 HTTP 进程 llama-server,它有自己的命令行参数和文档化端点。1.0.0 新增 OpenAI 兼容的 /v1/audio/speech 端点,说明服务器功能也会随着 C 库一同演进。同一版本删除了 --defrag-thold。打包服务若仍传入该选项,即便没有直接调用 C 函数,也需要迁移。1.0.0 发布说明 · 1.0.0 标签下的服务器文档
服务器文档介绍了一项可随应用一起测试的检查。模型加载期间,/health 可能返回 HTTP 503,加载完成后返回 200。已经使用 HTTP 客户端的团队,可以继续提交真正会用到的聊天、嵌入或其他请求,确认客户端能解析响应。若支持流式响应,既要试正常结束的短响应,也要试用户从应用里中途取消的较长响应。最简单的端点调用成功,无法覆盖取消按钮和文本解析器。v1.0.0 服务器健康检查及端点文档
| 应用使用的组件 | 升级后先检查什么 | 实际工作流增加的检查 |
|---|---|---|
| 公共 C 头文件和原生库 | 从头构建,并确认用预期的库运行 | 反复加载模型、发送短请求、释放资源 |
| 本地 HTTP 服务器进程 | 用保存的设置启动,等待模型报告就绪 | 试一下客户端真正支持的请求、流式响应、取消和错误状态 |
| 带运行时的桌面版或离线安装包 | 在代表性机器上安装并记录构建产物 | 以既有用户设置打开应用,用安装版运行一个已知的本地模型 |
| 特定硬件后端 | 查看选中了哪个后端,模型能否装入内存 | 在承诺支持的最慢配置上比较内存和耗时 |
第三种集成涉及服务器功能列表之外的事情。例如,Windows 安装包可能需要把后端库放在可执行文件旁,还要可靠地找到用户已有的模型,并在缺少文件时显示看得懂的错误提示。开发人员的电脑可能早已单独安装了可用的后端。在代表普通用户的环境中试用新安装包,才能发现那些被开发环境遮住的依赖缺口。11 月 13 日的公告列出了多种发布方式和预发布平台。用团队真正打算交付的标签或安装包版本,并记下来源。维护者的打包说明
版本号看不出多久能等到手册里的答案
对等待离线助手的人来说,好几个处理阶段都算在同一段等待里。系统先加载模型。应用对问题和文档摘录分词,运行时处理提示词、开始生成文字并发送到界面。手册摘录很长时,等待可能主要花在提示词处理上。若特意要求长答案,生成词元的时间则可能占得更多。如果这些差别都关系到体验,就分别测启动时间、首段文字出现在界面上的时间,以及完整响应时间。
1.0.0 标签下的文档说明,llama-bench 有提示词处理、文本生成和二者合并三种模式。报告的时间不包含分词和采样,所以它适合在匹配设置下比较两个运行时版本,也说明为什么结果和界面上测到的等待时间不同。要弄清哪个阶段改善了,可以把两组值都记下来。1.0.0 标签下的基准测试文档
先在两个版本中使用同一个 GGUF 模型文件。在两边都支持的情况下,保持硬件后端、上下文参数和卸载配置一致,并保存实际参数和模型哈希。分别试短输入和接近完整文档的长输入。测内存时,既记下加载后稳定的用量,也记录具有代表性的最长请求中观测到的峰值。一台空闲笔记本能启动模型,而用户同时打开浏览器和文档查看器时,可能就会碰到不同的限制。
1.0.0 发布说明列出了推理时键值缓存的 FP8 选项,包括 f8_e4m3,以及混合专家模型中可配置的主机内存专家缓存。这些能力增加了可比较的配置。如果后端和模型支持某项设置,就将它的效果和 1.0 迁移分开测。在一台代表性机器上启用设置,重跑相同输入,比较答案是否仍满足应用要求。这样出现耗时变化或遗漏引用时,才容易追查是哪个改动引起的。1.0.0 发布说明中的核心改动
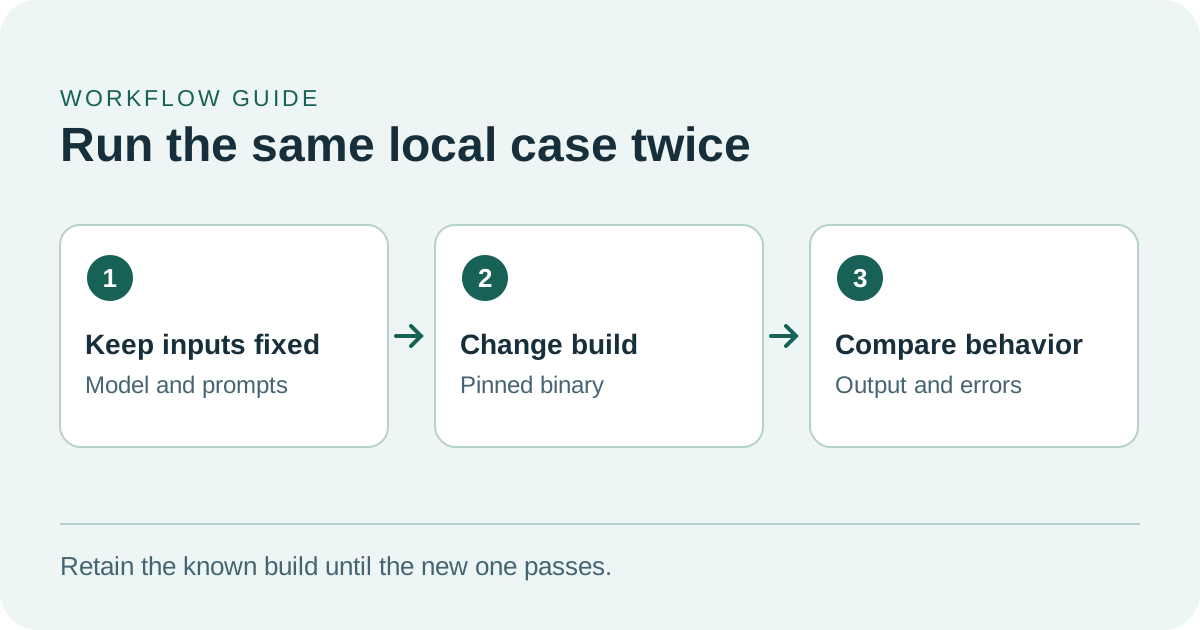
固定模型和输入,才能检查差异是否来自这次升级。
先做一次小迁移演练,再决定是否发布
- 锁定两个确切的构建版本。 把已交付版本和 1.0.0 候选放在不同位置。记下应用、运行时、模型版本、硬件后端,并确认每次运行使用相同的 GGUF 校验值。切换构建时保留用户数据和应用设置。
- 沿用真实的启动方式。 仅做回环服务器测试时,可在换成实际获准的模型文件后,以
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931为起点。也跑一遍已交付版本的启动命令,及早发现退役选项。确认服务器就绪,再用用户真正打开的客户端测试。标签版本的服务器配置与选项 - 准备几个不好回答的问题。 试一段只有一个明确答案的短摘录、一段混有相近术语的长摘录,以及单靠摘录无从回答的问题。先确定每个场景怎样算答得有用。原文有答案时,助手应引用正确页码。没有依据时要说明。将解析错误、无法使用的输出和模型质量分开记录。
- 每次只比较一项性能设置。 在代表性机器上为两个版本匹配相同后端,可先运行
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5。词元数量和五次重复都是示例。再加入应用启动、内存、延迟以及更长的真实输入,才能判断用户会遇到什么。标签版本的基准测试选项 - 运行已安装版本,并演练回退。 在能代表用户的干净环境中使用候选版本,重启并重复支持范围内规模最大的任务。确认启动失败时,现有设置和文件仍可使用,也能回到上一版应用。把证据留给同事,便于决定何时暂停扩大部署。
多数项目只需选几项合适的测试用例,就能发现接下来要排查的问题。如果长摘录的响应变慢,先查是首批文本出现前、生成过程中,还是界面显示时出现差异。升级后如果某类请求失败,先记录能触发问题的请求结构和客户端,再更改提示词或模型。若只有打包版本失败,将安装包和启动后的进程与能运行的开发版对照。每一层的负责人就有了可以复现的具体条件。
在需要用它的机器上,升级过程应该可以复现
llama.cpp 1.0 的价值是让许多本地工具依赖的运行时更易于管理变更。应用团队可以留下简短的兼容性记录,包括构建、模型、机器、用户实际发出的请求和结果。即使维护运行时或应用的人变了,下一次升级也能从测试用户依赖的流程开始。
来源
- ggml-org 的版本策略和分发公告,2026 年 11 月 13 日
- llama.cpp 1.0.0 发布说明,2026 年 11 月 13 日
- ggml 1.0.0 发布说明
- 1.0.0 标签下的 llama.cpp 公共 C 头文件
- 1.0.0 标签下的 llama-server 文档
- 1.0.0 标签下的 llama-bench 文档
想把升级决定、测试笔记和模型配置放在一起,方便以后搜索,可以创建 Telli.sh 账号。