Seu aplicativo de IA local pode migrar para o llama.cpp 1.0 sem quebrar o fluxo de trabalho?
A numeração do llama.cpp 1.0 explicita mudanças incompatíveis na interface pública em C. Veja como testar a biblioteca, o servidor local e o aplicativo empacotado antes de trocar uma versão que funciona.
Uma pequena equipe de engenharia leva um assistente de documentos offline a um local com conexão ruim. O assistente recebe um parágrafo de um manual de manutenção e devolve a página citada e uma resposta curta. No notebook de desenvolvimento, a nova versão do llama.cpp inicia e gera texto. No notebook de campo, a configuração de inicialização ainda passa uma opção antiga. Mais adiante, o aplicativo espera um campo da resposta que passou despercebido no teste manual. Nos três casos, a equipe diz que está atualizando o llama.cpp, mas cada componente depende de uma interface diferente.
Em 13 de novembro de 2026, a ggml-org lançou o llama.cpp e o ggml 1.0.0. O primeiro executa modelos de linguagem e disponibiliza a biblioteca de inferência libllama. O segundo oferece operações com tensores e backends de hardware por meio da biblioteca libggml. Os mantenedores anunciaram que futuras incompatibilidades em suas interfaces públicas em C serão sinalizadas no número da versão principal. A própria versão 1.0.0 do llama.cpp removeu chamadas obsoletas e uma opção de linha de comando descontinuada. Anúncio dos mantenedores sobre o versionamento, de 13 de novembro · Versão 1.0.0 do llama.cpp · Versão 1.0.0 do ggml
Antes de trocar o ambiente de execução, identifique em quais grupos a sua integração se encaixa. Alguns aplicativos são compilados e vinculados à biblioteca em C. Outros iniciam um servidor HTTP local e enviam solicitações para ele. Outros incluem o ambiente de execução em um aplicativo pronto para instalar. Um aplicativo pode pertencer a mais de um grupo. Em cada caso, um conjunto pequeno de verificações dá uma base melhor para decidir sobre a atualização do que uma demonstração bem-sucedida no computador de quem desenvolve.
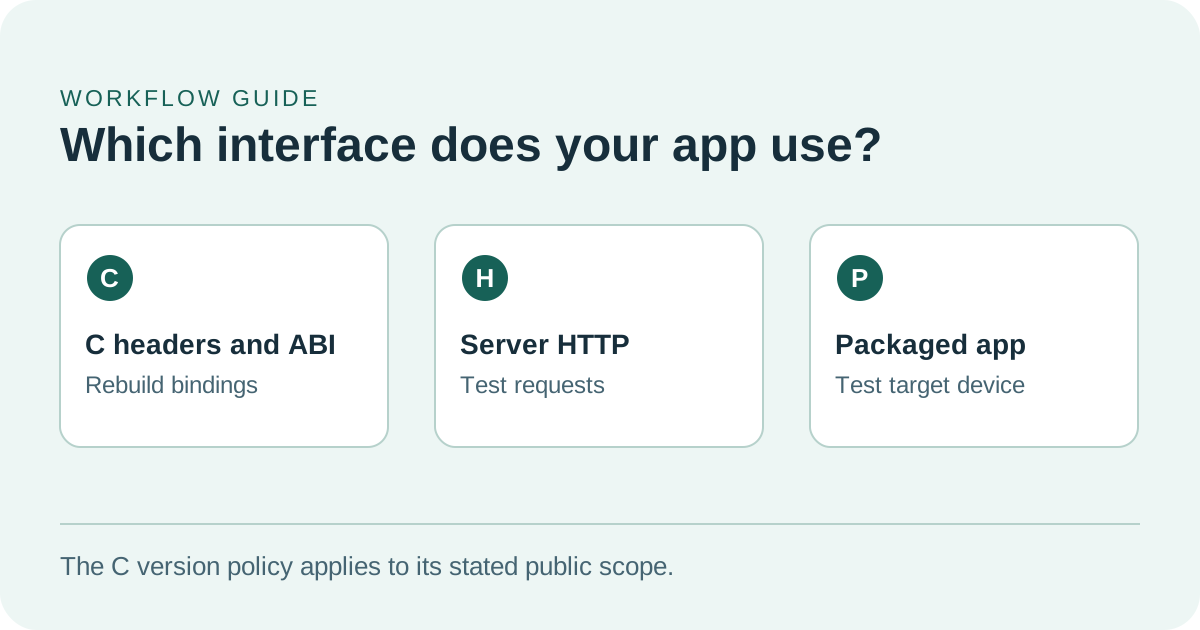
A compatibilidade em C, as respostas HTTP e os pacotes distribuídos exigem verificações diferentes.
A versão 1.0 dá um sinal mais claro às integrações nativas
Os arquivos de cabeçalho em C descrevem como o código-fonte chama a biblioteca. Eles informam ao compilador as funções e os tipos de dados disponíveis. A interface binária, ou ABI, define como o código compilado funciona com a biblioteca compilada. Uma compilação limpa pode revelar logo uma declaração que sumiu do código-fonte. Iniciar o aplicativo vinculado mostra o que acontece com a biblioteca instalada no dispositivo de destino. Um aplicativo que carrega suas próprias dependências nativas deve fazer as duas verificações.
A política de 13 de novembro prevê uma nova versão principal quando há mudanças incompatíveis na API pública em C, nos diretórios de inclusão do projeto. Adições compatíveis, atualizações de backend e suporte a novos modelos entram em versões secundárias. Correções sem mudança de API entram em versões de correção. A numeração ajuda quem distribui um binding nativo. Quem distribui um inicializador de linha de comando ou um cliente HTTP ainda precisa conferir as opções e as solicitações que os usuários já utilizam. Anúncio dos mantenedores sobre o versionamento
As mudanças na versão marcada dão um exemplo concreto. As notas do llama.cpp 1.0.0 listam a remoção de 35 funções obsoletas em llama.h e mencionam separadamente a retirada de llama_set_warmup e dos controles de desfragmentação descontinuados. Também registram a transferência da API NextN de decodificação especulativa para llama.h e a alteração do nome de uma função de estado. Comece pelas chamadas que você já usa. Se o compilador indicar uma função ausente, consulte as notas da versão e o cabeçalho público atual antes de decidir como substituir o comportamento que dependia dela. Mudanças de API na versão 1.0.0 · Cabeçalhos públicos marcados como 1.0.0
No assistente offline de manuais, um teste básico da integração nativa pode carregar um modelo conhecido, enviar uma pergunta com um trecho curto, ler a resposta e encerrar o modelo corretamente. Repita o ciclo de carga e encerramento no processo do aplicativo que os usuários executam. Se houver um binding de linguagem compilado separadamente, verifique se a compilação encontra os cabeçalhos certos e se a versão instalada carrega a biblioteca pretendida. Registre o artefato que foi usado antes de interpretar o resultado. Uma compilação bem-sucedida com uma cópia local diz pouco sobre outra cópia empacotada com o aplicativo no notebook de campo.
Teste a parte do sistema que os usuários realmente usam
O projeto também distribui o llama-server, um processo HTTP com seus próprios argumentos de linha de comando e endpoints documentados. A versão 1.0.0 acrescenta o endpoint /v1/audio/speech, compatível com a API da OpenAI, um exemplo de recurso do servidor que pode evoluir junto com a biblioteca em C. A mesma versão retirou --defrag-thold. Um serviço empacotado que passa essa opção precisa adaptar a inicialização mesmo que nunca chame uma função em C diretamente. Notas da versão 1.0.0 · Documentação do servidor na versão 1.0.0
A documentação do servidor sugere uma verificação simples para acompanhar o teste do aplicativo. Uma solicitação a /health pode retornar HTTP 503 enquanto o modelo está sendo carregado e retorna 200 quando está pronto. Uma equipe que já depende de um cliente HTTP pode então testar a própria solicitação de chat, embeddings ou outro recurso e confirmar que o cliente interpreta a resposta. Se o recurso usa streaming, inclua uma resposta curta que termine normalmente e uma mais longa, cancelada pelo usuário no aplicativo. O sucesso do endpoint mais simples não exercita o botão de cancelar nem o código que interpreta o texto. Documentação de saúde e endpoints do servidor 1.0.0
| O que o aplicativo usa | Primeira verificação após a atualização | O que verificar no fluxo real |
|---|---|---|
| Cabeçalhos públicos em C e biblioteca nativa | Recompilar do zero e executar com a biblioteca pretendida | Carregar um modelo, fazer uma solicitação curta e liberar seus recursos repetidas vezes |
| Um processo de servidor HTTP local | Iniciar com as configurações salvas e esperar o modelo ficar pronto | Usar a solicitação real e verificar resposta em streaming, cancelamento e erros que o cliente trata |
| Um instalador de desktop ou offline | Instalar em um dispositivo representativo e registrar os artefatos compilados | Abrir a versão instalada com as configurações existentes e usar um modelo local conhecido |
| Um backend de hardware específico | Conferir o backend escolhido e se há memória para o modelo | Comparar memória e tempos na configuração mais lenta que você se compromete a atender |
A terceira integração tem consequências além da lista de funções do servidor. Um pacote para Windows pode precisar de uma biblioteca de backend junto ao executável, de uma forma confiável de achar o modelo existente e de uma mensagem clara quando o arquivo não for encontrado. Quem desenvolve talvez já tenha um backend funcional instalado separadamente. Testar a nova versão em uma instalação representativa encontra dependências ausentes que o ambiente de desenvolvimento já fornece. O anúncio de 13 de novembro enumera vários canais de distribuição e plataformas com artefatos preliminares. Use a versão ou compilação exata que a equipe pretende distribuir e registre de onde veio. Notas dos mantenedores sobre distribuição
O número da versão não diz quanto o usuário vai demorar para receber uma resposta
Quem espera pelo assistente offline percebe várias etapas como uma única demora. O modelo carrega. O aplicativo converte a pergunta e o trecho do documento em tokens. O ambiente de execução processa a entrada, começa a gerar texto e o entrega à interface. Em uma seção longa do manual, a maior parte do tempo pode ser gasta processando a entrada. Em uma resposta deliberadamente longa, a geração pode pesar mais. Meça a inicialização, o tempo até o primeiro texto visível e o tempo total separadamente, quando esses tempos forem relevantes para quem usa o aplicativo.
A documentação da versão 1.0.0 distingue três modos no llama-bench: processamento da entrada, geração de texto e um modo combinado. As medições excluem os tempos de tokenização e amostragem. A ferramenta é útil para comparar duas compilações com a mesma configuração, e essa diferença de escopo explica por que o resultado não equivale à espera registrada na interface. Meça os dois tempos para entender qual etapa melhorou. Documentação da ferramenta de benchmark na versão 1.0.0
Comece usando o mesmo arquivo de modelo GGUF nas duas compilações. Mantenha o mesmo backend, as configurações de contexto e as escolhas de offload quando ambos derem suporte a elas. Salve a configuração aplicada junto com o hash do modelo. Em seguida, teste uma entrada curta e outra do tamanho de um documento. Ao medir memória, anote tanto o pico observado na solicitação representativa mais longa quanto o consumo estável depois da carga. Um modelo que inicia em um notebook sem outros aplicativos abertos pode atingir outro limite quando o usuário já tem um navegador e um leitor de documentos abertos.
A versão 1.0.0 lista opções FP8 para o cache de chaves e valores da inferência, incluindo f8_e4m3, e um cache de especialistas configurável na memória do host para modelos do tipo mistura de especialistas. São mais configurações para comparar. Se o backend e o modelo aceitarem um parâmetro, avalie seu efeito separadamente da migração para o 1.0. Aplique a configuração em um único dispositivo representativo, repita as entradas e confira se as respostas continuam atendendo aos critérios do aplicativo. Assim, uma alteração na latência ou uma citação que sumiu pode ser investigada sem adivinhar qual mudança a produziu. Mudanças do núcleo na versão 1.0.0
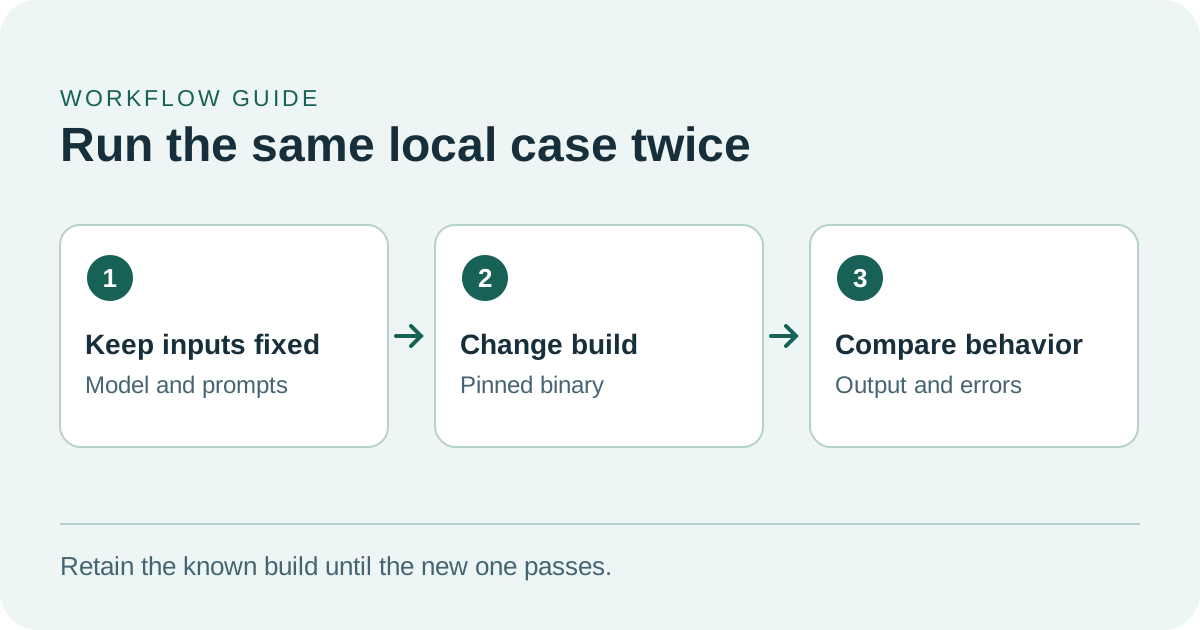
Fixe o modelo e as entradas para atribuir eventuais diferenças à atualização.
Um ensaio pequeno ajuda a decidir sobre a migração
- Selecione duas compilações exatas. Mantenha a versão distribuída e a candidata 1.0.0 em locais diferentes. Registre as versões do aplicativo, do ambiente de execução e do modelo, o mesmo checksum de GGUF em cada teste e o backend de hardware. Preserve dados e configurações do usuário ao trocar a versão.
- Use o caminho de inicialização habitual. Para um teste de servidor apenas no endereço de loopback,
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931é um ponto de partida depois de trocar o caminho pelo seu modelo aprovado. Execute também o comando usado na versão distribuída para detectar cedo opções descontinuadas. Confirme que o modelo ficou pronto e teste com o cliente que os usuários já abrem. Opções e configuração do servidor na versão marcada - Separe algumas perguntas difíceis. Teste um trecho curto com uma resposta clara, um trecho mais longo com termos parecidos e uma pergunta que o trecho não responde. Defina o que conta como resposta útil em cada caso. O assistente deve citar a página certa quando o trecho contém a resposta e indicar quando faltam evidências. Registre erros de interpretação e saídas inutilizáveis separadamente da qualidade do modelo.
- Compare uma configuração de desempenho por vez. Em um dispositivo representativo, um primeiro teste é
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5em cada compilação, com o mesmo backend. Os números de tokens e as cinco repetições são exemplos. Inclua no aplicativo a medição da inicialização, da memória e da latência, além de uma entrada real e mais longa, para avaliar o que o usuário vai sentir. Opções da ferramenta de benchmark na versão marcada - Execute a versão instalada e ensaie a volta à anterior. Use a candidata em uma instalação limpa e representativa, reinicie-a e repita o maior caso suportado. Confira se uma falha na inicialização deixa os arquivos e as configurações existentes utilizáveis e se é possível voltar à versão anterior. Guarde as evidências que indicariam a outro integrante da equipe que é hora de pausar a distribuição.
Na maioria dos projetos, poucos casos bem escolhidos bastam para encontrar a próxima falha. Se um trecho longo ficou mais lento, descubra primeiro se a diferença aparece antes do primeiro texto, durante a geração ou na apresentação da interface. Se uma solicitação começa a falhar após a mudança, registre seu formato e o cliente que a aciona antes de alterar a entrada ou o modelo. Se só a versão empacotada falha, compare o instalador e o processo iniciado com a cópia do ambiente de desenvolvimento. Essas comparações dão à pessoa que cuida de cada camada algo concreto para reproduzir.
Uma atualização bem-sucedida precisa funcionar na máquina de quem depende dela
O valor do llama.cpp 1.0 é oferecer um jeito mais claro de gerenciar mudanças em um ambiente de execução usado por muitas ferramentas locais. A equipe de um aplicativo pode aproveitar isso para guardar um registro curto de compatibilidade, com a compilação, o modelo, o dispositivo, a solicitação feita pela interface e o resultado. Assim, a próxima versão começa com um teste do fluxo do qual as pessoas dependem, mesmo que outros profissionais já mantenham o aplicativo e seu ambiente de execução.
Fontes
- Anúncio de versionamento e distribuição da ggml-org, 13 de novembro de 2026
- Versão 1.0.0 do llama.cpp, 13 de novembro de 2026
- Versão 1.0.0 do ggml
- Cabeçalhos públicos em C do llama.cpp na versão 1.0.0
- Documentação do llama-server na versão 1.0.0
- Documentação do llama-bench na versão 1.0.0
Para guardar decisões de atualização, anotações de teste e configurações de modelo em um registro pesquisável, crie uma conta no Telli.sh.