Wie aktualisiert man eine lokale KI-App auf llama.cpp 1.0, ohne ihren Ablauf zu stören?
Bei llama.cpp 1.0 werden inkompatible Änderungen an der öffentlichen C-Schnittstelle in der Versionsnummer sichtbar. So prüfst du Bibliothek, lokalen Server und Installationspaket, bevor du einen funktionierenden Build ersetzt.
Ein kleines Entwicklerteam bringt einen Offline-Assistenten für Dokumente an einen Standort mit schlechter Netzverbindung. Der Assistent erhält einen Absatz aus einem Wartungshandbuch und liefert eine kurze Antwort mit Seitenangabe. Auf einem Entwickler-Laptop startet der neue llama.cpp-Build und gibt Text aus. Auf dem Laptop vor Ort übergibt eine gespeicherte Startkonfiguration noch eine alte Option. An anderer Stelle erwartet die App ein Antwortfeld, das bei der manuellen Prüfung nie kontrolliert wurde. In allen drei Fällen geht es um ein Update von llama.cpp. Die Anwendung ist dabei jeweils auf eine andere Schnittstelle angewiesen.
Am 13. November 2026 veröffentlichte ggml-org llama.cpp und ggml in Version 1.0.0. llama.cpp führt Sprachmodelle aus und stellt seine Inferenzbibliothek als libllama bereit. ggml liefert Tensoroperationen und Hardware-Backends, unter anderem über die Bibliothek libggml. Die Verantwortlichen kündigten an, künftige Inkompatibilitäten in den öffentlichen C-Schnittstellen durch eine neue Hauptversionsnummer kenntlich zu machen. Mit llama.cpp 1.0.0 selbst entfielen veraltete Funktionsaufrufe und eine nicht mehr unterstützte Kommandozeilenoption. Ankündigung zur Versionspolitik vom 13. November · llama.cpp 1.0.0 · ggml 1.0.0
Überlege vor dem Wechsel der Laufzeitumgebung, zu welcher der drei Gruppen deine Integration gehört. Manche Apps werden gegen die C-Bibliothek kompiliert und gelinkt. Andere starten einen lokalen HTTP-Server und senden ihm Anfragen. Wieder andere liefern die Laufzeit als Teil einer installationsfertigen Anwendung aus. Eine App kann zu mehreren Gruppen gehören. Für jede Gruppe gibt es ein paar gezielte Prüfungen. Zusammen liefern sie eine bessere Entscheidungsgrundlage als eine gelungene Demo am Rechner der Entwicklerin oder des Entwicklers.
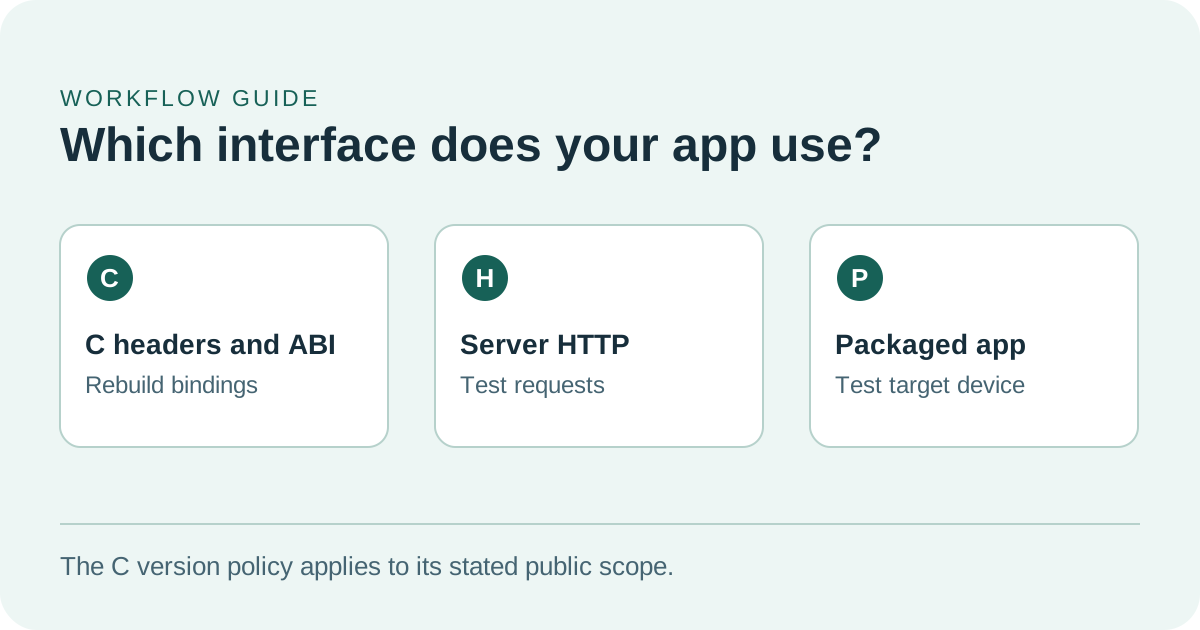
Für die C-Schnittstelle, HTTP-Antworten und Installationspakete sind unterschiedliche Prüfungen nötig.
Version 1.0 gibt nativen Integrationen ein klareres Signal
C-Header legen fest, wie Quellcode die Bibliothek aufruft. Sie teilen dem Compiler mit, welche Funktionen und Datentypen verfügbar sind. Die binäre Schnittstelle, kurz ABI, bestimmt, wie bereits kompilierter Code mit einer kompilierten Bibliothek zusammenarbeitet. Bei einem frischen Build fällt früh auf, wenn eine Deklaration im Quellcode fehlt. Erst der Start der gelinkten Anwendung zeigt, ob sie mit der Bibliothek auf dem Zielrechner läuft. Wenn die App eigene native Abhängigkeiten lädt, führe beide Prüfungen durch.
Nach der Versionspolitik vom 13. November steigt die Hauptversionsnummer bei inkompatiblen Änderungen an der öffentlichen C-API in den Include-Verzeichnissen des Projekts. Kompatible Ergänzungen, Backend-Updates und Unterstützung für weitere Modelle gehören in Nebenversionen. Fehlerkorrekturen ohne API-Änderung gehören in Patch-Releases. Diese Information ist für native Bindings hilfreich. Wer einen Kommandozeilenstarter oder einen HTTP-Client ausliefert, muss weiterhin die Optionen und Anfragen prüfen, die vorhandene Nutzerinnen und Nutzer verwenden. Ankündigung zur Versionspolitik
Die Änderungen am Release-Tag liefern ein konkretes Beispiel. In den Hinweisen zu llama.cpp 1.0.0 steht, dass 35 veraltete Funktionen in llama.h entfernt wurden. Zusätzlich nennen sie den Wegfall von llama_set_warmup und der alten Einstellungen zur Defragmentierung. Die NextN-API für spekulatives Dekodieren wandert in llama.h. Eine Funktion für den Zustand wurde dabei umbenannt. Beginne mit den Aufrufen, die du tatsächlich verwendest. Meldet der Compiler eine fehlende Funktion, prüfe die Release Notes und den aktuellen öffentlichen Header, bevor du entscheidest, wie du das bisherige Verhalten ersetzt. API-Änderungen in Version 1.0.0 · Öffentliche Header am Tag 1.0.0
Beim Offline-Assistenten für Handbücher könnte ein nativer Basistest eine bekannte Modelldatei laden, eine kurze Frage mit Textauszug übergeben, die erzeugte Antwort lesen und das Modell sauber schließen. Wiederhole das Laden und Schließen in dem Anwendungsprozess, den die Mitarbeitenden vor Ort nutzen. Wird ein Sprach-Binding separat kompiliert, prüfe, ob sein Build die vorgesehenen Header findet und ob die installierte Laufzeit die richtige Bibliothek lädt. Halte vor der Auswertung fest, welches Artefakt zum Einsatz kam. Eine erfolgreiche Kompilierung gegen eine Kopie auf dem Entwicklungsrechner sagt wenig über eine separat ausgelieferte Kopie neben der App auf dem Laptop vor Ort.
Prüfe den Teil des Stacks, den deine App tatsächlich nutzt
Das Projekt liefert auch llama-server aus, einen HTTP-Prozess mit eigenen Kommandozeilenargumenten und dokumentierten Endpunkten. Mit 1.0.0 kam der OpenAI-kompatible Endpunkt /v1/audio/speech hinzu. Das ist ein Beispiel dafür, wie sich Serverfunktionen parallel zur C-Bibliothek weiterentwickeln. Dieselbe Version hat --defrag-thold entfernt. Ein mitgelieferter Dienst, der diese Option übergibt, muss angepasst werden, selbst wenn er keine C-Funktion direkt aufruft. Release Notes zu 1.0.0 · Serverdokumentation zum Tag 1.0.0
Die Serverdokumentation beschreibt eine kleine Prüfung als Ergänzung zum App-Test. Eine Anfrage an /health kann beim Laden des Modells HTTP 503 liefern. Sobald das Modell geladen ist, kommt 200 zurück. Teste dann mit dem vorhandenen HTTP-Client deine tatsächliche Chat-, Embedding- oder sonstige Anfrage und prüfe, ob er die Antwort verarbeitet. Nutzt deine App Streaming, probiere eine kurze Antwort, die regulär endet, und eine längere, die du über die App abbrichst. Eine Anfrage an den einfachsten Endpunkt prüft weder die Schaltfläche zum Abbrechen noch die Textverarbeitung. Dokumentation zum Serverstatus und den Endpunkten in v1.0.0
| Was die App nutzt | Erste Prüfung nach dem Update | Was der reale Ablauf zusätzlich prüft |
|---|---|---|
| Öffentliche C-Header und native Bibliothek | Sauber neu bauen und mit der vorgesehenen Bibliothek starten | Ein Modell mehrfach laden, eine kurze Anfrage ausführen und Ressourcen freigeben |
| Lokaler HTTP-Serverprozess | Mit den gespeicherten Einstellungen starten und auf die Bereitschaft des Modells warten | Die unterstützten Anfragen, Streaming-Antworten, Abbrüche und Fehlerzustände des Clients ausprobieren |
| Desktop- oder Offline-Installationspaket | Auf einem repräsentativen Rechner installieren und die Build-Artefakte festhalten | Die installierte App mit vorhandenen Nutzereinstellungen und einem bekannten lokalen Modell öffnen |
| Bestimmtes Hardware-Backend | Ausgewähltes Backend und Speicherbedarf des Modells kontrollieren | Zeit und Speicherbedarf auf der langsamsten zugesagten Konfiguration vergleichen |
Die dritte Integrationsform stellt weitere Anforderungen, die über den Funktionsumfang des Servers hinausgehen. Ein Windows-Paket könnte etwa eine Backend-Bibliothek neben der ausführbaren Datei brauchen. Es muss das vorhandene Modell zuverlässig finden oder bei fehlender Datei verständlich erklären, was passiert ist. Auf dem Entwicklungsrechner ist möglicherweise bereits ein funktionierendes Backend separat installiert. Ein Test auf einer repräsentativen Nutzerinstallation deckt Abhängigkeiten auf, die im Entwicklungsumfeld schon vorhanden sind. In der Ankündigung vom 13. November werden verschiedene Paketkanäle und Plattformen für Vorab-Builds genannt. Nutze genau den Tag oder Paket-Build, den dein Team ausliefern will, und halte seine Herkunft fest. Hinweise der Verantwortlichen zur Paketverteilung
Wie schnell eine Handbuchantwort erscheint, steht in keiner Versionsnummer
Wer auf die Antwort eines Offline-Assistenten wartet, erlebt mehrere Verzögerungen am Stück. Zuerst wird das Modell geladen. Die Anwendung zerlegt Frage und Dokumentauszug in Tokens. Die Laufzeit verarbeitet den Prompt, beginnt mit der Textgenerierung und gibt den Text an die Oberfläche weiter. Bei einem langen Handbuchabschnitt kann das Verarbeiten des Prompts am meisten Zeit kosten. Eine bewusst lange Antwort kann mehr Zeit für neue Tokens beanspruchen. Miss den Start, die Zeit bis zum ersten sichtbaren Text und die Zeit bis zur fertigen Antwort getrennt, wenn diese drei Zeiten für die Nutzung relevant sind.
Die Dokumentation zum Tag 1.0.0 unterscheidet drei Modi in llama-bench: Verarbeitung des Prompts, Textgenerierung und einen kombinierten Modus. Die angegebenen Zeiten enthalten Tokenisierung und Sampling laut dieser Dokumentation nicht. Das macht das Werkzeug nützlich für einen Vergleich zweier Laufzeit-Builds bei identischen Einstellungen. Die gemessene Wartezeit in der Oberfläche kann davon abweichen. Halte beide Messwerte fest, wenn du wissen möchtest, welcher Abschnitt schneller geworden ist. Benchmark-Dokumentation zum Tag 1.0.0
Beginne in beiden Builds mit derselben GGUF-Modelldatei. Halte Hardware-Backend, Kontexteinstellungen und Offloading nach Möglichkeit gleich, und speichere die tatsächlich verwendeten Einstellungen mit dem Modell-Hash. Teste anschließend einen kurzen und einen dokumentlangen Eingabetext. Erfasse bei der Speichermessung den beobachtbaren Höchstwert während der längsten repräsentativen Anfrage und den Normalwert nach dem Laden. Ein Modell, das auf einem ansonsten unbenutzten Laptop startet, kann an eine andere Grenze stoßen, sobald Nutzerinnen und Nutzer zusätzlich Browser und Dokumentanzeige geöffnet haben.
Version 1.0.0 führt FP8-Optionen für den Key-Value-Cache der Inferenz wie f8_e4m3 auf. Dazu kommt ein konfigurierbarer Cache im Hauptspeicher für die Experten von Mixture-of-Experts-Modellen. So entstehen weitere mögliche Konfigurationen. Unterstützen Backend und Modell eine Einstellung, miss ihre Auswirkungen getrennt von der Migration auf 1.0. Ändere sie zuerst auf einem einzigen repräsentativen Rechner, wiederhole die Eingaben und prüfe, ob die Antworten weiterhin die Anforderungen der App erfüllen. So kannst du einer Zeitänderung oder einer fehlenden Quellenangabe gezielt nachgehen. Kernänderungen in Version 1.0.0
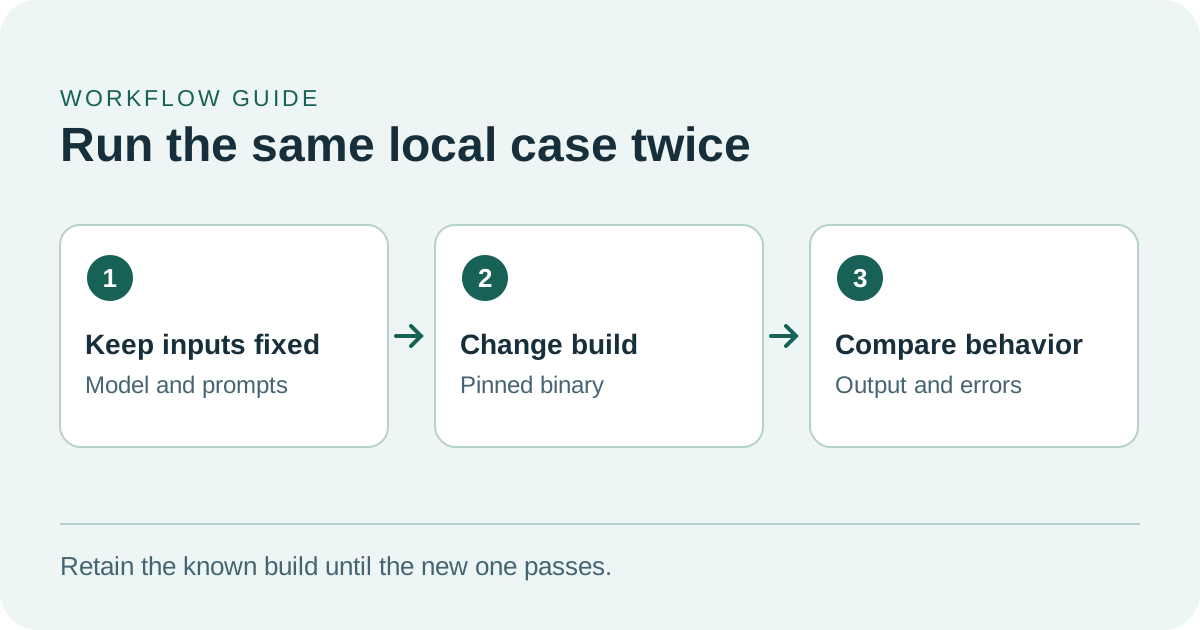
Halte Modell und Eingaben konstant, damit Unterschiede dem Update zugeordnet werden können.
Ein kurzer Probelauf hilft bei der Entscheidung über das Release
- Wähle zwei konkrete Builds. Halte den ausgelieferten Build und den Kandidaten 1.0.0 an unterschiedlichen Speicherorten bereit. Notiere die Versionen von App, Laufzeit und Modell, dieselbe GGUF-Prüfsumme bei jedem Durchlauf und das Hardware-Backend. Erhalte bei einem Build-Wechsel die vorhandenen Daten und Einstellungen.
- Nutze den üblichen Startweg. Für einen auf Loopback begrenzten Serverversuch kannst du mit
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931beginnen, nachdem du die tatsächliche freigegebene Modelldatei eingesetzt hast. Probiere auch den Befehl der bereits ausgelieferten Version, um entfallene Optionen früh zu entdecken. Prüfe die Bereitschaft und öffne den Client, den die Nutzerinnen und Nutzer tatsächlich verwenden. Konfiguration und Optionen des getaggten Servers - Bringe ein paar schwierige Fragen mit. Teste einen kurzen Auszug mit eindeutiger Antwort, einen längeren Abschnitt mit konkurrierenden Begriffen und eine Frage, die der Auszug nicht beantwortet. Lege fest, was in jedem Fall ein brauchbares Ergebnis ist. Wenn der Text die Antwort enthält, sollte der Assistent die richtige Seite nennen. Fehlen Nachweise, sollte er das melden. Erfasse Parserfehler und unbrauchbare Ausgaben getrennt von der Modellqualität.
- Vergleiche jeweils eine Leistungsoption. Auf einem repräsentativen Rechner bietet sich
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5mit beiden Builds und übereinstimmenden Backends als Ausgangspunkt an. Die Token-Zahlen und fünf Wiederholungen sind Beispiele. Miss außerdem Start, Speicher und Latenz in der App und versuche eine längere echte Eingabe, bevor du das Nutzererlebnis beurteilst. Benchmark-Optionen zum Release-Tag - Teste die installierte App und den Rückweg. Öffne den Kandidaten auf einer sauberen, repräsentativen Installation, starte ihn neu und wiederhole den umfangreichsten unterstützten Fall. Prüfe, ob ein fehlgeschlagener Start die bisherigen Einstellungen und Dateien intakt lässt und ob die Rückkehr zur vorigen App-Version klappt. Speichere die Belege, anhand derer andere erkennen, wann ein breiterer Rollout unterbrochen werden sollte.
Bei den meisten Projekten genügen einige gezielt gewählte Testfälle, um den nächsten Fehler zu finden. Ist ein langer Auszug plötzlich langsam, untersuche zuerst, ob sich die Verzögerung vor der ersten Ausgabe, bei der Generierung oder in der Anzeige ergibt. Scheitert eine Anfrage nach dem Wechsel, halte vor Änderungen an Prompt oder Modell fest, welches Anfrageformat und welcher Client den Fehler auslösen. Fällt nur die paketierte Version aus, vergleiche Installationsprogramm und gestarteten Prozess mit der funktionierenden Entwicklungsversion. So weiß die zuständige Person auf jeder Ebene, welchen Zustand sie reproduzieren soll.
Ein gelungenes Update muss auf dem vorgesehenen Rechner wiederholbar sein
llama.cpp 1.0 schafft einen klareren Rahmen für Änderungen an einer Laufzeit, die viele lokale Werkzeuge nutzen. Ein App-Team kann dafür einen kurzen Kompatibilitätsnachweis festhalten: den Build, das Modell, den Rechner, die echte Nutzeranfrage und das Ergebnis. Mit der nächsten Version lässt sich der benötigte Ablauf erneut testen, auch wenn mittlerweile andere Menschen die Laufzeit und die Anwendung betreuen.
Quellen
- Ankündigung zu ggml-org-Versionen und Paketverteilung, 13. November 2026
- llama.cpp 1.0.0, 13. November 2026
- ggml 1.0.0
- Öffentliche C-Header von llama.cpp am Tag 1.0.0
- llama-server-Dokumentation am Tag 1.0.0
- llama-bench-Dokumentation am Tag 1.0.0
Wenn du Update-Entscheidungen, Testnotizen und Modellkonfigurationen durchsuchbar festhalten willst, erstelle ein Konto bei Telli.sh.