Seu computador dá conta das legendas e da locução?
O llama.cpp 0.9.0 acrescenta três recursos de fala. Veja como testar transcrição offline, identificação de falantes e locução com vozes predefinidas no computador que você já tem.
Você tem uma versão preliminar de uma demonstração de produto, uma gravação com dois colegas comentando o vídeo e três falas de locução para refazer. Enviar a gravação a um serviço de transcrição e o roteiro a um serviço de voz é um caminho conhecido. Fazer os dois trabalhos na máquina de edição pode facilitar as revisões, sobretudo se o material precisa permanecer nela. Em troca, quem edita passa a responder pela fila, pelos arquivos dos modelos e pelas verificações de qualidade.
Em 4 de novembro de 2026, o projeto de inferência de código aberto llama.cpp lançou a versão 0.9.0. A versão traz suporte a transcrição offline com NVIDIA Nemotron 3.5 Transcribe, síntese de voz com Chatterbox e vozes predefinidas do Pocket TTS que dispensam uma gravação de referência. As notas descrevem transcrição em 40 idiomas, contexto no prompt e atribuição de falas. Cada mudança tem lugar no mesmo fluxo de edição e exige algo diferente do computador e de quem revisa o resultado. Notas da versão llama.cpp v0.9.0
Se você conheceu o llama.cpp ao tentar executar um chatbot local, o nome pode fazer a novidade parecer mais restrita do que é. O llama.cpp é um ambiente de inferência para arquiteturas compatíveis, com ferramentas para carregar os arquivos de modelo e atender a requisições. A atualização amplia o que passa por esse conjunto de ferramentas. O aplicativo que o integra continua decidindo onde guardar o áudio, como apresentar correções e quando o arquivo está pronto para publicar. Projeto llama.cpp
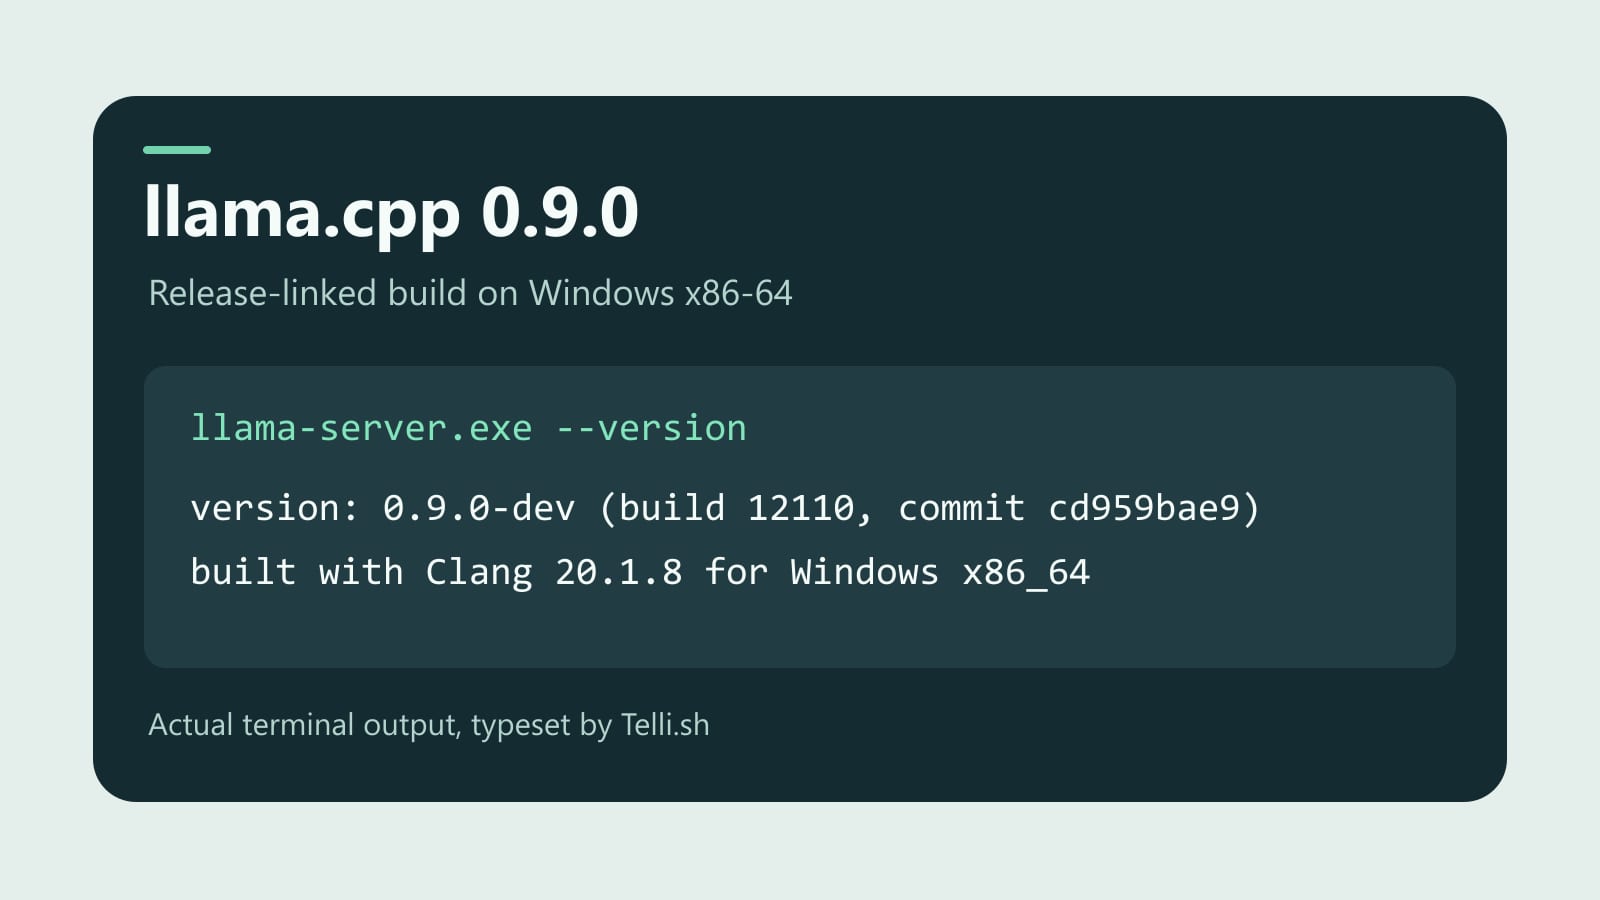
O Telli.sh executou a compilação oficial para Windows indicada no lançamento e apresentou a saída real de versão. Ela confirma a identidade da compilação. Compilação b12110 vinculada à versão
As legendas começam com uma transcrição que pode ser editada
Imagine que um colega grave dez minutos de demonstração de um produto ainda não lançado. Outra pessoa interrompe para corrigir o nome de um recurso. Você quer uma transcrição pesquisável, uma identificação inicial de quem disse o quê e, por fim, legendas no quadro certo. São três resultados distintos. O primeiro é texto, o segundo é anotação editorial e o terceiro exige sincronização.
A integração com o Nemotron permite começar pelos dois primeiros. A implementação integrada aceita transcrição offline com contexto opcional e atribuição de falas. Ela consegue manter informações sobre os falantes entre janelas de processamento da mesma gravação. As notas dos mantenedores registram que marcações de tempo por palavra e processamento em fluxo ficaram fora dessa integração. Na prática, transcreva a gravação completa, corrija o texto e faça a sincronização em uma etapa separada de edição ou legendagem quando o resultado final exigir. Integração do Nemotron 3.5 Transcribe
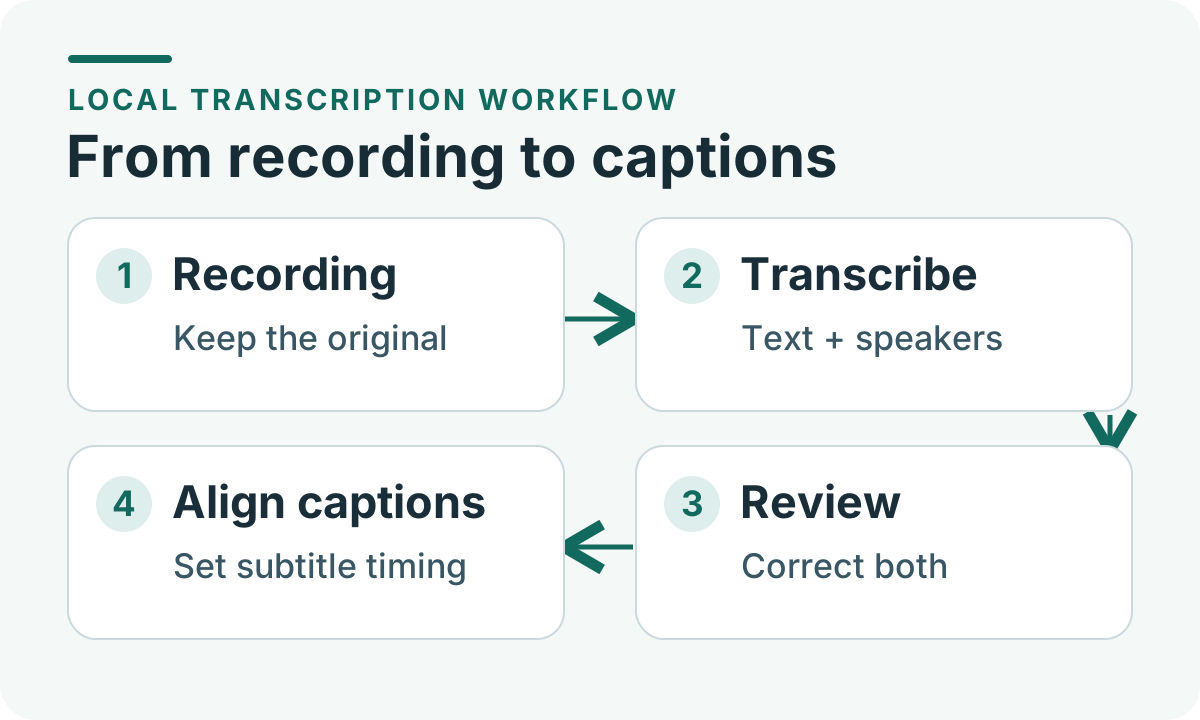
Ilustração do Telli.sh. A transcrição local oferece um texto para editar. Sincronize as legendas depois de conferir o texto e as indicações de quem fala.
O contexto no prompt é especialmente interessante para equipes que usam palavras raras em conversas comuns. Em uma gravação sobre um recurso fictício chamado Pine Relay, experimente uma lista curta de nomes e siglas esperados. Em seguida, rode o mesmo trecho sem a lista. Registre se o contexto corrige o nome, se o insere onde ninguém o disse e se altera números ou outras palavras. Use uma lista curta o bastante para explicar qual entrada afetou o resultado. Um assistente de transcrição deve facilitar a revisão de palavras incomuns, sem deixar que o glossário reescreva a gravação.
A atribuição de falas merece uma verificação própria. Duas pessoas em uma entrevista com áudio limpo podem ser fáceis de distinguir. Acrescente uma terceira no viva-voz e algumas frases simultâneas, e o esforço de correção pode mudar. Ouça as transições e também o trecho mais longo de cada pessoa. A transcrição pode acertar todas as palavras e ainda atribuir uma decisão importante à pessoa errada. Mantenha os rótulos gerados pelo modelo separados dos nomes atribuídos por pessoas até que alguém que conheça a gravação os confirme.
No caso das legendas, confira a exportação junto com o vídeo. Uma frase que parece boa no documento pode ultrapassar os limites da tela, aparecer antes de uma revelação importante ou ficar visível depois que outra pessoa já começou a falar. Teste cedo um corte seco e uma breve interrupção. Se você precisa de arquivos de legenda com marcações confiáveis, inclua a sincronização e a correção no orçamento de tempo. Uma primeira transcrição limpa é útil mesmo que a edição final ainda precise ser montada em outro lugar.
Uma voz predefinida é um bom primeiro teste
Considere agora a outra metade da edição preliminar. O nome de um recurso muda e você precisa trocar uma fala de locução em seis gravações de tela. Gerar uma nova versão localmente torna o experimento barato depois que o modelo e o equipamento estão prontos. Os pontos difíceis são consistência e pronúncia. O novo áudio deve soar natural entre os clipes vizinhos, pronunciar corretamente o nome do produto e caber na tomada.
A versão 0.9.0 inclui o Chatterbox entre os modelos de síntese de voz compatíveis com o llama.cpp. Na revisão do projeto, há registros de execuções com CUDA do Chatterbox Turbo e do Multilingual V3. A pessoa que revisou testou vozes padrão e geração com gravação de referência e anexou amostras dessas execuções. Essa evidência vem da revisão da integração em uma configuração específica. Para um fluxo de produção, a próxima pergunta é se a voz e o idioma escolhidos permanecem consistentes com o texto e o equipamento que serão usados. Suporte ao Chatterbox e amostras de áudio dos mantenedores
O Pocket TTS oferece outra opção. Um modelo compatível pode expor nomes de vozes integradas no campo voices da resposta do servidor a GET /props. O cliente pode enviar um dos nomes à rota de síntese de voz. Assim, um script ou aplicativo pequeno pode preencher um seletor de vozes com as opções do modelo carregado. Também dá para começar o piloto com uma voz predefinida, sem obter e guardar a gravação de uma pessoa para imitar. Registre o modelo e a voz selecionada com a exportação para que uma edição futura possa partir da mesma configuração. Suporte a vozes predefinidas no Pocket TTS
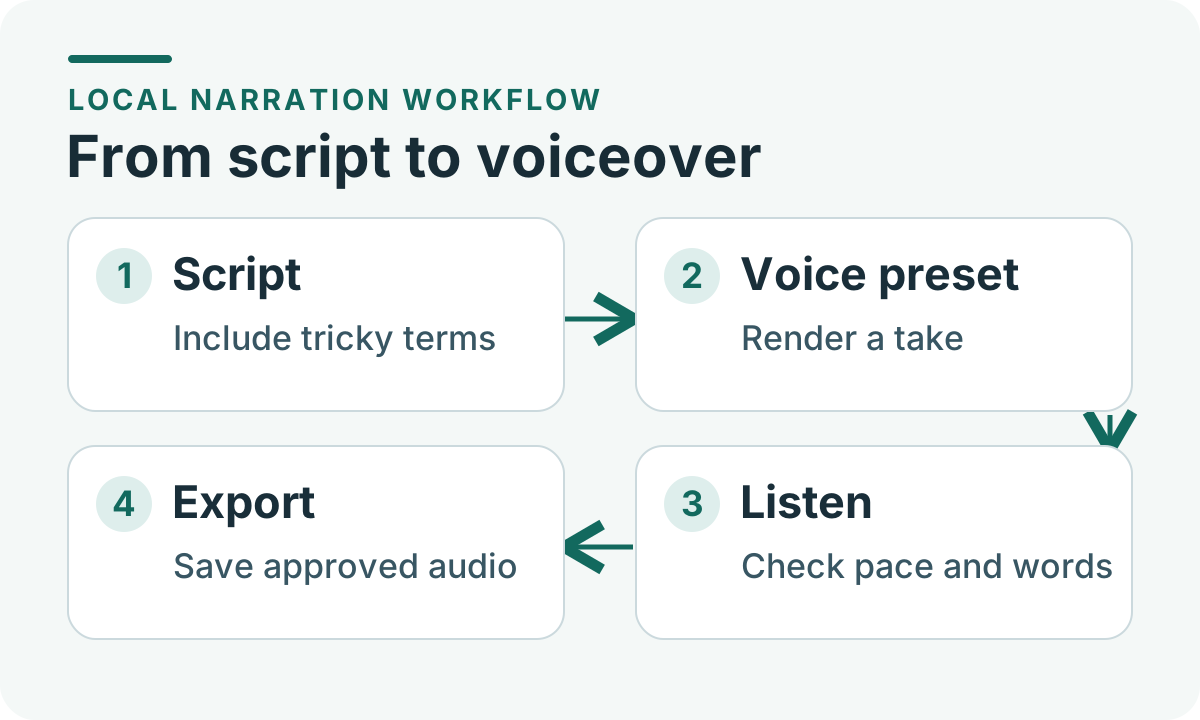
Ilustração do Telli.sh. Ouça o próprio áudio antes de exportar. A voz predefinida indica o que foi pedido. A escuta revela o que saiu.
Comece com um roteiro curto que inclua termos que uma demonstração comum costuma omitir. Inclua um código de produto, um formato de endereço ou um número acompanhado de unidade, além de uma frase cujo tom importe. Teste três falas isoladas e depois gere o parágrafo inteiro. A voz pode soar consistente em frases soltas e passar depressa pela palavra importante em uma leitura mais longa. Peça a alguém que conhece o idioma do público para ouvir primeiro sem o roteiro. Depois, compare o que a pessoa ouviu com o texto pretendido.
Salve o áudio final em separado do roteiro e das gravações de origem. Se mais tarde descobrir que um número saiu errado, você consegue corrigir aquela tomada sem perder a edição original. Em trabalhos de locução que já contam com um profissional autorizado, identifique claramente suas gravações e as alternativas geradas, para evitar que uma substitua a outra sem registro. Uma voz predefinida é uma opção simples quando o projeto precisa apenas de uma fala compreensível e consistente.
A versão do ambiente de inferência é só uma parte da configuração
A atualização pode dispensar a troca de ambiente se a equipe já usa o llama.cpp. Ainda é preciso obter uma compilação compatível com a máquina, os arquivos corretos do modelo e os complementos específicos, como o projetor multimodal citado na implementação do Nemotron. Os pesos são baixados separadamente e têm termos próprios. Consulte a documentação do ambiente e do modelo antes de empacotar qualquer parte para outra equipe ou para um cliente. Arquivos da versão e notas de configuração da integração do Nemotron
Vale medir a memória durante a tarefa, depois que o modelo já carregou. O tamanho do arquivo informa quanto espaço em disco ele ocupa. A execução também precisa de memória para o modelo, os buffers do backend e os dados intermediários. Um computador que inicia a transcrição pode deixar o editor mais lento se os dois usarem a GPU. Um notebook que funciona uma vez pode levar mais tempo na quarta execução, quando refrigeração e tarefas em segundo plano começam a pesar. Registre o pico de RAM e, quando pertinente, de memória da GPU, com o editor aberto na configuração que será usada.
Os mantenedores apresentaram resultados de validação no pull request do Nemotron, com conjuntos de fala limpa e reuniões, uma configuração de quantização especificada e uma RTX PRO 6000 Blackwell no ambiente de teste. Esses resultados ajudam a entender como a integração foi conferida. Para decidir sobre compra ou implantação, meça suas gravações na máquina de destino. Mesmo no mesmo equipamento, mudar a precisão ou o idioma, ou processar mais falas sobrepostas, pode alterar o equilíbrio entre tempo de execução e esforço de revisão. Validação e configuração do Nemotron
Mantenha simples a comparação de versões. A b12144 de 6 de novembro é uma prévia separada que altera a organização de misturas de especialistas no CUDA. Para avaliar os recursos de áudio, comece pela versão numerada de 4 de novembro e mantenha os arquivos de modelo e as configurações. Se avaliar a prévia mais tarde, registre-a como outra execução. Isso ajuda a distinguir mudanças no modelo de áudio, no backend de inferência e no aplicativo que os integra. Notas da prévia de 6 de novembro
Processamento local também exige uma definição precisa do que permanece na máquina. Mesmo que a edição chame um servidor local, outro aplicativo pode enviar logs, sincronizar a pasta de saída ou buscar uma dependência. Antes de introduzir gravações sensíveis, obtenha os binários e pesos em uma máquina de teste ou em uma etapa de instalação definida. Depois, use um clipe sem dados sensíveis e fique offline para observar quais partes do fluxo terminam. Confira onde o arquivo original, os dados temporários e a exportação final são gravados. O ambiente local limita o caminho da inferência, e o restante do aplicativo determina o percurso completo dos dados.
Teste um projeto na máquina que você usa de verdade
- Escolha duas entradas curtas que você possa compartilhar. Grave de 30 a 60 segundos com duas pessoas, alguma sobreposição de falas e o nome de um recurso inventado. Escreva uma locução curta com o mesmo nome e um número difícil de pronunciar. Use as mesmas entradas em todas as rodadas para perceber o efeito de cada ajuste.
- Fixe as versões do ambiente e dos modelos. Escolha o código-fonte da v0.9.0 ou a compilação b12110 vinculada para seu sistema. Registre a origem do modelo, os nomes dos arquivos e a quantização. Para o Nemotron via
llama-server, a integração documenta--reasoning offporque o modelo de conversa padrão pode devolver raciocínio sem transcrição. Segundo as notas, a CLI multimodal não precisa desse parâmetro. Teste o mesmo caminho que pretende operar. Notas da integração do Nemotron - Meça uma execução a frio e repita. Registre o tempo até a saída na primeira rodada e o tempo até o resultado com o modelo já carregado. Na transcrição, divida o tempo de processamento pela duração do áudio para saber se a espera aumenta de forma aceitável em uma gravação longa. Registre o pico de memória e a capacidade de resposta do editor. Para locução, pode importar mais o tempo entre editar uma fala e ouvir a nova versão.
- Compare os erros pelo trabalho que provocam. Marque um termo omitido, um número incorreto, uma troca de falante e uma frase que precisa ser sincronizada de novo. Conte a correção no tempo total. Na locução, confira nomes, números, pausas e o encaixe da nova fala no corte. Uma boa comparação inclui o resultado corrigido, além do primeiro arquivo gerado.
- Defina a passagem de responsabilidade antes de automatizar. Decida quem revisa a transcrição, onde as legendas são sincronizadas e como marcar locuções aprovadas. Teste um segundo trecho depois que o primeiro passar. Se um arquivo falhar, preserve a entrada e mostre o erro na fila para que alguém retome a tarefa sem repetir o lote todo.
Você pode acompanhar essas verificações em quatro colunas de uma planilha: configuração, tempo de processamento, tempo de correção e aceitação. Anote o motivo das rejeições. Depois de alguns testes, talvez descubra que o ambiente local é excelente para refazer locuções, mas que entrevistas em grupo com ruído ainda pedem outro processo. Esse é um resultado útil. Use cada componente onde economiza tempo e registre quando a alternativa funciona melhor.
Se já tem um processo de transcrição confiável, compare usando a mesma gravação e os mesmos critérios de aceitação. Dá para migrar só a parte mais simples, como gerar locuções provisórias de baixo risco na estação de trabalho. Um fluxo confiável de legendagem também pode aproveitar a integração local mais tarde, quando houver motivo para reunir a execução dos modelos e a nova implementação tiver demonstrado atender ao padrão editorial anterior.
Onde a versão é mais útil
O melhor primeiro caso é um trabalho que você já repete. Uma equipe de tutoriais pode transcrever uma tomada preliminar antes de o vídeo sair da estação de edição e gerar locução provisória para conferir o ritmo. Uma pessoa que pesquisa pode criar uma transcrição editável de uma gravação sob seu controle, corrigir a identificação dos falantes e manter o áudio como fonte. Uma equipe pequena de desenvolvimento pode testar os dois caminhos em uma interface interna, desde que ela mostre o modelo escolhido, o arquivo resultante e eventuais erros.
A versão pode ajudar principalmente a reduzir as passagens entre ferramentas especializadas, preservando as verificações de qualidade de cada etapa. O modelo de transcrição ainda precisa reconhecer palavras e distinguir pessoas. O modelo de síntese ainda precisa pronunciar o roteiro. Quem edita ainda decide quando o resultado está pronto. A novidade é que as tarefas podem compartilhar um conjunto de ferramentas de inferência e talvez a própria máquina que você já usa.
Para voltar a uma gravação pronta junto com a transcrição e suas anotações, inicie um envio no Telli.sh.