Liquid LFM3 faz uma pergunta melhor sobre IA local: qual modelo pequeno resolve a tarefa?
LFM3 ramifica uma base comum em modelos de texto, visão, áudio, omni e decisão. Como escolher um especialista, dimensionar a memória real e avaliar uma aplicação local útil.
Um assistente local que lê um recibo não precisa necessariamente do mesmo modelo que responde a uma pergunta falada. Um programa que escolhe entre três ações permitidas tem outro trabalho. Tratar tudo como uma tarefa só pode complicar desnecessariamente uma aplicação pequena.
A Liquid AI anunciou o LFM3 em 27 de outubro de 2026: seis modelos de aproximadamente 2B, derivados de uma base comum de 1.7B, cobrindo texto, visão, áudio, omni e duas variantes de decisão. A empresa oferece pesos abertos, um Playground e acesso por API. Anúncio do LFM3.
A decisão interessante é qual papel cabe na sua aplicação. Este guia explica a família por escolhas práticas, separa um arquivo compacto de pesos de um orçamento real de memória e propõe uma primeira avaliação capaz de revelar se um especialista é útil no seu hardware.
 Hardware Raspberry Pi 5; contexto ilustrativo de computação de borda, não um teste nosso do LFM3. Imagem: RetroEditor, CC BY 4.0; redimensionada com margens. Fonte da imagem · Licença e notas da imagem. Referência oficial do produto.

Uma família de especialistas começa pela saída necessária
A maneira mais rápida de escolher mal é começar pela maior lista de entradas suportadas. Comece pela saída que a aplicação precisa produzir. Um parágrafo, uma transcrição, um campo estruturado e uma escolha entre ações permitidas são contratos diferentes, mesmo quando o mesmo material pode ajudar a produzir os quatro.
O anúncio da Liquid de 27 de outubro identifica quatro ramificações de modalidade e duas de decisão: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B e d1-Omni-2B. A tabela traduz esses papéis em perguntas para escolher uma aplicação. É um guia de adequação, não um ranking independente de qualidade. Descrição da família.
| Papel do modelo | Candidato da família LFM3 | Pergunta para a aplicação |
|---|---|---|
| Interação textual | LFM3-1.7B | A tarefa precisa de uma saída de linguagem a partir de texto? |
| Compreensão de imagem e texto | LFM3-VL-2B | A resposta depende de algo visível? |
| Interação por fala e áudio | LFM3-Audio-2B | A aplicação precisa ouvir ou falar? |
| Interação audiovisual combinada | LFM3-Omni-2B | Precisa interpretar imagem e som juntos? |
| Decisões estruturadas a partir de texto e imagens | d1-2B | O resultado pode ser expresso como decisões tipadas? |
| Decisões estruturadas incluindo áudio | d1-Omni-2B | Uma decisão delimitada também precisa usar som? |
Nossa avaliação: a unidade útil da IA local é o menor trabalho completo. Um modelo deve ter capacidade suficiente para atender a um contrato claro da aplicação e uma forma de lidar com a incerteza. Tudo além disso tem custos de execução, teste e integração que precisam se justificar.
Pense na família como um estojo de ferramentas. Carregar todas faz sentido em alguns trabalhos; para um ajuste repetido, escolher a ferramenta certa pode ser mais simples. A analogia trata do projeto da aplicação, não de uma afirmação de que um modelo sempre supera outro.
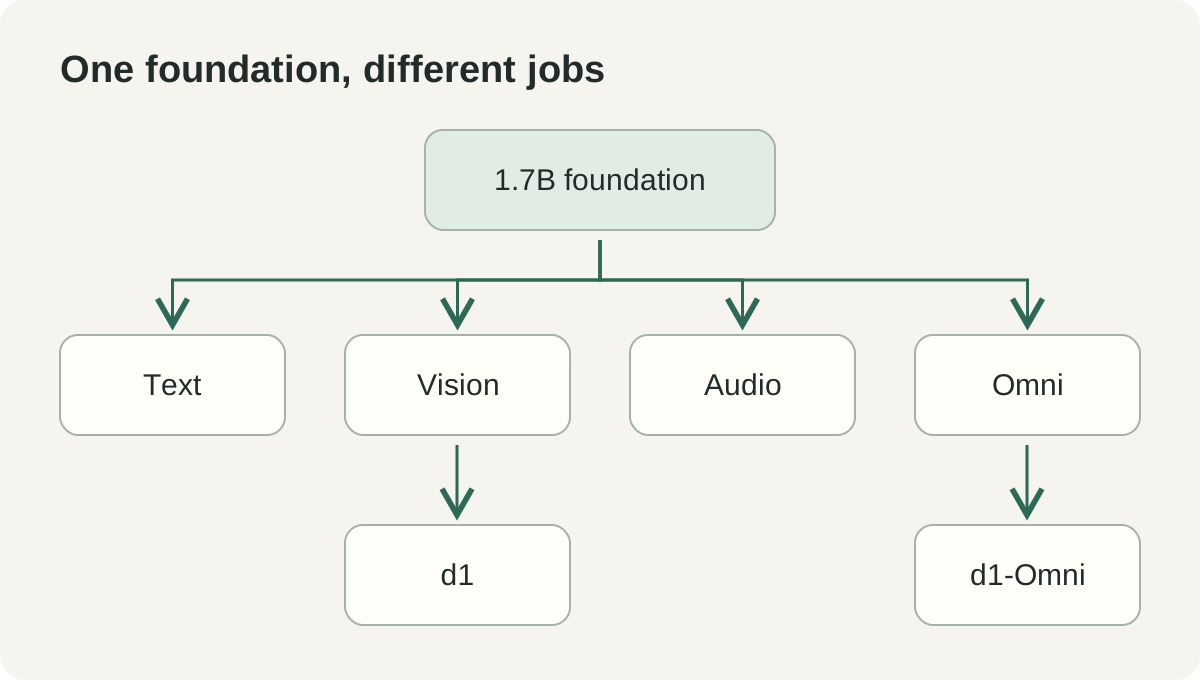 Diagrama explicativo original dos papéis citados no anúncio do LFM3 da Liquid AI. Agrupa escolhas de aplicação e omite detalhes internos de implementação.
Pesos abertos oferecem opções de implantação e uma licença para ler
Baixar pesos dá ao desenvolvedor algo concreto para empacotar, avaliar e adaptar. Pode apoiar uma implantação local em que o caminho dos dados permaneça sob seu controle. Isso é útil, mas a presença de um arquivo para download não resolve suas condições comerciais.
O catálogo de modelos da Liquid, consultado em 2 de novembro, descreve uso comercial gratuito até a empresa ultrapassar US$10 milhões de receita anual. O cartão do LFM3-1.7B identifica a LFM Open License v1.0. Leia a licença do checkpoint exato e a página atual de licenciamento para a implantação, a distribuição e a situação de receita pretendidas.
Essa é uma etapa prática de aquisição. Um protótipo interno pequeno, um aplicativo de consumo para download e um serviço para outras empresas podem levantar questões diferentes de distribuição e obrigações. Registre identificador, revisão e licença do modelo junto à aplicação para que a decisão continue rastreável quando o projeto crescer.
O software de execução e os pesos do modelo também têm versões separadas. Um modelo pode estar disponível enquanto o ambiente no seu dispositivo ainda não oferece suporte compatível. Confira a combinação documentada em vez de supor que toda aplicação capaz de carregar a família anterior consegue carregar corretamente a nova.
Para uma equipe, esse registro deve incluir o prompt ou template esperado pelo checkpoint. Um carregador compatível ainda pode produzir um comportamento ruim se a entrada estiver formatada incorretamente. A reprodutibilidade começa por saber o que foi realmente carregado e como a aplicação se comunicou com ele.
Cerca de 1 GB de pesos é o início do orçamento de memória
A Liquid descreve o tamanho do modelo textual em 4 bits como cerca de 1 GB no lançamento de 27 de outubro. O cartão do modelo textual especifica 1.73 bilhão de parâmetros e contexto de 256K tokens somando entrada e saída. São especificações do modelo; o pico de memória da aplicação também depende da carga e do ambiente de execução.
Um arquivo de pesos é apenas parte de um processo em funcionamento. O ambiente precisa de memória de trabalho; o processamento do contexto precisa de estado; entradas multimídia podem exigir buffers e codificadores adicionais. Outros programas no dispositivo disputam os mesmos recursos. Uma manchete sobre o tamanho dos pesos não diz se a aplicação inteira continuará funcionando confortavelmente sob carga.
Um orçamento ilustrativo deve, portanto, começar pela memória medida do processo. Registre o estado ocioso, o pico durante uma solicitação representativa e o estado depois de solicitações repetidas. Teste o comprimento de contexto e os tamanhos de entrada que os usuários realmente fornecerão, em vez de um prompt minúsculo escolhido por caber facilmente.
A mesma disciplina vale para o tempo. Inicialização, processamento do prompt e geração da resposta são esperas diferentes. Um modelo que produz tokens rapidamente após uma longa pausa pode parecer lento em uma aplicação interativa; uma tarefa em lote pode priorizar itens concluídos por hora. Escolha a medida adequada à interação.
Para um recurso de áudio, inclua todo o caminho da entrada ao resultado utilizável. Para imagens, inclua seu tratamento. Para decisões, inclua validação e encaminhamento da ação. São requisitos de avaliação definidos por você, não números de desempenho fornecidos pelo lançamento.
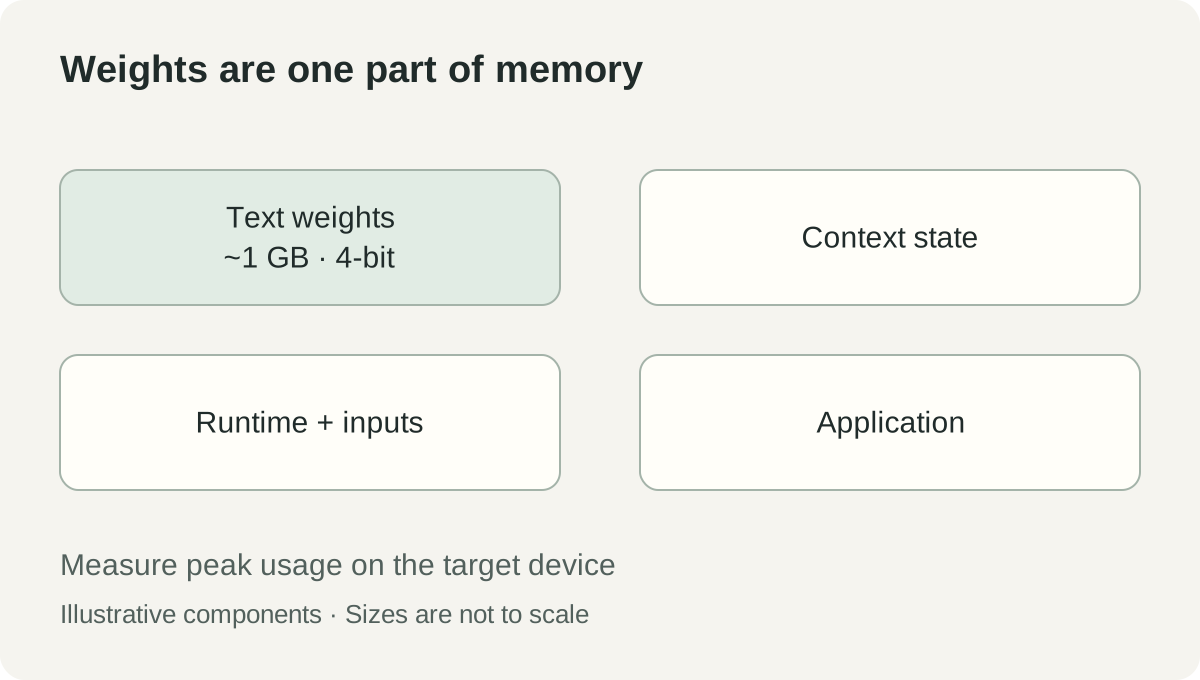 Diagrama original de orçamento de memória. As larguras são ilustrativas e não representam proporções medidas; o valor aproximado de 1 GB refere-se ao tamanho publicado do modelo textual da Liquid em 4 bits, não à memória total da aplicação. Fonte.
Três aplicações ilustrativas expõem escolhas diferentes
Um auxiliar de documentos pode separar leitura e decisão
Imagine uma aplicação para uma pequena empresa que recebe recibos fotografados. Um trabalho é ler estabelecimento, data e valor visíveis. Outro é decidir se o documento está completo o bastante para revisão humana. Essas saídas merecem validações separadas, mesmo que um modelo contribua para ambas.
Um caminho de visão e linguagem poderia responder perguntas sobre a imagem; um caminho de decisão poderia ser avaliado para uma verificação delimitada de completude. A aplicação deve guardar a imagem original e distinguir campos extraídos de dados contábeis aceitos. Uma data ausente deve continuar ausente até que alguém resolva o problema.
Monte um conjunto ilustrativo de avaliação com imagens claras, imagens borradas, layouts incomuns e recibos nos idiomas reais de trabalho. Meça erros por campo e a carga de revisão. Uma alta taxa global de sucesso pode esconder um erro recorrente no campo mais importante para o negócio.
O resultado útil do produto é uma fila de revisão mais curta e clara. A elegância da explicação importa menos do que permitir ao revisor examinar a fonte e corrigir os campos. Essa prioridade ajuda a escolher entre linguagem aberta e uma interface de decisão mais restrita.
Uma interface falada pode começar com poucas ações permitidas
Considere um assistente ilustrativo sem uso das mãos para uma aplicação local. O usuário pode pedir para localizar um item, ler seu status ou preparar uma ação em rascunho. O áudio se torna útil quando falar é mais fácil que digitar, mas a aplicação ainda precisa saber o que uma solicitação pode alterar.
Comece com um vocabulário pequeno de ações e um caminho visível de confirmação. Por exemplo, localizar um registro pode ocorrer imediatamente dentro dos dados autorizados, enquanto uma solicitação que o alteraria pode apresentar uma proposta para revisão. A política pertence à aplicação, não à formulação que o modelo produzir.
Teste as condições acústicas reais. Conversas de fundo, falas curtas e nomes parecidos podem gerar padrões de falha diferentes dos de uma frase gravada com clareza. Inclua casos em que o resultado correto é perguntar novamente. Uma resposta falada fluente vale menos que uma interação correta e recuperável.
Um candidato omni passa a ser relevante quando a solicitação depende do que se vê e do que se diz. Se todas as tarefas usam apenas fala, acrescentar processamento visual precisa de justificativa. É aqui que a abordagem de família pode manter o recurso proporcional ao trabalho.
Uma ferramenta local de suporte pode encaminhar trabalho mantendo uma saída
Uma aplicação ilustrativa de suporte poderia escolher entre três filas usando um ticket e uma captura de tela anexada. Uma saída de decisão delimitada pode se ajustar à tarefa mais diretamente que uma resposta longa a ser interpretada. A pergunta útil é se a rota escolhida é confiável o suficiente com uma taxa aceitável de revisão.
Mantenha um resultado explícito de “precisa de revisão”. Teste tickets que não correspondem a nenhuma fila permitida, capturas contraditórias e casos sem contexto suficiente. A aplicação não deve forçar o modelo a inventar uma rota válida apenas porque o esquema exige uma.
Compare o modelo com uma referência simples, como as regras existentes e o encaminhamento humano. Se a referência já trata uma categoria de forma confiável, o modelo precisa melhorar outra parte do processo. Novidade não é um critério de aceitação.
Para cada erro, preserve contexto autorizado suficiente para entender sua causa. Separe problemas de entrada, categorias ambíguas e erros do modelo. Essa distinção indica se é melhor melhorar o modelo, mudar as definições das filas ou pedir fontes melhores.
Tabelas de benchmarks são um começo para sua própria carga
O cartão oficial do LFM3-1.7B, consultado em 2 de novembro, recomenda recuperação de informação ou busca para trabalhos intensivos em conhecimento e alerta contra programação por agentes e raciocínio complexo de várias etapas nesse porte. É uma orientação útil para posicionar o modelo em um sistema maior, mesmo quando os benchmarks do fornecedor mostram progresso.
Um resultado de benchmark responde a uma pergunta específica sob uma configuração particular. Sua aplicação acrescenta dados, ferramentas, distribuição de idiomas e custos de falha próprios. Um modelo pode melhorar uma média pública e ainda exigir cuidado nas poucas categorias que seus usuários encontram diariamente.
Separe três comparações no piloto. Primeiro, compare a qualidade da tarefa ao processo atual. Segundo, compare o custo completo de recursos no dispositivo pretendido. Terceiro, compare o trabalho para recuperar uma falha. Essas comparações podem apontar vencedores diferentes.
Um generalista na nuvem, por exemplo, pode servir de encaminhamento quando um especialista local não responde. Essa combinação exige uma política de dados e uma experiência de uso explícitas. A operação local é uma escolha de implantação a verificar na aplicação inteira, incluindo registros e solicitações de contingência.
O ajuste fino deve seguir uma lacuna demonstrada. Se as falhas vêm de fontes ausentes ou definições pouco claras da saída, mais treinamento pode reforçar a tarefa errada. Defina o contrato e examine os erros antes de decidir que personalizar é a próxima etapa útil.
Um primeiro piloto deve caber em uma página de decisões
O cartão oficial do modelo textual traz links para formatos de checkpoint e instruções de execução. Comece ali para a combinação exata de modelo e ambiente; use o Playground oficial para uma primeira interação se isso respeitar sua política de dados. Nenhum caminho substitui testar a implantação que você pretende entregar.
- Escreva o contrato de entrada e saída. Declare o material permitido, o resultado esperado e o resultado explícito de revisão. Escolha uma tarefa, não uma persona de assistente geral.
- Escolha o candidato e a revisão. Relacione modalidade e papel da saída e registre checkpoint, licença e ambiente compatível. Leia as limitações específicas.
- Crie um conjunto representativo de avaliação. Inclua casos comuns, difíceis, solicitações não suportadas e exemplos nos idiomas reais dos usuários. Separe o material reservado para avaliação dos dados de personalização.
- Execute o início rápido documentado em ambiente isolado. Siga as instruções atuais de dependências e formatação do cartão. Confirme a identidade retornada do modelo antes de comparar saídas.
- Meça todo o caminho da aplicação. Registre correção, taxa de revisão, latência e pico de memória com tamanhos de entrada realistas. Anote hardware e configurações junto aos números.
- Exercite o caminho da incerteza. Confirme que informações ausentes, saídas inválidas e falhas de execução levam a estados compreensíveis de revisão ou nova tentativa.
- Decida o que especializar depois. Use as categorias recorrentes de erro para escolher entre entradas melhores, regras mais claras, recuperação de informação, ajuste fino ou outro modelo.
Na primeira rodada, a decisão escrita pode ser simples: este candidato serve a esta tarefa, neste dispositivo e com estas condições de revisão. Uma conclusão restrita e reproduzível vale mais que uma afirmação geral de que a IA local está pronta para tudo.
Um modelo pequeno conquista espaço ao concluir um trabalho definido
O LFM3 amplia as opções para desenvolvedores que querem texto, visão, som ou decisões delimitadas perto da aplicação. Sua relevância prática vem da possibilidade de escolher esses papéis e avaliá-los como partes de um produto.
O próximo passo é tornar um trabalho preciso o suficiente para medir qualidade, memória e recuperação. Um especialista se torna útil quando a aplicação inteira pode depender de seu contrato e sabe o que fazer quando ele não consegue responder.
Fontes
- Liquid AI: apresentação do LFM3, 27 de outubro de 2026; consultado em 2 de novembro de 2026.
- Catálogo de modelos da Liquid AI e preços e licenciamento, consultados em 2 de novembro de 2026.
- Cartão oficial do LFM3-1.7B, consultado em 2 de novembro de 2026.
- Cartão oficial do d1-2B, consultado em 2 de novembro de 2026.
Preserve o material por trás de uma decisão
O Telli.sh é uma opção para guardar fontes autorizadas junto às notas que você revisou. Criar um espaço de notas.