Liquid LFM3 stellt die bessere Frage für lokale KI: Welches kleine Modell erledigt die Aufgabe?
LFM3 verzweigt eine gemeinsame Basis in Text-, Bild-, Audio-, Omni- und Entscheidungsmodelle. So wählen Sie Spezialisten, planen realen Speicherbedarf und prüfen lokale Anwendungen.
Ein lokaler Assistent, der einen Beleg liest, braucht nicht unbedingt dasselbe Modell wie einer, der eine gesprochene Frage beantwortet. Ein Programm, das zwischen drei erlaubten Aktionen wählt, hat wiederum eine andere Aufgabe. Alles als eine einzige Aufgabe zu behandeln, kann eine kleine Anwendung unnötig kompliziert machen.
Liquid AI kündigte LFM3 am 27. Oktober 2026 an: sechs Modelle ungefähr der 2B-Klasse auf einer gemeinsamen 1.7B-Basis, darunter Text, Bild, Audio, Omni und zwei Entscheidungsvarianten. Das Unternehmen bietet offene Gewichte, einen Playground und API-Zugang. LFM3-Ankündigung.
Interessant ist, welche Rolle Ihre Anwendung benötigt. Dieser Leitfaden erklärt die Familie anhand praktischer Entscheidungen, trennt eine kompakte Gewichtsdatei von einem realen Arbeitsspeicherbudget und beschreibt eine erste Bewertung, die den Nutzen eines Spezialisten auf Ihrer Hardware zeigen kann.
 Raspberry-Pi-5-Hardware als beispielhafter Edge-Computing-Kontext, nicht unser LFM3-Test. Bild: RetroEditor, CC BY 4.0; mit Rändern skaliert. Bildquelle · Lizenz und Bildhinweise. Offizielle Produktreferenz.

Eine Spezialistenfamilie beginnt mit dem benötigten Ergebnis
Der schnellste Weg zur falschen Wahl beginnt mit der längsten Liste unterstützter Eingaben. Beginnen Sie stattdessen mit dem Ergebnis Ihrer Anwendung. Ein Absatz, ein Transkript, ein strukturiertes Feld und die Wahl einer erlaubten Aktion sind unterschiedliche Verträge, selbst wenn dasselbe Quellenmaterial für alle vier nützlich wäre.
Liquids Ankündigung vom 27. Oktober nennt vier Modalitäts- und zwei Entscheidungszweige: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B und d1-Omni-2B. Die folgende Tabelle übersetzt diese Rollen in Auswahlfragen für Anwendungen. Sie dient der Eignungsprüfung und ist keine unabhängige Qualitätsrangliste. Familienbeschreibung.
| Modellrolle | Kandidat der LFM3-Familie | Frage für Ihre Anwendung |
|---|---|---|
| Textinteraktion | LFM3-1.7B | Braucht die Aufgabe eine sprachliche Ausgabe aus Text? |
| Bild- und Textverständnis | LFM3-VL-2B | Hängt die Antwort von etwas Sichtbarem ab? |
| Sprach- und Audiointeraktion | LFM3-Audio-2B | Muss die Anwendung hören oder sprechen? |
| Kombinierte audiovisuelle Interaktion | LFM3-Omni-2B | Muss sie Bild und Ton gemeinsam interpretieren? |
| Strukturierte Entscheidungen aus Text und Bildern | d1-2B | Lässt sich das Ergebnis als typisierte Entscheidung ausdrücken? |
| Strukturierte Entscheidungen mit Audio | d1-Omni-2B | Muss eine begrenzte Entscheidung auch Klang nutzen? |
Unsere Einschätzung: Die nützliche Einheit lokaler KI ist die kleinste vollständig erledigte Aufgabe. Ein Modell sollte genügend Fähigkeiten für einen klaren Anwendungsvertrag sowie einen Umgang mit Unsicherheit besitzen. Alles darüber hinaus verursacht Laufzeit-, Prüf- und Integrationskosten, die ihren Platz rechtfertigen müssen.
Man kann die Familie als Werkzeugrolle betrachten. Für manche Arbeiten ist es sinnvoll, jedes Werkzeug mitzunehmen; für einen wiederholten Handgriff ist die richtige Auswahl oft einfacher. Der Vergleich betrifft Anwendungsdesign und behauptet nicht, dass ein Modell immer ein anderes schlägt.
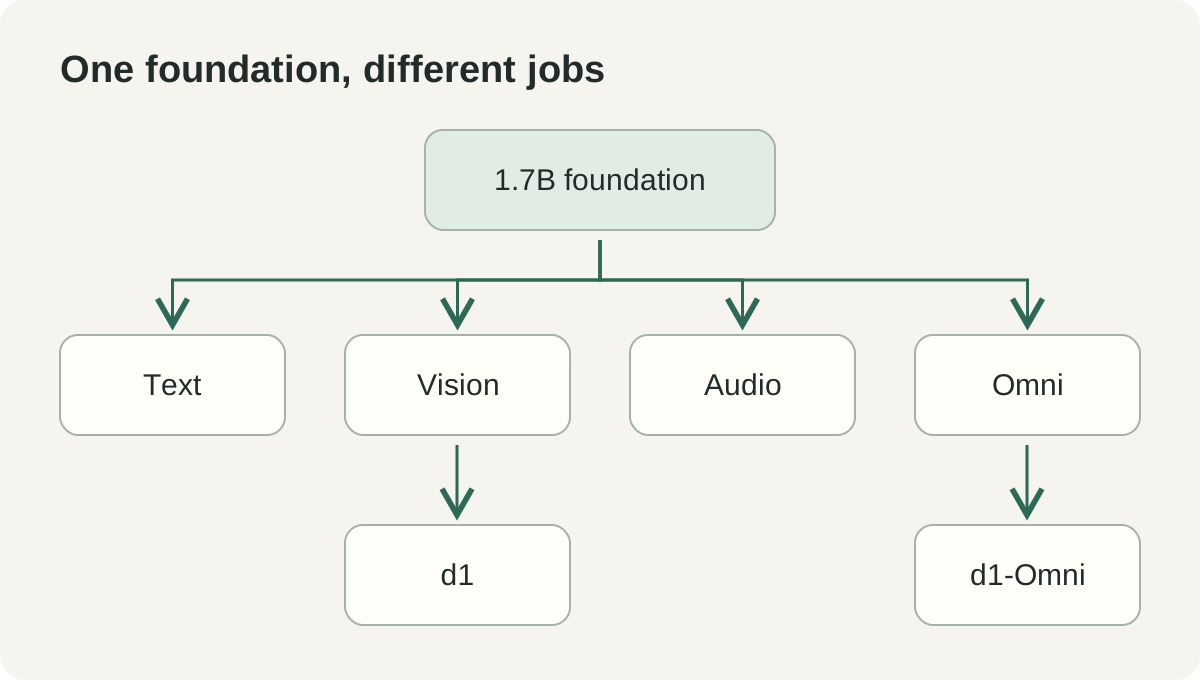 Eigene erklärende Grafik der Rollen aus Liquid AIs LFM3-Ankündigung. Sie gruppiert Anwendungsentscheidungen und lässt interne Implementierungsdetails aus.
Offene Gewichte eröffnen Bereitstellungswege und verlangen Lizenzprüfung
Herunterladbare Gewichte geben Entwicklern etwas Konkretes zum Paketieren, Bewerten und Anpassen. Sie können eine lokale Bereitstellung ermöglichen, bei der der Datenweg unter Entwicklerkontrolle bleibt. Das ist nützlich, klärt aber noch nicht die kommerziellen Bedingungen.
Liquids am 2. November geprüfter Modellkatalog beschreibt kostenlose kommerzielle Nutzung bis zu $10 Millionen Jahresumsatz eines Unternehmens. Die LFM3-1.7B-Modellkarte nennt die LFM Open License v1.0. Lesen Sie die Lizenz des exakten Checkpoints und die aktuelle Lizenzseite für die beabsichtigte Bereitstellung, Verteilung und Umsatzsituation.
Das ist ein praktischer Beschaffungsschritt. Ein kleiner interner Prototyp, eine herunterladbare Verbraucherapp und ein Dienst für andere Unternehmen können unterschiedliche Fragen zur Verteilung und zu Pflichten aufwerfen. Halten Sie Modellkennung, Revision und Lizenz bei der Anwendung fest, damit die Entscheidung bei wachsendem Projekt nachvollziehbar bleibt.
Auch Laufzeitsoftware und Modellgewichte haben getrennte Versionen. Ein Modell kann verfügbar sein, während der Laufzeit auf Ihrem Gerät noch kompatible Unterstützung fehlt. Prüfen Sie die dokumentierte Kombination, statt anzunehmen, dass jede Anwendung für eine frühere Familie auch die neue korrekt lädt.
Für ein Team sollte diese Aufzeichnung auch den vom Checkpoint erwarteten Prompt oder das Template enthalten. Ein kompatibler Loader kann trotzdem schlechtes Verhalten erzeugen, wenn die Eingabe falsch formatiert ist. Reproduzierbarkeit beginnt damit zu wissen, was geladen wurde und wie die Anwendung es ansprach.
Rund 1 GB Gewichte ist erst der Anfang des Speicherbudgets
Liquid beschreibt den 4-Bit-Footprint des Textmodells im Startmaterial vom 27. Oktober als rund 1 GB. Die Textmodellkarte nennt 1.73 Milliarden Parameter und ein 256K-Token-Kontextfenster für Eingabe plus Ausgabe. Das sind Modellspezifikationen; der Spitzenspeicher Ihrer Anwendung hängt auch von Arbeitslast und Laufzeit ab.
Eine Gewichtsdatei ist nur ein Teil eines laufenden Prozesses. Die Laufzeit braucht Arbeitsspeicher, die Kontextverarbeitung Zustand und Multimediaeingaben möglicherweise weitere Puffer und Encoder. Andere Programme konkurrieren um dieselben Ressourcen. Eine Schlagzeile zur Gewichtsgröße verrät nicht, ob die gesamte Anwendung unter Last problemlos arbeitet.
Ein beispielhaftes Budget sollte deshalb mit einem gemessenen Prozess-Footprint beginnen. Erfassen Sie Leerlaufzustand, Spitze während einer repräsentativen Anfrage und Zustand nach wiederholten Anfragen. Testen Sie tatsächliche Kontextlängen und Eingabegrößen der Nutzer, statt einen winzigen Prompt zu wählen, weil er leicht passt.
Dieselbe Disziplin gilt für Zeit. Start, Promptverarbeitung und Antwortgenerierung sind getrennte Wartephasen. Ein Modell, das nach langer Verzögerung schnell Tokens liefert, kann interaktiv langsam wirken; bei Stapelverarbeitung zählen vielleicht eher erledigte Elemente pro Stunde. Wählen Sie das zur Interaktion passende Maß.
Berücksichtigen Sie bei Audio den ganzen Weg von der Eingabe bis zum nutzbaren Ergebnis. Bei Bildfunktionen gehört die Bildverarbeitung dazu, bei Entscheidungen die Validierung und Aktionsübergabe. Das sind von Ihnen festgelegte Bewertungsanforderungen, keine Leistungszahlen der Veröffentlichung.
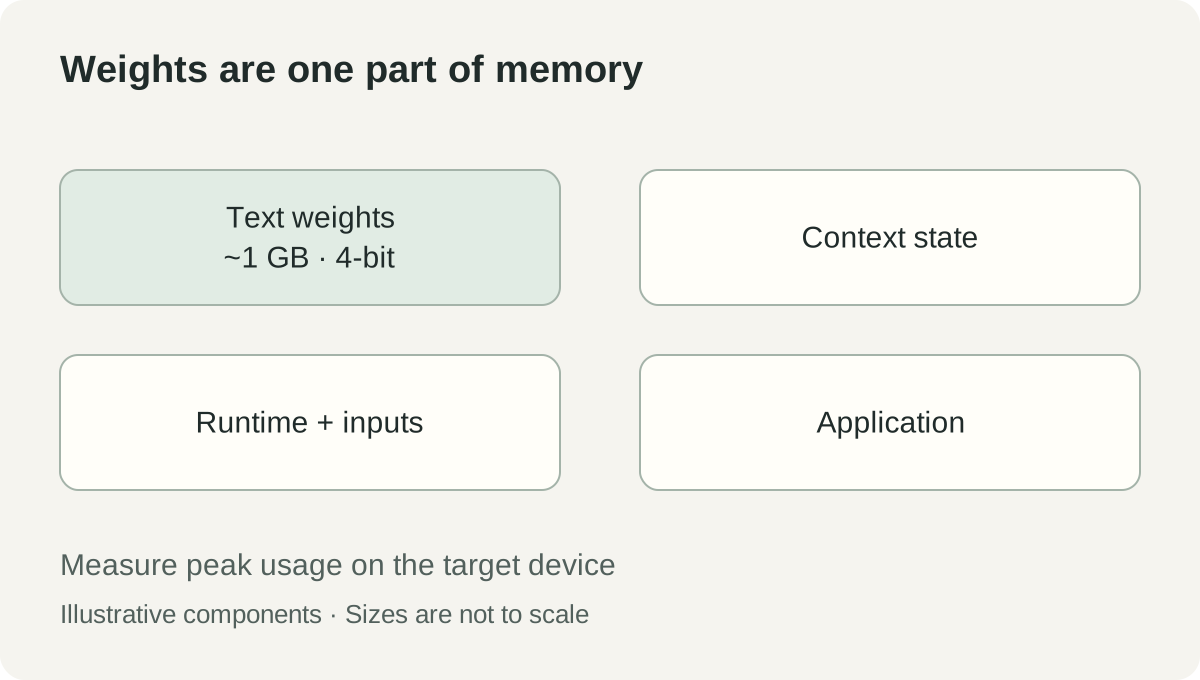 Eigene Speicherbudgetgrafik. Die Segmentbreiten sind beispielhaft und zeigen keine gemessenen Anteile; die rund 1 GB beziehen sich auf Liquids veröffentlichten 4-Bit-Footprint des Textmodells, nicht auf den gesamten Anwendungsspeicher. Quelle.
Drei beispielhafte Anwendungen zeigen verschiedene Abwägungen
Eine Dokumenthilfe kann Lesen und Entscheiden trennen
Stellen Sie sich eine Unternehmensapp vor, die fotografierte Belege empfängt. Eine Aufgabe ist das Lesen von Händler, Datum und Betrag. Eine andere ist die Entscheidung, ob das Dokument für menschliche Prüfung vollständig genug ist. Diese Ausgaben verdienen getrennte Validierung, auch wenn ein Modell zu beiden beiträgt.
Ein Bild-Sprach-Pfad könnte Fragen zum Bild unterstützen; ein Entscheidungspfad ließe sich für eine begrenzte Vollständigkeitsprüfung bewerten. Die Anwendung sollte das Quellbild behalten und extrahierte Felder von akzeptierten Buchhaltungsdaten unterscheiden. Ein fehlendes Datum bleibt fehlend, bis jemand es klärt.
Erstellen Sie ein beispielhaftes Bewertungsset mit klaren und unscharfen Bildern, ungewöhnlichen Layouts und Belegen in den tatsächlichen Arbeitssprachen. Messen Sie Feldfehler und Prüfaufwand. Eine hohe Gesamterfolgsquote kann einen wiederkehrenden Fehler im wichtigsten Geschäftsfeld verbergen.
Das nützliche Produktergebnis ist eine kürzere, klarere Prüfwarteschlange. Eine elegante Erklärung des Modells zählt weniger als die Möglichkeit, die Quelle zu prüfen und Felder zu korrigieren. Diese Priorität hilft bei der Wahl zwischen offener Sprachausgabe und stärker begrenzter Entscheidungsschnittstelle.
Eine Sprachoberfläche kann mit wenigen erlaubten Aktionen beginnen
Nehmen wir einen beispielhaften freihändigen Assistenten für eine lokale Anwendung. Nutzer können einen Eintrag suchen, seinen Status vorlesen lassen oder einen Aktionsentwurf vorbereiten. Audio ist nützlich, wenn Sprechen leichter als Tippen ist; die Anwendung muss weiterhin wissen, was eine Anfrage verändern darf.
Beginnen Sie mit einem kleinen Aktionsvokabular und sichtbarer Bestätigung. Eine Datensatzsuche kann beispielsweise sofort innerhalb autorisierter Daten erfolgen, während eine Datensatzänderung zunächst als Vorschlag zur Prüfung erscheint. Diese Richtlinie gehört der Anwendung, nicht der zufälligen Formulierung des Modells.
Testen Sie tatsächliche akustische Bedingungen. Hintergrundgespräche, kurze Äußerungen und ähnliche Namen erzeugen andere Fehler als ein sauber aufgenommener Satz. Nehmen Sie Fälle auf, in denen erneutes Nachfragen das richtige Ergebnis ist. Eine flüssige gesprochene Antwort ist weniger wertvoll als eine korrekte Interaktion mit Korrekturmöglichkeit.
Ein Omni-Kandidat wird relevant, wenn die Anfrage von Sichtbarem und Gesprochenem abhängt. Verwenden alle Aufgaben nur Sprache, braucht zusätzliche Bildverarbeitung einen Grund. Hier kann der Familienansatz helfen, den Funktionsumfang der Aufgabe anzupassen.
Ein lokales Supportwerkzeug kann Arbeit mit einem Ausweg weiterleiten
Eine beispielhafte Supportapp könnte anhand eines Tickets und Screenshots zwischen drei Warteschlangen wählen. Eine begrenzte Entscheidungsausgabe passt direkter als eine lange Antwort, die die Anwendung erst interpretieren muss. Entscheidend ist, ob die Zuordnung bei akzeptabler Prüfquote zuverlässig genug ist.
Behalten Sie ein ausdrückliches Ergebnis „Prüfung erforderlich“ bei. Testen Sie Tickets ohne passende Kategorie, widersprüchliche Screenshots und unzureichenden Kontext. Die Anwendung sollte das Modell nicht zur Erfindung einer gültigen Zuordnung zwingen, nur weil das Schema eine verlangt.
Vergleichen Sie mit einer einfachen Ausgangslösung, etwa bestehenden Regeln und menschlicher Zuordnung. Bewältigt diese eine Kategorie bereits zuverlässig, muss das Modell einen anderen Teil verbessern. Neuheit ist kein Abnahmekriterium.
Bewahren Sie für jeden Fehler genügend autorisierten Kontext zur Erklärung auf. Trennen Sie Eingabeprobleme, unklare Kategorien und Modellfehler. So erkennen Sie, ob das Modell, die Kategoriedefinitionen oder das Quellenmaterial verbessert werden sollten.
Benchmarktabellen sind der Ausgangspunkt für Ihre eigene Arbeitslast
Die am 2. November geprüfte offizielle LFM3-1.7B-Modellkarte empfiehlt Retrieval oder Suche für wissensintensive Arbeit und warnt bei dieser Größe vor agentischem Programmieren und komplexem mehrstufigem Denken. Das hilft bei der Einordnung in ein größeres System, auch wenn Herstellertabellen Fortschritte zeigen.
Ein Benchmark beantwortet eine bestimmte Frage unter einer bestimmten Konfiguration. Ihre Anwendung ergänzt eigene Daten, Werkzeuge, Sprachverteilung und Fehlerkosten. Ein Modell kann sich im öffentlichen Gesamtwert verbessern und trotzdem sorgfältige Arbeit an den wenigen alltäglichen Nutzerkategorien benötigen.
Trennen Sie im Pilot drei Vergleiche. Vergleichen Sie zuerst Aufgabenqualität mit dem aktuellen Ablauf. Vergleichen Sie dann den vollständigen Ressourcenverbrauch auf dem Zielgerät. Vergleichen Sie schließlich den Aufwand zur Fehlerbehebung. Diese Vergleiche können verschiedene Sieger ergeben.
Ein Cloud-Generalist kann beispielsweise als Eskalationsweg dienen, wenn ein lokaler Spezialist ablehnt. Dafür braucht es eine ausdrückliche Datenrichtlinie und Nutzerführung. Lokaler Betrieb ist eine Bereitstellungsentscheidung, die Sie über die gesamte Anwendung einschließlich Protokollierung und Fallback-Anfragen prüfen.
Fine-Tuning sollte auf eine nachgewiesene Lücke folgen. Entstehen Fehler durch fehlende Quellen oder unklare Ausgabedefinitionen, kann weiteres Training die falsche Aufgabe verstärken. Definieren Sie den Vertrag und untersuchen Sie Fehler, bevor Sie Anpassung als nächsten sinnvollen Schritt wählen.
Ein erster Pilot sollte auf eine Seite Entscheidungen passen
Die offizielle Textmodellkarte verlinkt Checkpointformate und Laufzeitanweisungen. Beginnen Sie dort für die genaue Kombination; nutzen Sie gegebenenfalls den offiziellen Playground für eine erste Interaktionsprüfung, sofern Ihre Datenrichtlinie das erlaubt. Keiner dieser Wege ersetzt die Prüfung der geplanten Auslieferung.
- Schreiben Sie den Ein- und Ausgabevertrag. Benennen Sie erlaubtes Material, erwartetes Ergebnis und ausdrücklichen Prüfausgang. Wählen Sie eine Aufgabe statt einer allgemeinen Assistentenpersönlichkeit.
- Wählen Sie Kandidat und Revision. Passen Sie Modalität und Ausgaberolle an und dokumentieren Sie Checkpoint, Lizenz und kompatible Laufzeit. Lesen Sie modellspezifische Grenzen.
- Erstellen Sie ein repräsentatives Bewertungsset. Berücksichtigen Sie normale und schwierige Fälle, nicht unterstützte Anfragen und tatsächliche Nutzersprachen. Halten Sie Testmaterial von Anpassungsdaten getrennt.
- Führen Sie den dokumentierten Schnellstart isoliert aus. Folgen Sie den aktuellen Abhängigkeits- und Formatierungshinweisen der Modellkarte. Bestätigen Sie vor Vergleichen die zurückgegebene Modellidentität.
- Messen Sie den gesamten Anwendungspfad. Erfassen Sie Richtigkeit, Prüfquote, Latenz und Spitzenspeicher bei realistischen Eingabegrößen. Dokumentieren Sie Hardware und Laufzeiteinstellungen mit den Zahlen.
- Prüfen Sie den Unsicherheitspfad. Fehlende Informationen, ungültige Ausgaben und Laufzeitfehler müssen zu einem verständlichen Prüf- oder Wiederholungszustand führen.
- Entscheiden Sie über die nächste Spezialisierung. Wiederkehrende Fehlerkategorien zeigen, ob bessere Eingaben, klarere Regeln, Retrieval, Fine-Tuning oder ein anderes Modell sinnvoll sind.
Für den ersten Durchgang genügt ein einfaches schriftliches Urteil: Dieser Kandidat hilft bei dieser Aufgabe auf diesem Gerät unter diesen Prüfbedingungen. Ein enges, reproduzierbares Ergebnis ist wertvoller als die allgemeine Behauptung, lokale KI sei für alles bereit.
Ein kleines Modell verdient seinen Platz durch eine definierte Aufgabe
LFM3 erweitert die Auswahl für Entwickler, die Text, Bild, Klang oder begrenzte Entscheidungen nahe an der Anwendung benötigen. Seine praktische Bedeutung liegt darin, zwischen diesen Rollen wählen und sie als Produktbestandteile bewerten zu können.
Der nächste Schritt ist eine ausreichend genaue Aufgabe, bei der sich Qualität, Speicher und Fehlerbehebung messen lassen. Ein Spezialist wird nützlich, wenn die gesamte Anwendung sich auf seinen Vertrag verlassen kann und weiß, was zu tun ist, wenn er nicht antwortet.
Quellen
- Liquid AI: Einführung von LFM3, 27. Oktober 2026; geprüft am 2. November 2026.
- Liquid-AI-Modellkatalog sowie Preise und Lizenzen, geprüft am 2. November 2026.
- Offizielle LFM3-1.7B-Modellkarte, geprüft am 2. November 2026.
- Offizielle d1-2B-Modellkarte, geprüft am 2. November 2026.
Bewahren Sie das Material hinter einer Entscheidung auf
Telli.sh ist eine Möglichkeit, autorisiertes Quellenmaterial zusammen mit bereits geprüften Notizen aufzubewahren. Notizbereich anlegen.