Trinta GPUs em um servidor podem reduzir as filas de IA de um laboratório?
O LIQID UltraStack dá aos modelos placas AMD Instinct MI350P separadas. Compare o teste da fabricante com 20 GPUs à projeção de 30 e meça a espera de quem faz as consultas.
Às nove da manhã, uma equipe de pesquisa começa a extrair texto do material digitalizado no dia anterior. Uma segunda equipe envia notas para tradução, e uma terceira precisa de respostas rápidas sobre o manual de um instrumento. Se todas as tarefas entrarem na mesma fila de inferência, uma pergunta curta pode ficar atrás de um lote grande de documentos. Quando a resposta sair, a pessoa que fez a pergunta talvez já tenha voltado ao PDF.
Em 12 de novembro de 2026, a fornecedora de infraestrutura LIQID descreveu uma configuração do UltraStack que conecta de 4 a 30 aceleradores AMD Instinct MI350P a um único host AMD EPYC 9005 com dois soquetes. Na configuração publicada, cada placa roda uma instância de modelo, de modo que o reconhecimento óptico de caracteres (OCR) pode continuar enquanto outras GPUs cuidam das traduções ou perguntas. A LIQID anunciou uma demonstração na SC26, em Chicago, durante a exposição marcada para 17 a 19 de novembro. Anúncio da LIQID de 12 de novembro e imagens oficiais do sistema · Datas da SC26
A ideia faz sentido quando um laboratório precisa concluir várias tarefas no prazo e cada modelo cabe por inteiro em uma placa. Comece pelo tempo que alguém passa esperando. Pergunte se GPUs separadas eliminariam a parte da espera causada por outra tarefa, qual limite apareceria em seguida e se a melhora justificaria o consumo e o custo. Boa parte disso pode ser testada com uma configuração bem menor do que a completa.
Cada GPU tem 144 GB de memória própria
No arranjo divulgado pela LIQID, o host AMD EPYC se conecta às placas MI350P por uma rede de interconexão PCIe Gen 5. As placas podem ficar em chassis de GPU separados, ligados ao mesmo host. A AMD especifica 144 GB de HBM3E dedicada e interface PCIe 5.0 x16 para cada MI350P. No arranjo com um modelo por placa, cada modelo usa a memória da GPU que recebeu. Uma instância pode atender a várias solicitações, respeitando o limite do software de inferência e da memória de trabalho. Ficha técnica do LIQID UltraStack · Especificações da AMD MI350P
Vinte placas somam 2,88 TB de HBM3E em unidades decimais. Esse valor ajuda a estimar quantas instâncias separadas o sistema pode hospedar. Para uma tarefa na placa número sete, o ponto de partida continua sendo 144 GB. Se seu modelo só couber com os parâmetros e o estado de trabalho divididos entre várias GPUs, avalie uma estratégia de distribuição e meça seu desempenho diretamente. A expansão demonstrada pela LIQID usa instâncias independentes em placas separadas. Configuração do teste e dados de memória da LIQID
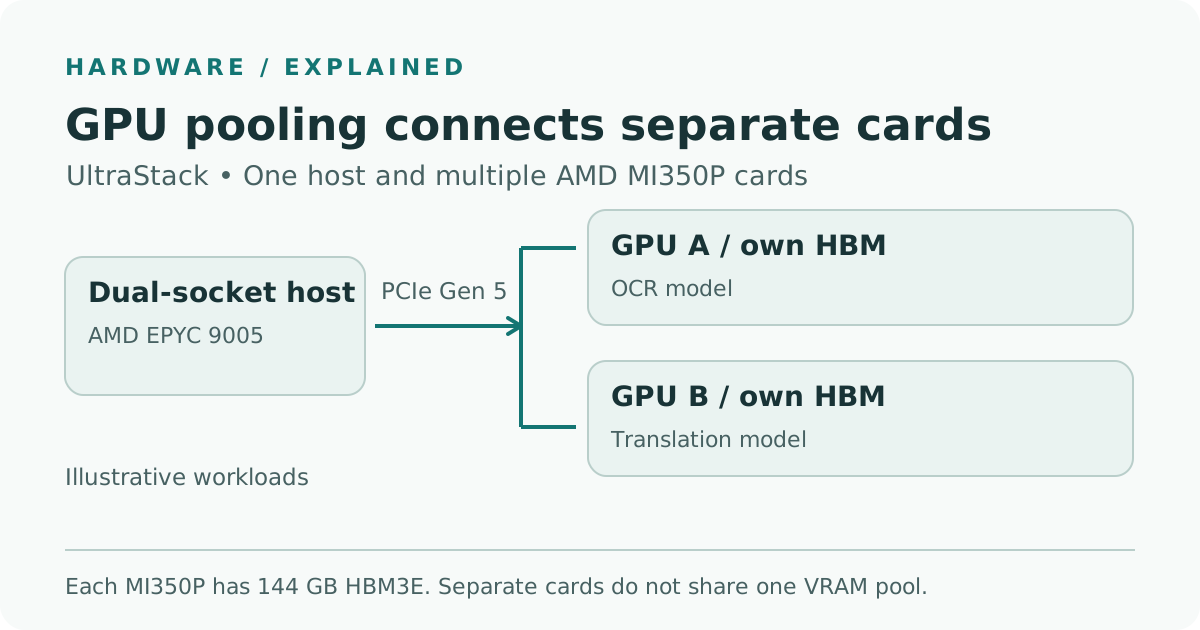
Ilustração do Telli.sh com base na descrição do hardware pela LIQID e nas especificações da AMD. O esquema mostra um exemplo de inferência independente e deixa de fora chassis e periféricos do host.
O número de parâmetros ajuda a restringir as opções, mas dois modelos com a mesma contagem podem exigir volumes diferentes de memória. Comece pelos pesos exatos e pela precisão usada. Reserve espaço para o ambiente de execução e para o cache com que o modelo acompanha os tokens anteriores enquanto gera novos. Se o serviço aceita várias solicitações longas ao mesmo tempo, rode o modelo proposto e observe a memória sob essa carga. Uma entrada curta em uma placa desocupada indica se o serviço inicia. Um teste prolongado com as entradas mais longas aceitas indica se ele consegue continuar recebendo trabalho.
Filas independentes ajudam quando as tarefas chegam em ritmos diferentes
Imagine um arquivo universitário que digitaliza entrevistas e registros em papel. Em um teste, uma GPU pode rodar um modelo de OCR para documentos, outra pode transcrever as entrevistas e uma terceira pode atender a traduções curtas. Depois de uma semana de dados de utilização, uma quarta placa poderia receber uma segunda instância do serviço mais procurado. Dê a cada serviço uma fila e defina quanto trabalho ele pode aceitar de uma vez. Assim, o acúmulo de páginas digitalizadas tem menos chances de atrasar uma tradução curta por disputa pelo mesmo acelerador.
Suponha que o arquivo receba um pedido para traduzir o texto depois do OCR. As etapas podem se sobrepor para documentos diferentes. O primeiro documento pode entrar em tradução enquanto o segundo passa pelo OCR. Para um documento em particular, a tradução ainda depende de seu próprio resultado de OCR. Meça o tempo entre o envio e a obtenção de um resultado utilizável para esse documento, junto com a quantidade concluída em todo o fluxo. Um sistema que processa mais documentos por hora ainda pode deixar um tradutor esperando por uma página.
Para outra combinação, imagine um laboratório de engenharia que usa um assistente de documentos durante o dia e processa registros antigos de instrumentos à noite. O assistente precisa começar a responder em um prazo previsível quando alguém faz uma pergunta. A tarefa noturna tem um prazo para terminar e, em geral, pode tolerar pausas. Meça quanto tempo cada GPU dedica aos serviços antes de reservar uma placa permanente para cada um. Se o assistente passa boa parte do dia ocioso, mas recebe uma enxurrada de pedidos após uma reunião, uma segunda instância reservada tem custo mesmo com pouco tráfego. Uma implantação que já absorve o pico com tarefas programadas ou filas separadas serve de comparação.
A distribuição dos modelos também afeta a recuperação. Um único host simplifica parte da configuração, e todos os serviços nele dependem da mesma máquina. Anote quais tarefas podem esperar depois de uma manutenção, quais precisam voltar primeiro e quais precisam de um segundo local de execução. Em um fluxo de documentos, salve os resultados intermediários para retomar o trabalho após as extrações já concluídas. Para o trabalho interativo, defina um intervalo de indisponibilidade aceitável ou ofereça outro endpoint. O número de placas no host principal representa a capacidade de inferência em operação normal. O tempo de recuperação exige um teste próprio.
A LIQID mediu 89.000 tokens de saída por segundo com 20 GPUs
No relatório de desempenho, a LIQID descreve um modelo da classe de 7 bilhões de parâmetros em precisão FP4, com nível de concorrência informado de 128. Cada GPU executava sua própria instância. No conjunto de 20 placas, a LIQID relatou cerca de 89.000 tokens de saída por segundo. A estimativa de cerca de 133.000 tokens por segundo com 30 GPUs prolonga a curva observada no teste de 20 GPUs. Os dois valores são agregados para a configuração testada ou projetada. Uma pessoa que envia uma solicitação tem seu próprio tempo de fila, de processamento da entrada e de geração da resposta. Relatório de desempenho e metodologia da LIQID
| Teste da LIQID | Número de GPUs | Tokens de saída agregados/s | Evidência |
|---|---|---|---|
| Classe 7B, FP4 | 1 | 4.653 | Medição da LIQID |
| Classe 7B, FP4 | 10 | 44.383 | Medição da LIQID |
| Classe 7B, FP4 | 20 | Cerca de 89.000 | Medição da LIQID |
| Classe 7B, FP4 | 30 | Cerca de 133.000 | Projeção da LIQID a partir de 20 GPUs |
| Classe 72B, FP8, com limites de latência interativa | 8 | 1.256 | Medição separada da LIQID |
O teste separado de 72B em FP8 adotou como meta no máximo dois segundos até o primeiro token no percentil 99 e pelo menos 30 tokens de saída por segundo por usuário. A LIQID relata medições com 2, 4 e 8 placas. O tamanho do modelo, a precisão e as condições de serviço diferem dos do teste de vazão de 7B. Use o resultado interativo como referência para esse tipo de teste e aplique suas metas de latência às solicitações e à concorrência esperadas. Metodologia do benchmark e resultados interativos da LIQID
Os números do 7B dão um bom motivo para repetir o mesmo teste ao acrescentar instâncias idênticas. Para equipes que planejam misturar tarefas, fica uma pergunta mais interessante. E se as solicitações passarem parte do tempo lendo vários arquivos pequenos, reunindo contexto no armazenamento ou esperando a CPU preparar imagens? Reproduza o mesmo tráfego duas vezes com modelos e contagem de GPUs idênticos, primeiro para cada serviço sozinho e depois com todos juntos. Se a operação combinada aumentar o tempo de fila e o uso das GPUs continuar baixo, examine a CPU do host, a atividade do sistema de arquivos e o roteamento das solicitações antes de acrescentar aceleradores.
Meça o trabalho útil dentro de um limite de latência
Comece com um teste que a implantação atual consiga rodar. Por exemplo, use uma amostra representativa de 200 documentos autorizados com idiomas e quantidades de páginas digitalizadas conhecidos e reproduza, em paralelo ao lote, um registro anonimizado dos horários de chegada das solicitações interativas. Mantenha a mesma combinação de entradas nos dois sistemas. Se uma alteração de hardware ou software exigir outra precisão, confira de novo a qualidade dos resultados na mesma amostra. Conte apenas os resultados que chegam ao fim e passam pelas verificações da equipe.
- Defina o que é um bom resultado. Para o assistente, fixe uma meta de primeira resposta e outra de tempo de ponta a ponta. Um exemplo é obter o primeiro token em até dois segundos no percentil 95 da sua amostra interativa. Para a extração em lote, escolha um prazo diário e uma quantidade mínima de páginas que passem pela validação. Esses valores são exemplos para o teste proposto. A LIQID usou o percentil 99 como limite para o primeiro token em seu teste separado de 72B.
- Registre onde cada solicitação passa o tempo. Anote quando chega, quando uma unidade de processamento começa a atendê-la, quando aparece a primeira saída e quando termina. Identifique o tipo de tarefa e registre as novas tentativas. Com esses horários, é possível comparar a espera na fila separadamente do tempo de execução. Um único número de ponta a ponta pode esconder uma fila longa quando a inferência em si dura pouco.
- Mude uma coisa e repita o tráfego. Compare a fila compartilhada com filas separadas enquanto as mesmas instâncias permanecem nas mesmas placas. Teste à parte qualquer mudança na atribuição das placas. Mantenha os limites de entrada e saída, a ordem das entradas e os controles de qualidade. Rode cada teste depois de um aquecimento igual. Confira o período de pico além do tráfego médio. Quando uma tarefa grande chega na pior hora, as filas separadas devem mostrar seu efeito.
- Compare os dados do host e dos medidores com o resultado. Registre o uso e a memória dos aceleradores, a CPU e a RAM do host, a atividade de leitura e gravação e a potência de entrada do sistema na mesma janela. Informe o percentil 95 do tempo de conclusão por tipo de tarefa, o número de páginas ou solicitações bem-sucedidas por hora e a energia por resultado bem-sucedido. Analise descartes e estouros de prazo junto com os percentis, para que o trabalho rejeitado também apareça.
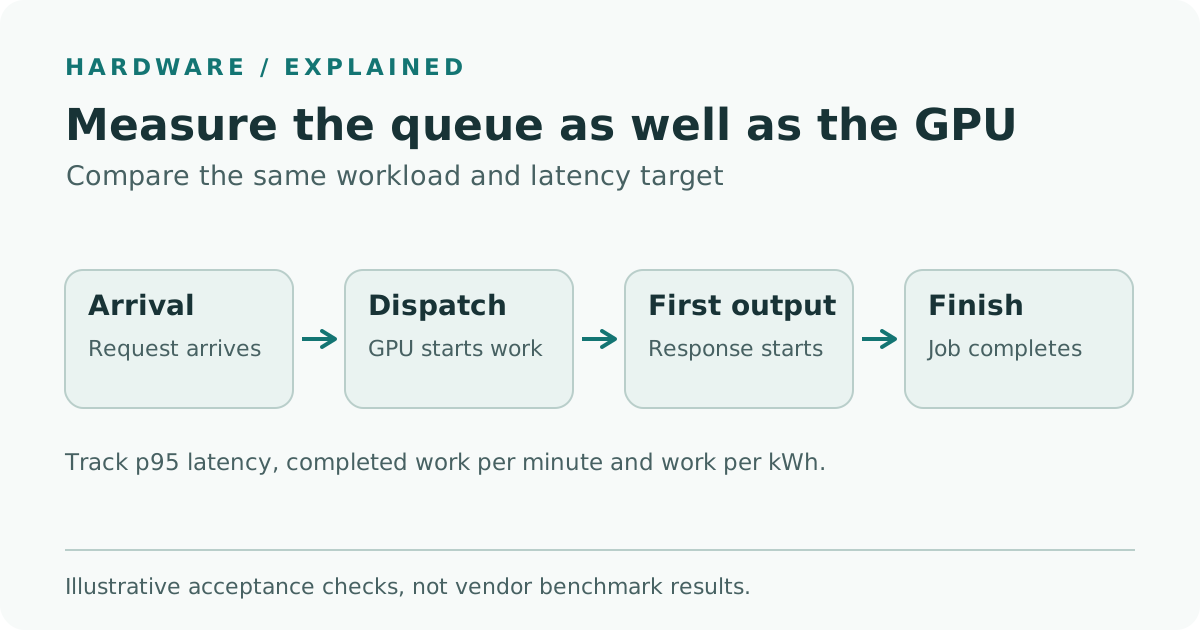
Ilustração do Telli.sh de um teste de aceitação proposto. Mudanças no tempo de fila, de primeira resposta ou de conclusão podem apontar para limites diferentes.
Trace uma distribuição de latência para cada serviço. O p95 é o tempo dentro do qual terminam 95% dos eventos medidos. Ele pode mudar enquanto a mediana fica estável, o que importa se alguém acessa o serviço repetidamente durante o pico. Registre o número de eventos de cada distribuição. Um percentil com base em cinco trabalhos noturnos diz algo diferente de um baseado em centenas de solicitações interativas. Uma queda sustentada no tempo de espera do serviço mais usado, com qualidade comparável e menos estouros de prazo, é uma razão mais forte para reservar uma placa do que o pico de vazão.
A comparação também precisa usar o mesmo perímetro de medição. Para avaliar a eficiência energética, conte os resultados úteis em um intervalo fixo e meça o consumo dos mesmos equipamentos nas duas configurações. Se medir só o servidor e os chassis de GPU, identifique o resultado como energia do sistema de TI. Se armazenamento compartilhado ou refrigeração entrarem na conta, inclua-os com o mesmo critério para os dois projetos. Registre a potência em repouso de um serviço que funciona o dia todo. Uma máquina rápida passa menos minutos em atividade por tarefa. Uma instalação com potência ociosa maior pode gastar mais ao ficar em espera durante a noite.
Os 22 kW precisam entrar na avaliação do local
A LIQID informa cerca de 22 kW para o sistema completo de 30 GPUs refrigerado a ar. A AMD especifica uma potência típica máxima de 600 W por placa MI350P e uma opção configurável de 450 W. Multiplicar 30 por 600 W resulta em 18 kW para as placas, usando esse valor de potência. Os 22 kW divulgados abrangem o sistema. A alimentação elétrica do prédio, a infraestrutura dos racks e a capacidade de refrigeração dependem da instalação. Rodar a 450 W também pode mudar o volume de trabalho útil. Se o fornecedor oferecer os dois ajustes na configuração cotada, compare-os com a mesma carga e os mesmos critérios de qualidade. Orientações de potência do sistema da LIQID · Especificações da AMD MI350P
Envolva a equipe de infraestrutura predial antes de escolher uma configuração maior. Confira o número exato de chassis, a capacidade dos circuitos em condições normais e redundantes, a dissipação de calor nas condições de entrada do ar e se a instalação suporta uma volta repentina à carga plena após reiniciar. Use a cotação para esclarecer quem cuida da manutenção, do suporte e dos ajustes de potência. Compare esses pontos com o custo de uma fila longa de documentos. Mesmo que um único host reduza o número de servidores para administrar, a densidade de potência pode mudar quais salas podem receber o equipamento.
A LIQID anuncia sistemas de 4 a 30 GPUs sob encomenda via parceiros, sujeitos a estoque. A página descreve um fluxo de entrega de 4 a 6 semanas e vincula o prazo anunciado de quatro semanas à confirmação do pedido de compra. Peça uma cotação datada da configuração e um compromisso de entrega para o local de instalação. A empresa informou que sua exposição na SC26 no McCormick Place começaria em 17 de novembro. Orientações da LIQID sobre pedidos e entrega · Anúncio da LIQID para a SC26
Quanta espera vale pagar para eliminar?
Um acelerador dedicado à tradução pode ser um bom investimento quando a equipe seguinte depende de passagens traduzidas na hora. A mesma placa pode ficar parada a maior parte da semana se todas as traduções puderem esperar até amanhã. Comece com a menor configuração que represente as tarefas simultâneas do laboratório e repita o teste no período de maior movimento. Acrescente capacidade onde esperas menores ainda produzem resultados melhores. Para um arquivo, um critério concreto pode ser o técnico receber respostas a tempo e o lote diário passar inteiro pelo scanner antes da troca de turno.
Fontes
- Anúncio da LIQID para a SC26 e imagens oficiais do UltraStack, 12 de novembro de 2026
- Página do LIQID UltraStack com AMD Instinct MI350P, pedidos e ajustes de potência, consultada em 15 de novembro de 2026
- Ficha técnica do LIQID UltraStack, consultada em 15 de novembro de 2026
- Métodos e resultados do benchmark LIQID Phase 3, consultados em 15 de novembro de 2026
- Especificações da placa AMD Instinct MI350P, consultadas em 15 de novembro de 2026
- Calendário oficial da SC26 2026, incluindo as exposições
Para manter notas de testes, gráficos e decisões de implantação em um só lugar pesquisável, crie uma conta no Telli.sh.