Verkürzen 30 GPUs an einem Server die Wartezeit auf KI im Labor?
Mit LIQID UltraStack können Modelle auf eigenen AMD Instinct MI350P laufen. Vergleiche den Test mit 20 GPUs mit der Schätzung für 30 und miss, wie lange Forschende tatsächlich warten.
Um neun Uhr morgens beginnt ein Forschungsteam, Text aus den Scans vom Vortag zu extrahieren. Ein zweites Team reicht Notizen zur Übersetzung ein. Ein drittes möchte schnell eine Antwort aus einem Gerätehandbuch. Teilen sich diese Aufträge eine Inferenzwarteschlange, kann eine kurze Frage hinter einem großen Stapel Dokumente landen. Bis die Antwort eintrifft, hat die Person womöglich schon wieder selbst in der PDF nachgesehen.
Am 12. November 2026 beschrieb der Infrastrukturanbieter LIQID eine UltraStack-Konfiguration, die 4 bis 30 Beschleuniger vom Typ AMD Instinct MI350P an einen AMD EPYC 9005 Host mit zwei Prozessorsockeln anschließt. Im veröffentlichten Betriebskonzept läuft pro Karte eine Modellinstanz. So kann beispielsweise die Texterkennung weiterarbeiten, während andere GPUs Übersetzungen oder Fragen bearbeiten. LIQID kündigte eine Vorführung auf der SC26 in Chicago an, deren Ausstellung für den 17. bis 19. November angesetzt ist. LIQIDs Mitteilung vom 12. November und offizielle Systembilder · Termine der SC26
Das Konzept eignet sich für Labore, in denen mehrere Aufträge pünktlich fertig sein müssen und die Modelle jeweils auf eine Karte passen. Miss zunächst, wie lange jemand auf das Ergebnis wartet. Frage dann, welchen Teil dieser Wartezeit separate GPUs beseitigen können, wo danach der Engpass liegt und ob die Verbesserung Strombedarf und Kosten des Systems rechtfertigt. Das meiste lässt sich schon mit einem Versuch prüfen, der deutlich kleiner ist als der Vollausbau.
Jede GPU hat 144 GB eigenen Speicher
Im veröffentlichten Aufbau verbindet LIQID den AMD EPYC Host über eine PCIe-Gen-5-Verbindungsstruktur mit den MI350P-Karten. Die Karten können in separaten GPU-Gehäusen untergebracht sein, die am Host hängen. AMD gibt je MI350P 144 GB dedizierten HBM3E und eine Schnittstelle vom Typ PCIe 5.0 x16 an. Wenn pro Karte ein Modell läuft, verwendet jede Instanz den Speicher ihrer zugewiesenen GPU. Wie viele Anfragen eine Instanz bearbeiten kann, hängt von der eingesetzten Serversoftware und ihrem Speicherbudget ab. LIQID UltraStack Datenblatt · AMD MI350P Spezifikationen
Zwanzig Karten bringen zusammen 2,88 TB HBM3E in Dezimaleinheiten mit. Mit diesem Wert lässt sich abschätzen, wie viele unabhängige Modellinstanzen das System aufnehmen kann. Für den Auftrag auf Karte sieben bleiben 144 GB der Ausgangspunkt. Wenn ein Modell nur passt, indem du seine Parameter und seinen Arbeitszustand über mehrere GPUs verteilst, prüfe eine passende Verteilungsstrategie und teste sie gesondert. LIQIDs Skalierungswerte beziehen sich auf unabhängige Instanzen auf eigenen Karten. LIQIDs Testaufbau und Speicherangaben
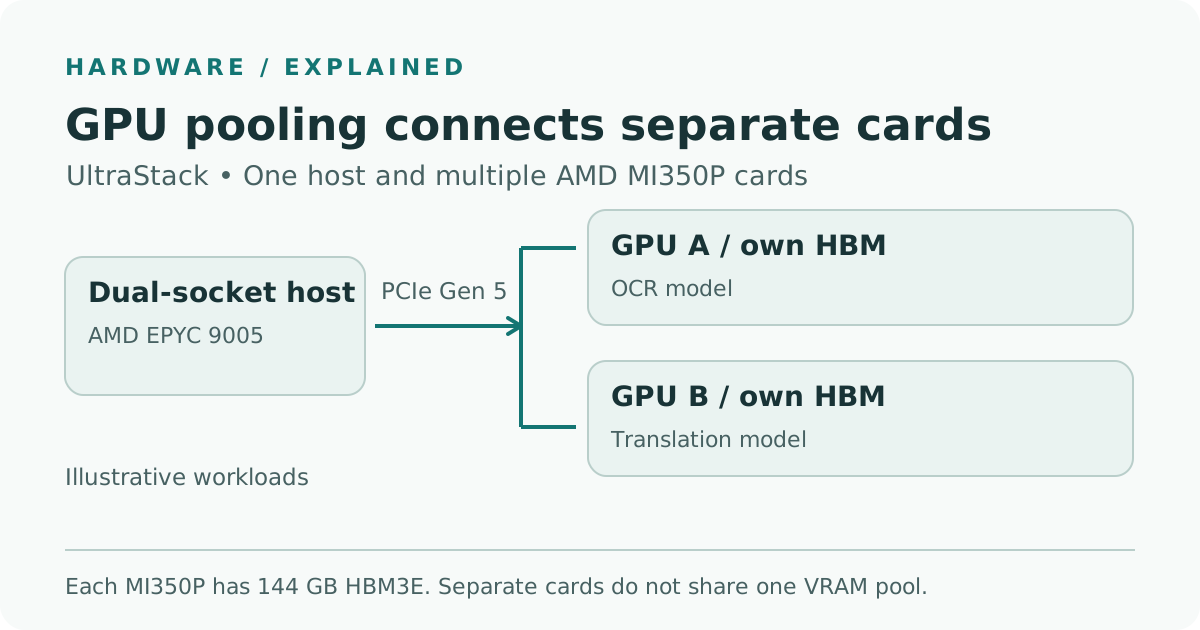
Illustration von Telli.sh nach LIQIDs Hardwarebeschreibung und AMDs Kartenspezifikationen. Das Beispiel zeigt unabhängige Inferenzdienste und lässt Gehäuse sowie Peripherie des Hosts weg.
Die Anzahl der Parameter hilft bei der Vorauswahl. Zwei Modelle mit gleich vielen Parametern können trotzdem unterschiedlich viel Speicher benötigen. Gehe von den konkreten Gewichten und ihrer Präzision aus. Plane Platz für die Laufzeitumgebung und einen möglichen Cache ein, in dem das Modell bei der Ausgabe weitere Informationen zu bisherigen Token vorhält. Wenn ein Dienst mehrere lange Anfragen gleichzeitig annimmt, beobachte den Speicherbedarf des vorgesehenen Modells mit genau diesem Anfragemix. Ein kurzer Prompt auf einer sonst ungenutzten Karte zeigt, ob der Dienst startet. Mit längeren Tests der maximal zugelassenen Eingaben siehst du, ob er weiter Aufträge annehmen kann.
Unabhängige Warteschlangen helfen bei unterschiedlich eintreffenden Aufträgen
Nehmen wir ein Universitätsarchiv, das Interviews und Papierakten digitalisiert. Im Pilotbetrieb kann eine GPU ein Dokumentmodell zur Texterkennung ausführen, eine weitere Interviews transkribieren und eine dritte kurze Übersetzungen bearbeiten. Nach einer Woche Nutzungsdaten könnte eine vierte Karte die zweite Instanz des am stärksten ausgelasteten Dienstes übernehmen. Gib jedem Dienst eine eigene Warteschlange und lege fest, wie viel Arbeit er gleichzeitig annehmen darf. Ein Rückstau bei gescannten Seiten kann eine kurze Übersetzung dann seltener blockieren, weil beide Aufträge um denselben Beschleuniger konkurrieren.
Angenommen, das Archiv soll einen Text zuerst erkennen und anschließend übersetzen. Die Arbeitsschritte unterschiedlicher Dokumente können sich überlappen. Während das erste Dokument übersetzt wird, läuft für das zweite bereits die Texterkennung. Die Übersetzung eines einzelnen Dokuments braucht weiterhin dessen OCR-Ergebnis. Miss daher sowohl die Zeit vom Upload bis zum nutzbaren Ergebnis eines Dokuments als auch die Anzahl abgeschlossener Dokumente in der gesamten Verarbeitungskette. Ein höherer Stundendurchsatz kann für die Person, die auf eine bestimmte Seite wartet, weiterhin mit einer langen Wartezeit einhergehen.
In einem anderen Szenario betreibt ein Ingenieurlabor tagsüber einen Dokumentenassistenten und verarbeitet nachts ältere Geräteprotokolle. Der Assistent soll nach einer Frage innerhalb einer vorhersehbaren Zeit reagieren. Der Nachtauftrag muss bis zu einer Frist fertig sein und kann Unterbrechungen oft verkraften. Miss, wie viel GPU-Zeit die Dienste benötigen, bevor du jedem eine Karte dauerhaft zuweist. Wenn der Assistent tagsüber oft untätig ist und nach einer Laborbesprechung viele Anfragen auf einmal bekommt, verursacht eine dauerhaft reservierte zweite Instanz auch in den ruhigen Stunden Kosten. Als Vergleich eignet sich ein vorhandener Betrieb, der Spitzen mit geplanten Aufträgen oder getrennten Warteschlangen bewältigt.
Die Platzierung der Modelle wirkt sich auch auf die Wiederherstellung aus. Ein einzelner Host kann einen Teil der Konfiguration vereinfachen. Alle Dienste darauf hängen aber vom selben Host ab. Halte fest, welche Aufträge nach der Wartung warten können, welche zuerst zurückkehren müssen und welche einen weiteren Betriebsstandort brauchen. Speichere bei einer Dokumentenstrecke Zwischenergebnisse, damit ein Neustart nach der abgeschlossenen Extraktion fortsetzen kann. Vereinbare für interaktive Vorgänge eine zulässige Ausfallzeit oder stelle einen weiteren Endpunkt bereit. Die Zahl der Karten auf dem Haupthost gibt die Inferenzkapazität im normalen Betrieb an. Die Wiederanlaufzeit musst du gesondert messen.
LIQID maß bei 20 GPUs rund 89.000 ausgegebene Token pro Sekunde
LIQIDs Bericht zum Durchsatz beschreibt ein Modell mit etwa 7 Milliarden Parametern in FP4-Präzision bei einer angegebenen Parallelität von 128. Jede GPU bediente Anfragen mit ihrer eigenen Instanz. Über alle Karten hinweg meldete LIQID bei 20 GPUs rund 89.000 ausgegebene Token pro Sekunde. Die Schätzung von rund 133.000 ausgegebenen Token pro Sekunde bei 30 GPUs schreibt die im 20-GPU-Test beobachtete Skalierung fort. Beide Zahlen sind Gesamtwerte für den gemessenen beziehungsweise hochgerechneten Aufbau. Für eine einzelne Forschungsanfrage zählen ihre eigene Wartezeit, die Verarbeitung der Eingabe und die Geschwindigkeit der Ausgabe. LIQIDs Durchsatzbericht und Testmethodik
| LIQID-Test | Anzahl GPUs | Gesamtausgabe in Token/s | Nachweis |
|---|---|---|---|
| Rund 7 Mrd. Parameter, FP4 | 1 | 4.653 | Messung von LIQID |
| Rund 7 Mrd. Parameter, FP4 | 10 | 44.383 | Messung von LIQID |
| Rund 7 Mrd. Parameter, FP4 | 20 | Rund 89.000 | Messung von LIQID |
| Rund 7 Mrd. Parameter, FP4 | 30 | Rund 133.000 | LIQID-Hochrechnung aus dem Test mit 20 GPUs |
| Rund 72 Mrd. Parameter, FP8, Latenzvorgaben für interaktive Nutzung | 8 | 1.256 | Separate Messung von LIQID |
Im separaten FP8-Test mit rund 72 Milliarden Parametern waren höchstens zwei Sekunden bis zum ersten Token im 99. Perzentil und mindestens 30 ausgegebene Token pro Sekunde und Nutzer vorgegeben. Für dieses Experiment meldet LIQID Messwerte mit 2, 4 und 8 Karten. Modellgröße, Präzision und Betriebsbedingungen unterscheiden sich vom Durchsatztest mit rund 7 Milliarden Parametern. Nutze das interaktive Ergebnis als Anhaltspunkt für diese Testklasse und lege dann anhand der erwarteten Prompts und Parallelität eigene Latenzziele fest. LIQIDs Testmethodik und Ergebnisse für interaktive Anfragen
Die Zahlen des kleineren Modells sprechen dafür, denselben Test beim Hinzufügen identischer Instanzen zu wiederholen. Für gemischte Auslastung bleibt eine andere Frage offen. Was passiert, wenn Anfragen viele kleine Dateien lesen, Kontext aus dem Speicher zusammensetzen oder auf die Bildaufbereitung durch eine CPU warten? Spiele denselben Anfrageverlauf bei unveränderten Modellen und gleicher Kartenanzahl zweimal ab. Teste erst jeden Dienst für sich und danach den gesamten Mix. Wenn der Mischbetrieb längere Warteschlangen verursacht und die GPU-Auslastung niedrig bleibt, untersuche Host-CPU, Dateisystemaktivität und Weiterleitung der Anfragen, bevor du weitere Beschleuniger einbaust.
Miss verwertbare Ergebnisse unter einer Latenzvorgabe
Beginne mit einem Test, den deine bestehende Umgebung ausführen kann. Verwende beispielsweise 200 repräsentative, für den Test freigegebene Dokumente, deren Sprachen und Anzahl gescannter Seiten bekannt sind. Spiele daneben die Eingangszeiten interaktiver Anfragen aus einem anonymisierten Protokoll nach. Verwende auf beiden Systemen denselben Eingabemix. Wenn eine Hard- oder Softwareänderung eine andere Präzision erzwingt, prüfe die Ergebnisqualität mit derselben Stichprobe erneut. Zähle nur abgeschlossene Ergebnisse, die eure üblichen Prüfungen bestehen.
- Lege fest, wann ein Ergebnis gut ist. Gib für den Assistenten eine Zielzeit für die erste Reaktion und den gesamten Vorgang vor. Für deine interaktive Stichprobe könnte das erste Token zum Beispiel im 95. Perzentil nach höchstens zwei Sekunden eintreffen. Für die Stapelverarbeitung kannst du eine tägliche Frist und eine Mindestzahl an erfolgreich geprüften Seiten festlegen. Das sind Beispielvorgaben für diesen Versuch. LIQID verwendete die Grenze im 99. Perzentil im separaten Experiment mit rund 72 Milliarden Parametern.
- Erfasse die einzelnen Zeiten je Anfrage. Protokolliere Eingang, Start auf einem Worker, erste Ausgabe und Abschluss. Kennzeichne den Auftragstyp und erfasse Wiederholungen. Mit diesen Zeitstempeln kannst du die Wartezeit getrennt von der aktiven Verarbeitung vergleichen. Eine kurze Inferenz kann in der Gesamtzeit verschleiern, wie viel davon auf die Warteschlange entfällt.
- Ändere eine Sache und spiele die Anfragen erneut ab. Vergleiche gemeinsame und separate Warteschlangen bei identischen Modellinstanzen auf denselben Karten. Teste jede geplante Änderung der Kartenzuordnung gesondert. Halte Grenzen für Prompts und Ausgabe, Eingabereihenfolge und Qualitätsprüfungen konstant und beginne jeweils nach derselben Aufwärmphase. Prüfe die Spitzenzeit ebenso wie den durchschnittlichen Betrieb. Wenn genau zur falschen Zeit ein großer Auftrag eingeht, zeigt sich der Effekt getrennter Warteschlangen.
- Prüfe neben dem Ergebnis den Host und die Strommessung. Halte für dasselbe Zeitfenster die Auslastung und den Speicher der Beschleuniger, CPU und Arbeitsspeicher des Hosts, Lese- und Schreibvorgänge sowie die Leistungsaufnahme des Systems fest. Gib für jeden Auftragstyp die Abschlusszeit im 95. Perzentil, erfolgreiche Seiten oder Anfragen pro Stunde und Energie je verwertbarem Ergebnis an. Prüfe verworfene Aufträge und Zeitüberschreitungen neben den Perzentilen, damit abgelehnte Arbeit sichtbar bleibt.
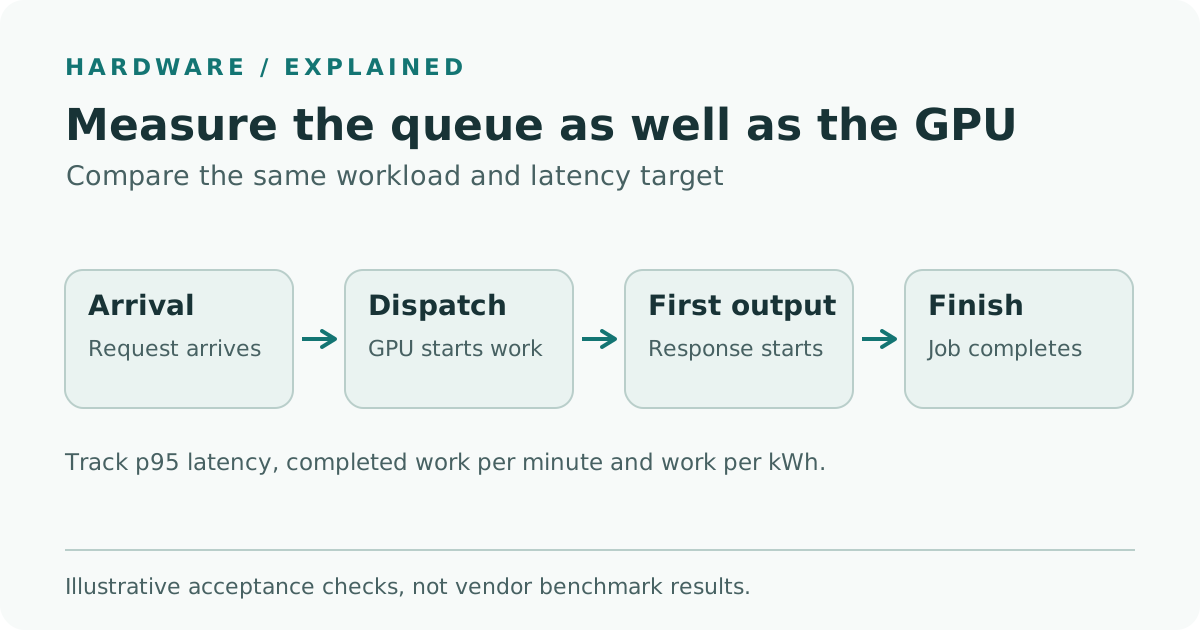
Illustration von Telli.sh für einen möglichen Abnahmetest. Änderungen bei Wartezeit, erster Antwort und Abschlusszeit können auf unterschiedliche Engpässe hindeuten.
Zeichne die Latenzverteilung jedes Dienstes separat. P95 ist die Zeit, in der 95 Prozent der gemessenen Vorgänge abgeschlossen sind. Dieser Wert kann steigen oder sinken, während der Median gleich bleibt. Für Personen, die den Dienst regelmäßig während der Lastspitze verwenden, ist das relevant. Notiere die Anzahl der Fälle für jede Verteilung. Ein Perzentil aus fünf Nachtaufträgen hat eine andere Aussagekraft als eines aus Hunderten interaktiven Anfragen. Verkürzt sich die Wartezeit des belasteten Dienstes dauerhaft bei ähnlicher Qualität und weniger Zeitüberschreitungen, spricht das stärker für eine eigene Karte als der Spitzendurchsatz.
Vergleiche außerdem dieselben Teile des Systems. Für den Energievergleich zählst du verwertbare Ausgaben in einem festgelegten Zeitraum und misst in beiden Aufbauten dieselben Geräte. Erfasst du nur den Server und die GPU-Gehäuse, bezeichne die Messung ausdrücklich als Energieverbrauch des IT-Systems. Wenn gemeinsame Speicher oder Kühlung einbezogen werden, berücksichtige sie auf beiden Seiten nach derselben Methode. Halte bei einem Dienst im Dauerbetrieb auch die Leistungsaufnahme im Leerlauf fest. Ein schnelleres System arbeitet pro Auftrag kürzer. Wenn es nachts mit höherer Leistungsaufnahme wartet, kann es über den ganzen Tag mehr Energie verbrauchen.
Die Angabe von 22 kW gehört in die Standortprüfung
LIQID nennt rund 22 kW für das luftgekühlte System mit 30 GPUs. AMD gibt bei der MI350P maximal 600 W typische Kartenleistung sowie eine konfigurierbare Stufe von 450 W an. Bei 30 Karten zu je 600 W ergibt sich für die Karten ein Wert von 18 kW. Die angegebenen 22 kW gelten für das Gesamtsystem. Strombedarf des Standorts, Rack-Versorgung und Kühlkapazität hängen von der Installation ab. Der Betrieb bei 450 W kann auch den nutzbaren Durchsatz verändern. Vergleiche beide Einstellungen mit derselben Last und denselben Qualitätsanforderungen, sofern der Anbieter sie für die angebotene Konfiguration unterstützt. LIQIDs Hinweise zur Systemleistung · AMDs MI350P-Kartenspezifikationen
Beziehe das Gebäudeteam ein, bevor du dich für einen größeren Aufbau entscheidest. Kläre die genaue Gehäusezahl, die Stromkreiskapazität im Normal- und Redundanzbetrieb und die Wärmeabfuhr unter den vorgesehenen Zuluftbedingungen. Prüfe, ob der Standort eine plötzliche Rückkehr zur Volllast nach einem Neustart verkraftet. Leite aus dem Angebot ab, wer für Service, Support und Leistungsanpassungen zuständig ist. Stelle diese Anforderungen den Kosten langer Dokumentwarteschlangen gegenüber. Ein Host kann die Zahl zu verwaltender Server verringern. Seine Leistungsdichte kann trotzdem die Auswahl möglicher Räume einschränken.
LIQID bewirbt Systeme mit 4 bis 30 GPUs zur Bestellung über Partner, vorbehaltlich der Verfügbarkeit. Auf der Produktseite beschreibt der Anbieter einen Lieferablauf von vier bis sechs Wochen. Die ebenfalls genannten vier Wochen gelten laut Hersteller ab bestätigter Bestellung. Frage nach einem datierten Konfigurationsangebot und einer Lieferzusage für deinen Standort. Für die SC26 nennt LIQID als Ausstellungsort McCormick Place ab dem 17. November. LIQIDs Hinweise zu Bestellung und Lieferung über Partner · LIQIDs Ankündigung zur SC26
Für wie viel weniger Wartezeit lohnt sich die Ausgabe?
Eine eigene Karte für Übersetzungen kann sich lohnen, wenn das nächste Team die übersetzten Passagen sofort braucht. Haben alle Übersetzungen bis zum nächsten Tag Zeit, könnte dieselbe Karte große Teile der Woche ungenutzt bleiben. Beginne mit dem kleinsten Aufbau, der gleichzeitige Aufträge in deinem Labor abbildet, und spiele die Spitzenzeit mehrfach nach. Erweitere dort, wo kürzere Wartezeiten noch zu einem besseren Ergebnis führen. Für ein Archiv kann die Abnahme so konkret sein, dass ein Mitarbeiter rechtzeitig Antworten bekommt und der Scanner seinen ganzen Tagesstapel trotzdem bis zur Übergabe verarbeitet.
Quellen
- LIQIDs Ankündigung zur SC26 mit offiziellen UltraStack-Bildern vom 12. November 2026
- LIQID UltraStack mit AMD Instinct MI350P, Produktseite mit Bestell- und Leistungsangaben, abgerufen am 15. November 2026
- LIQID UltraStack Datenblatt, abgerufen am 15. November 2026
- LIQIDs Testmethoden und Ergebnisse aus Phase 3, abgerufen am 15. November 2026
- AMDs Spezifikationen der Instinct MI350P, abgerufen am 15. November 2026
- Offizielle Termine der SC26 für Konferenz und Ausstellung 2026
Wenn du Testnotizen, Diagramme und Entscheidungen zum Betrieb an einem durchsuchbaren Ort sammeln möchtest, erstelle ein Konto bei Telli.sh.