机器人正在移动时,你能改指令吗?
LeRobot 0.7 加入交互式执行。看看如何给运行中的机器人改指令,区分视觉回答与实体动作,并设计更安全的试验。
机器人正在分拣泡沫块,红色箱子装满了,夹爪里已经夹着下一块。好用的操作界面应该让人可以改变下一步动作,问摄像头看到了什么,或者中断运行。夹爪拿着东西时,这三种操作会带来不同的结果。
11 月 5 日,Hugging Face 发布了 LeRobot 0.7.0。这套开源工具可收集机器人示范数据、训练策略,并在实体设备上运行。交互式执行会保留机器人连接和加载好的策略,让操作人员从终端发出新指令。兼容的策略或外部规划器也能解读场景,决定下一个子任务。同一版本还改进了数据集流式读取、训练和远程推理。其中值得细看的是实时控制,它改变了实验做到一半时,操作人员还能做什么。LeRobot 发布公告 · v0.7.0 版本发布
以下是可以用来规划小规模试验的工作台场景。每个场景都将模型收到的请求、控制器实际发送的动作和事后观察到的结果分开。
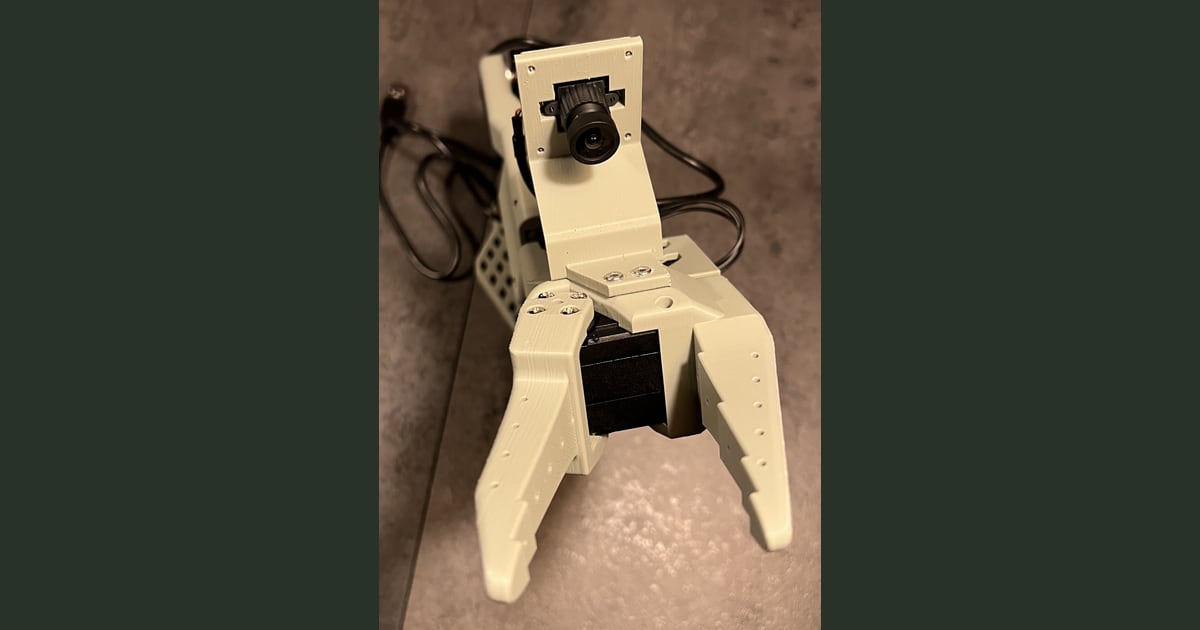
The Robot Studio 拍摄的 SO-101 腕部摄像头支架。图中是这种硬件支持的一种安装位置,图片来自SO-ARM100 项目,按 Apache 2.0 许可使用。Telli.sh 调整了图片尺寸并添加留白。

三条命令对应三种操作目的
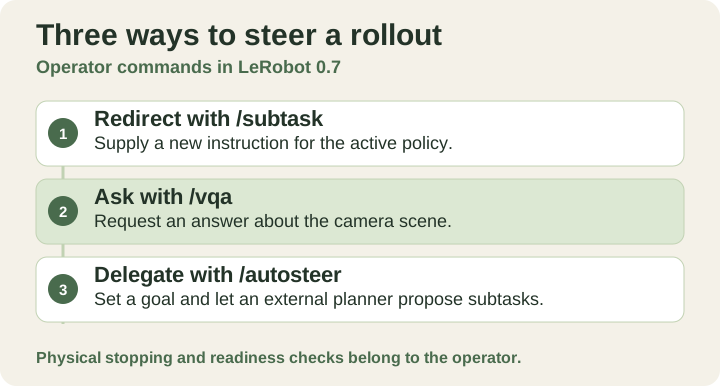
交互命令及各自的作用。Telli.sh 原创图解。
一次执行,也称 rollout,是策略不断接收观测并输出动作的运行会话。观测可能包括摄像头图像和测得的关节位置。0.7 版中,将 --interactive=true 加到已配置的 lerobot-rollout 会话,发出下一条指令前可保留机器人连接、策略权重和处理组件。发布公告列出了五条终端命令,除了开始的 /start 和结束的 /stop,还有三种在会话中途改变指令或提问的方式。LeRobot 发布公告 · v0.7.0 执行文档
| 终端命令 | 操作人员的意图 | 要观察的结果 |
|---|---|---|
/subtask | 替换动作策略收到的指令 | 接下来可见的动作指向新目标,或允许操作人员介入 |
/vqa | 询问机器人看到了什么 | 系统返回可与现场情况核对的答案 |
/autosteer | 委派一个目标,让系统选择子任务 | 系统选择子任务,操作人员可以重新接管 |
LeRobot 公告将 FineART-VLA 和 Wall-OSS-0.5 列为能够生成文本、因而支持提问和委派目标的策略示例。如果动作策略不能生成文字,也可由兼容的外部视觉语言模型补上这项能力。公告介绍了使用 OpenAI 兼容 API 接入规划器的方式,既可本地运行,也可使用托管服务。外部规划器可以回答视觉问题并将指令交给策略,动作策略负责把子任务转成机器人的动作。交互式执行和外部规划器 · v0.7.0 执行文档
在摆满东西的工作台上,这个区别很容易看到。如果摄像头拍不到容器的边缘,关于容器的回答再流畅,证据也有限。如果规划器正确选中了蓝色泡沫块,却从夹爪里滑落,语言层完成了工作,实体操作仍告失败。把问题、策略动作和结果分开,有助于判断该移动摄像头、改写指令,还是改善抓取。
把任务控制得足够小,再在中途换目标
设想工作台上有两个不同颜色的箱子、三块软泡沫和一台受支持的机械臂。从拿起红色泡沫块这类熟悉任务开始,再选一个策略已在类似条件下成功操作过的目标。第一次在接触物体前改指令。操作人员确认切换生效后,从新的初始状态重来,在动作更靠后的时刻改指令。在机械臂移动时发指令,与夹爪闭合后再发指令,给策略提出的是两种不同的要求。
观察机械臂第一次转向新目标的动作,以及泡沫块最后停在哪里。视频时间戳能标出肉眼可见的转向时间,终端时间戳则标出键入指令的时刻。两者都记录,便能解释延迟,包括软件已接受输入但动作变化很难看出的情况。事先定好停止条件,就不用无限期等待可能不会发生的纠正。
另一个例子是在试验后把工作台恢复原状。先只把一个物体放错位置,问系统桌上还剩什么。要求清理之前,分别测试无遮挡和有遮挡的视角。视觉回答随摄像头角度而变时,就有理由重新布置场景或缩小目标范围。摸清策略的行为之前,一次只交给机器人一个熟悉动作。
第三轮可以用 /autosteer 委派目标,例如把两个泡沫块收进同一只托盘。记下系统做了哪些中间选择。它可能先选中一个合理的物体,却在第二个物体够不着时需要协助。能把每个子任务与预期的简单顺序逐项对照时,目标委派格外有用。轨迹记录会告诉你,是规划器选错了步骤,还是机器人没有做好正确的步骤。
软件停止与实体停机要分别测试
交互会话让观察机器人的人可以就地发指令,也可能让人以为新指令已经生效,而眼前还在继续旧动作。可以分开记录四个时刻。记下指令发送时间、执行端确认时间(若有该信号)、首次看到行为变化的时间,以及最终状态。如果没有确认信号,就把这一栏留空,另外三项仍有参考价值。
LeRobot 的版本化部署文档介绍了受支持机器人在纠正流程中的软件位置保持功能。它会持续刷新驱动程序最后应用的位置目标。带负载的机械臂仍可能继续向那个位置移动并稳定下来,夹爪的行为也要在实体机器上确认。语言界面位于这些机械行为之上。继续遵循设备适用的实体停机与监护流程,在加入实时修改之前,先在清空的工作区验证停机效果。v0.7.0 执行文档
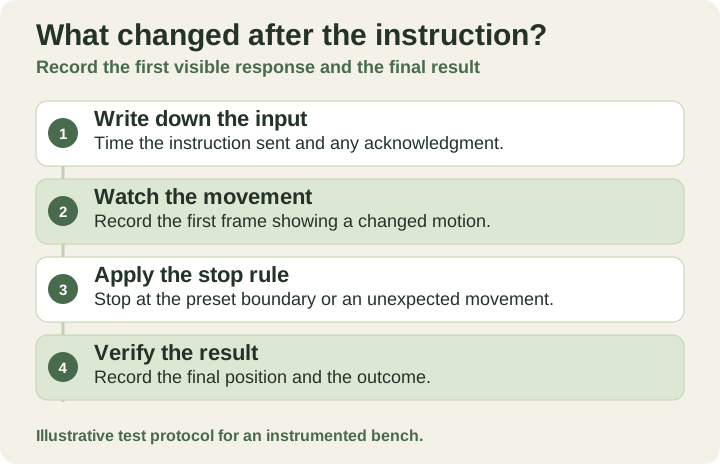
记录改指令的时间、运动变化的时间和试验如何结束。Telli.sh 原创图解。
这也改变了怎么看待一次看似成功的运行。泡沫块最终进了正确的托盘,途中可能有两次错误动作是由操作人员叫停的。记录介入频率,以及有多少次能从剩下的状态恢复。能从常见失误中继续运行的策略,与每次出错都要整体重置的策略,对操作人员的要求不同。在工作区和物体相同的配对试验中,可以测出这个差异。
FineART 把中间步骤也放进训练数据
本次发布还有一点值得注意,就是如何记录机器人示范。如果录像只显示干净的起点与成功的结尾,指令中途改变时,很难知道策略该学的是哪一段行为。子任务标签为训练流程补充了转折点,例如何时抓取、放下物体,何时去操作下一个物体。
Hugging Face 和 Scale AI 报告,FineART 包含超过 4 万段双臂操作、1,718 小时数据,以及超过 53.3 万条子任务标注。11 月 5 日的公告称,按 LeRobot 格式存储时数据量为 1.9 TB。FineART-VLA 基于 π0.5,增加了一个语言输出头,可以在动作组件执行前预测用文字表述的子任务。这些数字描述的是作者的数据集,语言和动作的分工描述的是模型设计。换成形状不同的夹爪、视野更窄的摄像头,或训练中没有的物体,需要做的评估也会变化。发布公告与 FineART 说明 · FineART-VLA 文档
收集小型纠正数据集时,先想清楚以后要复现什么。保存新指令、相关的摄像头画面、修改时的状态和观察到的结果。「红色箱子满了」与「把下一块红色泡沫放到空托盘」的作用不同。前一句描述状态,后一句告诉策略下一步怎么做。实验需要两者时就都保留。失败的例子也要保存,以便未来用最初触发这项工作的情况测试新策略。
第一次试验只需要一张工作台
-
固定版本,选择受支持的组合。 按项目的版本化指南安装 LeRobot 0.7.0。用一个已知任务检查机器人、摄像头配置和所选策略能否配合。11 月 5 日的发布说明称,Linux 上默认的 PyTorch 构建改用 CUDA 13,这条安装路径要求 NVIDIA 驱动 580.65 或更新版本。较旧的驱动可采用文档列出的替代安装方法。将修改驱动和观察机器人行为视为不同实验。安装文档 · v0.7.0 版本发布
-
在加入交互控制前先跑一次基线。 清空桌面,限制运动范围,安排好机械臂的监护。保存初始姿态和目标,记录策略能否完成任务。比较基线与中途改指令的运行时,固定摄像头位置、光线和物体。SO-101 设置文档
-
给已验证可运行的会话添加交互选项。 从终端开始会话,发一个子任务,改一次指令,然后结束运行。以下为发布公告中的终端命令,所用指令文字仅作示例。交互会话文档
纯文本/start /subtask move the red block to the tray /subtask move the blue block to the tray /stop -
基线可以复现后,再加入视觉提问和小目标委派。 选择能够生成文本的策略,或按文档配置外部规划器。从你看同一摄像头就能回答的问题开始。试一个能看得见结束条件的目标,并记录规划器不可用或不能给出有效子任务时的情况。使用外部端点也可能改变观测的处理地点,摄像头拍到工作台以外的东西时尤其要注意。外部规划器文档
-
除了是否完成,也比较如何恢复。 用相同条件重复几轮,保留每次失败。记录操作人员是否看得出发生了什么,能否选择合适的干预并确认最终状态。少量试验能帮助调整配置。要断言可靠性,则需要大量覆盖实际使用条件的证据。
0.7.0 还用策略服务器和远程执行模式取代了旧的异步推理接口。如果将来把推理移到 GPU 服务器,要在实际网络连接上重测延迟和中断。服务器可以提供更多算力,网络则会在新观测和下一步动作之间增加一个依赖。连接缓慢或中断本身就是独立的测试场景。v0.7.0 兼容性变更 · 远程推理文档
最值得试的时刻在任务做到一半时
机器人演示里有意思的时刻,是原先计划的步骤突然不再合适。箱子装满了,物体换了位置,或操作人员看到了摄像头漏掉的东西。LeRobot 的终端控制可以让这一刻成为实验的一部分。要检验的是,监护人员能否知道哪里变了,调整下一步动作,并亲眼确认结果。
来源
想把工作背后的决定和试验存成可搜索的记录,可以创建 Telli.sh 账户。