Deep Hat Sift transforma não executar um agente em uma decisão que exige aprovação
O modelo de triagem da Kindo aprende quais alertas um agente descarta. Como observação, revisão de limiares e amostras de omissões mudam os custos do trabalho em grande volume.
Um agente de operações pode analisar um alerta de forma excelente e ainda passar boa parte do dia concluindo que nada precisa ser feito. Em volume suficiente, essas execuções corretas, mas sem consequências, tornam-se um problema de projeto do sistema.
A Kindo anunciou o Deep Hat Sift em 28 de outubro de 2026, um modelo de decisão System One que aprende com os vereditos de um agente e pontua quais eventos recebidos merecem uma execução. Ele começa em modo de observação, deixando tudo passar, e só começa a reter eventos depois que uma pessoa aprova o limiar. Anúncio da Kindo.
A parte interessante é aprovar uma ausência: uma execução que nunca começa. Este guia explica essa decisão, compara-a a controles de custo mais simples e esboça um piloto que mede omissões importantes junto às chamadas evitadas.
 Centro de monitoramento de segurança física da University of Maryland, publicado em 2008. Contexto histórico de monitoramento de alertas; não mostra Kindo, Sift ou um painel de cibersegurança. Foto: UMD-Eskin, domínio público; redimensionada com margens. Fonte da imagem · Licença e notas da imagem. Referência oficial do produto.

Economizar uma execução muda o que o sistema consegue observar
Quando cada evento chega ao agente, o sistema pode examinar cada veredito. Quando um filtro começa a reter eventos, esse caminho simples de retorno muda. Os eventos considerados menos interessantes passam a ser justamente os que não recebem a atenção completa do agente.
Isso diferencia a filtragem da escolha de um modelo mais barato para a mesma solicitação. Um modelo mais barato ainda produz um resultado para cada evento. Uma decisão de retenção remove uma execução do caminho normal. O plano de medição precisa levar esse resultado ausente em conta.
Nossa avaliação: pular uma execução é um comportamento do produto com um responsável próprio. Alguém precisa decidir quais evidências o tornam aceitável, quais tipos de evento permanecem protegidos e o que acontece quando a fonte muda. Tratar isso como otimização invisível dificulta a revisão dessas decisões.
Pense no filtro como uma central de despacho. Sua função útil é encaminhar o trabalho correto e manter um registro do que ficou para trás. A qualidade desse despacho importa porque o especialista posterior não pode investigar algo que nunca recebe.
Para um piloto, defina o trabalho do agente antes de definir o sucesso do filtro. Ele identifica incidentes, pede mais contexto, encaminha tickets ou prepara investigações? “Precisa de execução” deve corresponder a esse trabalho. Caso contrário, um modelo pode aprender uma decisão consistente que não atende ao objetivo operacional da equipe.
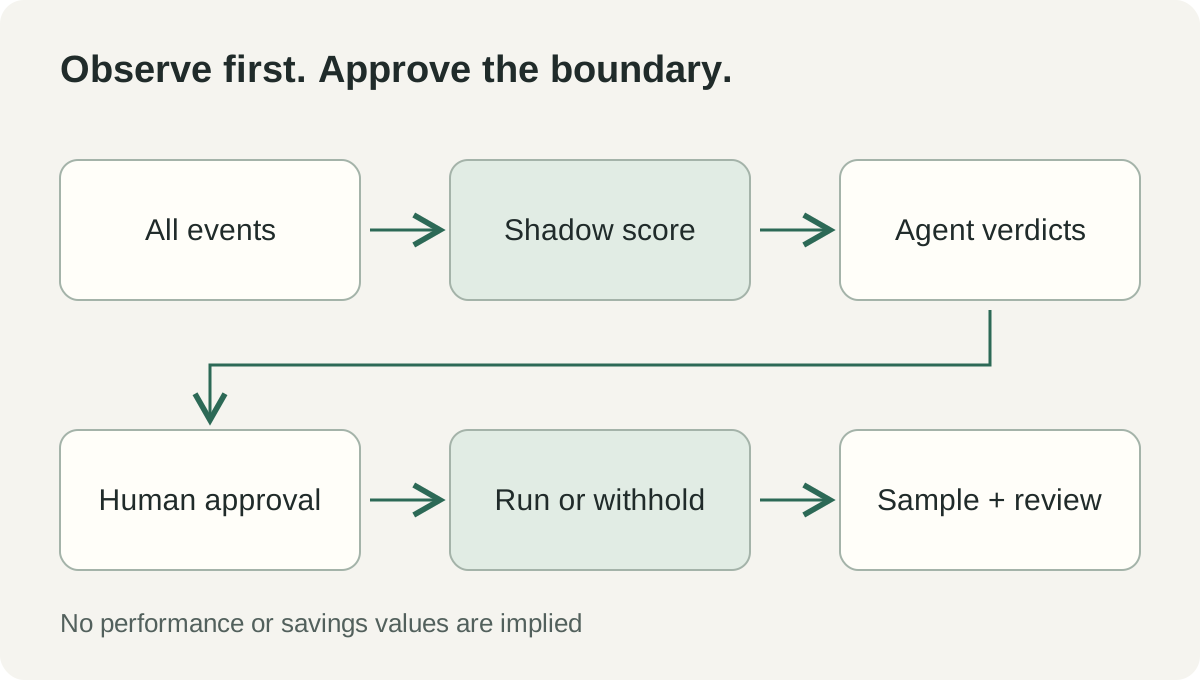 Explicação original do processo de observação e aprovação descrito no anúncio da Kindo. É uma visão operacional simplificada, não um diagrama de implantação.
O modo de observação cria uma comparação antes de mudar a entrega
O lançamento da Kindo de 28 de outubro descreve um período inicial em que o Sift pontua eventos enquanto todos continuam chegando ao agente-alvo. Depois, apresenta uma prévia das retenções propostas comparadas aos resultados daquela fonte; a aprovação inclui uma justificativa escrita, e uma amostra aleatória continua passando após a ativação para revelar omissões. Método operacional anunciado.
Essa ordem dá à equipe de operações uma comparação contrafactual útil. Antes de mudar a entrega, pode perguntar quais execuções históricas teriam desaparecido no ponto de operação proposto. A pergunta é concreta o suficiente para revisão com os responsáveis pela fonte e pelo agente.
A prévia deve incluir exemplos, não apenas uma média. Um grande grupo de eventos rotineiros pode dominar a taxa principal, enquanto uma categoria pequena e importante apresenta problemas. Peça ao aprovador que examine eventos cuja omissão seria cara e eventos perto do limite proposto.
A duração da observação deve seguir a cobertura. Um dia útil movimentado pode ser diferente de um fim de semana, de um lançamento ou de um incidente incomum. Um período do calendário só é útil se contiver as condições relevantes para a decisão. Evite tratar certo número de dias tranquilos como sinal universal de prontidão.
A aprovação deve indicar a condição operacional pretendida. Um registro como “aprovado para esta fonte e este agente, com estas exclusões e este intervalo de revisão” é mais útil que um simples sim. Ele dá à equipe algo para revisitar quando mudarem o esquema da fonte, o prompt do agente ou as prioridades operacionais.
Três filas ilustrativas exigem cuidados diferentes
Um alerta repetido de infraestrutura pode ser um ponto de partida delimitado
Imagine uma fila de SRE recebendo muitas repetições de uma notificação conhecida durante manutenção rotineira. A equipe já entende a fonte e tem um caminho documentado para exceções urgentes. Um piloto poderia verificar se o agente gasta repetidamente tempo para chegar ao mesmo veredito de nenhuma ação.
Comece separando o tratamento conhecido de duplicatas da nova decisão. Se uma regra simples de correlação já agrupa eventos idênticos, preserve essa referência. Use a avaliação do modelo para examinar a variação restante que torna a execução completa cara ou desnecessária.
Durante a observação, compare os descartes propostos ao que o agente realmente fez. Procure mudanças de gravidade, serviço afetado ou contexto que diferenciem um evento superficialmente parecido. A pergunta útil é se o filtro preserva as distinções que a operação já considera importantes.
Um critério ilustrativo de sucesso poderia exigir uma taxa específica de revisão e nenhuma omissão na categoria protegida durante a avaliação. Essas condições são escolhidas pela equipe; não são garantias universais do Sift. O exercício deve produzir uma decisão clara sobre uma fonte, não uma implantação imediata em toda a organização.
Uma fila de denúncias de phishing torna mais visível o custo da omissão
Considere uma equipe ilustrativa de segurança cujos funcionários denunciam mensagens suspeitas. Muitas denúncias podem não exigir ação, mas uma mensagem rara que exige investigação pode importar desproporcionalmente. A economia do filtro depende dessa assimetria.
Para essa fonte, examine exemplos que parecem correspondência comum, mas contêm os sinais relevantes à equipe. Mantenha as ferramentas de segurança e o processo de incidentes posteriores. Um filtro diante de um agente de IA deve ser avaliado para essa decisão de encaminhamento, não tratado como todo o programa de detecção.
A avaliação deve envolver analistas que entendem as consequências de uma investigação perdida. Um responsável financeiro pode ajudar a quantificar o custo das execuções, mas não pode definir sozinho uma cobertura aceitável de incidentes. O limiar é uma escolha operacional compartilhada cuja aprovação exige a experiência correta.
Revise também os erros do próprio agente. Aprender a prever o descarte de um agente pode reproduzir seu ponto cego. Um conjunto separado revisado por analistas pode revelar casos em que agente e filtro concordam entre si e ambos discordam do resultado desejado pela equipe.
Uma fila de tickets precisa definir o que é uma ação útil
Em uma central de serviços ilustrativa, um ticket pode parecer rotineiro e ainda exigir confirmação de recebimento, um prazo de nível de serviço ou um encaminhamento. “Não precisa de investigação” e “não precisa de execução do agente” podem, portanto, ser rótulos diferentes. Defina exatamente o que uma execução retida pode omitir.
Mantenha as ações obrigatórias fora de uma decisão ambígua quando necessário. Por exemplo, o sistema de tickets pode continuar responsável pelas confirmações exigidas enquanto o modelo ajuda a decidir se um agente investigativo específico deve executar. Isso facilita explicar a fronteira.
Teste tickets de equipes, idiomas e tipos de solicitação diferentes. Um filtro treinado principalmente em pedidos rotineiros de um departamento pode não se adequar aos padrões de escalonamento de outro. Uma avaliação por fonte é mais útil que presumir que o volume torna duas filas equivalentes.
Nesse piloto, a saída pode ser uma fila de investigação mais clara, não menos tickets. Meça a passagem para uma pessoa e o tempo até a próxima ação significativa. Isso liga a avaliação à qualidade do serviço, em vez de a uma contagem estreita de chamadas de modelo.
Quatro controles de custo respondem a perguntas diferentes
A comparação descreve escolhas de projeto que uma equipe pode avaliar. Não afirma que a implementação de um fornecedor vence em todas as categorias. Vários controles podem pertencer ao mesmo sistema porque atuam em pontos diferentes.
| Controle | Decisão tomada | O que medir |
|---|---|---|
| Regras de deduplicação ou correlação | Estes eventos são repetidos ou relacionados? | Incidentes distintos preservados e repetições agrupadas |
| Modelo mais barato para cada evento | Este evento pode usar uma análise menos cara? | Qualidade e custo completo por evento |
| Filtro de seleção, como o Sift | Este evento precisa deste agente? | Execuções evitadas, omissões acionáveis e cobertura de revisão |
| Orçamentos e roteamento por chamada | Qual chamada de modelo é permitida e cabe no orçamento? | Gasto, chamadas rejeitadas e conclusão posterior da tarefa |
A comparação começa pela decisão e ajuda a evitar contar economias duas vezes. Se uma regra de correlação já remove um evento repetido, o filtro não pode também alegar que impediu a mesma execução posterior. Defina a referência após os controles existentes e calcule os efeitos incrementais.
Inclua o custo operacional do próprio filtro. Hospedagem, monitoramento, execuções amostradas e revisão humana pertencem à contabilidade do piloto. Uma conta menor de um endpoint é útil, mas constitui apenas um componente do processo completo.
A qualidade pertence à mesma conversa que o custo. Um limiar que economiza muitas chamadas escondendo trabalho útil mudou o serviço. A equipe deve conseguir explicar esse compromisso na linguagem da fila real, não apenas com um percentual genérico de acurácia.
Use as omissões amostradas para fazer perguntas melhores
As perguntas frequentes da Kindo, consultadas em 2 de novembro, descrevem uma amostra padrão de passagem de 3%, configurável de 1% a 5%, e um piso inicial padrão de 400 vereditos rotulados. A página informa que desvio ou estouro do teto de acionamentos devolve o sistema à observação. São padrões operacionais publicados, não uma garantia de evidência suficiente para toda carga.
Um cálculo ilustrativo mostra a importância da cobertura da amostra. Suponha que 10.000 eventos seriam retidos e 3% sejam amostrados; isso produz cerca de 300 eventos amostrados. Se os casos importantes forem raros, a equipe ainda precisa verificar se a amostra representa as categorias cujas omissões importariam. A conta ilustra a questão da amostragem, sem estimar a taxa real de erros do Sift.
Informe pelo menos dois denominadores na avaliação. Um descreve os eventos acionáveis que o filtro perderia. Outro descreve a parcela dos eventos retidos posteriormente considerada acionável. Eles respondem a perguntas diferentes: cobertura do trabalho importante e contaminação do conjunto descartado.
Examine recortes por tipo de fonte, gravidade, equipe e mudanças de formato quando relevantes. Uma média pode melhorar enquanto uma categoria pequena piora. As categorias devem refletir os riscos e a carga da operação, não o agrupamento mais fácil de desenhar em um gráfico.
Por fim, separe o veredito do agente de um resultado revisado independentemente. A concordância com o agente mede a capacidade do Sift de prever esse agente. Sozinha, não estabelece que o julgamento do agente estava correto. As duas medidas podem ser úteis se seus significados permanecerem explícitos.
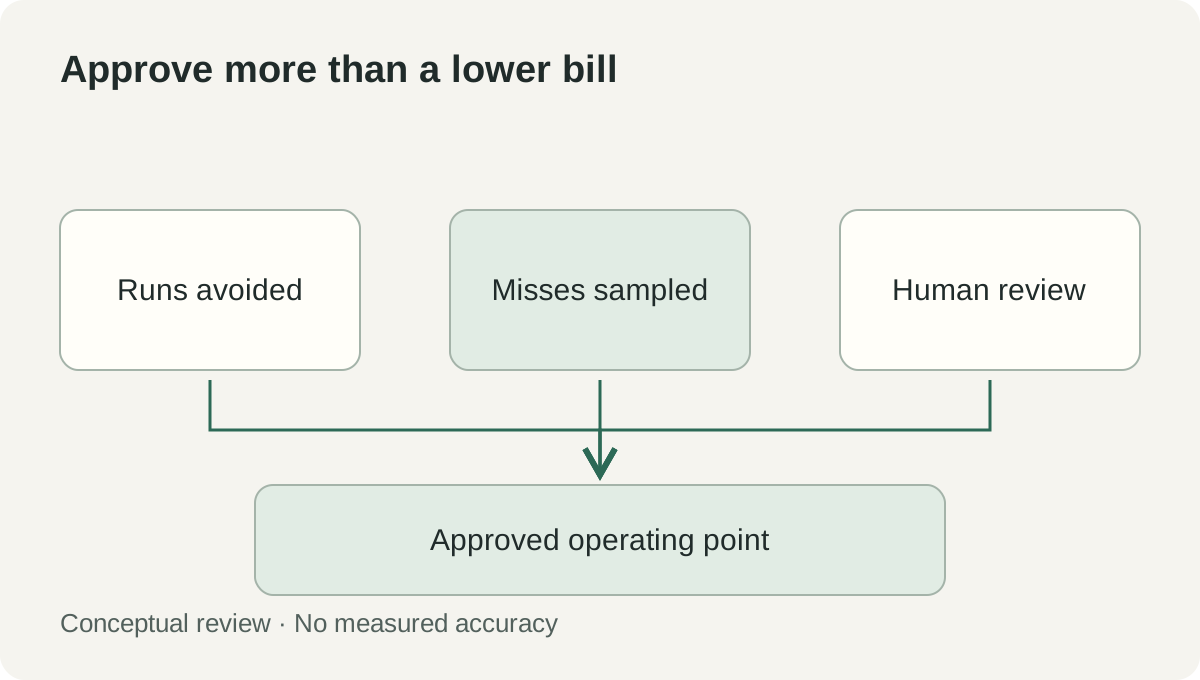 Auxílio original de revisão da decisão. Ilustra o que o operador deve comparar e não contém economias ou acurácias medidas. Amostragem e aprovação estão documentadas na página da Kindo.
A implantação atual tem limites que precisam entrar no piloto
Em 2 de novembro, a Kindo descreve o Sift como serviço auto-hospedado para agentes Kindo. As perguntas frequentes indicam implantação Docker Compose em um único host, sem cluster ou failover, e contas locais sem SSO ou MFA. Não há teste gratuito ou faixa de uso separada do Sift. Perguntas frequentes da versão atual.
Essas condições afetam onde cabe um piloto. Revise a fronteira da implantação com os responsáveis por identidade, disponibilidade e resposta a incidentes. Uma demonstração de pontuação bem-sucedida não revela se o serviço atende aos requisitos operacionais da organização.
- Nomeie uma fonte, um agente e um responsável pela decisão. Escreva o que o agente faz e o que uma execução pulada omitiria. Preserve as responsabilidades existentes de detecção e atendimento.
- Revise os requisitos atuais com a Kindo. Confirme a hospedagem disponível e o suporte operacional que sua equipe assumiria.
- Defina uma referência aprovada. Inclua regras existentes, correlação e roteamento de modelos para medir valor incremental.
- Comece em observação. Colete vereditos representativos e examine retenções propostas nas categorias importantes antes de alterar a entrega.
- Revise os erros independentemente. Inclua exemplos revisados por analistas e casos protegidos, sem depender inteiramente da concordância com o agente-alvo.
- Aprove um ponto de operação e sua justificativa. Registre escopo, revisor, plano de amostragem e condições que exigem nova revisão.
- Exercite a volta à observação. Confirme o que os operadores veem e como o fluxo completo volta ao agente. Mantenha custo, qualidade e disponibilidade na avaliação final.
O resultado deve ser uma decisão operacional delimitada com um responsável. Se o piloto revelar uma categoria incerta, mantê-la no caminho de análise completa é útil. O objetivo é aprender onde a retenção se justifica, não maximizar descartes na primeira oportunidade.
Uma chamada evitada vale quando você consegue explicar o trabalho que ela não escondeu
O Sift traz uma pergunta importante ao processo dos agentes: quais eventos merecem execução completa e quem responde por essa fronteira? Sua abordagem de observação primeiro dá às equipes um lugar para examinar a decisão antes de usá-la para mudar a entrega.
A medida duradoura é a capacidade da operação de mostrar execuções economizadas, omissões observadas e a razão de o limiar atual continuar adequado. É isso que transforma uma ausência de atividade em uma decisão que alguém consegue defender.
Fontes
- Anúncio do Deep Hat Sift da Kindo, distribuído pela PR Newswire, 28 de outubro de 2026, 09:00 ET.
- Kindo: detalhes do Deep Hat Sift e perguntas frequentes da versão atual, consultados em 2 de novembro de 2026.
Preserve o material por trás de uma decisão
O Telli.sh é uma opção para guardar fontes autorizadas junto às notas que você revisou. Criar um espaço de notas.