Deep Hat Sift macht das Überspringen eines Agentenlaufs zur freizugebenden Entscheidung
Kindos Ereignisfilter lernt, welche Meldungen ein Agent verwirft. Wie Schattenbetrieb, Schwellenprüfung und Stichproben übersehener Fälle die Wirtschaftlichkeit großer Agentenströme verändern.
Ein Betriebsagent kann Meldungen hervorragend prüfen und trotzdem den Großteil seines Tages mit der Feststellung verbringen, dass nichts geschehen muss. Bei ausreichendem Volumen werden diese korrekten, ereignislosen Durchläufe zu einem Problem des Systemdesigns.
Kindo kündigte Deep Hat Sift am 28. Oktober 2026 an: ein System-One-Entscheidungsmodell, das aus Agentenurteilen lernt und eingehende Ereignisse nach ihrem Ausführungsbedarf bewertet. Es beginnt im Schattenbetrieb und lässt alles durch. Erst nachdem eine Person den Schwellenwert genehmigt, hält es Ereignisse zurück. Kindos Ankündigung.
Interessant ist die Freigabe einer Abwesenheit: eines Durchlaufs, der niemals startet. Dieser Leitfaden erklärt diese Entscheidung, vergleicht sie mit einfacheren Kostenkontrollen und skizziert einen Pilotversuch, der wichtige Auslassungen ebenso misst wie vermiedene Aufrufe.
 Das Zentrum für physische Sicherheitsüberwachung der University of Maryland, veröffentlicht 2008. Historischer Kontext zur Meldungsüberwachung; es zeigt weder Kindo noch Sift noch ein Cybersicherheitsdashboard. Foto: UMD-Eskin, gemeinfrei; mit Rändern skaliert. Bildquelle · Lizenz und Bildhinweise. Offizielle Produktreferenz.

Ein eingesparter Durchlauf verändert die Beobachtungsmöglichkeiten
Erreicht jedes Ereignis den Agenten, kann das System jedes Urteil prüfen. Hält ein Filter Ereignisse zurück, verändert sich dieser einfache Rückkopplungsweg. Die vermeintlich uninteressantesten Ereignisse erhalten dann keine vollständige Aufmerksamkeit des Agenten mehr.
Dadurch unterscheidet sich Filtern von der Wahl eines günstigeren Modells für dieselbe Anfrage. Ein günstigeres Modell liefert weiterhin für jedes Ereignis ein Ergebnis. Eine Zurückhalteentscheidung entfernt eine Ausführung aus dem normalen Pfad. Der Messplan muss dieses fehlende Ergebnis berücksichtigen.
Unsere Einschätzung: Überspringen ist ein Produktverhalten mit eigener Verantwortung. Jemand muss entscheiden, welche Belege es rechtfertigen, welche Ereignisarten geschützt bleiben und was bei Quellenänderungen geschieht. Als unsichtbare Optimierung behandelt, wird es schwerer überprüfbar.
Der Filter ähnelt einer Einsatzleitstelle. Seine nützliche Aufgabe ist, die richtige Arbeit weiterzuleiten und festzuhalten, was zurückblieb. Die Qualität dieser Zuordnung zählt, weil der nachgelagerte Spezialist nichts untersuchen kann, was ihn nie erreicht.
Definieren Sie für einen Pilot zuerst die Agentenaufgabe und dann den Filtererfolg. Erkennt der Agent Vorfälle, fordert er Kontext an, verteilt er Tickets oder bereitet er Untersuchungen vor? „Benötigt einen Durchlauf“ sollte zu dieser Aufgabe passen. Sonst kann ein Modell eine konsistente Entscheidung lernen, die am Betriebsziel vorbeigeht.
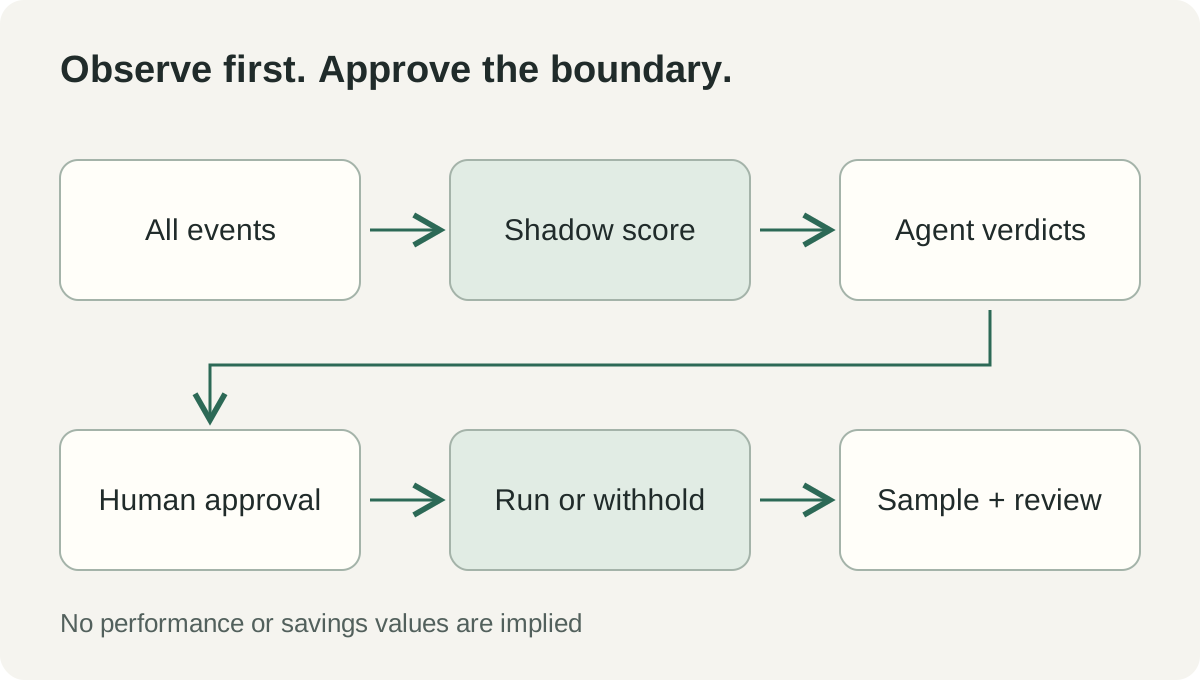 Eigene Erklärung des in Kindos Ankündigung beschriebenen Ablaufs vom Schattenbetrieb zur Freigabe. Dies ist eine vereinfachte Betriebssicht, kein Bereitstellungsdiagramm.
Schattenbetrieb schafft einen Vergleich vor der Lieferänderung
Kindos Veröffentlichung vom 28. Oktober beschreibt eine anfängliche Beobachtung, in der Sift Ereignisse bewertet und trotzdem alle an den Zielagenten weitergibt. Anschließend stellt es vorgeschlagenes Zurückhalten den Ergebnissen dieser Quelle gegenüber. Die Freigabe umfasst eine schriftliche Begründung; nach Aktivierung wird weiterhin eine Zufallsstichprobe durchgelassen, um Auslassungen sichtbar zu machen. Angekündigte Betriebsweise.
Diese Reihenfolge liefert Betriebsteams einen nützlichen kontrafaktischen Vergleich. Vor einer Zustelländerung können sie fragen, welche historischen Ausführungen beim vorgeschlagenen Betriebspunkt entfallen wären. Die Frage ist konkret genug für eine Prüfung mit den Verantwortlichen für Quelle und Agent.
Die Vorschau sollte Beispiele und Gesamtwerte enthalten. Eine große Menge routinemäßiger Ereignisse kann die Schlagzeilenquote dominieren, während eine kleine wichtige Kategorie schlecht abschneidet. Lassen Sie die freigebende Person Ereignisse mit teuren Auslassungsfolgen und solche nahe der vorgeschlagenen Grenze prüfen.
Die Beobachtungsdauer sollte sich nach Abdeckung richten. Ein arbeitsreicher Werktag kann anders aussehen als ein Wochenende, Veröffentlichungstag oder ungewöhnlicher Vorfall. Ein Kalenderzeitraum hilft nur, wenn er entscheidungsrelevante Bedingungen enthält. Eine bestimmte Anzahl ruhiger Tage ist kein universelles Reifesignal.
Die Freigabe sollte die beabsichtigte Betriebsbedingung benennen. „Für diese Quelle und diesen Agenten, mit diesen Ausnahmen und diesem Prüfintervall genehmigt“ ist nützlicher als ein bloßes Ja. Das lässt sich später erneut prüfen, wenn Quellschema, Agentenprompt oder Betriebsprioritäten sich ändern.
Drei beispielhafte Warteschlangen verlangen unterschiedliche Vorsicht
Wiederholte Infrastrukturmeldungen eignen sich für einen begrenzten Einstieg
Stellen Sie sich eine SRE-Warteschlange mit vielen Wiederholungen einer bekannten Meldung während routinemäßiger Wartung vor. Das Team versteht die Quelle bereits und hat einen dokumentierten Weg für dringende Ausnahmen. Ein Pilot könnte untersuchen, ob der Agent immer wieder Zeit für dasselbe Urteil „keine Aktion“ aufwendet.
Trennen Sie bekannte Duplikatbehandlung von der neuen Entscheidung. Fasst eine einfache Korrelationsregel identische Ereignisse bereits zusammen, behalten Sie diese Ausgangslösung. Untersuchen Sie mit der Modellbewertung die verbleibende Variation, die einen vollen Agentenlauf teuer oder unnötig macht.
Vergleichen Sie im Schattenbetrieb vorgeschlagene Auslassungen mit tatsächlichen Agentenaktionen. Achten Sie auf Schweregrad, betroffenen Dienst oder Kontext, die ein äußerlich ähnliches Ereignis verändern. Entscheidend ist, ob der Filter die im Betrieb wichtigen Unterschiede erhält.
Ein beispielhaftes Erfolgskriterium könnte eine festgelegte Prüfquote und keine übersehenen Ereignisse einer geschützten Kategorie im Versuch verlangen. Diese Bedingungen wählt das Team; sie sind keine universellen Sift-Garantien. Die Übung sollte eine klare Entscheidung zu einer Quelle liefern statt sofort eine unternehmensweite Einführung.
Phishingmeldungen machen die Kosten einer Auslassung sichtbar
Nehmen wir ein beispielhaftes Sicherheitsteam, dessen Beschäftigte verdächtige Nachrichten melden. Viele Berichte brauchen keine weitere Aktion, eine seltene relevante Nachricht kann aber überproportional wichtig sein. Die Filterwirtschaftlichkeit hängt von dieser Asymmetrie ab.
Prüfen Sie für diese Quelle Beispiele, die wie gewöhnliche Korrespondenz aussehen und dennoch relevante Zeichen enthalten. Behalten Sie nachgelagerte Sicherheitswerkzeuge und den Vorfallsprozess. Ein Filter vor einem KI-Agenten ist für diese Weiterleitungsentscheidung zu bewerten und nicht als gesamtes Erkennungsprogramm zu behandeln.
An der Bewertung sollten Analysten beteiligt sein, die die Folgen einer unterbliebenen Untersuchung verstehen. Finanzverantwortliche können Ausführungskosten beziffern, aber nicht allein akzeptable Vorfallsabdeckung definieren. Der Schwellenwert ist eine gemeinsame Betriebsentscheidung, deren Freigabe passende Fachkenntnis braucht.
Prüfen Sie auch die Fehler des Agenten. Lernt der Filter dessen Verwerfen vorherzusagen, kann er dessen blinden Fleck übernehmen. Ein gesondertes, von Analysten geprüftes Set kann Fälle zeigen, in denen Agent und Filter übereinstimmen, aber beide vom gewünschten Ergebnis abweichen.
Eine Ticketwarteschlange braucht eine Definition nützlicher Aktion
In einem beispielhaften Service Desk kann ein routinemäßiges Ticket trotzdem eine Bestätigung, einen SLA-Zeitgeber oder eine Zuordnung erfordern. „Keine Untersuchung nötig“ und „kein Agentenlauf nötig“ sind deshalb möglicherweise verschiedene Labels. Definieren Sie genau, was eine zurückgehaltene Ausführung weglassen darf.
Halten Sie verpflichtende Aktionen gegebenenfalls außerhalb einer unklaren Entscheidung. Das Ticketsystem kann etwa für vorgeschriebene Empfangsbestätigungen verantwortlich bleiben, während das Modell über den Start eines bestimmten Untersuchungsagenten mitentscheidet. So lässt sich die Grenze leichter erklären.
Testen Sie Tickets verschiedener Teams, Sprachen und Anfragetypen. Ein hauptsächlich mit Routineanfragen einer Abteilung trainierter Filter kann schlecht zu den Eskalationsmustern einer anderen passen. Quellspezifische Bewertung hilft mehr als die Annahme, Volumen mache zwei Warteschlangen gleichwertig.
Das Ergebnis dieses Piloten könnte eine klarere Untersuchungswarteschlange statt weniger Tickets sein. Messen Sie die menschliche Übergabe und die Zeit bis zur nächsten sinnvollen Aktion. Dadurch bleibt die Bewertung mit Servicequalität verbunden statt mit einer engen Zahl von Modellaufrufen.
Vier Kostenkontrollen beantworten verschiedene Fragen
Der folgende Vergleich beschreibt bewertbare Designentscheidungen. Er behauptet nicht, dass eine konkrete Anbieterimplementierung jede Kategorie gewinnt. Mehrere Kontrollen können im selben System sinnvoll sein, weil sie an unterschiedlichen Stellen wirken.
| Kontrolle | Ihre Entscheidung | Zu messen |
|---|---|---|
| Deduplizierungs- oder Korrelationsregeln | Sind diese Ereignisse wiederholt oder verwandt? | Erhaltene eigenständige Vorfälle und zusammengefasste Wiederholungen |
| Günstigeres Modell für jedes Ereignis | Reicht hier eine preiswertere Analyse? | Qualität und vollständige Kosten pro Ereignis |
| Ausführungsfilter wie Sift | Braucht dieses Ereignis diesen Agenten überhaupt? | Vermiedene Läufe, relevante Auslassungen und Prüfabdeckung |
| Budgets und Routing pro Aufruf | Welcher Modellaufruf ist erlaubt und bezahlbar? | Ausgaben, abgelehnte Aufrufe und nachgelagerte Aufgabenerfüllung |
Der Vergleich beginnt bei der Entscheidung und verhindert doppelt gezählte Einsparungen. Entfernt eine Korrelationsregel bereits ein wiederholtes Ereignis, kann der Filter nicht denselben verhinderten Lauf beanspruchen. Definieren Sie die Ausgangslage nach bestehenden Kontrollen und berechnen Sie zusätzliche Effekte.
Berücksichtigen Sie die eigenen Betriebskosten des Filters. Hosting, Überwachung, Stichprobenläufe und menschliche Prüfung gehören in die Pilotabrechnung. Eine kleinere Rechnung für einen Anbieterendpunkt hilft, ist aber nur ein Teil des gesamten Ablaufs.
Qualität gehört ins gleiche Gespräch wie Kosten. Ein Schwellenwert, der viele Aufrufe spart und nützliche Arbeit verbirgt, verändert den Dienst. Das Team sollte diese Abwägung in der Sprache seiner tatsächlichen Warteschlange erklären können statt mit einer einzigen allgemeinen Genauigkeitsquote.
Stellen Sie mit stichprobenartig entdeckten Auslassungen bessere Fragen
Kindos am 2. November geprüfte FAQ beschreibt standardmäßig 3% durchgelassene Stichprobe, einstellbar von 1% bis 5%, und eine anfängliche Standarduntergrenze von 400 gelabelten Urteilen. Drift oder eine überschrittene Auslöseschwelle führe zum Schattenverhalten zurück. Das sind veröffentlichte Standardwerte, keine Garantie ausreichender Belege für jede Arbeitslast.
Eine Beispielrechnung zeigt die Bedeutung der Stichprobenabdeckung. Würden 10.000 Ereignisse zurückgehalten und 3% geprüft, ergäbe das ungefähr 300 Stichprobenereignisse. Sind wichtige Fälle selten, muss das Team weiterhin untersuchen, ob die Stichprobe die entscheidenden Kategorien repräsentiert. Diese Rechnung erklärt die Stichprobenfrage und schätzt nicht Sifts tatsächliche Fehlerrate.
Berichten Sie in der eigenen Bewertung mindestens zwei Bezugsgrößen. Eine beschreibt relevante Ereignisse, die der Filter übersehen würde. Eine andere beschreibt den Anteil später als relevant bewerteter Ereignisse unter den zurückgehaltenen. Sie beantworten verschiedene Betriebsfragen: Abdeckung wichtiger Arbeit und Anteil relevanter Fälle in der ausgelassenen Menge.
Untersuchen Sie gegebenenfalls Teilgruppen nach Quelltyp, Schweregrad, Team und wechselndem Eingabeformat. Der Gesamtwert kann steigen, während eine kleine Kategorie schlechter wird. Die Kategorien sollten Risiken und Arbeitslast widerspiegeln, nicht die bequemste Diagrammgruppierung.
Halten Sie schließlich das Agentenurteil von einem unabhängig geprüften Ergebnis getrennt. Übereinstimmung mit dem Agenten misst, wie gut Sift diesen Agenten vorhersagt. Sie belegt allein nicht, dass dessen Urteil richtig war. Beide Maße können helfen, wenn ihre Bedeutungen ausdrücklich bleiben.
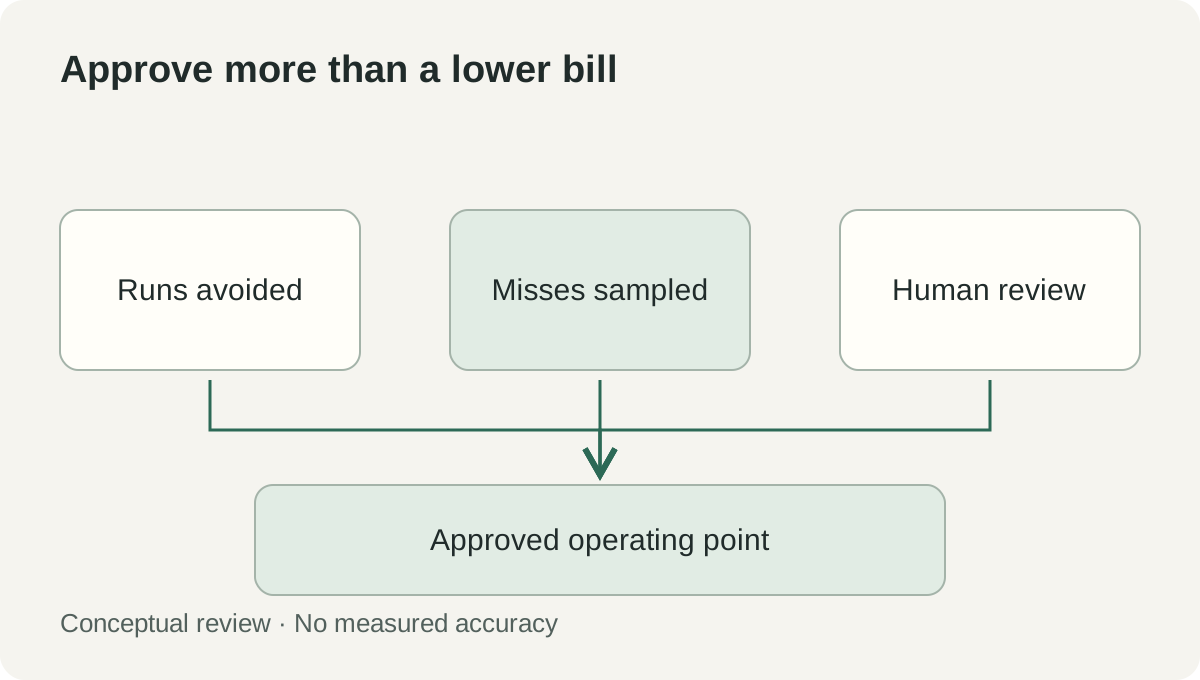 Eigene Entscheidungshilfe. Sie zeigt, was Betreiber vergleichen sollten, und enthält keine gemessenen Einsparungs- oder Genauigkeitswerte. Stichproben und Freigabe sind auf Kindos Produktseite dokumentiert.
Der aktuelle Betrieb hat Grenzen, die in den Pilot gehören
Am 2. November beschreibt Kindo Sift als selbst gehosteten Dienst für Kindo-Agenten. Die FAQ nennt eine Docker-Compose-Bereitstellung auf einem Host, ohne Clustering oder Failover, sowie lokale Konten ohne SSO oder MFA. Es gibt keinen gesonderten kostenlosen Sift-Test oder Nutzungstarif. FAQ zur aktuellen Version.
Diese Bedingungen bestimmen den passenden Pilotort. Besprechen Sie die Bereitstellungsgrenze mit den Verantwortlichen für Identität, Verfügbarkeit und Vorfallsreaktion. Eine erfolgreiche Bewertungsdemo beantwortet nicht, ob der Dienst zu den Betriebsanforderungen passt.
- Benennen Sie eine Quelle, einen Agenten und einen Entscheidungsverantwortlichen. Schreiben Sie auf, was der Agent tut und was beim Überspringen fehlt. Erhalten Sie bestehende Erkennungs- und Ticketzuständigkeiten.
- Prüfen Sie mit Kindo die aktuellen Betriebsanforderungen. Bestätigen Sie Hostingmöglichkeiten und den von Ihrem Team zu tragenden Support.
- Definieren Sie eine genehmigte Ausgangslage. Berücksichtigen Sie Regeln, Korrelation und Modellrouting, um zusätzlichen Wert zu messen.
- Beginnen Sie im Schattenbetrieb. Sammeln Sie repräsentative Urteile und prüfen Sie vorgeschlagenes Zurückhalten in wichtigen Kategorien vor der Zustelländerung.
- Prüfen Sie Fehler unabhängig. Beziehen Sie analystengeprüfte Beispiele und geschützte Fälle ein, statt sich nur auf Übereinstimmung mit dem Zielagenten zu verlassen.
- Genehmigen Sie einen konkreten Betriebspunkt mit Begründung. Dokumentieren Sie Umfang, Prüfer, Stichprobenplan und Bedingungen für erneute Prüfung.
- Erproben Sie die Rückkehr zum Schattenbetrieb. Bestätigen Sie die Operatorsicht und die erneute vollständige Zustellung. Beziehen Sie Kosten, Qualität und Verfügbarkeit in das Schlussurteil ein.
Das Ergebnis sollte eine begrenzte Betriebsentscheidung mit Verantwortlichem sein. Zeigt der Pilot eine unsichere Kategorie, ist deren Beibehaltung auf dem vollständigen Analysepfad ein nützliches Ergebnis. Es geht darum zu lernen, wo Zurückhalten gerechtfertigt ist, und nicht sofort möglichst viele Ereignisse auszulassen.
Ein vermiedener Aufruf zählt, wenn die nicht verborgene Arbeit erklärbar bleibt
Sift bringt eine wichtige Frage in den Agentenablauf: Welche Ereignisse verdienen eine vollständige Ausführung, und wer verantwortet diese Grenze? Der anfängliche Schattenbetrieb bietet einen Ort, die Entscheidung vor einer Zustelländerung zu untersuchen.
Das dauerhafte Maß ist, ob der Betrieb eingesparte Läufe, beobachtete Auslassungen und die fortbestehende Angemessenheit des Schwellenwerts zeigen kann. So wird aus fehlender Aktivität eine Entscheidung, hinter der jemand stehen kann.
Quellen
- Kindos Deep-Hat-Sift-Ankündigung, verbreitet über PR Newswire, 28. Oktober 2026, 09:00 ET.
- Kindo: Deep-Hat-Sift-Produktdetails und FAQ zur aktuellen Version, geprüft am 2. November 2026.
Bewahren Sie das Material hinter einer Entscheidung auf
Telli.sh ist eine Möglichkeit, autorisiertes Quellenmaterial zusammen mit bereits geprüften Notizen aufzubewahren. Notizbereich anlegen.