Jev выбирает, а не беседует: три демонстрации и их ограничения
Что на самом деле делает Jev от TypeSafe: GIF и интерактивная демонстрация Browser Use, пример классификации 1 500 писем из X и официальные игровые демонстрации. Узнайте, где помогают типизированные решения, где они ошибаются и как оценивать реальный рабочий процесс.
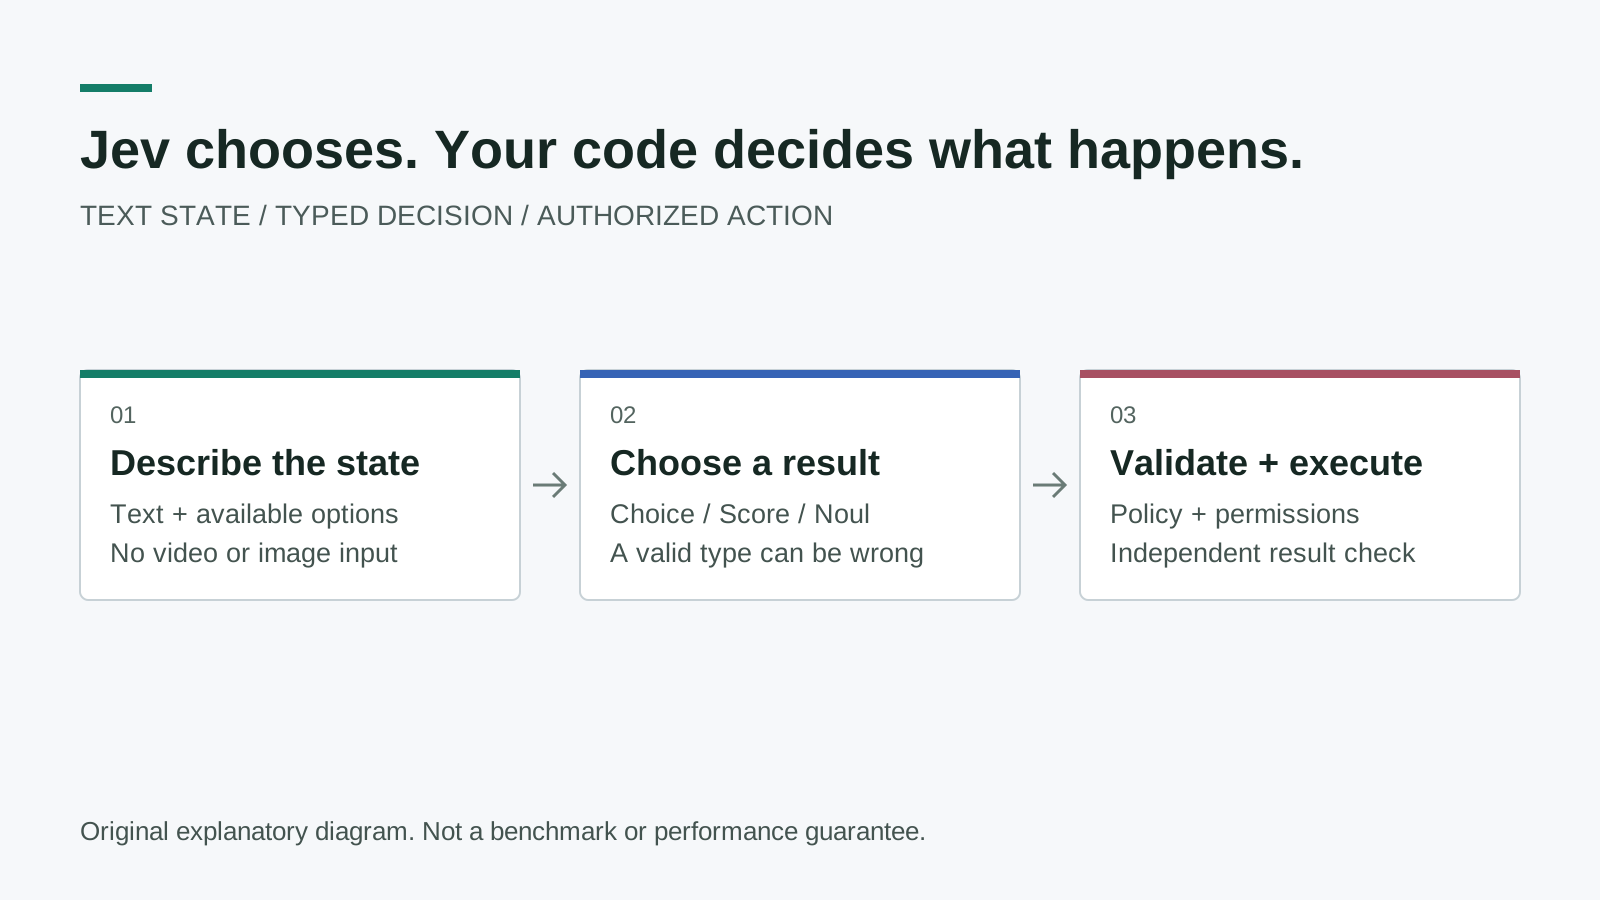
Оригинальная поясняющая схема, а не бенчмарк поставщика. Модель выбирает из заданного набора вариантов; ответственность за разрешения, проверку и выполнение остается у кода приложения.
Классификатору входящих писем не нужно сначала писать эссе, чтобы выбрать папку. Контроллеру браузера часто достаточно выбрать одну из доступных кнопок, а не придумывать новую команду. Именно в таких небольших решениях Jev, первая модель TypeSafe AI из семейства System One, выглядит особенно интересно.
TypeSafe представила Jev 15 сентября 2026 года. Важно не просто то, что это еще одна быстрая модель: она возвращает решения с ограниченным набором вариантов, а не произвольный текст. Это меняет устройство окружающей программы, но не исключает возможность выбрать неправильный ответ. См. официальный анонс, где изложен взгляд поставщика.
В этом руководстве рассматриваются три публичные демонстрации: задача в браузере с загружаемыми GIF и видеозаписью, рассказ автора о классификации 1 500 писем и игровые демонстрации TypeSafe. Мы также превращаем эти примеры в конкретный план оценки. Статья о сценариях применения на Tistory, опубликованная 18 сентября, послужила отправной точкой исследования; предложенные в ней применения здесь не выдаются за независимо подтвержденные внедрения у клиентов.
Кратко:
- Jev умеет выбирать вариант, оценивать его или проверять утверждение по тексту; это не замена модели, которая пишет произвольный текст.
- Даже типизированный ответ допустимого формата может быть семантически неверным. Проверку и окончательное разрешение оставляйте коду.
- Запись работы браузера подлинная, но одна задача не является универсальным бенчмарком. Пример с письмами — рассказ автора, а не опубликованное исследование точности.
- Начните с обратимой классификации, измеряйте ошибки на собственных данных и предусмотрите возможность воздержаться от ответа.
Короткий ответ требует очень точного вопроса
Три основных примитива API — Choice, Score и Noul. Choice выбирает один из именованных вариантов. Score оценивает соответствие упорядоченным описанным уровням. Noul возвращает вероятность истинности утверждения, на которое можно ответить «да» или «нет»; значение около середины означает неуверенность в утверждении, а не средний уровень серьезности. Контракты этих примитивов описаны в документации.
Практический сдвиг состоит в том, чтобы заранее определить возможные результаты. Вместо просьбы написать абзац о новом сообщении в поддержку можно спросить, относится ли оно к оплате, доступу к аккаунту, дефекту продукта или неразрешенной категории. Приложение затем решает, какую очередь показать. Это стрелка на железнодорожном пути, а не весь поезд: она помогает направить работу, но не обладает всеми возможностями, нужными для ее завершения.
| Примитив | Полезный вопрос | Ответственность приложения |
|---|---|---|
| Choice | Какая из этих очередей лучше всего подходит для сообщения? | Определить полный набор вариантов, включая путь на проверку |
| Score | Насколько хорошо сообщение соответствует описанным уровням срочности? | Определить уровни и проверить согласие оценщиков |
| Noul | Просит ли отправитель явно отменить услугу? | Решить, какая вероятность оправдывает проверку или обратимое действие |
Составление хороших вариантов — часть инженерной работы. Если две метки пересекаются, внешне уверенный выбор может скрывать проблему в вашей таксономии. Если ни одна метка не подходит, принудительный выбор маскирует отсутствие нужной категории уверенностью. Вариант «на проверку» часто полезнее еще одной узкой категории: он показывает, где нужно улучшить контракт принятия решений.
По состоянию на 30 сентября 2026 года в справочнике моделей указаны jev-1.13.0, только текстовый ввод и цена $0.042 за миллион входных токенов; выходные токены бесплатны. Это цена токенов модели, а не полная стоимость запуска агента. В операционный бюджет также входят браузеры, извлечение данных, вспомогательные модели, повторные попытки и проверка человеком.
GIF браузера показывает настоящий поиск, а не бронирование авиабилета
В публичном репозитории jev-ultrafast от Browser Use есть запись поиска авиарейса Google Flights из Цюриха в Лондон. Jev выбирает операцию и целевой элемент по текущему представлению страницы. Если для выбранной операции нужно что-то ввести, текст предоставляет отдельная генеративная вспомогательная модель. Это составная система, а не доказательство того, что сама Jev генерирует каждую строку или интерпретирует кадры видео.
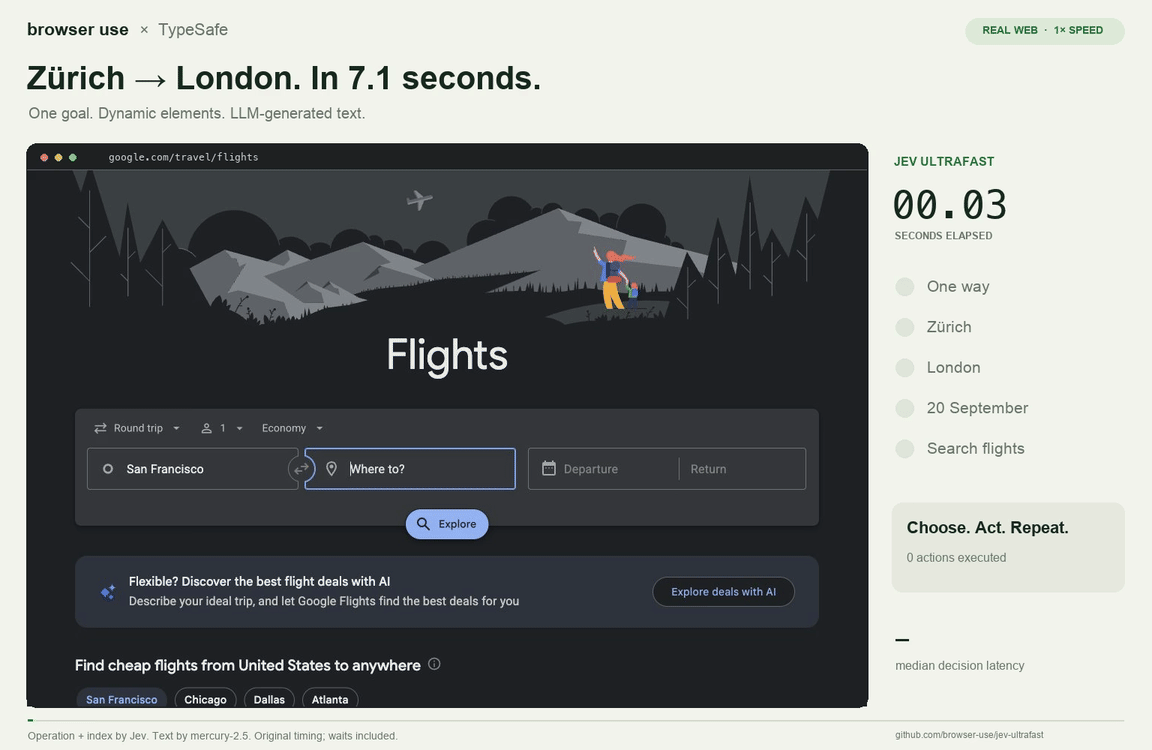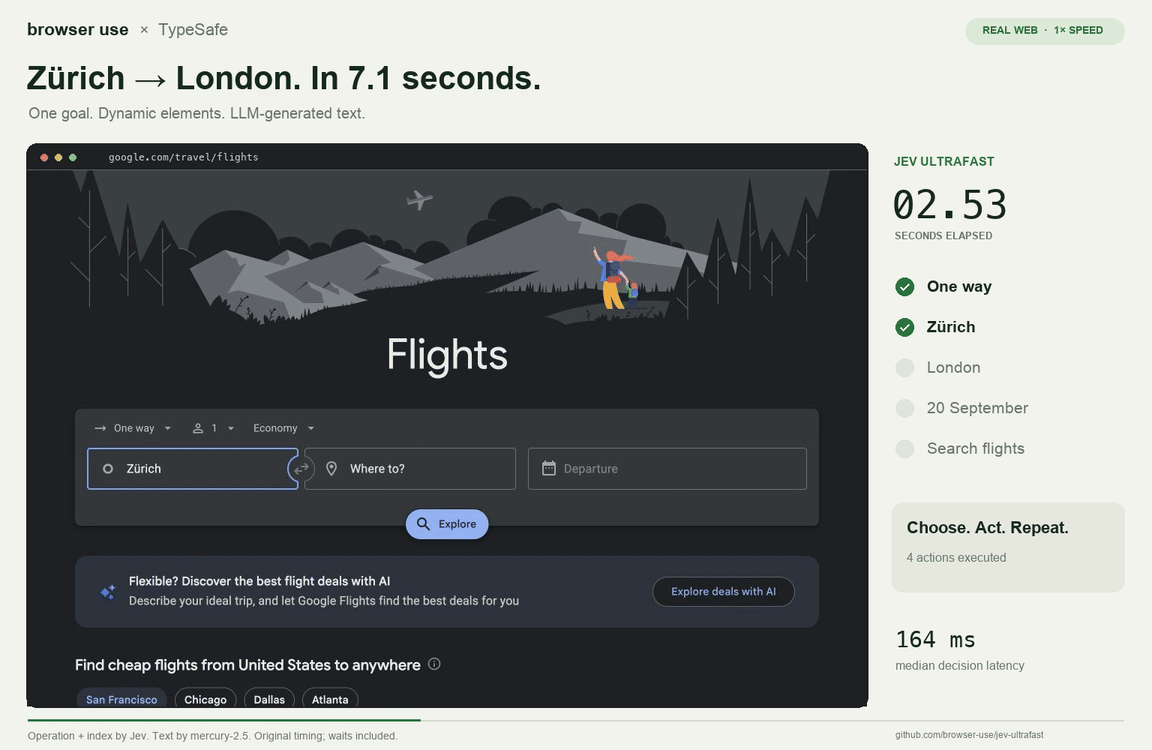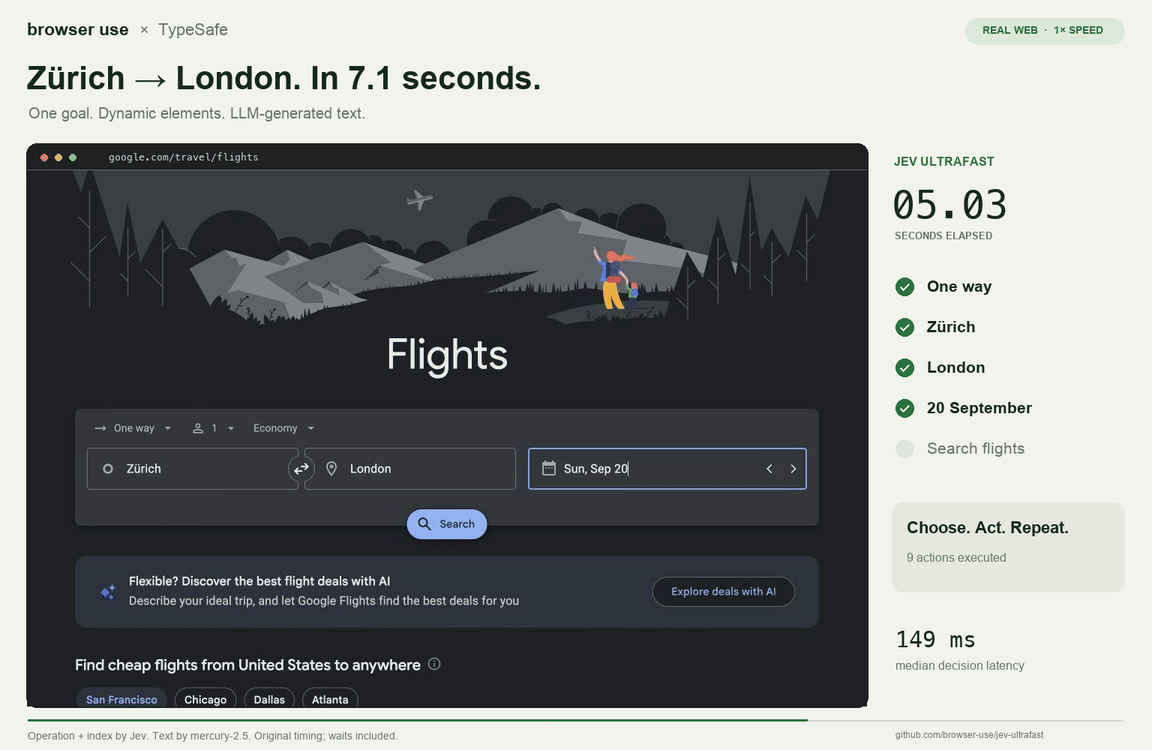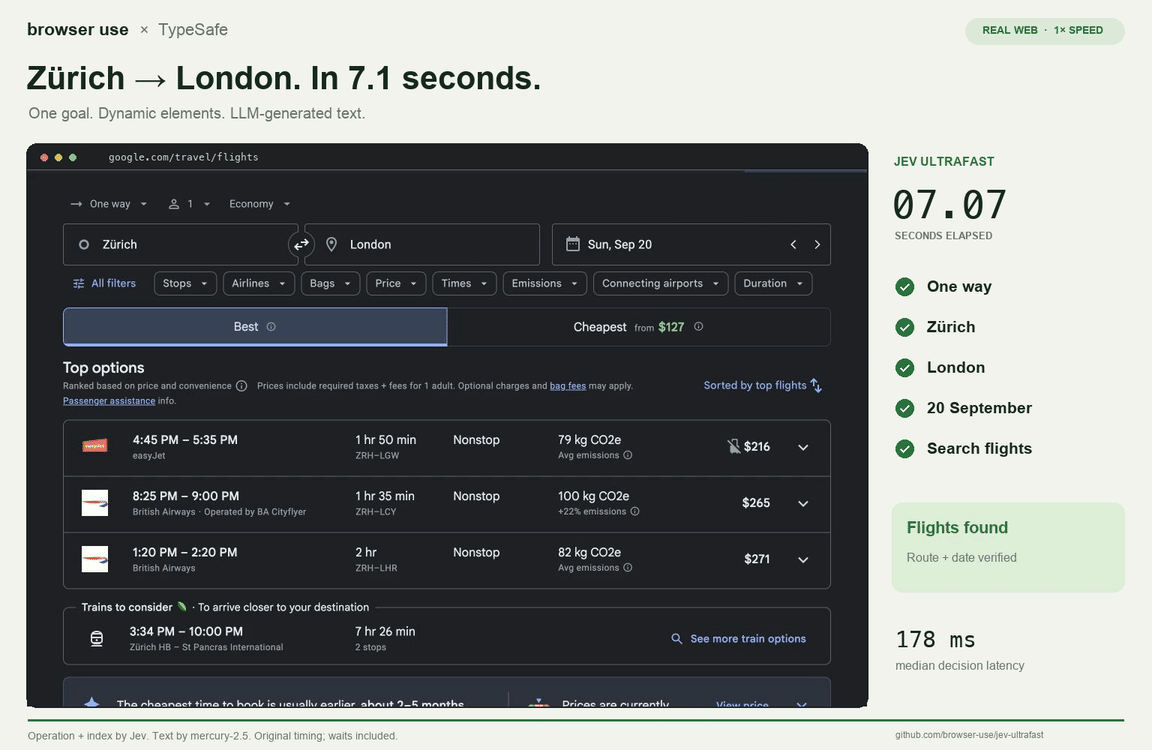
Настоящая авторская GIF-запись Browser Use, закрепленная за коммитом 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, лицензия MIT. Показан процесс поиска, а не покупка. Эту же запись можно посмотреть ниже.
Авторская запись MP4 показана на исходной скорости с элементами управления воспроизведением. Оригинальная запись и заметки об измерениях; сохраненная лицензия MIT. Мы изучили общедоступные материалы, но не повторяли этот бенчмарк.
Измеренное автором время выполнения этой записи — 7.073 секунды. Отсчет начинается с первого предсказания после начального наблюдения домашней страницы, а не с запуска нового браузера. Настройка, начальная навигация и новая независимая проверка после выполнения не входят в этот временной интервал. Результаты поиска проверяются; ни билет не выбирается, ни покупка не совершается. Эти границы принципиальны для понимания смысла числа.
В том же отчете сравниваются шесть чередующихся запусков, по три для каждой среды выполнения. Медианное время выполнения задачи сокращается с 9.450 секунды до 7.092 секунды, а медианное число вызовов протокола браузера падает с 1,092 до 101. В обеих группах используется Jev и один и тот же текстовый помощник, поэтому это прежде всего сравнение сред выполнения, а не состязание двух семейств моделей. Автор прямо отмечает небольшую выборку и изменчивость живого веба в отчете о производительности.
На наш взгляд, окружающий браузерный цикл заслуживает не меньшего внимания, чем модель. Повторный сбор страницы, поиск целевых элементов и признание решений недействительными могут обходиться дороже, чем кажется при простом щелчке. Быстрый движок принятия решений не компенсирует ненадежное описание кнопки, которую он должен выбрать. В репозитории предусмотрена независимая проверка результата, потому что заявление модели о завершении задачи не доказывает, что она действительно завершена.
Именно здесь ограничения демонстрации становятся полезными. Документированная реализация не охватывает все кадры, canvas, загрузки файлов и произвольные клавиатурные виджеты. Оценивая такую систему, команда должна воспроизвести характерные для нее задачи и сценарии отказа, а не делать вывод об общей компетентности браузера по успешному поиску авиарейса. Рассматривайте запись как проверяемое свидетельство одной работающей комбинации компонентов.
Пост о 1 500 письмах — многообещающий пример без нужных знаменателей
16 сентября 2026 года vogel (@ryanvogel) написал в X, что опробовал Jev на 1 500 собственных письмах и остался под впечатлением от результатов классификации. В исходном сообщении есть видео. Это полезный пример реального использования: объем работы конкретен, а источник — сам человек, сообщающий об эксперименте, а не безымянный список гипотетических применений.
Однако это не отчет о точности. В сообщении не указаны общедоступная размеченная тестовая выборка, измеренная доля ошибок, согласие проверяющих или цена ошибок. Число обработанных писем говорит о масштабе эксперимента, но не о правильности результата. Смотрите оригинальную демонстрацию в X, учитывая это различие; видео дано ссылкой, поскольку лицензия на распространение копии отсутствует.
Классификация писем все же подходит для начала оценки, потому что ее можно сделать обратимой. Показывайте рекомендуемые метки рядом с существующим почтовым ящиком, не меняйте исходные сообщения и записывайте исправления. Сравнивайте легко путаемые пары: счет и напоминание об оплате, запрос на отмену и жалобу, где отмена лишь упоминается. Такие случаи показывают, соответствуют ли категории вашему настоящему рабочему процессу.
В первой версии нельзя автоматически удалять письма, отправлять ответы или одобрять транзакции только потому, что классификация выглядит уверенной. Для таких действий нужны иные разрешения, а последствия у них другие. Начните с рекомендаций или очереди на проверку; добавляйте узкое действие только после измерения структуры ошибок. Это предложенная нами процедура оценки, а не утверждение о реализации автора публикации в X.
Doom и Wikiracing наглядно показывают цикл принятия решений
В релиз TypeSafe вошли демонстрация Doom и демонстрация Wikiracing; обе ссылки приведены в официальной статье о запуске. Это наглядные объяснения многократного принятия решений. Они не доказывают, что Jev — универсальная визуальная модель или что она может решать любые задачи планирования.
В примере с Doom модель получает структурированное текстовое описание состояния, а не снимки экрана. В Wikiracing она выбирает из доступных ссылок, а не изобретает URL назначения. Интересен повторяющийся цикл наблюдения, ограниченного выбора и действия. Игровые демонстрации позволяют легко увидеть этот цикл, но не отвечают на вопрос, насколько хорошо он переносится в другую среду.
Такое же разделение показано в документации демонстрации умного дома от TypeSafe. Одни вопросы классифицируют стороны запроса, а другой компонент ведет свободный диалог или разделяет составной запрос. Не следует описывать такую архитектуру как одну модель, которая и генерирует текст, и выполняет все решения. Названия вроде «ассистент» или «агент» часто скрывают эти границы, если реализация не делает их явными.
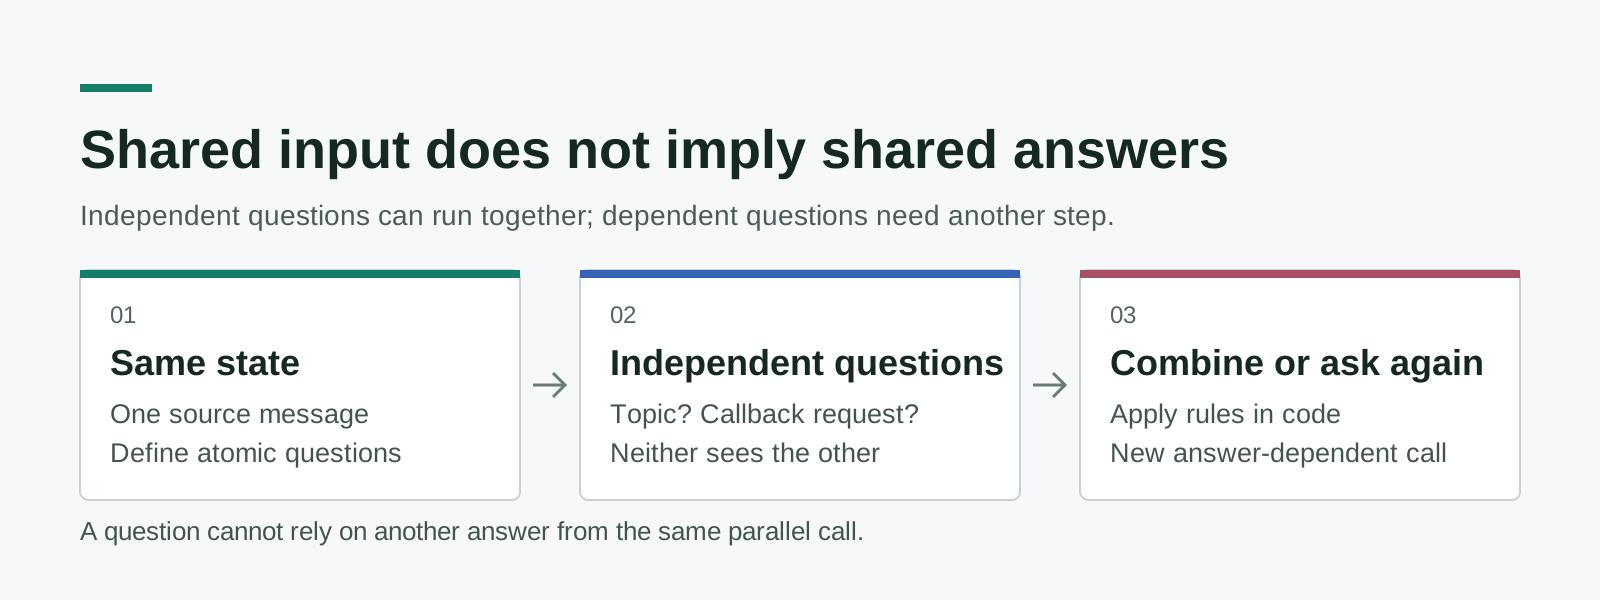
Оригинальная схема, основанная на документированном контракте fan-out. Одновременные вопросы используют общее состояние, но не читают ответы друг друга тайком.
Шаблон fan-out позволяет сократить последовательное ожидание, если несколько вопросов зависят от одного источника. Например, тему сообщения и явную просьбу перезвонить можно оценить независимо. Вопрос, зависящий от только что выбранной темы, не может предполагать, что ответ уже есть в том же вызове. Перенесите эту зависимость в следующий шаг или детерминированно объедините независимые результаты в коде.
Типизированный ответ — еще не правильный ответ
Самая опасная трактовка модели с ограниченным ответом — считать, что правильно оформленный результат не может быть ошибочным. Может. Классификатор способен выбрать разрешенную, но неподходящую метку, а селектор действий — правильную кнопку не в той форме. Устранить некорректный текстовый вывод из интерфейса полезно, но это другой класс проблем, нежели непонимание задачи.
В заметках TypeSafe об особенностях Jev 1.13, в последний раз пересмотренных 17 сентября, описаны слабые места в арифметике, подсчете, сравнении дат, отвлекающем контексте и обработке состязательного ввода. Для точных сравнений разбирайте даты и вычисляйте значения обычным кодом. Не превращайте детерминированное правило в семантическую оценку только потому, что модели можно задать такой вопрос.
Важна и документация по уверенности: Choice и Score предоставляют распределения вероятностей и вычисляемое значение уверенности; у Noul отдельного поля уверенности нет. Это значение не является универсальной вероятностью правильности ответа. Пороговые значения нужно проверять на собственной задаче, особенно если последствия ложноположительного и ложноотрицательного результата различаются.
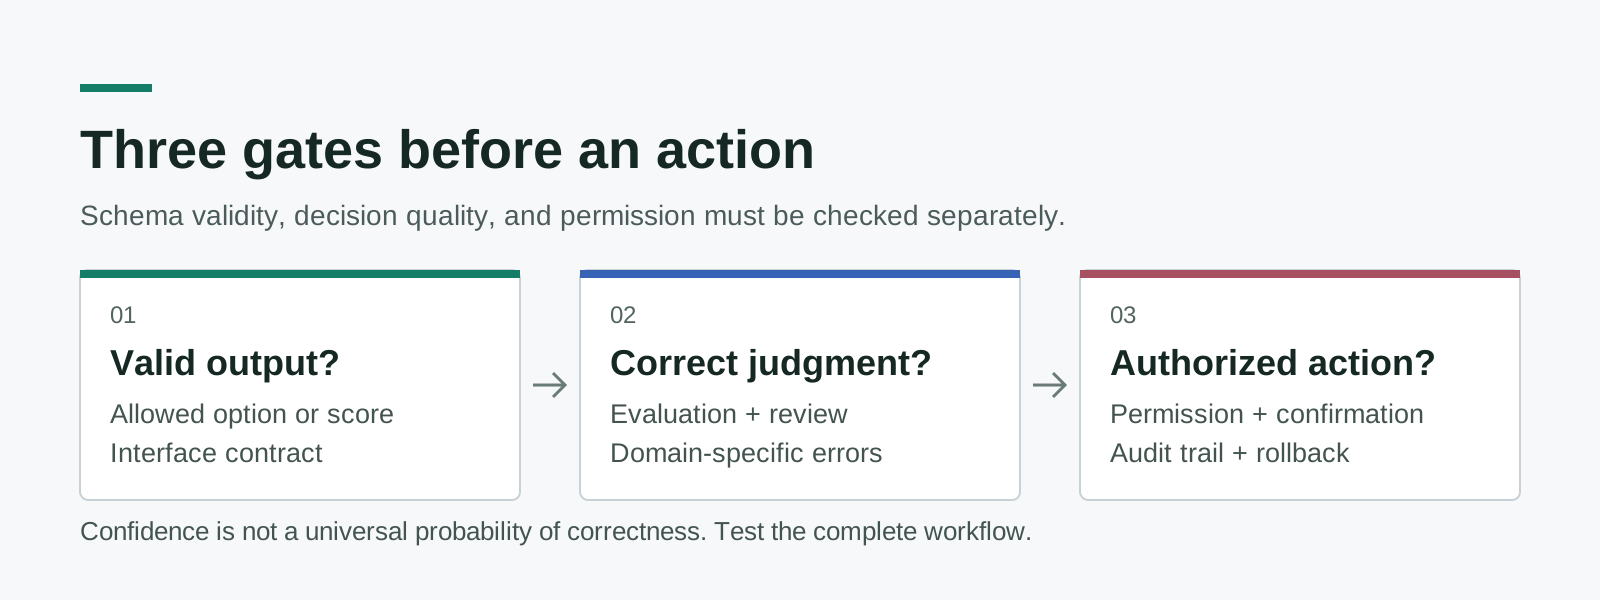
Оригинальная схема оценки. Прохождение одних ворот не означает прохождения следующих; даже допустимый вывод требует правильной интерпретации и разрешенного действия.
Для многоязычных задач проверяйте каждый язык, которым действительно пользуетесь. В документации модели сказано, что основным языком обучения был английский и что качество на других языках, включая языки с письменностью CJK, неоднородно. Поэтому очередь поддержки на корейском или архив рассылок на нескольких языках должны стать отдельными срезами оценки, а не считаться продолжением английского результата. Перевод также способен изменить свидетельства, поэтому при оценке переведенного представления сохраняйте оригинал.
Спланируйте испытание, которое честно допускает неудачу
Полезный пилот начинается с решения, которое команда может последовательно размечать. Выберите обратимую задачу, например рекомендацию очереди поддержки, пометку возможного дубликата или метку документа для последующей проверки. Не определяйте успех по плавности демонстрации. Определите ошибки, которые вы заметите, ошибки, которые можете пропустить, и цену каждой для пользователя.
- Опишите контракт решения. Перечислите возможные результаты, нужные поля источника и вариант проверки. Отделите семантическую интерпретацию от вычислений и разрешений.
- Соберите набор для оценки. Используйте только материалы, обработку которых вы вправе проводить. Включите типичные примеры, неоднозначные границы, разные языки, пустые поля и вредоносные инструкции внутри исходного текста.
- Оставьте контрольную часть. Настраивайте критерии на одном наборе, а затем измеряйте результат на материалах, которые не повлияли на формулировки. Записывайте разногласия, а не меняйте ожидаемый ответ молча.
- Измеряйте рабочий процесс. Отслеживайте ошибки по категориям, долю отправленных на проверку, сквозную задержку, повторы и полную стоимость. Быстрый вызов модели внутри медленного цикла извлечения данных все равно означает медленный продукт.
- Запустите режим рекомендаций. Записывайте выбранный вариант, соответствующие вероятности, версию модели и исправление человека, не выполняя автоматически действия с последствиями.
- Добавьте одно ограниченное действие. Где нужно, требуйте явного разрешения, сохраняйте журнал аудита и предусмотрите откат при смене источника или версии модели.
Эта процедура намеренно строже просмотра записи. Она проверяет, помогает ли модель на распределении ваших случаев, включая неудобные. Высокая доля отправки на проверку может быть предпочтительнее небольшого числа незаметных и дорогостоящих ошибок. Решите, на какой компромисс готовы, до выбора порога, а не после инцидента.
Для воспроизводимой оценки закрепите версию и записывайте версию, указанную в каждом результате. Подвижные псевдонимы удобны для изучения, но их поведение может измениться без правок исходного кода приложения. Материалы оценки должны позволять другому человеку восстановить критерии, вводы, ожидаемые результаты и границы выполнения. Так многообещающий эксперимент становится поддерживаемой функцией, а не подборкой впечатляющих роликов.
Главное: заключите суждение в четкие границы
Jev особенно интересна, когда принимает небольшое проверяемое решение внутри программы, уже знающей свои правила. Видео браузера показывает работающую композицию, публикация о письмах дает конкретный эксперимент, достойный проверки, а официальные демонстрации раскрывают сам цикл. Следующий вопрос не в том, может ли модель выбрать ответ, а в том, способна ли ваша система распознать плохой выбор до того, как он навредит.
Источники и права на медиа
- TypeSafe: Introducing System One Models and Jev, 15 сентября 2026 года; официальный запуск и контекст игровых видеороликов.
- Browser Use: jev-ultrafast, закрепленный источник, изученный 30 сентября 2026 года. GIF и MP4: copyright 2026 Browser Use, лицензия MIT; аффилированность не подразумевается.
- Browser Use: запись и измерения сопоставленных запусков, изучено 30 сентября 2026 года; измерения автора, не наша репликация.
- vogel в X: эксперимент классификации 1 500 писем, 16 сентября 2026 года; сценарий применения со слов автора и оригинальное видео.
- Примитивы TypeSafe, модели, уверенность, шаблон fan-out и демонстрация умного дома, проверено 30 сентября 2026 года.
- Особенности Jev 1.13, последнее обновление 17 сентября 2026 года; проверено 30 сентября.
- Статья о применении Jev на Tistory, 18 сентября 2026 года; отправная точка исследования, а не подтверждение внедрения.
Сохраняйте свидетельства рядом с заметками
Изучая новую модель, сохраняйте источник, дату и то, что именно доказывает демонстрация. Создайте аккаунт Telli.sh, чтобы упорядочивать собственные исследовательские материалы и производные заметки, не смешивая сводку с исходным свидетельством.