Jev decide em vez de conversar: três demos e seus limites
O que Jev, da TypeSafe, realmente faz, com um GIF do Browser Use e uma demo reproduzível, um caso de 1.500 e-mails no X e demos oficiais de jogos. Veja onde decisões tipadas ajudam, onde falham e como avaliar um fluxo de trabalho real.
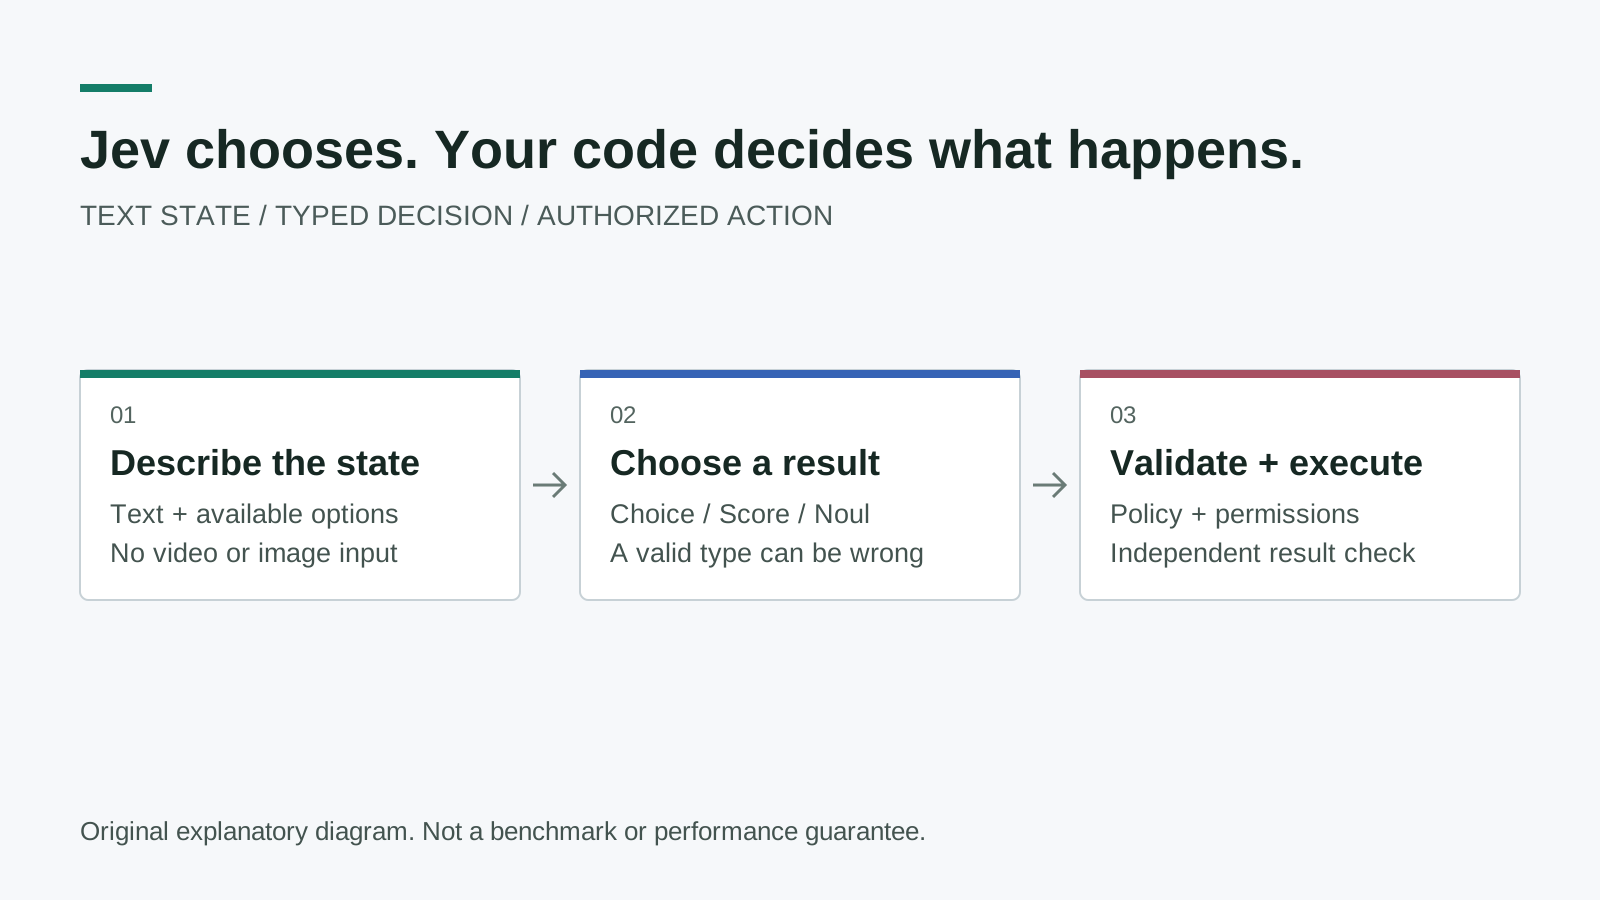
Diagrama explicativo original, não um benchmark do fornecedor. O modelo escolhe dentro de um espaço definido; autorização, validação e execução continuam sob responsabilidade do código da aplicação.
Um classificador de caixa de entrada não precisa escrever um ensaio antes de escolher uma pasta. Um controlador de navegador muitas vezes precisa escolher um botão disponível, não inventar um comando novo. Essas pequenas decisões são o caso mais interessante a favor de Jev, o primeiro modelo System One da TypeSafe AI.
A TypeSafe apresentou Jev em 15 de setembro de 2026. A distinção útil não é simplesmente que ele seja mais um modelo rápido: ele retorna decisões delimitadas, em vez de prosa aberta. Isso muda a forma como você pode construir o programa ao redor, mas não elimina a possibilidade de escolher a resposta errada. Consulte o lançamento oficial para conhecer a apresentação do fornecedor.
Este guia acompanha três demonstrações públicas: uma tarefa no navegador com evidências em GIF e vídeo disponíveis para baixar, o relato de um autor que classificou 1.500 e-mails e as demonstrações de jogos da TypeSafe. Também transformamos esses exemplos em um plano concreto de avaliação. O artigo de casos de uso do Tistory, publicado em 18 de setembro, foi o ponto de partida da pesquisa; as aplicações propostas não são tratadas aqui como implantações em clientes verificadas de forma independente.
Em resumo:
- Jev pode escolher, pontuar ou avaliar uma proposição a partir do texto; não substitui um modelo que escreve texto arbitrário.
- Um resultado tipado válido ainda pode estar semanticamente errado. Mantenha a validação e a autorização final no código.
- A gravação do navegador é real, mas uma única tarefa não constitui um benchmark geral. O exemplo dos e-mails é o relato de um autor, não um estudo de precisão publicado.
- Comece com uma classificação reversível, meça os erros nos seus próprios dados e permita a abstenção como resultado.
Uma resposta curta pode exigir uma pergunta muito clara
As três primitivas centrais da API são Choice, Score e Noul. Choice seleciona entre alternativas nomeadas. Score avalia níveis ordenados e descritos. Noul retorna uma probabilidade para uma proposição de sim ou não; um valor próximo ao meio representa incerteza sobre essa proposição, não um nível de gravidade moderado. A documentação das primitivas define esses contratos.
A mudança prática é definir os resultados possíveis antes de pedir ao modelo que decida. Em vez de solicitar um parágrafo sobre uma mensagem de suporte recebida, você pode perguntar se ela trata de cobrança, acesso à conta, defeito do produto ou uma categoria não resolvida. Sua aplicação então decide qual fila mostrar. O resultado é uma chave de desvio nos trilhos, não o trem inteiro: ajuda a direcionar o trabalho, mas não oferece tudo o que é necessário para concluí-lo.
| Primitiva | Pergunta útil | Responsabilidade da aplicação |
|---|---|---|
| Choice | Qual destas filas corresponde melhor a esta mensagem? | Definir um conjunto completo de opções, incluindo um caminho de revisão |
| Score | Quanto esta mensagem corresponde a estes níveis de urgência descritos? | Definir os níveis e verificar se os avaliadores concordam |
| Noul | Esta mensagem solicita explicitamente um cancelamento? | Decidir qual probabilidade justifica uma revisão ou ação reversível |
Escrever boas alternativas faz parte do trabalho de engenharia. Se dois rótulos se sobrepõem, uma escolha aparentemente confiante pode esconder um problema na taxonomia. Se nenhum rótulo serve, forçar uma seleção disfarça a falta de cobertura como certeza. Uma opção de revisão costuma ser mais valiosa do que outra categoria com nome muito específico, pois revela onde o contrato de decisão precisa melhorar.
Na consulta de 30 de setembro de 2026, a referência do modelo lista jev-1.13.0, entrada somente de texto e o preço de US$ 0.042 por milhão de tokens de entrada, com tokens de saída gratuitos. Esse é o preço dos tokens do modelo, não o custo total de operar um agente. Navegadores, extração, modelos auxiliares, novas tentativas e revisão humana também fazem parte do orçamento operacional.
O GIF do navegador mostra uma busca real, não uma reserva de voo
O repositório público do Browser Use, jev-ultrafast, inclui uma tarefa gravada no Google Flights, de Zurique a Londres. Jev escolhe uma operação e um alvo com base na representação atual da página. Um assistente generativo separado fornece texto quando a operação escolhida exige digitação. É um sistema composto, não uma prova de que o próprio Jev gere todas as frases ou interprete quadros de vídeo.
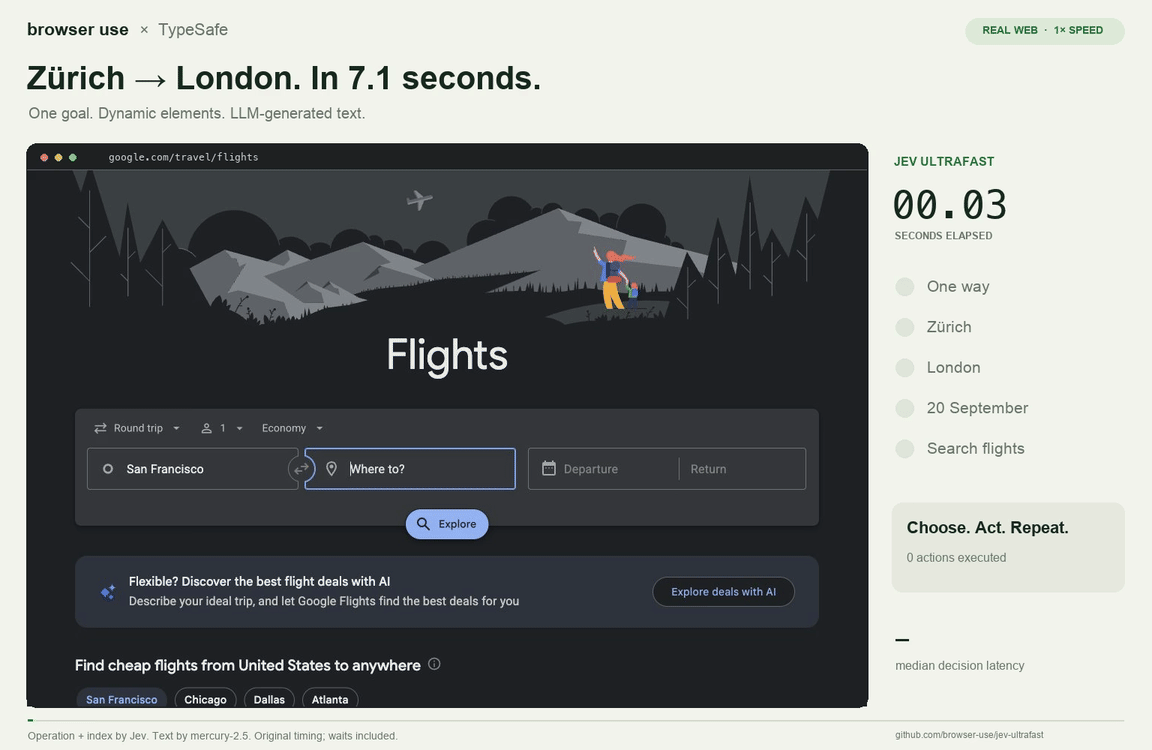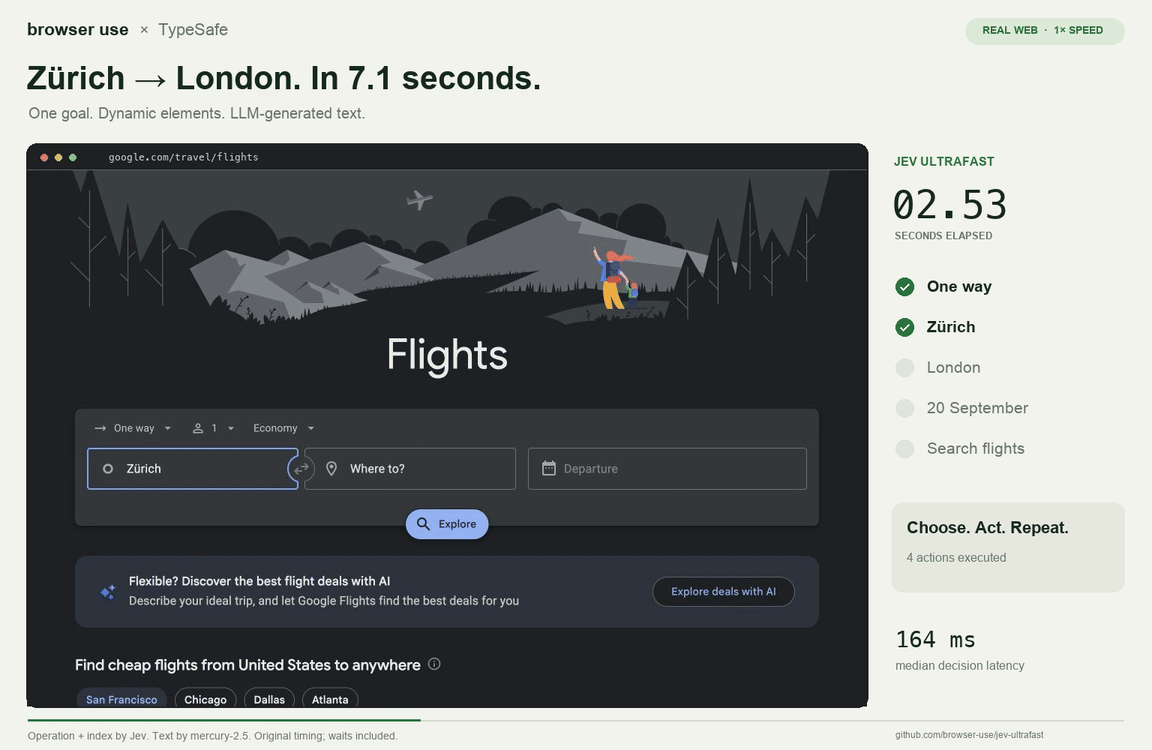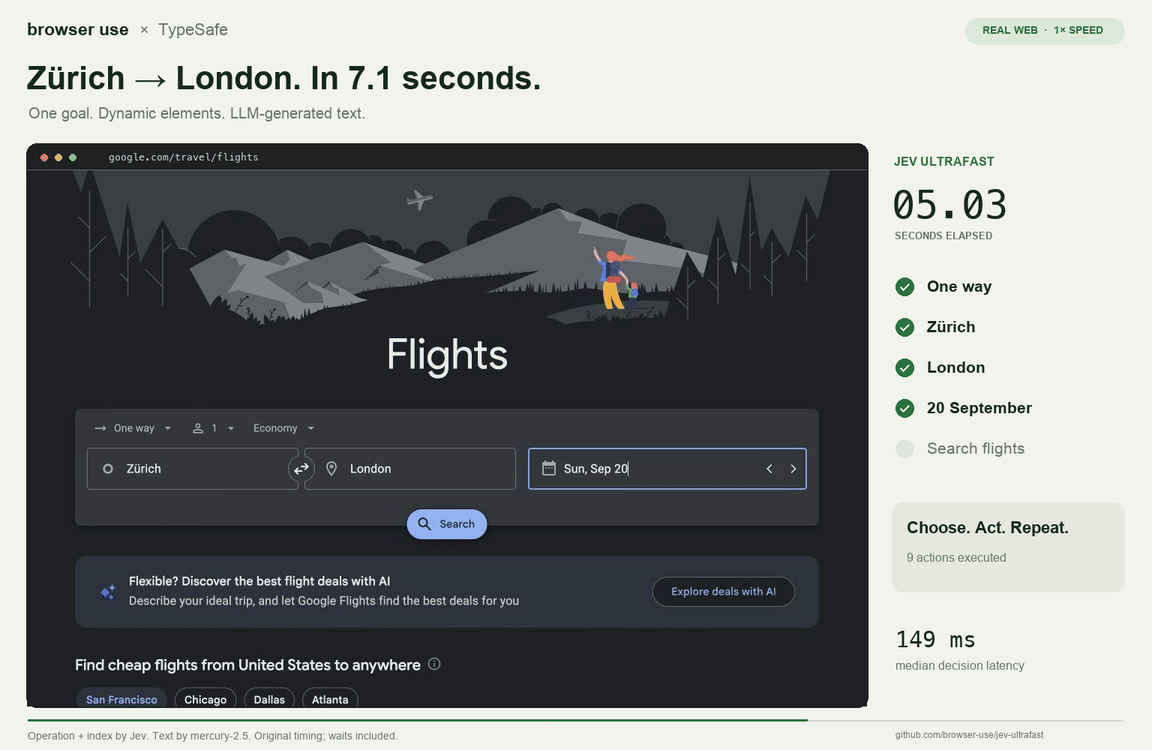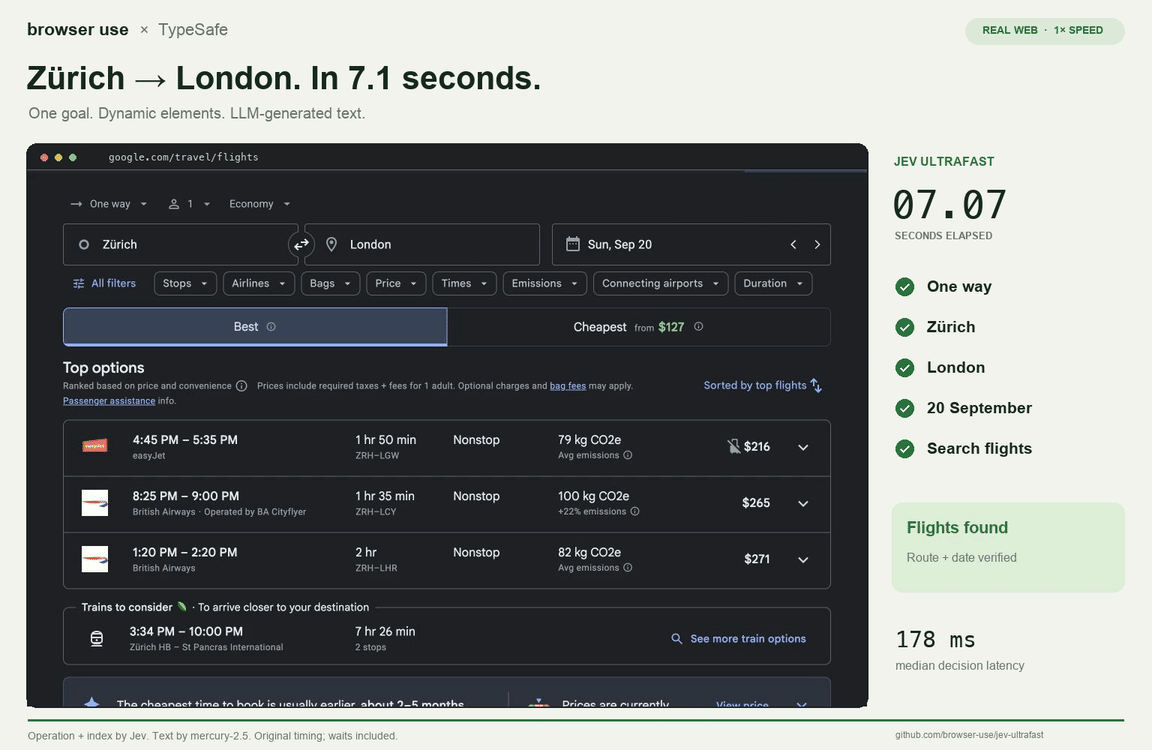
GIF realmente gravado pelo autor do Browser Use e fixado no commit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, licença MIT. Demonstra um fluxo de busca, não uma compra. A mesma gravação pode ser reproduzida abaixo.
MP4 do autor, exibido na velocidade gravada com os controles do navegador. Gravação original e notas de medição; licença MIT mantida. Inspecionamos os materiais públicos; não repetimos esse benchmark.
O tempo de conclusão medido pelo autor para a gravação é de 7.073 segundos. O cronômetro começa na primeira previsão após a observação inicial da página inicial, não quando um navegador novo é iniciado. Preparação, navegação inicial e a nova verificação independente após a execução ficam fora desse intervalo cronometrado. Os resultados da busca são conferidos; nenhum bilhete é selecionado ou comprado. Esses limites são essenciais para entender o significado do número.
O mesmo relatório compara seis execuções alternadas, três para cada runtime. O tempo mediano da tarefa cai de 9.450 segundos para 7.092 segundos, enquanto a mediana de chamadas ao protocolo do navegador cai de 1.092 para 101. Os dois grupos usam Jev e o mesmo assistente de texto; portanto, trata-se principalmente de uma comparação de runtimes, não de duas famílias de modelos. O autor destaca a amostra pequena e a variabilidade da web ao vivo no relatório de desempenho.
Nossa leitura é que o ciclo do navegador ao redor merece tanta atenção quanto o modelo. Coletar a página repetidamente, localizar alvos e invalidar decisões pode custar mais do que a aparente simplicidade de um clique sugere. Um mecanismo de decisão mais rápido não compensa uma descrição pouco confiável do botão que deveria escolher. O repositório mantém uma verificação independente do resultado porque o modelo dizer que terminou não prova que a tarefa foi concluída.
É também aqui que os limites da demo se tornam úteis. A implementação documentada não cobre todos os quadros, canvas, fluxos de upload ou widgets arbitrários de teclado. Uma equipe que a avalia deve reproduzir suas próprias tarefas representativas e caminhos de falha, não concluir que uma busca de voos bem-sucedida demonstra competência geral de navegação. Trate a gravação como evidência inspecionável de uma composição funcional.
O post sobre 1.500 e-mails é promissor, mas faltam denominadores
Em 16 de setembro de 2026, vogel (@ryanvogel) publicou no X que havia experimentado Jev em 1.500 dos próprios e-mails e ficado impressionado com os resultados da classificação. A publicação original inclui um vídeo. É um exemplo útil de uso real porque a carga de trabalho é concreta e a fonte é a pessoa que relata o experimento, não uma lista sem autoria de aplicações hipotéticas.
Ainda assim, não é um relatório de precisão. O post não estabelece um conjunto de teste público rotulado, uma taxa de erro medida, concordância entre avaliadores ou o custo dos erros. A quantidade de mensagens processadas mostra a escala do experimento, não sua correção. Assista à demonstração original no X tendo essa distinção em mente; o vídeo é referenciado, não copiado sem uma licença de redistribuição.
A classificação de e-mails ainda é um ponto de partida sensato para uma avaliação porque pode ser reversível. Mostre rótulos sugeridos ao lado da caixa de entrada existente, mantenha a mensagem original intacta e registre as correções. Compare pares confusos, como uma fatura e um lembrete de pagamento, ou um pedido de cancelamento e uma reclamação que apenas menciona cancelamento. Esses casos revelam se as categorias correspondem ao seu fluxo de trabalho real.
Uma implantação inicial não deve apagar mensagens, enviar respostas ou aprovar transações automaticamente só porque uma classificação parece confiante. Essas ações têm permissões e consequências diferentes. Comece com uma sugestão ou uma fila de revisão; promova uma ação restrita somente depois de medir seu padrão de erros. Este é o procedimento de avaliação que propomos, não uma afirmação sobre a implementação do autor no X.
Doom e Wikiracing tornam visível o ciclo de decisão
O lançamento da TypeSafe inclui uma demonstração de Doom e uma demonstração de Wikiracing, ambas vinculadas pelo artigo oficial de lançamento. Elas são explicações visuais úteis de decisões repetidas. Não provam que Jev seja um modelo visual de uso geral ou que consiga resolver problemas arbitrários de planejamento.
No exemplo de Doom, o modelo recebe uma descrição textual estruturada do estado, não capturas de tela. Em Wikiracing, ele escolhe entre links disponíveis, em vez de inventar um URL de destino. O mecanismo interessante é o ciclo repetido de observação, escolha delimitada e ação. As demonstrações de jogos facilitam enxergar esse ciclo, mas não respondem quão bem ele se transfere para outro ambiente.
A mesma separação aparece na documentação da demo de casa inteligente da TypeSafe. Perguntas diferentes podem classificar aspectos de uma solicitação, enquanto outro componente cuida da conversa livre ou da divisão de uma solicitação composta. Não descreva essa arquitetura como um único modelo que gera linguagem e executa todas as decisões. Nomes como assistente ou agente costumam ocultar esses limites, a menos que a implementação os deixe explícitos.
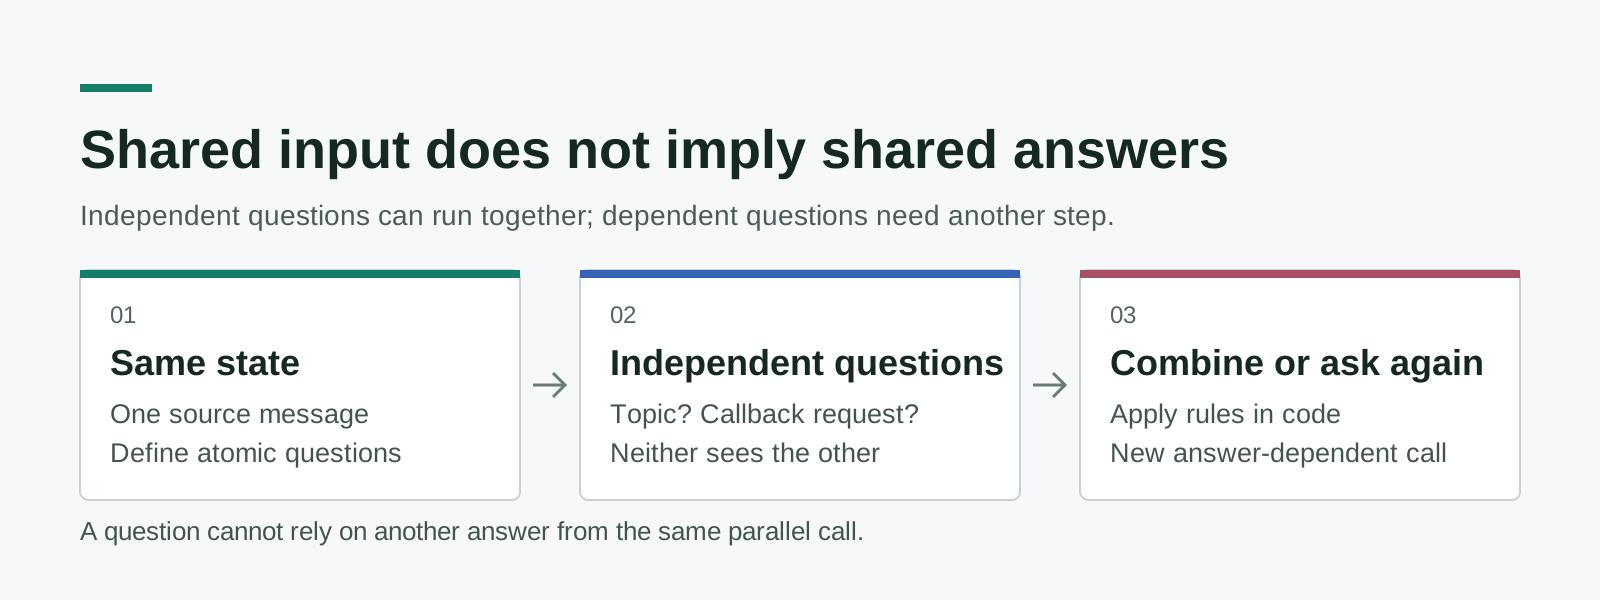
Diagrama original baseado no contrato fan-out documentado. Perguntas simultâneas compartilham o estado; elas não leem secretamente as respostas umas das outras.
O padrão fan-out pode reduzir a espera em série quando várias perguntas dependem da mesma fonte. Por exemplo, o assunto de uma mensagem e se ela solicita explicitamente uma ligação de retorno podem ser avaliados de forma independente. Uma pergunta que dependa de um assunto recém-escolhido não pode presumir que essa resposta já exista dentro da mesma chamada. Separe essa dependência em uma etapa posterior ou combine os resultados independentes de forma determinística no código.
Uma resposta tipada não é o mesmo que uma resposta correta
A interpretação mais perigosa de um modelo delimitado é pensar que uma resposta bem formada não pode estar errada. Pode, sim. Um classificador pode escolher um rótulo permitido, porém inadequado; um seletor de ações pode escolher um botão válido no formulário errado. Eliminar prosa malformada de uma interface é valioso, mas trata de uma classe de falha diferente de entender mal a tarefa.
As notas de irregularidade do Jev 1.13 da TypeSafe, revisadas pela última vez em 17 de setembro, descrevem pontos fracos em aritmética, contagem, comparação de datas, contexto distrativo e entradas adversariais. Para comparações exatas, interprete as datas e calcule quantidades com código convencional. Não transforme uma regra determinística em julgamento semântico só porque o modelo aceita a pergunta.
A documentação de confiança também importa: Choice e Score expõem distribuições de probabilidade e um valor de confiança derivado; Noul não tem um campo de confiança separado. Esse número não representa uma probabilidade universal de a resposta estar correta. Os limiares precisam ser validados para a sua tarefa, especialmente quando as consequências de um falso positivo são diferentes das de um falso negativo.
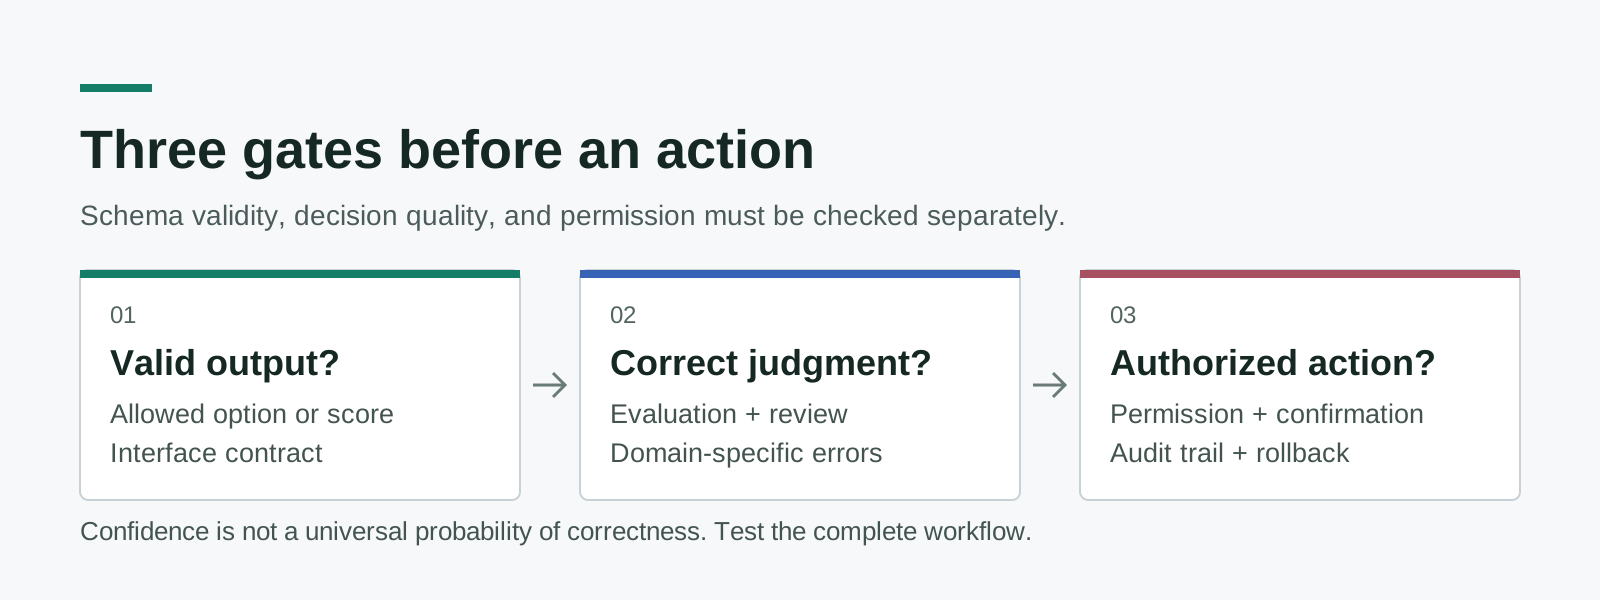
Diagrama original de avaliação. Passar por uma etapa não implica passar pela seguinte; uma saída permitida ainda exige interpretação correta e ação autorizada.
Em trabalhos multilíngues, teste cada idioma que você realmente atende. A documentação do modelo diz que o inglês é o principal idioma de treinamento e que a qualidade não é uniforme nos demais, inclusive nos idiomas com escritas CJK. Uma fila de suporte em coreano ou um arquivo de newsletters em idiomas mistos deve, portanto, ser uma fatia própria da avaliação, não uma extensão presumida de uma pontuação em inglês. A tradução também pode alterar as evidências; preserve o original se avaliar uma representação traduzida.
Monte um teste capaz de admitir honestamente que falhou
Um piloto útil começa com uma decisão que sua equipe consiga rotular de forma consistente. Escolha uma tarefa reversível, como sugerir uma fila de suporte, sinalizar um possível duplicado ou rotular um documento para revisão posterior. Não defina sucesso como uma demo visualmente fluida. Defina os resultados incorretos que você perceberia, os que talvez não percebesse e o custo de cada um para o usuário.
- Escreva o contrato de decisão. Liste os resultados possíveis, os campos de origem necessários e a opção de revisão. Separe a interpretação semântica dos cálculos e das permissões.
- Crie um conjunto de avaliação. Use material que você tem autorização para processar. Inclua itens típicos, limites ambíguos, idiomas mistos, campos vazios e instruções maliciosas dentro do texto de origem.
- Reserve uma parte para teste cego. Ajuste os critérios em um conjunto e depois meça em materiais que não influenciaram a formulação. Registre divergências em vez de redefinir silenciosamente a resposta esperada.
- Meça o fluxo de trabalho. Acompanhe erros por categoria, taxa de revisão, latência de ponta a ponta, novas tentativas e custo total. Uma chamada rápida ao modelo dentro de um ciclo lento de recuperação ainda produz um produto lento.
- Execute em modo de sugestão. Registre a opção escolhida, probabilidades relevantes, versão do modelo e correção humana, sem realizar automaticamente ações de consequência.
- Promova uma única ação delimitada. Exija autorização explícita quando apropriado, mantenha uma trilha de auditoria e preserve um caminho de reversão quando a fonte ou a versão do modelo mudar.
Este procedimento é deliberadamente mais rigoroso do que assistir a uma gravação. Ele pergunta se o modelo ajuda na distribuição dos seus casos, inclusive os difíceis. Uma taxa de revisão aparentemente alta pode ser preferível a poucos erros silenciosos e caros. Decida essa compensação antes de escolher um limiar, não depois de descobrir um incidente.
Fixe uma versão para que a avaliação seja reproduzível e registre a versão retornada junto a cada resultado. Aliases móveis são convenientes para explorar, mas podem mudar o comportamento sem qualquer alteração no código da aplicação. Um artefato de avaliação deve permitir que outra pessoa reconstrua os critérios, as entradas, os resultados esperados e os limites de execução. É assim que um experimento promissor se transforma em um recurso sustentável, em vez de uma coleção de clipes impressionantes.
Em resumo: coloque o julgamento dentro de um contrato delimitado
Jev é mais interessante quando toma uma decisão pequena e inspecionável dentro de um programa que já conhece suas regras. O vídeo do navegador mostra uma composição funcional, o post sobre os e-mails fornece um experimento concreto que vale testar e as demos oficiais deixam o ciclo visível. A próxima pergunta não é se o modelo consegue escolher uma resposta, mas se o seu sistema consegue reconhecer uma escolha ruim antes que ela tenha consequências.
Fontes e créditos de mídia
- TypeSafe: Introducing System One Models and Jev, 15 de setembro de 2026; lançamento oficial e contexto dos vídeos de jogos.
- Browser Use: jev-ultrafast, fonte fixada e consultada em 30 de setembro de 2026. GIF e MP4 copyright 2026 Browser Use, licença MIT; não há afiliação implícita.
- Browser Use: gravação e medições de execuções pareadas, consultadas em 30 de setembro de 2026; medições do autor, não uma reprodução nossa.
- vogel no X: experimento de classificação de 1.500 e-mails, 16 de setembro de 2026; caso de uso relatado pelo próprio autor, com vídeo original.
- Primitivas, modelos, confiança, fan-out e demo de casa inteligente da TypeSafe, consultados em 30 de setembro de 2026.
- Irregularidade do Jev 1.13, revisada pela última vez em 17 de setembro de 2026; consultada em 30 de setembro.
- Artigo de casos de uso do Jev no Tistory, 18 de setembro de 2026; ponto de partida da pesquisa, não verificação de implantação.
Mantenha as evidências junto das suas notas
Ao pesquisar um modelo novo, preserve a fonte, a data e o que a demonstração realmente comprova. Crie uma conta no Telli.sh para organizar sua pesquisa e suas notas derivadas sem confundir um resumo com as evidências originais.