Jev decide invece di conversare: tre demo e i loro limiti
Cosa fa davvero Jev di TypeSafe, con una GIF di Browser Use e una demo riproducibile, il caso dei 1.500 messaggi su X e le demo ufficiali dei giochi. Scopri dove aiutano le decisioni tipizzate, dove falliscono e come valutare un flusso di lavoro reale.
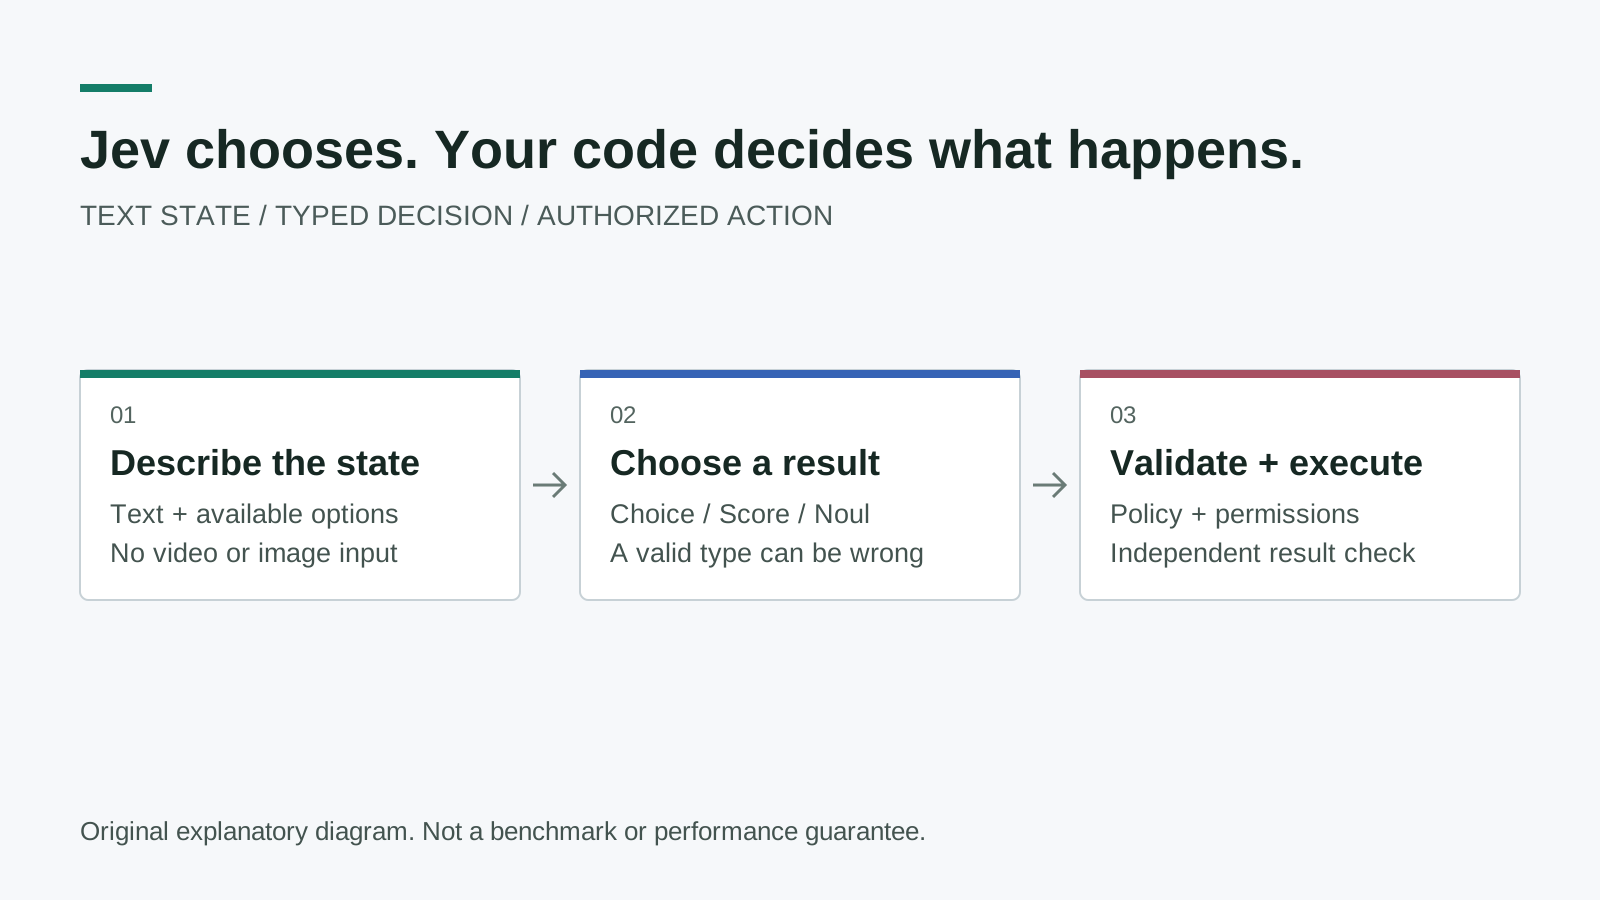
Diagramma esplicativo originale, non un benchmark del fornitore. Il modello sceglie entro uno spazio definito; autorizzazione, convalida ed esecuzione restano responsabilità del codice applicativo.
Un classificatore della posta in arrivo non deve scrivere un saggio prima di scegliere una cartella. Spesso un controller del browser deve scegliere uno dei pulsanti disponibili, non inventare un nuovo comando. Sono queste piccole decisioni il caso più interessante a favore di Jev, il primo modello System One di TypeSafe AI.
TypeSafe ha presentato Jev il 15 settembre 2026. La distinzione utile non è semplicemente che sia un altro modello veloce: restituisce decisioni vincolate invece di prosa aperta. Questo cambia il modo in cui puoi costruire il programma circostante, ma non elimina la possibilità di scegliere la risposta sbagliata. Consulta il lancio ufficiale per la presentazione del fornitore.
Questa guida segue tre dimostrazioni pubbliche: un'attività nel browser con prove GIF e video scaricabili, il resoconto di un autore sulla classificazione di 1.500 email e le demo dei giochi di TypeSafe. Trasformiamo inoltre questi esempi in un piano di valutazione concreto. L'articolo sui casi d'uso di Tistory, pubblicato il 18 settembre, è stato il punto di partenza della ricerca; le applicazioni proposte non vengono considerate implementazioni presso clienti verificate indipendentemente.
In breve:
- Jev può scegliere, assegnare un punteggio o valutare una proposizione a partire dal testo; non sostituisce un modello che genera testo arbitrario.
- Un risultato tipizzato valido può comunque essere semanticamente errato. Mantieni convalida e autorizzazione finale nel codice.
- La registrazione del browser è autentica, ma una singola attività non è un benchmark generale. L'esempio delle email è il resoconto di un autore, non uno studio di accuratezza pubblicato.
- Inizia con una classificazione reversibile, misura gli errori sui tuoi dati e prevedi l'astensione come esito possibile.
Una risposta breve richiede una domanda molto chiara
Le tre primitive fondamentali dell'API sono Choice, Score e Noul. Choice seleziona tra alternative nominate. Score valuta livelli ordinati e descritti. Noul restituisce una probabilità per una proposizione sì/no: un valore vicino al centro indica incertezza su quella proposizione, non un livello di gravità medio. La documentazione delle primitive definisce questi contratti.
Il cambiamento pratico consiste nel definire i possibili esiti prima di chiedere al modello di decidere. Invece di richiedere un paragrafo su un messaggio di assistenza in arrivo, puoi chiedere se riguarda la fatturazione, l'accesso all'account, un difetto del prodotto o una categoria irrisolta. L'applicazione decide poi quale coda mostrare. È uno scambio ferroviario, non il treno intero: aiuta a indirizzare il lavoro, ma non offre tutte le capacità necessarie per completarlo.
| Primitiva | Domanda utile | Responsabilità dell'applicazione |
|---|---|---|
| Choice | Quale di queste code corrisponde meglio al messaggio? | Definire un insieme completo di opzioni, incluso un percorso di revisione |
| Score | Quanto corrisponde il messaggio a questi livelli di urgenza descritti? | Definire i livelli e verificare se i revisori concordano |
| Noul | Questo messaggio chiede esplicitamente una cancellazione? | Decidere quale probabilità giustifica una revisione o un'azione reversibile |
Scrivere buone alternative fa parte del lavoro ingegneristico. Se due etichette si sovrappongono, una scelta apparentemente sicura può nascondere un problema nella tassonomia. Se nessuna etichetta è adatta, forzare una selezione maschera una lacuna di copertura come se fosse certezza. Un'opzione di revisione spesso vale più di un'altra categoria dal nome molto specifico, perché rende visibile dove il contratto decisionale va migliorato.
Al controllo del 30 settembre 2026, la scheda del modello elenca jev-1.13.0, input solo testuale e un prezzo di $0.042 per milione di token di input, mentre i token di output sono gratuiti. È il prezzo dei token del modello, non il costo totale di esecuzione di un agente. Browser, estrazione, modelli ausiliari, nuovi tentativi e revisione umana appartengono anch'essi al budget operativo.
La GIF del browser mostra una ricerca reale, non una prenotazione di volo
Il repository pubblico di Browser Use, jev-ultrafast, include una registrazione di una ricerca su Google Flights da Zurigo a Londra. Jev sceglie un'operazione e un obiettivo dalla rappresentazione corrente della pagina. Un assistente generativo separato fornisce il testo quando l'operazione selezionata richiede di digitare. È un sistema composto, non la prova che Jev generi ogni stringa o interpreti fotogrammi video.
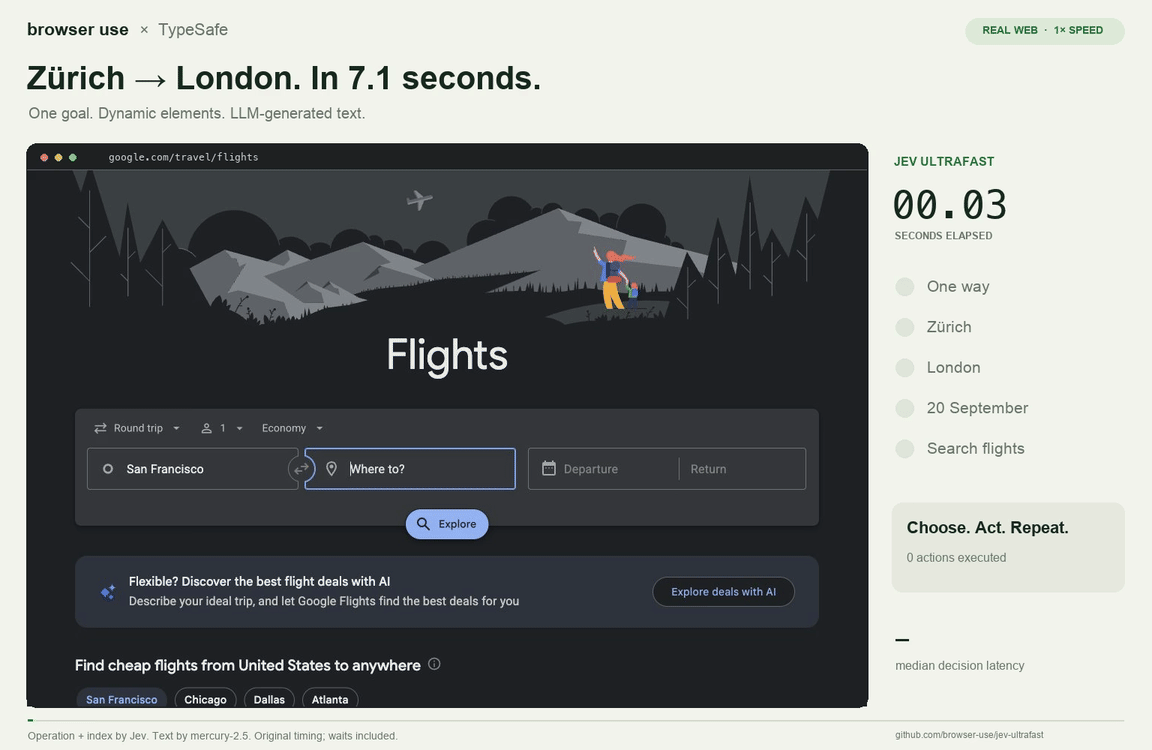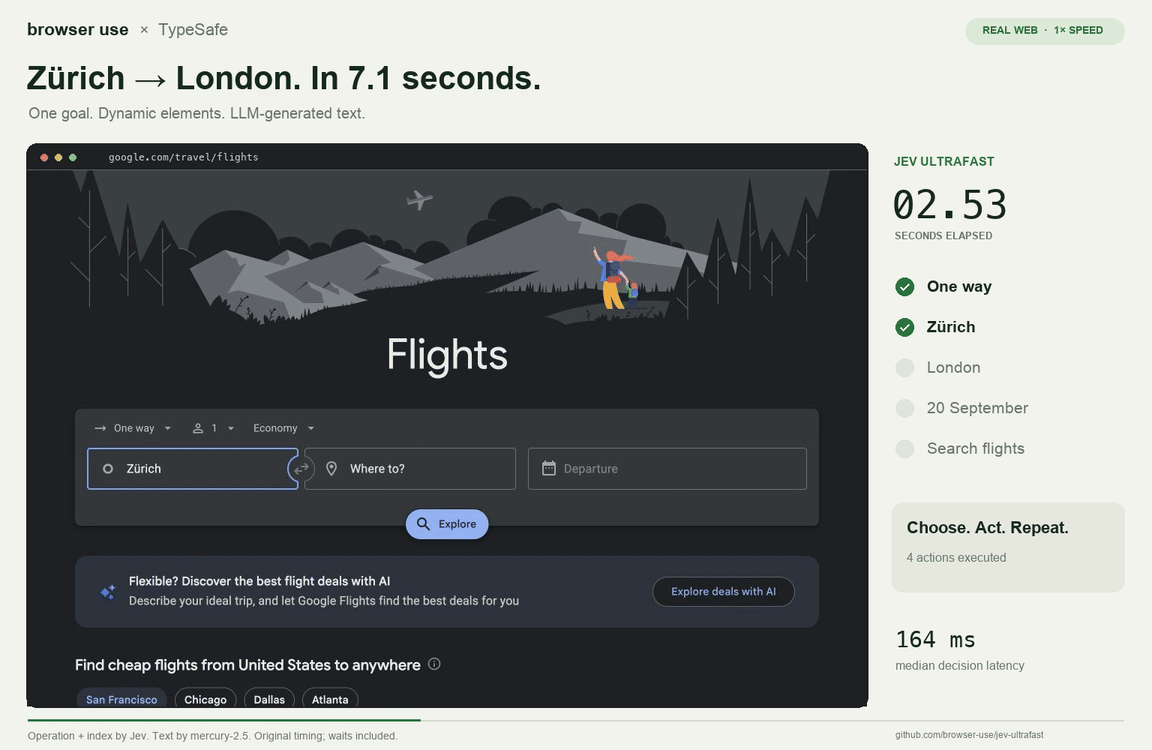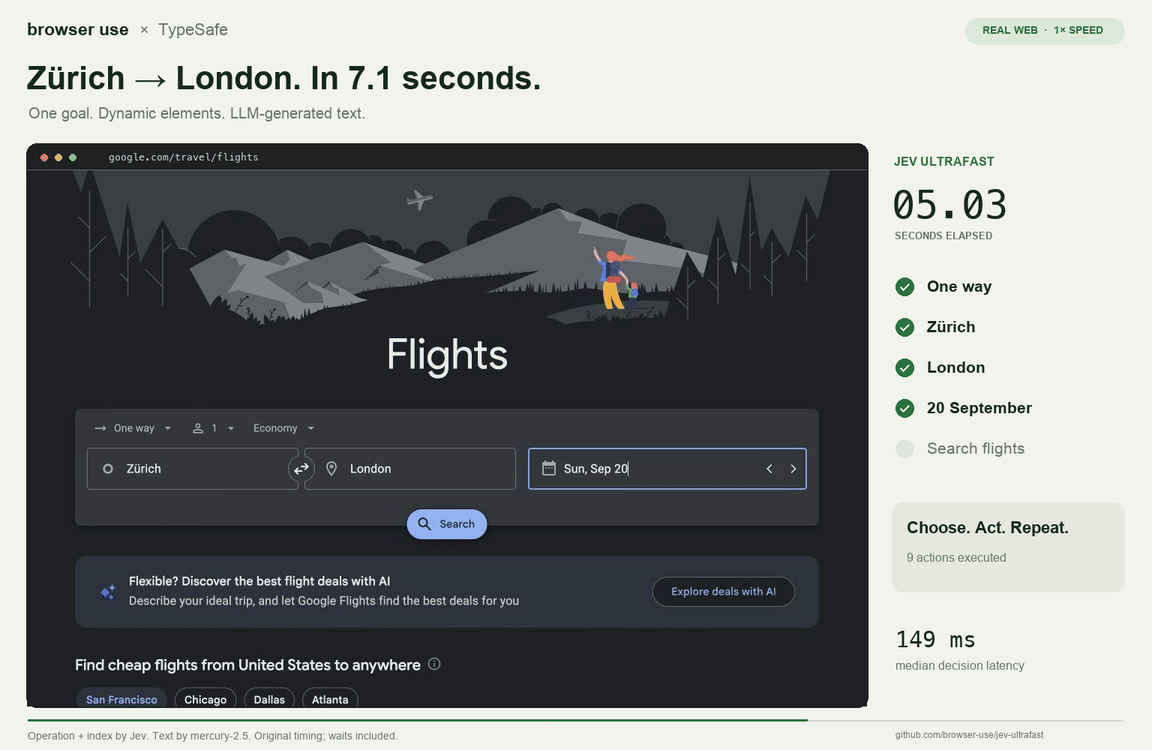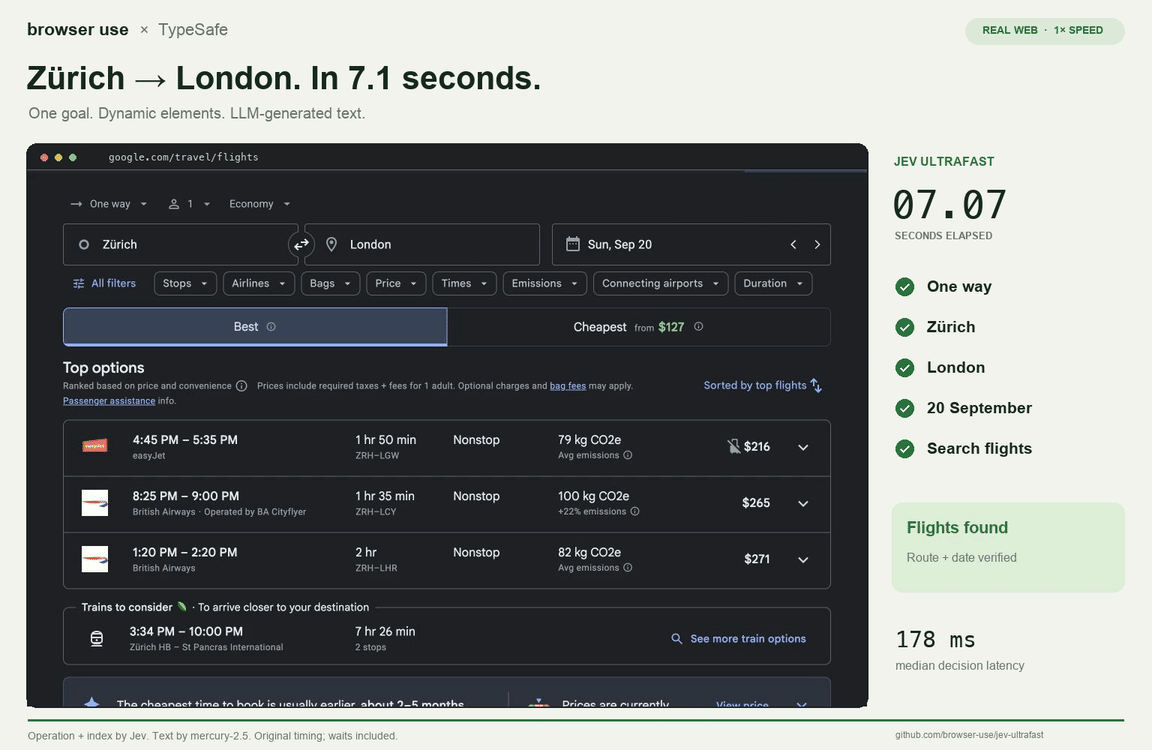
GIF effettivamente registrata dall'autore di Browser Use, fissata al commit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, licenza MIT. Mostra un flusso di ricerca, non un acquisto. La stessa registrazione è riproducibile qui sotto.
File MP4 dell'autore, mostrato alla velocità registrata con i controlli del browser. Registrazione originale e note sulle misurazioni; licenza MIT conservata. Abbiamo esaminato i materiali pubblici, ma non ripetuto questo benchmark.
Il tempo di completamento misurato dall'autore per la registrazione è 7.073 secondi. Il cronometro parte dalla prima previsione successiva all'osservazione iniziale della home page, non dall'avvio di un browser appena aperto. Preparazione, navigazione iniziale e nuova verifica indipendente dopo l'esecuzione sono esclususe dall'intervallo cronometrato. I risultati della ricerca vengono controllati; non si seleziona né acquista alcun biglietto. Questi confini sono essenziali per interpretare correttamente il dato.
Lo stesso resoconto confronta sei esecuzioni alternate, tre per ciascun runtime. Il tempo mediano dell'attività passa da 9.450 secondi a 7.092 secondi, mentre le chiamate mediane al protocollo del browser scendono da 1,092 a 101. Entrambi i gruppi usano Jev e lo stesso assistente testuale: il confronto riguarda soprattutto i runtime, non due famiglie di modelli. Nel rapporto sulle prestazioni, l'autore segnala esplicitamente il campione ridotto e la variabilità del web in tempo reale.
Secondo noi, il ciclo circostante del browser merita tanta attenzione quanto il modello. Raccogliere ripetutamente la pagina, individuare gli obiettivi e invalidare le decisioni può costare più di quanto suggerisca la semplicità apparente di un clic. Un motore decisionale più veloce non compensa una descrizione inaffidabile del pulsante che deve scegliere. Il repository mantiene una verifica indipendente del risultato perché il modello che dice di aver finito non dimostra che l'attività sia stata completata.
È anche qui che i limiti della demo diventano utili. L'implementazione documentata non copre ogni fotogramma, canvas, flusso di caricamento o widget per la tastiera. Un gruppo che la valuta dovrebbe riprodurre le proprie attività rappresentative e i relativi casi di errore, non dedurre da una ricerca di voli riuscita una competenza generale nel browser. Considera la registrazione una prova esaminabile di una composizione funzionante.
Il post sulle 1.500 email è promettente, ma mancano i denominatori
Il 16 settembre 2026, vogel (@ryanvogel) ha pubblicato su X di aver provato Jev su 1.500 email personali e di essere rimasto colpito dai risultati della classificazione. Il post originale include un video. È un esempio utile di uso reale perché il carico di lavoro è concreto e la fonte è la persona che riferisce l'esperimento, non un elenco anonimo di applicazioni ipotetiche.
Non è però un rapporto di accuratezza. Il post non dimostra l'esistenza di un insieme pubblico di test etichettato, di un tasso di errore misurato, dell'accordo tra revisori o del costo degli errori. Il numero di messaggi elaborati indica la scala dell'esperimento, non la sua correttezza. Guarda la dimostrazione originale su X tenendo presente la distinzione; il video è collegato, non copiato senza una licenza di redistribuzione.
La classificazione delle email è comunque un punto di partenza sensato per una valutazione, perché può essere resa reversibile. Mostra le etichette suggerite accanto alla posta in arrivo esistente, lascia intatto il messaggio originale e registra le correzioni. Confronta coppie ambigue, come una fattura e un promemoria di pagamento, oppure una richiesta di cancellazione e un reclamo che la menziona soltanto. Questi casi rivelano se le categorie corrispondono al tuo flusso di lavoro effettivo.
Una prima distribuzione non dovrebbe cancellare automaticamente la posta, inviare risposte o approvare transazioni solo perché una classificazione sembra sicura. Queste azioni comportano permessi e conseguenze diversi. Inizia con un suggerimento o una coda di revisione; promuovi un'azione circoscritta solo dopo aver misurato il suo profilo di errore. Questa è la procedura di valutazione che proponiamo, non un'affermazione sull'implementazione dell'autore del post su X.
Doom e Wikiracing rendono visibile il ciclo decisionale
Il lancio di TypeSafe include una dimostrazione di Doom e una dimostrazione di Wikiracing, entrambe collegate dall'articolo di lancio ufficiale. Sono spiegazioni visive utili di decisioni ripetute. Non dimostrano che Jev sia un modello visivo generalista o che sappia risolvere problemi di pianificazione arbitrari.
Nell'esempio di Doom, il modello riceve una descrizione testuale strutturata dello stato, non schermate. In Wikiracing sceglie tra i link disponibili, anziché inventare un URL di destinazione. Il meccanismo interessante è il ciclo ripetuto di osservazione, scelta vincolata e azione. Le demo dei giochi rendono facile vedere quel ciclo, ma non chiariscono quanto bene si trasferisca a un altro ambiente.
La stessa separazione compare nella documentazione della demo di casa intelligente di TypeSafe. Domande diverse possono classificare aspetti di una richiesta, mentre un altro componente gestisce la conversazione libera o la suddivisione di una richiesta composta. Non descrivere questa architettura come un unico modello che genera linguaggio ed esegue ogni decisione. Nomi come assistente o agente spesso nascondono questi confini, a meno che l'implementazione non li renda espliciti.
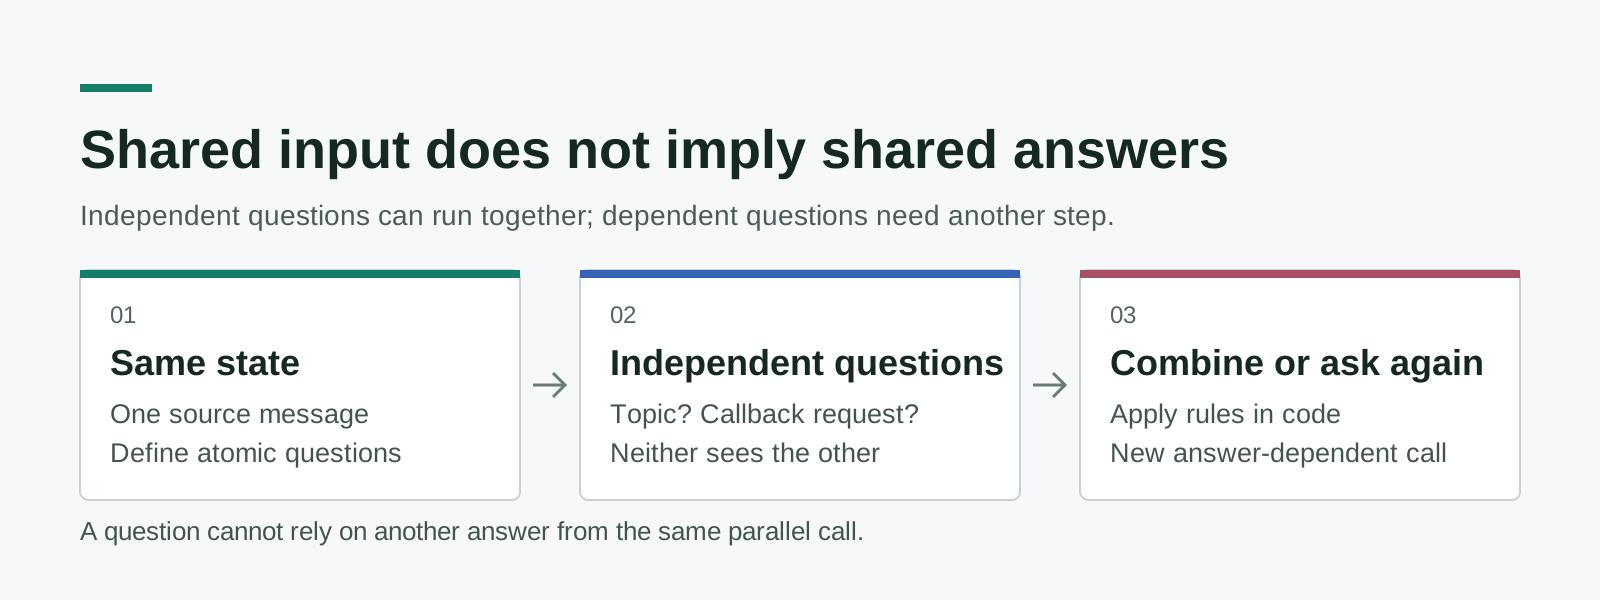
Diagramma originale basato sul contratto fan-out documentato. Le domande simultanee condividono lo stato; non leggono di nascosto le risposte l'una dell'altra.
Il pattern fan-out può ridurre l'attesa seriale quando diverse domande dipendono dalla stessa fonte. Per esempio, si possono valutare indipendentemente l'argomento di un messaggio e la presenza di una richiesta esplicita di richiamata. Una domanda che dipende dall'argomento appena scelto non può presumere che la risposta esista già nella stessa chiamata. Separa la dipendenza in un passaggio successivo oppure combina deterministicamente i risultati indipendenti nel codice.
Una risposta tipizzata non equivale a una risposta corretta
L'interpretazione più pericolosa di un modello vincolato è pensare che una risposta ben formata non possa essere sbagliata. Può esserlo. Un classificatore può scegliere un'etichetta consentita ma inadatta; un selettore di azioni può scegliere un pulsante valido nel modulo sbagliato. Eliminare dalla propria interfaccia la prosa malformata è utile, ma affronta una classe di errori diversa dall'aver frainteso l'attività.
Le note sull'irregolarità di Jev 1.13 di TypeSafe, riviste l'ultima volta il 17 settembre, descrivono debolezze nei calcoli aritmetici, nel conteggio, nei confronti tra date, nel contesto fuorviante e negli input avversari. Per confronti esatti, interpreta le date e calcola le quantità con il normale codice. Non trasformare una regola deterministica in un giudizio semantico soltanto perché il modello può ricevere la domanda.
Conta anche la documentazione sulla confidenza: Choice e Score espongono distribuzioni di probabilità e un valore di confidenza derivato; Noul non ha un campo di confidenza separato. Quel numero non rappresenta una probabilità universale che la risposta sia corretta. Le soglie vanno convalidate sul tuo compito, soprattutto quando le conseguenze di un falso positivo differiscono da quelle di un falso negativo.
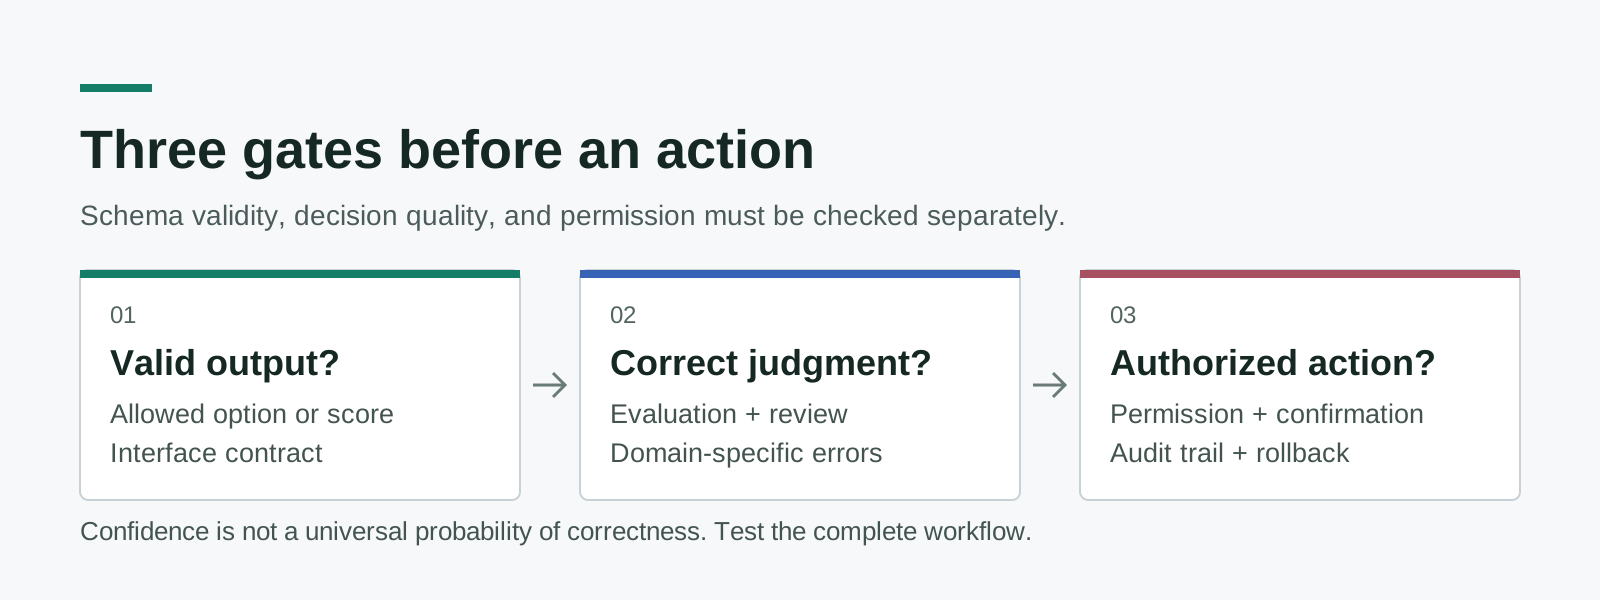
Diagramma originale di valutazione. Superare una verifica non implica superare la successiva: anche un output consentito richiede un'interpretazione corretta e un'azione autorizzata.
Per un lavoro multilingue, prova ogni lingua che usi davvero. La documentazione del modello indica che l'inglese è la lingua principale dell'addestramento e che la qualità non è uniforme nelle altre lingue, comprese quelle con scritture CJK. Una coda di assistenza in coreano o un archivio di newsletter in più lingue dovrebbe quindi costituire una propria sezione di valutazione, non un'estensione presunta di un punteggio inglese. Anche la traduzione può alterare le prove: conserva l'originale quando valuti una rappresentazione tradotta.
Progetta una sperimentazione capace di ammettere i propri errori
Un progetto pilota utile parte da una decisione che il tuo team può etichettare in modo coerente. Scegli un'attività reversibile, come suggerire una coda di assistenza, segnalare un possibile duplicato o assegnare un'etichetta a un documento da rivedere in seguito. Non definire il successo in base alla fluidità della demo. Definisci gli esiti errati che noteresti, quelli che potrebbero sfuggirti e il costo di ciascuno per l'utente.
- Definisci il contratto decisionale. Elenca i possibili esiti, i campi sorgente necessari e l'opzione di revisione. Separa l'interpretazione semantica dai calcoli e dai permessi.
- Crea un insieme di valutazione. Usa materiale che sei autorizzato a elaborare. Includi casi tipici, confini ambigui, lingue miste, campi vuoti e istruzioni malevole contenute nel testo sorgente.
- Tieni da parte una porzione di controllo. Affina i criteri su un insieme, poi misura su materiale che non ne ha influenzato la formulazione. Registra i disaccordi invece di ridefinire in silenzio la risposta attesa.
- Misura il flusso di lavoro. Tieni traccia degli errori per categoria, del tasso di revisione, della latenza end-to-end, dei nuovi tentativi e del costo totale. Una chiamata veloce al modello dentro un ciclo di recupero lento resta un prodotto lento.
- Esegui in modalità suggerimento. Registra l'opzione scelta, le probabilità pertinenti, la versione del modello e la correzione umana, senza eseguire automaticamente azioni rilevanti.
- Promuovi una sola azione circoscritta. Richiedi un'autorizzazione esplicita dove serve, conserva una traccia di controllo e mantieni una procedura di ripristino quando cambiano la fonte o la versione del modello.
Questa procedura è volutamente più rigorosa che guardare una registrazione. Verifica se il modello aiuta sulla distribuzione dei tuoi casi, compresi quelli scomodi. Un tasso di revisione apparentemente alto può essere preferibile a pochi errori silenziosi e costosi. Decidi questo compromesso prima di scegliere una soglia, non dopo aver scoperto un incidente.
Fissa una versione per rendere riproducibile la valutazione e registra quella restituita con ogni risultato. Gli alias mobili sono comodi per esplorare, ma possono cambiare comportamento senza alcuna modifica al codice applicativo. Un artefatto di valutazione dovrebbe permettere a un'altra persona di ricostruire criteri, input, esiti attesi e confini di esecuzione. Così un esperimento promettente diventa una funzionalità manutenibile, anziché una raccolta di clip impressionanti.
In sintesi: porta il giudizio entro un contratto circoscritto
Jev è più interessante quando prende una decisione piccola e verificabile all'interno di un programma che già conosce le proprie regole. Il video del browser mostra una composizione funzionante, il post sulle email offre un esperimento concreto da provare e le demo ufficiali rendono visibile il ciclo. La domanda successiva non è se il modello sappia scegliere una risposta, ma se il tuo sistema sappia riconoscere una scelta sbagliata prima che abbia conseguenze.
Fonti e crediti dei contenuti multimediali
- TypeSafe: Introducing System One Models and Jev, 15 settembre 2026; lancio ufficiale e contesto dei video di gioco.
- Browser Use: jev-ultrafast, fonte fissata e consultata il 30 settembre 2026. GIF e MP4 copyright 2026 Browser Use, licenza MIT; non si implica alcuna affiliazione.
- Browser Use: registrazione e misurazioni delle esecuzioni abbinate, consultate il 30 settembre 2026; misurazioni dell'autore, non una nostra riproduzione.
- vogel su X: esperimento di classificazione di 1.500 email, 16 settembre 2026; caso d'uso auto-riferito con video originale.
- Primitive, modelli, confidenza, fan-out e demo di casa intelligente di TypeSafe, consultati il 30 settembre 2026.
- Irregolarità di Jev 1.13, ultima revisione il 17 settembre 2026; consultata il 30 settembre.
- Articolo sui casi d'uso di Jev su Tistory, 18 settembre 2026; punto di partenza della ricerca, non verifica di una distribuzione.
Conserva le prove accanto alle tue note
Quando fai ricerche su un nuovo modello, conserva la fonte, la data e ciò che la dimostrazione prova davvero. Crea un account Telli.sh per organizzare il tuo materiale di ricerca e le note derivate senza confondere un riepilogo con le prove originali.