Dieses Start-up behielt Claude und Codex und verlagerte die Dokumentationsarbeit auf lokale KI
Grayhat Developers versuchte, seine kostenpflichtigen Coding-Agenten zu ersetzen. Schließlich übernahmen lokale Modelle Dokumentation, Tickets und Übergaben. Die Fallstudie zeigt, wie sich diese Arbeitsteilung testen lässt.
Ein Entwickler bittet einen Coding-Agenten, einen Fehler in einem Dienst zu beheben. Zuerst muss der Agent das ursprüngliche Ticket finden, einige Produktentscheidungen abrufen und herausfinden, welche Anforderungen noch gelten. Nach dem Patch muss jemand die übrigen Aufgaben in Tickets überführen, die eine Designerin oder der Support sehen kann. Die Codeänderung ist nur ein Teil des Auftrags, doch alle Schritte können beim selben kostenpflichtigen Modell landen.
Grayhat Developers, ein Softwareunternehmen mit weniger als 40 Beschäftigten, beschrieb in einem Preprint vom 5. November 2026, was geschah, als das Team diese Aufgaben trennte. Die Entwickler hatten selbst gehostete Modelle für die Entwicklung ausprobiert. Beim Ersatz ihrer kommerziellen Coding-Agenten wurden manche Arbeiten im Repository langsamer oder schwieriger. Für komplexe Änderungen behielten sie die bisherigen Agenten bei. Einen Teil der Dokumentensuche, der Aufbereitung und des Ticketabgleichs übernahm ein lokaler Dienst.
Für ein anderes kleines Team stellt sich die Frage, welche Arbeit es zuerst verlagern kann. Grayhats Erfahrungen bieten einen konkreten Einstieg, eine Schätzung, deren Annahmen einen genaueren Blick verdienen, und ein Beispiel dafür, wie eine ungeschickte Einführung einen Pilotversuch ausbremsen kann, bevor das Team überhaupt etwas über die Modellqualität erfährt.
Eine Fehlerbehebung braucht Kontext, bevor sie den Code berührt
Grayhat setzte Outline für die Dokumentation, Plane zur Aufgabenverwaltung und ERPNext für Organisationsinformationen ein. Diese Dienste liefen bereits auf einem Rechner im Büro. Die Identitätsverwaltung war über Authentik angebunden. Auch die Konnektoren für das Model Context Protocol, kurz MCP, liefen auf demselben Rechner. Ein zweiter Rechner übernahm die Modellinferenz. Das hatte einen praktischen Grund. Dokumentation und Ticketsystem konnten ihre gewohnten Oberflächen weiter bereitstellen, während Modellprozesse anderswo Rechenleistung beanspruchten.
Im beschriebenen Ablauf übergeben Menschen die Arbeit. Ein Teammitglied nutzt das interne Modell, um Material aus dem Wiki oder Ticketsystem zu finden und zusammenzufassen. Die relevanten Teile lassen sich in einer Datei im Repository für einen Coding-Agenten bereitstellen. Nach der Arbeit im Repository kann ein Teammitglied die nächsten Schritte an den internen Assistenten zurückgeben, Ticketentwürfe daraus erstellen und sie ins Ticketsystem übertragen. Die direkte Kommunikation zwischen Agenten nennt die Studie als zukünftige Arbeit. Schon heute kann eine Person die Informationen am Übergabepunkt sehen und entscheiden, welche davon weitergegeben werden dürfen.
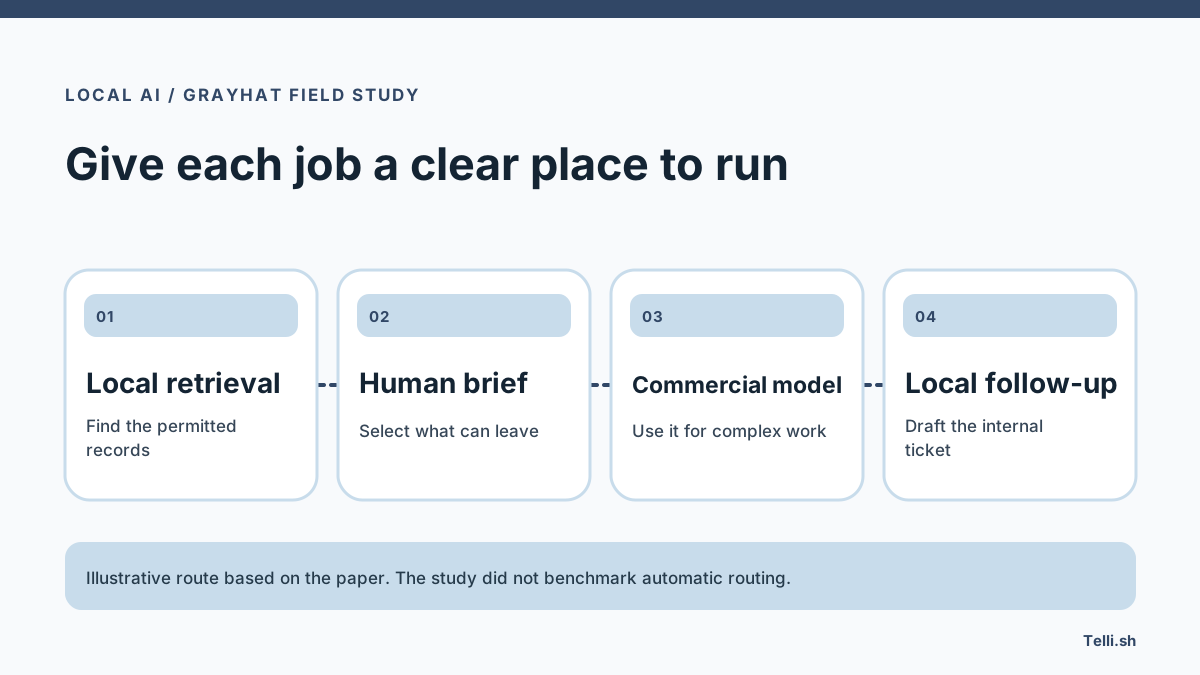
Übergabepunkte in Grayhats Arbeitsablauf. Eigene Illustration von Telli.sh auf Grundlage der Fallstudie vom 5. November.
Angenommen, ein Kunde meldet, dass ein Export Zeilen doppelt ausgibt. Die ursprüngliche Meldung enthält eine vertrauliche Kontoreferenz und ein für den Fehler irrelevantes Gesprächsprotokoll. Ein lokaler Assistent kann die aktuellen Exportregeln, die für den Dienst zuständige Person und den bisherigen Workaround finden. Der Entwickler kann daraus eine Aufgabenbeschreibung mit einem künstlichen Beispieldatensatz und der erwarteten Zeilenzahl erstellen. Der Coding-Agent erhält, was er braucht, um den Fehler zu reproduzieren. Vertrauliche Informationen bleiben in den internen Systemen, weil ein Mensch entschieden hat, welche Daten weitergegeben werden.
Die Originalverweise gehören in den internen Entwurf. Widersprechen sich Anforderungen, kann die prüfende Person feststellen, ob eine vorgeschlagene Regel aus einer aktuellen Entscheidung oder einer alten Behelfslösung stammt. Wenn eine lokal erzeugte Zusammenfassung ihre Quellen verliert, entsteht ein ähnliches Problem wie zuvor. Das nächste Teammitglied muss wieder herausfinden, welcher Beschreibung es trauen kann.
Das Team bezahlte für KI-Dienste und schätzte, wie viel Arbeit es verlagern konnte
Als Ausgangswert für kommerzielle KI nennen die Autoren rund 325 US-Dollar monatlich. Davon entfielen ungefähr 175 Dollar auf sieben Claude-Plätze, 140 Dollar auf sieben Codex-Abos und 10 Dollar auf Guthaben. Außerdem berichten sie von über 25,93 Milliarden erfassten Tokens über die Dienste hinweg. Ob die Tokenzahl aus demselben Abrechnungszeitraum wie die 325 Dollar stammt, geht aus dem Papier nicht hervor. Beide Zahlen beantworten unterschiedliche Fragen. Aus ihrem Verhältnis lässt sich kein verlässlicher Tokenpreis ableiten.
Das Team schätzte, dass Kontextübergaben, Dokumentation und Projektkoordination 30–40 % der Arbeit mit kommerzieller KI ausmachten. Davon könnte das lokale System nach Einschätzung der Autoren etwa 90 % übernehmen. Daraus ergeben sich 27–36 % des gesamten kommerziellen Arbeitsvolumens. Auf den Ausgangswert von 325 Dollar umgerechnet entspricht das etwa 88–117 Dollar im Monat. Die Fallstudie vom 5. November schätzt Arbeitsanteile und deren rechnerischen Gegenwert. Ein kontrollierter Vorher-nachher-Vergleich von Rechnungen fand nicht statt.
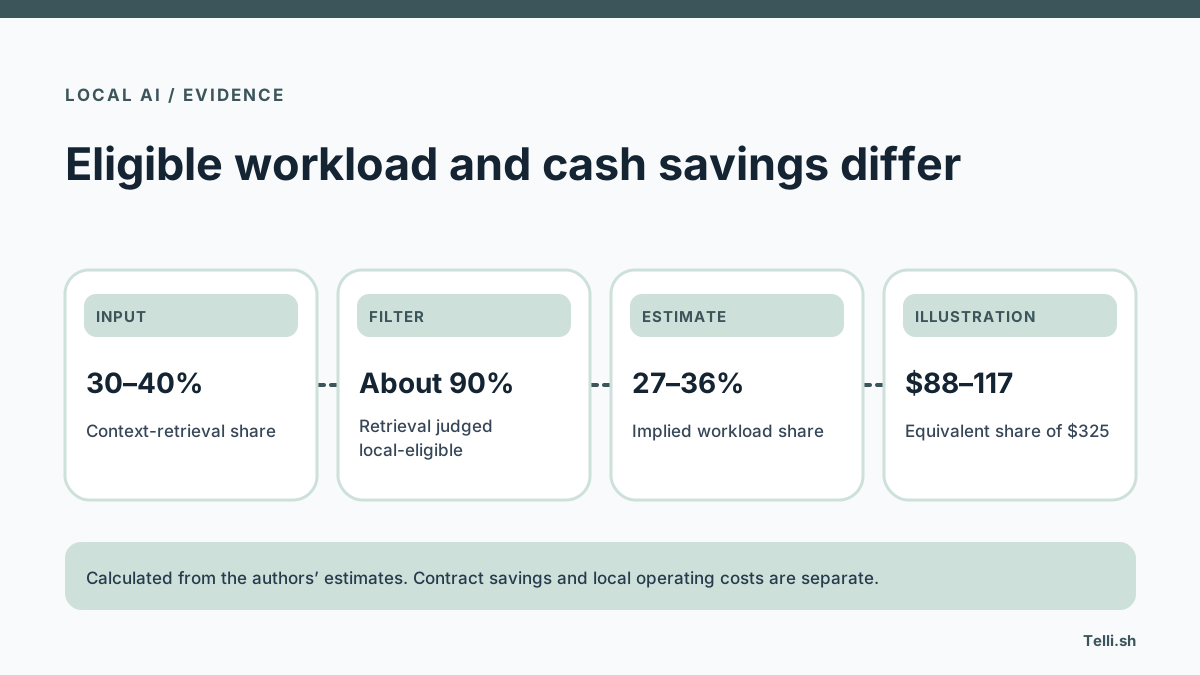
Grayhat rechnet einen geschätzten Anteil der Arbeit in einen Kostengegenwert um. Eigene Illustration von Telli.sh.
| Zahl aus dem Preprint | Was sie beschreibt | Wie sie sich nutzen lässt |
|---|---|---|
| 325 US-Dollar monatlich | Genannter Ausgangswert für kommerzielle Abos und Guthaben | Vergleichbaren Ausgangswert aus den eigenen Rechnungen ermitteln |
| 30–40 % | Geschätzter Anteil für Koordination und Kontextarbeit | Wiederkehrende Aufgaben erfassen, bevor ein weiterer Dienst installiert wird |
| Rund 90 % | Geschätzter lokal abdeckbarer Anteil der Koordinationsaufgaben | Ergebnisse für jede Aufgabe mit den zuständigen Prüfenden abgleichen |
| 27–36 % und 88–117 US-Dollar monatlich | Geschätzter verlagerter Arbeitsanteil und sein rechnerischer Gegenwert | Rechnungen und Modellnutzung getrennt auswerten |
| 10–30 US-Dollar monatlich | Laufende Kosten des lokalen Modells laut Tabelle der Autoren | Hardware und Wartungszeit separat berücksichtigen |
Bei Abrechnung pro Platz macht diese Unterscheidung einen Unterschied. Wenn sieben Entwickler ihr Abo weiterhin für komplexe Arbeit brauchen, kann die nächste Rechnung trotz sinkender Nutzung gleich bleiben. Der Nutzen kann sich in zusätzlicher Kapazität für Patches, weniger Druck durch Nutzungslimits oder weniger Zukäufen zeigen. Bei Abrechnung nach Anfragen können sich die Kosten früher ändern, doch wiederholte Versuche und Warteschlangen können einen Teil der Einsparung aufzehren. Muss das Team eine neue GPU anschaffen und für ihren Betrieb Arbeitszeit einplanen, gehört auch das in den Vergleich.
Wählt eine Bezugsgröße, die sich überprüfen lässt. Ticketentwürfe sind leicht zu zählen. Muss die Projektleitung ein Ticket allerdings komplett neu schreiben, ist das kaum ein Beleg für Zeitersparnis. Erfasst angenommene Aufgabenbeschreibungen und Tickets sowie Änderungen, die den Sinn eines Auftrags betreffen. Sobald Prüfende brauchbare Ausgaben einheitlich erkennen, lässt sich der Aufwand für ihre Erstellung messen.
Die zweite Oberfläche verlagerte die Einrichtung zum zentralen Betrieb
Beim ersten Anlauf verwendete das Team LobeHub. Die Entwickler bekamen eine Anleitung, mit der sie ihre eigene Oberfläche an interne Werkzeuge anschließen sollten. Laut den Autoren führten vielversprechende Demos nicht zu regelmäßiger Nutzung. Die Beschäftigten mussten wissen, welcher Konnektor zuständig war, wo sie ihn fanden und wie sie sich authentifizierten. Jede zusätzliche Entscheidung verzögerte die erste brauchbare Antwort.
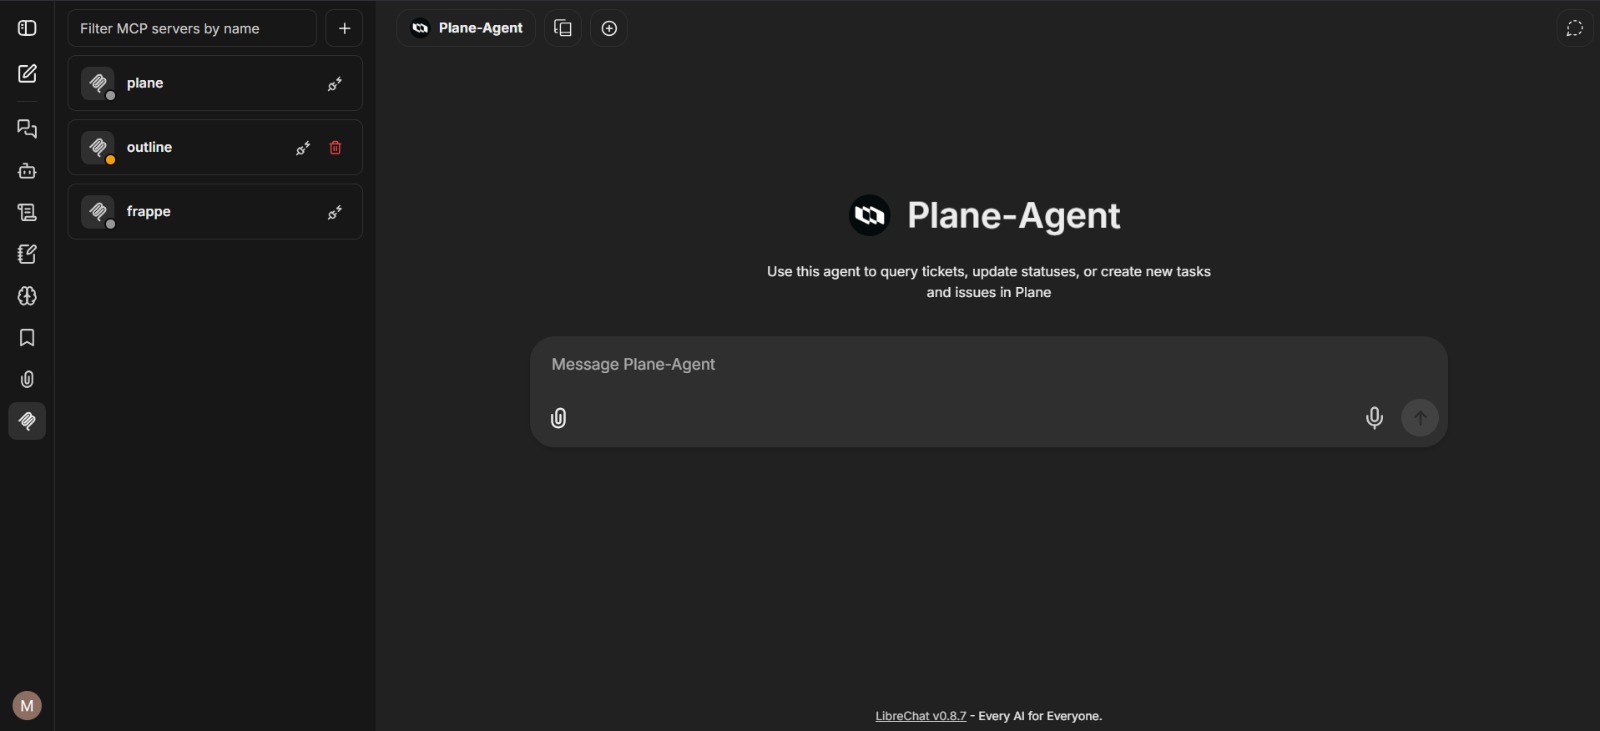
In Grayhats zweiter Oberfläche waren die Arbeitswerkzeuge zentral eingerichtet. Abbildung 2 aus „Create Your Own Work Stack“ von Saad Ahmed Bazaz, Talha Amjad, Abdurrehman Subhani, Sohaib Ahmed Bazaz und Abdullah Aamir, CC BY 4.0.
Das Team wechselte zu einer zentral konfigurierten LibreChat-Installation. Die Nutzer konnten die eingerichteten Werkzeuge sehen und sich beim Zugriff darauf anmelden. Für die erste Version zählten die Autoren acht Bemerkungen zur Einrichtung und Einführung aus elf strukturierten Interviews. Zur zweiten Version kamen drei entsprechende Bemerkungen über unstrukturiertes Discord-Feedback. Die Zahlen stammen aus unterschiedlichen Erhebungen. Sie helfen, die Einstiegshürde zu erkennen. Wie stark die Nutzung stieg oder wie vielen Beschäftigten die Hürde erspart blieb, lässt sich daraus nicht ablesen.
Die erste Sitzung lässt sich um eine kleine, reale Aufgabe herum aufbauen. Eine Projektleiterin, die sich anmeldet, um die Abnahmekriterien für ein Ticket nachzuschlagen, sollte sehen können, ob das Ticketsystem verbunden ist und welches Konto aktiv ist. Ein Entwickler, der drei Tickets entwerfen möchte, sollte sie vor dem Absenden prüfen können. Muss ein Team erst die Konfiguration von Konnektoren lernen, bevor es seine eigene Arbeit findet, misst der Pilotversuch schnell die Geduld der Beteiligten.
Eine zentrale Einrichtung bringt zusätzliche Verantwortung. Jemand muss die Liste erlaubter Konnektoren pflegen, Zugangsdaten wechseln und erklären, wer Berechtigungen ändern darf. Sonst kann eine fehlerhafte Konfiguration alle betreffen. Umgekehrt kann das Team ein wiederkehrendes Einrichtungsproblem einmal beheben und die Korrektur allen Nutzern des Dienstes bereitstellen.
Das lokale System braucht Aufgaben mit klarer Zuständigkeit
Die Sichtung von Fehlermeldungen eignet sich als Einstieg. Der interne Assistent kann ähnliche Meldungen gruppieren und eine Zusammenfassung mit Links zu den ursprünglichen Tickets vorschlagen. Die Projektverantwortlichen entscheiden, ob zwei Meldungen tatsächlich dasselbe Problem beschreiben und ob in der gemeinsamen Fassung eine Bedingung fehlt. Der Assistent kann einen Kommentar zur Gruppierung vorbereiten. Durch die sichtbare Zuständigkeit kann eine Person nachvollziehen, was geändert wurde.
Die Dokumentationspflege ist eine andere Aufgabe. Angenommen, eine Änderung verschiebt eine Einstellung auf einen anderen Bildschirm. Der Assistent kann veraltete Hilfeseiten finden, die betroffenen Produktvarianten erkennen und Änderungsvorschläge erstellen. Ein Redakteur überprüft den aktuellen Navigationspfad und veröffentlicht die richtigen Änderungen. Ein leistungsfähigeres entferntes Modell hilft wenig, wenn die größte Schwierigkeit darin besteht, die aktuellen internen Seiten zu erreichen und den Geltungsbereich jedes Artikels zu erhalten.
Komplexe Entwicklung ist das Gegenbeispiel. Eine Datenbankmigration kann es erfordern, alte Datenverträge zu prüfen, mehrere Dienste zu ändern und einen Rollback zu validieren. Grayhats getestete lokale Installation hatte bei umfangreicheren Arbeiten im Repository Schwierigkeiten, besonders wenn das Modell viel Kontext brauchte und zeitnah antworten sollte. Die Studie beschreibt die Hardware, Modelle und Erfahrungen dieses Teams. Sie spricht dafür, die eigene Arbeitslast lokal zu testen, bevor weitere Aufgaben hinzukommen.
Für Aufgaben, die einfache Formatierung mit vertraulichen Daten verbinden, bietet sich ein klar begrenzter Ablauf an. Ein aus dem Netzwerk versandter Entwurf kann Informationen offenlegen, auch wenn die ursprünglichen Werkzeuge vor Ort laufen. Erfordert eine Aufgabe eine externe Übergabe, sollte das Ziel freigegeben und nur das dafür nötige Material erstellt werden. Ohne Freigabe bleibt das interne Ergebnis zur Prüfung zurück. Bei einer Zeitüberschreitung hilft eine sichtbare Fehlermeldung, damit keine unerwartete Übertragung stattfindet.
Ein kurzer Pilotversuch trennt brauchbare Ergebnisse vom Betriebsaufwand
- Drei Ergebnisse festlegen. Wählt eine verlinkte Aufgabenbeschreibung zu einem Ticket, eine Dokumentationsänderung und einen Ticketentwurf. Notiert für jedes Ergebnis in einem Satz, wer es abnimmt und welche Belege nötig sind. Bewahrt neben einem gelungenen Beispiel auch ein misslungenes auf, einschließlich leicht zu übersehender Fehler.
- Den bisherigen Ablauf messen. Zählt in einer normalen Arbeitswoche abgeschlossene Beispiele, inhaltliche Korrekturen und die Zeit für die Kontextsuche. Ordnet die kommerzielle Nutzung nach Möglichkeit den einzelnen Abläufen zu. Haltet fest, ob eine Verlagerung die Zahl der bezahlten Plätze oder Zukäufe ändern würde. Erfasst separat die Arbeit, die das Team bislang ganz vermieden hat.
- Ein internes Werkzeug anbinden. Beginnt mit Lesezugriff und einem festgelegten Projekt. Prüft, ob eine berechtigte Person ein bekanntes Ticket abrufen kann und eine projektfremde Person nicht. Beschränkt den Versuch auf wenige Personen, die die ausgewählten Aufgaben bereits erledigen. Bietet einen klaren manuellen Weg, wenn das Werkzeug ausfällt.
- Entwürfe vergleichen, bevor Schreibzugriff dazukommt. Lasst dieselbe Person Ergebnisse nach denselben Kriterien annehmen oder ablehnen. Erfasst falsch verlinkte Tickets, überholte Fakten und unbelegte Schlüsse. Richtet Vorschau, Freigabe und dauerhafte Aufzeichnung ein, bevor der Assistent ein echtes Ticketsystem ändern darf.
- Nachsehen, was sich verschoben hat. Vergleicht angenommene Arbeit, Prüfzeit, aktive Nutzung und Rechnungen. Rechnet Zeit für Rechnerpflege, Ausfälle und Konnektoränderungen hinzu. Berücksichtigt auch persönliche Einrichtungshilfe. Eine Anwendung, die erst nach zehn Minuten Einzelbetreuung pro Person funktioniert, verursacht weiterhin Einführungskosten.
Wenn bereits ein lokales Modell für Entwickler läuft, lässt sich der Pilot parallel zum normalen Betrieb durchführen. Warteschlangen entstehen, wenn mehrere Personen gleichzeitig loslegen. Ein Dienst kann eine einzelne Anfrage rasch bearbeiten und drei Personen trotzdem warten lassen. Zeitkritische Aufgaben brauchen eine sichtbare Fortschrittsanzeige und einen Rückweg zum gewohnten manuellen Ablauf. So bleibt der Pilot nutzbar, während das Team ermittelt, welche Arbeitslast zum Dienst passt.
Der Anhang liefert eine Größenordnung. Der Rechner für die internen Werkzeuge hatte 16 GB Arbeitsspeicher. Der separate Inferenzrechner hatte 32 GB und eine RTX 4080 mit 16 GB VRAM. Mit wachsendem Betriebsbedarf ergänzte das Team laut Studie Netzwerküberwachung, Zeitplanung und eine unterbrechungsfreie Stromversorgung. Das hilft bei der Kalkulation. Zum Betrieb eines Dienstes, auf den sich Kollegen verlassen, gehören auch die Kosten jenseits der Modellantwort.
Wo die nächste Stunde KI-Arbeit am besten aufgehoben ist
Der übertragbare Ansatz besteht darin, Kontextaufbereitung und spezialisiertes Schlussfolgern zu trennen und jeder Übergabe eine zuständige Person zuzuordnen. Beginnt mit einer wiederkehrenden Aufgabe, deren Ergebnis das Team bereits beurteilen kann. Messt den Aufwand bis zur Abnahme und entscheidet dann, ob der lokale Ablauf eine weitere Aufgabe übernehmen soll. Grayhats Erfahrungen zeigen, wie diese Entscheidung möglich ist, während die weiterhin nützlichen Coding-Werkzeuge im Einsatz bleiben.
Quellen
- Preprint von Grayhat Developers vom 5. November 2026
- Volltext mit Schätzungen zum Arbeitsaufwand, Infrastruktur und Abbildung 2
- Originalbild von Abbildung 2
- Lizenz CC BY 4.0 für die Abbildung der Studie

Um die Gespräche hinter einer Übergabe durchsuchbar festzuhalten, erstelle ein Telli.sh-Konto.