Granite Switch 4.1:让英文语音转化为可用的下一步决策
动手体验 Granite Switch 4.1,再搭建实用的聊天、英文转写与决策工作流,了解真实的部署、记忆、隐私和成本注意事项。
一条口头请求通常需要三类处理:听清说了什么、解释它的含义、决定接下来该做什么。Granite Switch 4.1 把这些能力放在一个端点后面,不必再拼装三个互不相关的模型服务。
IBM 于 2026 年 10 月 15 日宣布推出已组合好的 8B 和 30B 版本,包含聊天、通用决策适配器、Guardian 安全筛查和语音识别。它的实际吸引力在于:从一段英文语音备忘到可审核的行动,路径更短了。IBM 发布文章,2026 年 10 月 15 日
本指南先从一个小型浏览器练习开始,然后介绍本地部署和三个实际工作流。你也会了解几个必须划清的边界:英文音频不等于多语言音频,决策分数不等于证据,模型权重也不等于 GPU 的全部内存预算。
头图:原创编辑示意图,展示英文音频转成转写文本,再分流到聊天回复、决策选项和安全筛查。最终行动须经人工审核;这不是官方截图,也不代表性能结论。
先获得一个有用结果,再考虑安装
先试用官方 Speech to Decisions 演示。IBM 在 10 月 15 日的公告中链接了它;演示自身的文档介绍了实时麦克风输入、简短主题说明、安全检查和是/否判断。官方演示文档,核对于 2026 年 10 月 18 日
-
打开演示,只使用虚构且不敏感的内容。这是托管服务,不是本地处理。
-
如果应用可用,允许麦克风访问,然后用英语说出下面这段内容;英语是受支持的 ASR 语言:
口述内容的中文释义是:“替换键盘送到时已经损坏。请寄一把新的来。我明天可以提供照片。”
纯文本The replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow. -
停止录音,将屏幕上的转写文本与实际说出的内容逐句比较。分别检查主题描述和可用的判断标记。
-
确认请求、损坏的物品和承诺的后续事项都保留下来了。如果转写漏掉否定词或把物品改错,即使主题标签听起来合理,也不能算成功。
这是一个有用的首要检查点:输入清晰,输出可供检查。它不保证用词完全一致、延迟固定或演示始终可用。如果 Space 暂不可用,或组织不允许向外部服务上传音频,就转到下方的本地路径,不要把私人素材提交到别处。
Switch 到底切换了什么?
基础语言模型处理一般聊天。适配器是较小的一组训练调整,用来让模型专精某项任务。decision 适配器会从带标签的选项中作选择;guardian-core 会筛查文本中的特定安全风险。应用通过聊天模板选择适配器,而不必再加载完整的第二个语言模型。Granite Switch 仓库,核对于 2026 年 10 月 18 日
语音采用不同路径。自动语音识别(ASR)先将波形转换为文本,再交给语言模型读取。套件中的识别器是 IBM 的 4.7 亿参数英文 Granite Speech TurboCTC 模型,核对于 2026 年 10 月 18 日。可以把这份转写看作交接凭据:下游每一步都依赖记录在这里的文字。请将它和任何润色后的摘要一起保留,读者才能从有疑问的决策追溯到原始输入。
| 检查点 | 状态与适用起点 | 音频能力 |
|---|---|---|
granite-switch-4.1-8b | 已发布;较小的即用型组合 | 内含英文 ASR |
granite-switch-4.1-30b | 已发布;基础模型更大,能力组合相同 | 内含英文 ASR |
granite-switch-4.1-3b-preview | 预览版,适配器组合不同 | 不是已发布的语音版组合 |
8B 模型卡,发布于 2026 年 10 月 14 日区分了支持音频的正式版本与无音频的预览系列。30B 模型卡和 3B 预览版模型卡于 2026 年 10 月 18 日核对,分别介绍了各自的组合。更小的预览版并不能直接替代语音版本。
8B 模型卡列出 12 种聊天语言:英语、德语、西班牙语、法语、日语、葡萄牙语、阿拉伯语、捷克语、意大利语、韩语、荷兰语和中文。这份列表并不会让默认语音识别器也支持英语以外的语言。
先根据操作系统,再决定复制哪组命令
下面的 CUDA/vLLM 配置适用于有兼容 NVIDIA GPU 和驱动的 Linux。Windows 用户需要配置妥当且能访问 GPU 的 WSL 环境;这些 Bash 命令不能直接在原生 PowerShell 中运行。macOS 用户应从托管演示或 Linux GPU 主机开始,不要假定这套 CUDA 配方能直接迁移到 Apple Silicon。vLLM GPU 安装指南,核对于 2026 年 10 月 18 日
vLLM-Metal 和其他运行时有各自的兼容路径。运行时支持你的操作系统,并不能证明这个具体的 Switch 检查点、适配器和语音级联都能在那里工作。选用该路径前,应先找到适用于相同配置的示例。
先从本地聊天开始,再加入音频与决策
在 Linux 或 WSL 的 Bash 终端中新建工作目录。先安装 Git 和 Python 3.12,并确认 nvidia-smi 能看到 GPU。此处使用的仓库版本要求 Python >=3.11,<3.14、PyTorch >=2.11.0、Transformers >=5.16,<=5.17.0 和 vLLM >=0.26.0,<0.31.0。版本 7e72456 中的依赖声明,核对于 2026 年 10 月 18 日
- 同时安装 Switch 软件包和音频依赖。 固定到源码配方,避免依赖较早发布的 wheel。
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
不同可选依赖承担不同任务:[hf] 添加 Hugging Face 推理支持,[compose] 添加组合工具,[audio] 则安装 vLLM 的音频解码依赖。只安装 vllm 并不会安装 Switch 插件。PyTorch/CUDA 解析出的组合要与你的驱动兼容;不要为了绕过依赖错误而移除依赖检查。首次使用时会下载模型权重,因此要为检查点预留磁盘空间和部署时间,再开始录音。
- 启动仅绑定本机回环地址的服务端。 以下上下文和并发限制是较保守的起始设置,不代表一定能适配你的硬件。
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
该软件包会在 vllm.general_plugins 中注册 register_granite_switch。vLLM 会发现已安装的入口点;环境变量用于显式选择该插件。此配方不需要复制注册脚本,也不需要 --trust-remote-code 变通方案。Switch 注册源码及 vLLM 插件系统,核对于 2026 年 10 月 18 日。
- 检查普通聊天回复。 在第二个 Bash 终端中等待服务就绪,然后运行:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
读取 JSON 响应中的 assistant 消息。成功意味着保留了原请求,没有编造订单号、截止时间或退款批准。仅仅收到 HTTP 响应,并不能证明答案有用。
- 发送一段简短的英文 WAV。 在仓库目录放入一段已获录音同意、且不含敏感内容的
request.wav。在第二个终端激活相同虚拟环境,将下列脚本保存为try_audio.py,然后运行python try_audio.py。
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
这会通过内部插入的转写文本返回语言模型回复,不会导出未经改动的 ASR 结果。音频指南说明了级联结构和输入格式;如果需要分别查看两个阶段,请使用能展示转写文本的应用。音频文档,核对于 2026 年 10 月 18 日
- 使用经过审核的文本,尝试一次范围明确的决策。 保持服务端运行并发送:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
这会测试适配器选择,并要求返回一个标签,而不是概率报告。若要查看概率,请按模型卡中的决策示例(核对于 2026 年 10 月 18 日)操作:确认标签是单 token,取回对应的 logprob_token_ids,并在候选标签范围内归一化。决策适配器的读出文档,核对于 10 月 18 日解释了选项级 softmax。不要用聊天模型写一句“我有 95% 的把握”来冒充这个结果。
让三个工作流可审核,而不只是自动运行
以下均为示意用法,不是已报告的试验结果。先让输出帮助人们审核工作,再考虑加入会造成实际后果的操作。
为客户语音留言分流。 用 ASR 捕捉请求,让聊天模型起草中性摘要,再用决策问题在换货、账户支持和人工分诊中选择。将原始音频与审核过的转写关联保存。“请不要取消我的订单”应该成为有意设计的测试案例,而不是取消自动化已经上线后才想到的边界情况。
验收标准很具体:选定的队列是否符合实际说的话?任何内容发出之前,客服人员能否先修改?安全标记可以提示进一步审核,但不应悄悄抹掉沮丧客户的投诉。
将项目进展整理成任务草稿。 假设同事在一段英文录音里说:“我周五可以审核草稿,但不能批准预算。”让聊天模型区分承诺和排除事项,再问决策适配器是否明确提到预算批准。若录音或上下文不足,要保留“无法确定”选项。任务进入共享跟踪系统前,由人核实日期和责任人。
准备访谈后的跟进问题。 在获得说话者许可后,转写一段简短的英文访谈,并起草有关缺失细节的问题。使用范围明确的判断,例如“这段话是否明确给出了交付日期?”,而不是“这个人值得信任吗?”。保留能支持每项标记的原文片段。意见不同时,人们便可以针对证据讨论,而不必把模型的理解当成对说话者的定性。
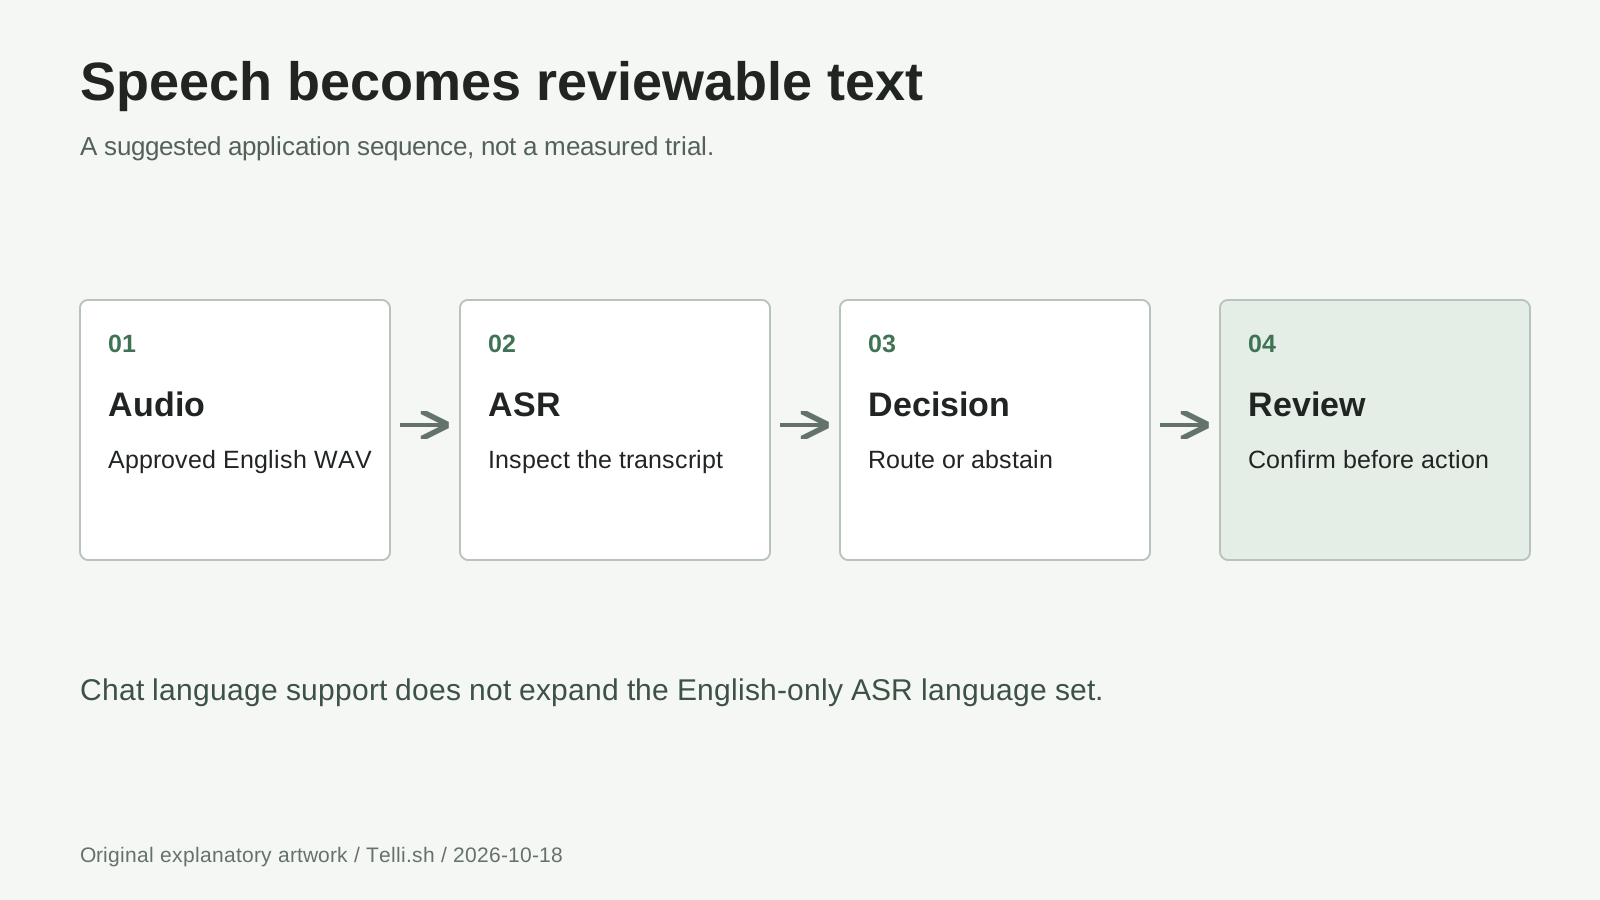
原创工作流示意图:保留音频和转写,将派生输出分开,然后在行动前审核。它说明的是以上应用,并非官方界面;底层级联结构见音频指南,核对于 2026 年 10 月 18 日。
为什么几种能力可以共用同一段上下文?
键值缓存会保存前面 token 计算出的注意力信息。激活式 LoRA(aLoRA)让专用适配器可以在共享上下文之后激活,不必像普通适配器那样重新处理整段前缀。IBM 于 2025 年 4 月 17 日发表的研究说明介绍了这种底层方法。IBM Research:aLoRA
Switch 使用归一化后的基础模型缓存状态,避免不同专家相互消耗对方私有的适配状态。在应用中,要保持证据前缀完全相同,只追加针对具体任务的问题。每次检查都用不同方式改写转写文本,会妨碍前缀复用。Switch 机制文档,核对于 2026 年 10 月 18 日
共享缓存是效率机制,不是免费的推理。前缀缓存能减少重复处理提示词,但不会免掉生成回复或识别音频。vLLM 前缀缓存文档,核对于 2026 年 10 月 18 日。我们的看法是:应比较完整且经过审核的工作流,而不是孤立的宣传速度。
按完整工作负载做预算,而不只看 8B 权重
作为规划计算,80 亿个参数按每个 2 字节计约占 16GB,即 14.9GiB;300 亿个参数约占 60GB,即 55.9GiB。这些只是基础权重的算术示例,不是检查点大小或最低显存要求。它们不包含适配器、语音编码器、缓存、临时缓冲区和运行时开销。
上下文越长、并发序列越多,内存压力就越大。模型宣称的上下文上限不代表第一次试验就应该用满。vLLM 文档将调低 max_model_len 和 max_num_seqs 列为内存控制手段。vLLM 内存指南,核对于 2026 年 10 月 18 日
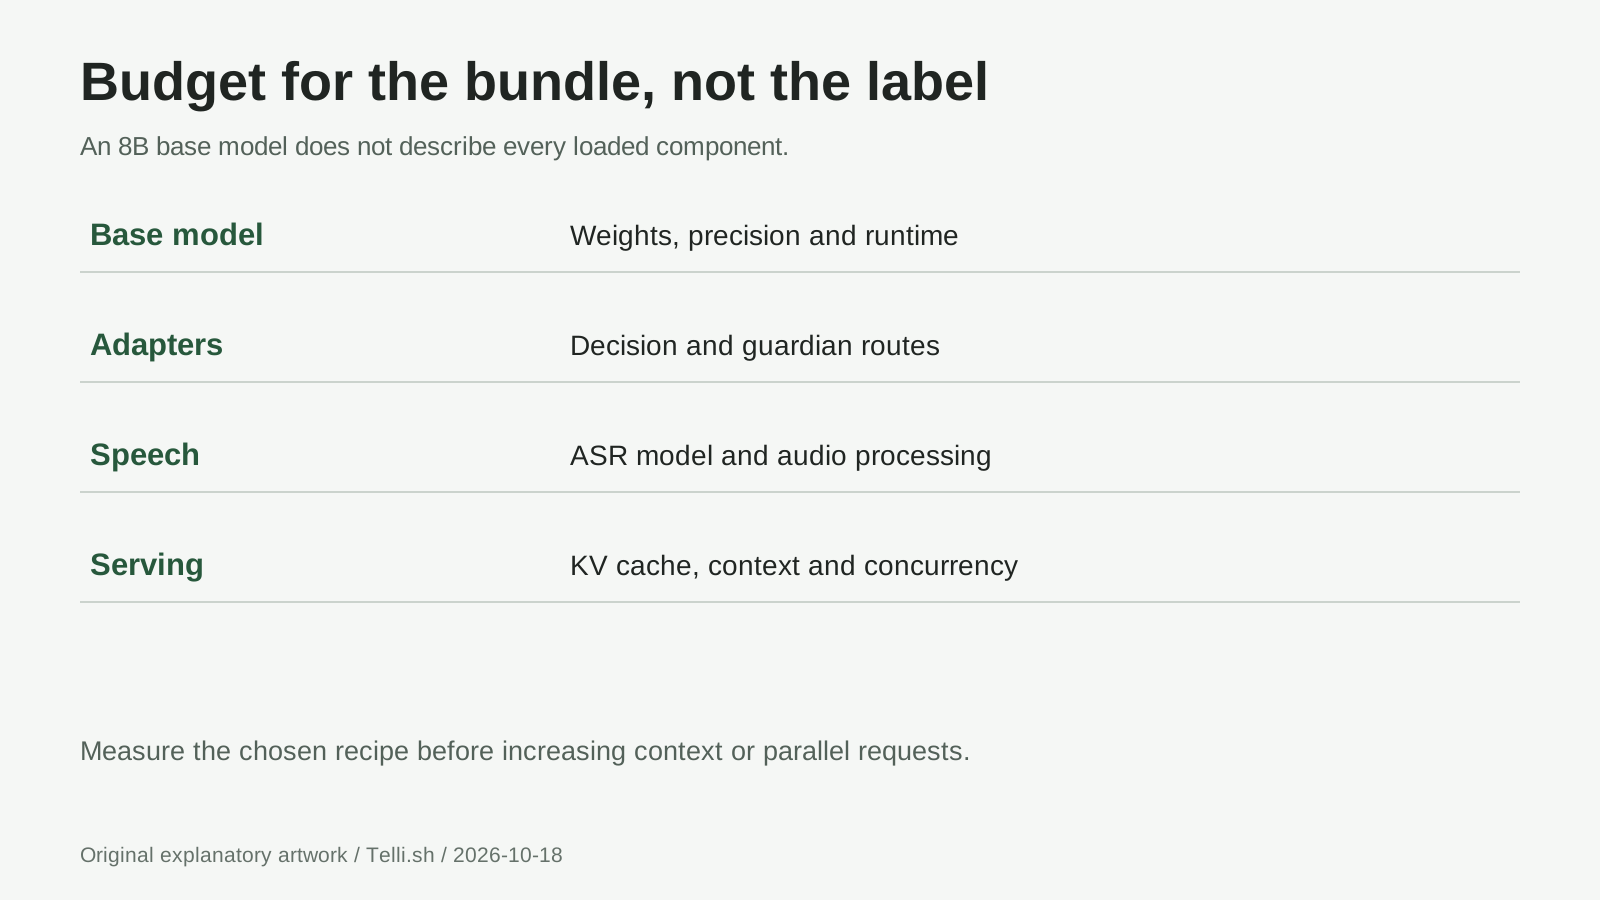
原创内存清单,不按比例绘制:基础权重 + 适配器 + ASR 权重与激活值 + KV 缓存 + 运行时和显示余量。音频指南提醒,缓存预分配可能让 ASR 没有足够空间;核对于 2026 年 10 月 18 日。
分别测试短聊天、短音频片段和最长的常规输入。记录观测到的峰值内存、完成时间和错误。减少缓存分配能给语音留出更多空间,但不能让过大的权重凭空装进显存。量化版本也必须单独验证与 Switch 适配器和音频功能的兼容性,不能只看下载量变小了。
根据部署方式,同时考虑成本和隐私
模型采用 Apache-2.0 许可,不代表运行没有成本。本地使用会消耗硬件、电力、存储和维护时间;托管端点则涉及供应商账单和数据处理条款。不要假设 Granite Switch 有适用于所有场景的每分钟统一价格。试点时,把总算力和审核成本除以成功完成的项目数,并将失败请求与更正也计入。
一个简单的假设预算能说明问题:如果供应商费率为每小时 1 美元,使用 10 小时的算力就是 10 美元,尚未计入存储、传输和人工审核。这只是示意输入,并非某家服务商的报价。端点闲置时的小时数同样会产生影响。
处理敏感内容时,应在录音之前确定音频、转写、缓存、日志和备份分别存放在哪里。绑定到回环地址可以限制网络访问,但不等于设置了保留期限,也不能关闭所有库的遥测。不要将服务端暴露到公共接口,检查依赖和日志,取得说话者许可,并分别制定源音频和派生记录的删除规则。托管演示适合学习,不应默认用来处理机密会议。
先修复出错的阶段,不要一上来就换整套技术栈
架构未知。 检查虚拟环境中是否装有 granite-switch、vLLM 是否使用该环境,以及 VLLM_PLUGINS 是否包含 register_granite_switch。先查看插件导入时最早出现的错误,再决定是否更换软件包。
聊天可用,音频失败。 确认使用的是带音频功能的正式版本标识、安装了 [audio] 依赖,并且文件确实是 WAV,而不是改了扩展名的其他格式。检查 Transformers 版本和可用内存。安装解码库无法让纯文本预览版变成音频检查点。
名称或标点错误。 默认英文 CTC 识别器会输出小写、无标点的文本,也不支持在解码时指定语言。保留原始文本;恢复标点属于派生编辑。级联流程会把转写错误继续传给后续决策。音频限制,核对于 2026 年 10 月 18 日
长录音超出上下文。 缩短输入,或按有意义的片段分段,并保留来源引用。转写文本会消耗上下文,因此还要为问题和回答留出空间。提高上下文上限也会改变内存预算。
依赖它之前,还应该了解什么?
它能用语音朗读答案吗? 这个内置语音路径是 ASR,不是文本转语音。应用要输出语音,还得接入单独的 TTS 组件。
它能转写全部 12 种聊天语言吗? 默认英文识别器不行。音频指南说明可以替换 ASR 后端以处理多语言输入,但那是另一种配置,需要另行评估。
选项概率为 0.95,就代表现实中正确率有 95% 吗? 不代表。它表示模型在你提供的选项之间如何分配概率,不是模型在你的领域经过验证的成功率。选项缺失、转写不佳和问题含糊,都可能让模型表现出明显偏好。自动执行操作之前,应评估带标签的案例并制定弃权规则。决策适配器文档,核对于 2026 年 10 月 18 日
Guardian 能证明答案真实吗? 不能。安全筛查和事实核验是两回事。即用型组合也不包含 Granite Libraries 全系列的每一种专家模块;设计事实性工作流前,应先检查适配器清单。
总结:一个端点仍然需要证据链
Granite Switch 4.1 最适合这样的场景:聊天负责解释,语音提供可审核的文字,范围明确的决策帮助整理下一步。模块化服务设计减少了基础设施重复,但工作流中的同意、证据和行动权限仍由你负责。
先从一段简短录音和一个可撤销的决策开始。只有在转写、理解和行动对结果责任人始终清晰时,才逐步扩展。
来源
日期:IBM 发布文章标注为 2026 年 10 月 15 日;8B 模型卡标注为 2026 年 10 月 14 日。链接文档核对于 2026 年 10 月 18 日。部署说明改编自一手文档,不是实测性能结果。图示均为原创编辑示意图;未转载供应商图片。
- IBM 发布文章、8B 模型卡、30B 模型卡和 3B 预览版模型卡:发布范围与检查点差异。
- Granite Switch 仓库、固定版本的依赖要求及音频指南:安装、架构和语音限制。
- 官方语音演示、演示文档和 aLoRA 官方竞速笔记本:可供了解的演示,并非本文测得的结果。
- IBM 于 2025 年 4 月 17 日发布的 aLoRA 说明及 vLLM 文档:本文讨论的机制与运行要求。
可选的 Telli.sh 建议:让决策背后有据可查
将原始录音、笔记和审核结果放在一起保存,让后续决策保有上下文。创建 Telli.sh 账户,随着工作流发展整理参考资料。