Granite Switch 4.1: transforme fala em inglês em uma decisão útil
Conheça o Granite Switch 4.1 e monte um fluxo prático de conversa, transcrição em inglês e decisões, com orientações realistas sobre configuração, memória, privacidade e custos.
Um pedido falado costuma exigir três tipos distintos de trabalho: reconhecer as palavras, explicar o que significam e decidir o que deve acontecer em seguida. O Granite Switch 4.1 oferece esses recursos por meio de um único endpoint, sem exigir que você monte três servidores de modelos independentes.
O anúncio da IBM de 15 de outubro de 2026 apresentou as versões prontas e compostas de 8B e 30B, com conversa, um adaptador geral de decisões, triagem de segurança Guardian e reconhecimento de fala. A vantagem prática é encurtar o caminho de uma nota de voz em inglês até uma ação que pode ser revisada. Artigo de lançamento da IBM, 15 de outubro de 2026.
Este guia começa com um exercício curto no navegador, mostra depois uma configuração local e três fluxos realistas. Você também verá onde os limites importam: áudio em inglês não é áudio multilíngue, uma pontuação de decisão não é prova e os pesos do modelo não representam todo o orçamento de memória da GPU.
Imagem de abertura: esquema editorial original em que o áudio em inglês vira uma transcrição e se divide em resposta de conversa, opções de decisão e triagem de segurança. A ação final passa por revisão humana; não é uma captura de tela oficial nem uma afirmação de desempenho.
Obtenha seu primeiro resultado útil antes de instalar qualquer coisa
Comece pela demonstração oficial Speech to Decisions. A IBM a indica no anúncio de 15 de outubro; a documentação da própria demonstração descreve entrada ao vivo pelo microfone, uma breve descrição do assunto, verificações de segurança e julgamentos de sim/não. Documentação oficial da demonstração, consultada em 18 de outubro de 2026.
-
Abra a demonstração e use apenas material inventado e não confidencial. O serviço é hospedado, não realiza processamento local.
-
Se o aplicativo estiver disponível, permita o acesso ao microfone e diga o texto a seguir em inglês, idioma aceito pelo ASR:
Texto simplesThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow. -
Pare a gravação e compare a transcrição exibida com o que você disse. Examine separadamente a descrição do assunto e as sinalizações de julgamento disponíveis.
-
Confira se o pedido, o item danificado e o acompanhamento prometido foram preservados. Não considere um rótulo plausível para o assunto um sucesso se a transcrição perdeu uma negação ou trocou o item.
Esse é um primeiro marco útil: uma entrada compreensível e resultados que você pode inspecionar. Não é uma promessa de redação exata, latência ou disponibilidade ininterrupta da demonstração. Se o Space estiver indisponível ou sua organização proibir o envio de áudio a serviços externos, siga o caminho local abaixo em vez de enviar material privado a outro lugar.
O que o switch realmente alterna?
O modelo de linguagem base lida com conversas comuns. Um adaptador é um conjunto menor de ajustes treinados para especializar o modelo em uma tarefa. O adaptador decision escolhe entre opções rotuladas; guardian-core examina o texto em busca de riscos específicos de segurança. Em vez de carregar um segundo modelo de linguagem completo, o aplicativo escolhe o adaptador por meio do modelo de conversa. Repositório Granite Switch, consultado em 18 de outubro de 2026.
A fala segue outro caminho. O reconhecimento automático de fala, ou ASR, converte a forma de onda em texto antes que o modelo de linguagem a leia. O reconhecedor incluído é o modelo Granite Speech TurboCTC em inglês da IBM, com 470 milhões de parâmetros, consultado em 18 de outubro de 2026. Pense nessa transcrição como o comprovante de transferência: tudo o que vem depois depende das palavras registradas ali. Guarde-a junto de qualquer resumo revisado para que o leitor possa rastrear uma decisão questionável até sua entrada.
| Checkpoint | Status e ponto de partida pretendido | Expectativa para áudio |
|---|---|---|
granite-switch-4.1-8b | Lançado; a opção composta pronta menor | ASR em inglês incluído |
granite-switch-4.1-30b | Lançado; base maior com o mesmo conjunto de recursos | ASR em inglês incluído |
granite-switch-4.1-3b-preview | Prévia com um conjunto diferente de adaptadores | Não é o pacote de fala lançado |
O cartão do modelo 8B, lançado em 14 de outubro de 2026, diferencia as versões com áudio da família de prévia sem áudio. O cartão 30B e o cartão da prévia 3B, consultados em 18 de outubro, descrevem suas respectivas composições. Uma prévia menor não substitui diretamente o modelo com fala.
O cartão 8B lista 12 idiomas para conversa: inglês, alemão, espanhol, francês, japonês, português, árabe, tcheco, italiano, coreano, neerlandês e chinês. Essa lista não amplia o reconhecedor de fala padrão para além do inglês.
Escolha o sistema operacional antes de copiar os comandos
Para a configuração CUDA/vLLM deste guia, escolha Linux com GPU NVIDIA e driver compatíveis. No Windows, use um ambiente WSL devidamente configurado e com acesso à GPU; estes comandos Bash não são comandos nativos do PowerShell. No macOS, comece pelo exercício hospedado ou por um servidor Linux com GPU, em vez de presumir que esta receita CUDA se aplica ao Apple Silicon. Orientações de instalação de GPU do vLLM, consultadas em 18 de outubro de 2026.
O vLLM-Metal e outros runtimes têm caminhos de compatibilidade próprios. O fato de um runtime oferecer suporte ao seu sistema operacional não comprova que este checkpoint Switch específico, seus adaptadores e toda a cadeia de fala funcionem nele. Exija um exemplo compatível antes de escolher esse caminho.
Comece localmente com conversa; depois acrescente áudio e decisões
Use uma nova pasta de trabalho em um terminal Linux ou Bash no WSL. Instale Git e Python 3.12 primeiro e confirme que nvidia-smi detecta a GPU. O snapshot do repositório usado aqui requer Python >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 e vLLM >=0.26.0,<0.31.0. Declarações de pacotes na revisão 7e72456, consultadas em 18 de outubro de 2026.
- Instale juntos o pacote Switch e as dependências de áudio. Assim, você fixa a receita do código-fonte em vez de depender de um wheel publicado mais antigo.
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
Os extras são específicos de cada tarefa: [hf] adiciona suporte à inferência Hugging Face, [compose] acrescenta ferramentas de composição e [audio] instala as dependências de decodificação de áudio do vLLM. Instalar apenas vllm não instala o plugin Switch. Mantenha a combinação resolvida de PyTorch/CUDA compatível com o driver; não resolva um erro de dependência removendo as verificações. O primeiro uso baixa os pesos do modelo; reserve tempo de provisionamento e espaço em disco para os checkpoints antes de iniciar uma gravação.
- Inicie um servidor restrito ao loopback. Os limites de contexto e concorrência abaixo são configurações iniciais conservadoras, não uma garantia de que o modelo caiba no hardware.
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
O pacote registra register_granite_switch em vllm.general_plugins. O vLLM encontra os entry points instalados; a variável de ambiente seleciona explicitamente este plugin. Para esta receita, não é necessário copiar um script de registro nem contornar o problema com --trust-remote-code. Código de registro do Switch e sistema de plugins do vLLM, consultados em 18 de outubro de 2026.
- Confira uma resposta de conversa simples. Em outro terminal Bash, aguarde o servidor ficar pronto e execute:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
Leia a mensagem do assistente dentro da resposta JSON. O sucesso significa preservar o pedido sem inventar número de ordem, prazo ou aprovação de reembolso. Receber uma resposta HTTP, por si só, não comprova que a resposta seja útil.
- Envie um WAV curto em inglês. Coloque na pasta do repositório uma gravação consentida e não confidencial chamada
request.wav. Ative o mesmo ambiente virtual no segundo terminal, salve o conteúdo abaixo comotry_audio.pye executepython try_audio.py.
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
Isso retorna uma resposta do modelo de linguagem sobre a transcrição inserida internamente, não uma exportação ASR intacta. O guia de áudio documenta a cadeia e o formato de entrada; use um aplicativo que exponha a transcrição quando precisar inspecionar as duas etapas separadamente. Documentação de áudio, consultada em 18 de outubro de 2026.
- Teste uma decisão delimitada usando texto revisado. Deixe o servidor em execução e envie:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
Este teste exercita a seleção do adaptador e pede um rótulo, não um relatório de probabilidades. Para obter probabilidades, siga o exemplo de decisão do cartão do modelo, consultado em 18 de outubro de 2026: verifique os rótulos de token único, solicite logprob_token_ids e normalize entre os rótulos candidatos. A documentação de leitura do adaptador de decisão, consultada em 18 de outubro, explica o softmax no nível das opções. Não substitua isso por uma frase gerada no chat dizendo “tenho 95% de confiança”.
Faça com que três fluxos possam ser revisados, em vez de apenas automáticos
Estes são usos ilustrativos, não testes relatados. Comece com resultados que ajudem alguém a revisar o trabalho; só acrescente ações consequentes depois de avaliar casos representativos.
Encaminhe uma mensagem de voz de um cliente. Use ASR para capturar o pedido, o chat para redigir um resumo neutro e uma pergunta de decisão para escolher entre substituição, suporte à conta e triagem humana. Mantenha o áudio original vinculado à transcrição revisada. Um pedido que diga “não cancele meu pedido” deve virar um caso de teste deliberado, não uma preocupação descoberta depois que a automação de cancelamento já existe.
A verificação de aceitação é concreta: a fila escolhida corresponde às palavras reais e um agente de suporte pode corrigi-la antes que algo seja enviado? Uma sinalização de segurança pode pedir revisão adicional, mas não deve descartar silenciosamente a reclamação de um cliente frustrado.
Transforme uma atualização de projeto em uma tarefa preliminar. Em uma gravação em inglês, uma colega diz: “I can review the draft Friday, but I cannot approve the budget.” Peça ao chat que separe compromissos de exclusões e depois pergunte ao adaptador de decisão se a aprovação do orçamento está presente, ausente ou não está clara. Mantenha “não está claro” disponível quando a gravação ou o contexto forem insuficientes. Alguém confere a data e a responsabilidade antes de incluir a tarefa em um rastreador compartilhado.
Prepare perguntas de acompanhamento para uma entrevista. Com a permissão de quem fala, transcreva um trecho curto de entrevista em inglês e rascunhe perguntas sobre detalhes ausentes. Use decisões delimitadas, como “Este trecho menciona explicitamente uma data de entrega?”, em vez de “Esta pessoa é confiável?”. Guarde o trecho que fundamenta cada sinalização. Assim, é possível resolver divergências sem tratar a interpretação do modelo como um julgamento sobre a pessoa entrevistada.
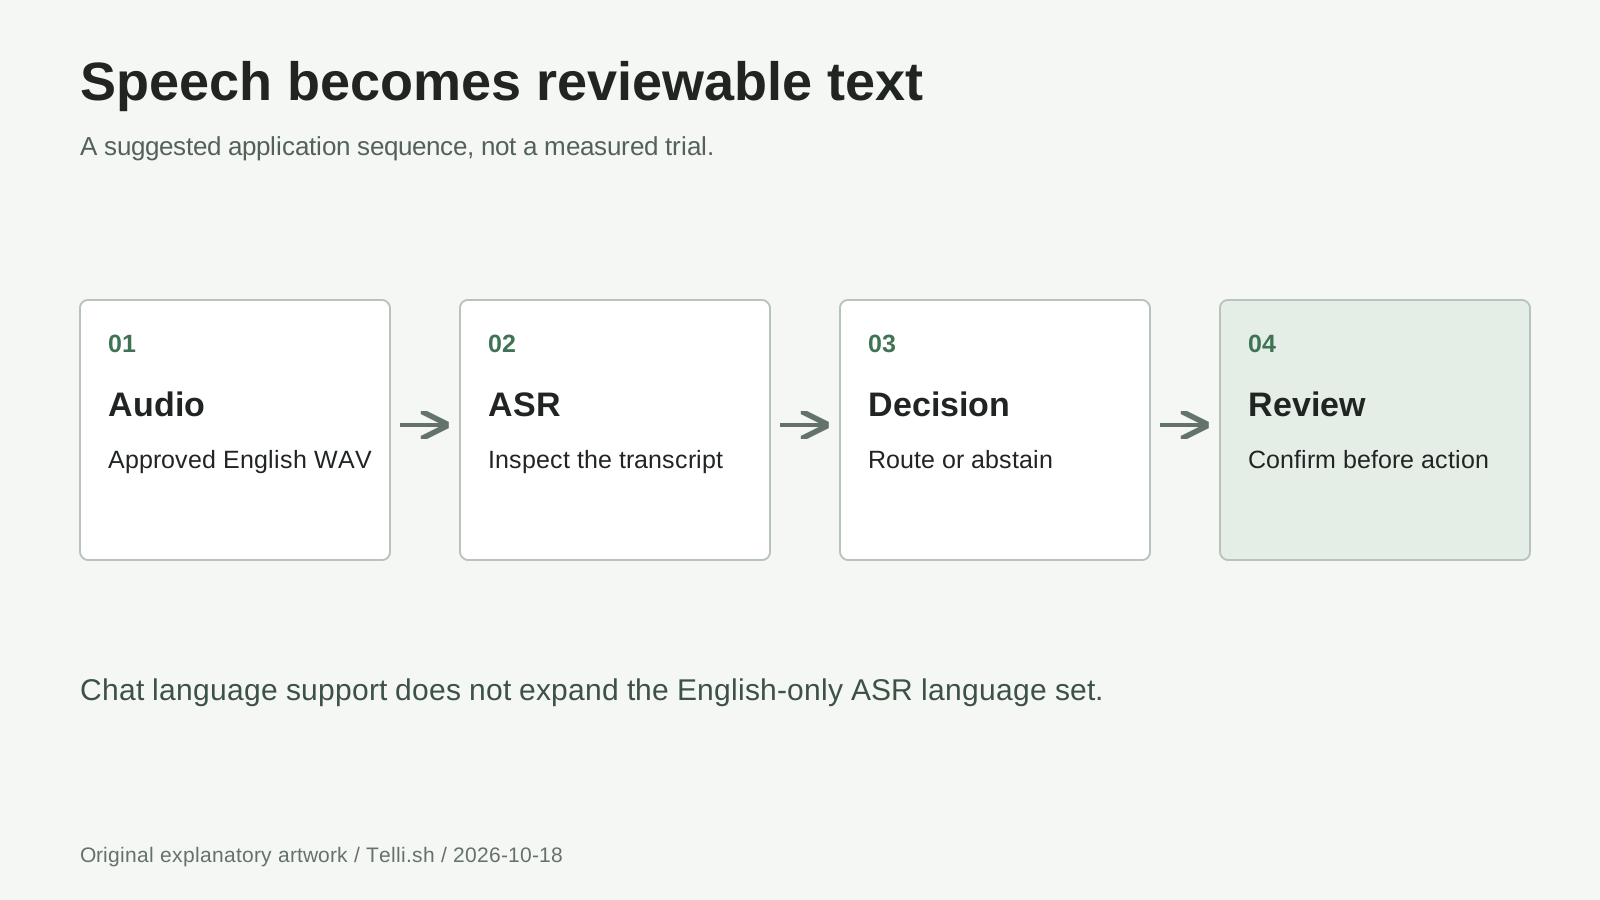
Esquema de fluxo original: preserve o áudio e a transcrição, produza resultados derivados separados e revise antes de agir. Ilustra os aplicativos acima, não uma interface oficial; a cadeia subjacente é descrita no guia de áudio, consultado em 18 de outubro de 2026.
Por que vários recursos podem compartilhar o mesmo contexto?
Um cache key/value armazena informações de atenção calculadas a partir de tokens anteriores. LoRA ativado, ou aLoRA, permite que um especialista seja ativado depois de um contexto compartilhado, em vez de exigir o reprocessamento específico de um adaptador comum de todo o prefixo. A IBM apresentou a abordagem subjacente em sua explicação de pesquisa de 17 de abril de 2025. Pesquisa da IBM sobre aLoRA.
O Switch usa o estado normalizado do cache do modelo base para que os especialistas não consumam o estado adaptado privado uns dos outros. Na aplicação, mantenha idêntico o prefixo de evidências e acrescente a pergunta específica da tarefa. Reescrever a transcrição de modo diferente para cada verificação prejudica a reutilização do prefixo. Documentação do mecanismo Switch, consultada em 18 de outubro de 2026.
Cache compartilhado é um mecanismo de eficiência, não inferência gratuita. O cache de prefixo economiza o reprocessamento repetido do prompt; não elimina a geração de respostas nem o reconhecimento de áudio. Documentação de cache de prefixo do vLLM, consultada em 18 de outubro de 2026. Nossa opinião: compare fluxos completos e revisados, não velocidades isoladas de destaque.
Planeje a carga inteira, não apenas os pesos 8B
Como cálculo de planejamento, 8 bilhões de parâmetros a dois bytes cada ocupam cerca de 16 GB, ou 14,9 GiB; 30 bilhões ocupam cerca de 60 GB, ou 55,9 GiB. São exemplos de aritmética para pesos-base, não tamanhos de checkpoint nem especificações mínimas de VRAM. Eles não incluem adaptadores, codificador de fala, cache, buffers temporários nem sobrecarga do runtime.
Contextos mais longos e mais sequências simultâneas aumentam a pressão sobre a memória. O limite de contexto anunciado para o modelo não é recomendação de reservá-lo para o primeiro teste. O vLLM documenta a redução de max_model_len e max_num_seqs como controles de memória. Orientações de memória do vLLM, consultadas em 18 de outubro de 2026.
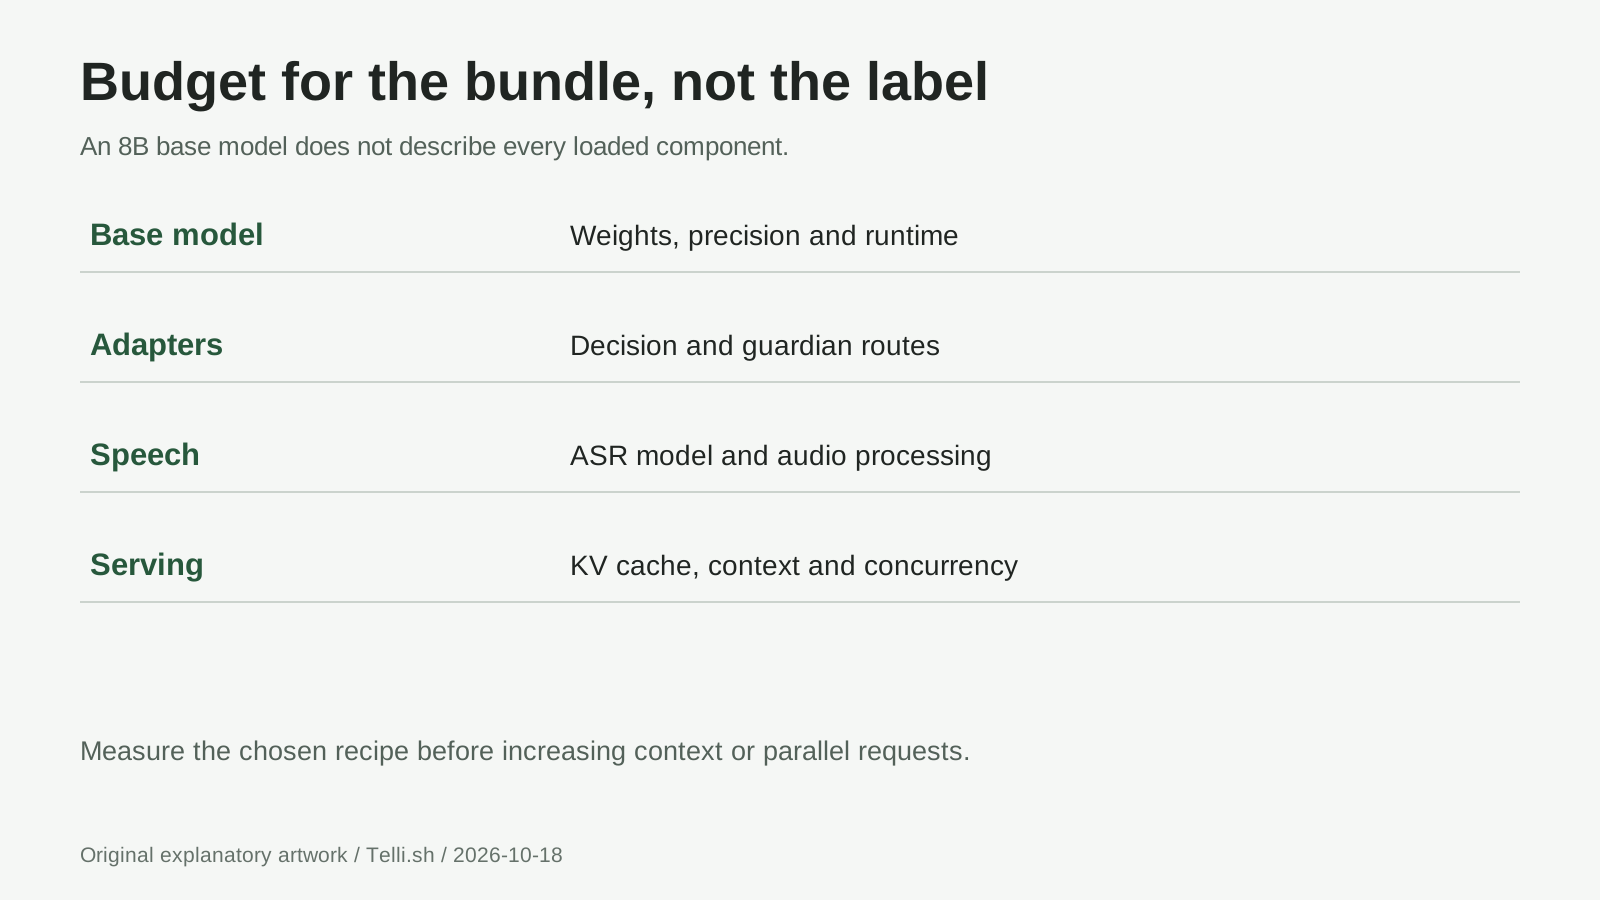
Lista original de memória, sem proporções: pesos-base + adaptadores + pesos e ativações de ASR + cache KV + margem para runtime e tela. O guia de áudio alerta que a pré-alocação de cache pode deixar espaço insuficiente para ASR; consultado em 18 de outubro de 2026.
Teste separadamente uma conversa curta, um clipe curto e sua entrada normal mais longa. Registre observações de pico de memória, tempo de conclusão e erros. Reduzir a alocação do cache pode liberar mais espaço para fala, mas não faz pesos grandes caberem. Uma alternativa quantizada exige sua própria verificação de compatibilidade com adaptadores Switch e áudio, não basta ser um download menor.
Mantenha custos e privacidade vinculados à escolha de implantação
A licença Apache-2.0 dos modelos não torna a operação gratuita. O uso local consome hardware, eletricidade, armazenamento e tempo de manutenção; um endpoint hospedado acrescenta cobrança do provedor e termos de tratamento de dados. Não presuma um preço universal por minuto para o Granite Switch. Em um piloto, divida o custo total de computação e revisão pelo número de itens concluídos com sucesso, incluindo requisições com falha e correções.
Um orçamento hipotético simples deixa isso concreto: 10 horas à taxa de US$ 1 por hora custam US$ 10 em computação, antes de armazenamento, transferência e revisão humana. Esses valores são ilustrativos, não o preço anunciado de um serviço. Também importa quantas horas o endpoint fica ocioso.
Para trabalho sensível, decida onde ficam áudio, transcrições, caches, logs e backups antes de gravar. Vincular ao loopback limita o acesso pela rede, mas não define regras de retenção nem desativa a telemetria de todas as bibliotecas. Mantenha o servidor fora de interfaces públicas, revise dependências e registros, obtenha permissão de quem fala e defina separadamente a exclusão do áudio de origem e dos registros derivados. Uma demonstração hospedada é útil para aprender, não um destino padrão para reuniões confidenciais.
Corrija a etapa que falhou antes de trocar toda a pilha
A arquitetura é desconhecida. Confirme que o ambiente virtual contém granite-switch, que o vLLM usa esse ambiente e que VLLM_PLUGINS inclui register_granite_switch. Leia o primeiro erro de importação do plugin antes de substituir pacotes.
O chat funciona, mas o áudio falha. Confirme o identificador de versão com áudio, as dependências [audio] e um WAV real, não um arquivo renomeado. Verifique a versão do Transformers e a memória disponível. Instalar bibliotecas de decodificação não transforma uma prévia somente de texto em um checkpoint de áudio.
Nomes ou pontuação estão incorretos. O reconhecedor CTC padrão em inglês produz texto em minúsculas e sem pontuação e não permite direcionamento de idioma durante a decodificação. Preserve esse texto bruto; qualquer restauração de pontuação é uma edição derivada. A cadeia pode propagar erros de transcrição para decisões posteriores. Limitações de áudio, consultadas em 18 de outubro de 2026.
Um clipe longo excede o contexto. Encurte a entrada ou divida-a em trechos significativos, mantendo as referências à origem. A transcrição consome contexto de texto; ainda deve haver espaço suficiente para a pergunta e a resposta. Aumentar o limite de contexto também altera o orçamento de memória.
O que você precisa saber antes de confiar nele?
Ele fala as respostas em voz alta? Este caminho de fala integrado é ASR, não síntese de voz. Um aplicativo com saída de voz precisa de um componente TTS separado.
Ele transcreve os 12 idiomas de conversa? Não com o reconhecedor padrão em inglês. O guia de áudio descreve a substituição do backend ASR para entrada multilíngue; é outra configuração que precisa ser avaliada.
Uma probabilidade de opção de 0,95 significa 95% de acerto no mundo real? Não. Ela expressa a distribuição do modelo entre as opções fornecidas, não uma taxa de sucesso verificada para o seu domínio. Opções ausentes, transcrições ruins e perguntas ambíguas ainda podem gerar uma preferência forte. Avalie exemplos rotulados e defina regras de abstenção antes de automatizar ações. Documentação do adaptador de decisão, consultada em 18 de outubro de 2026.
O Guardian prova que uma resposta é verdadeira? Não. A triagem de segurança é diferente da verificação factual. A versão composta pronta não inclui todos os especialistas da coleção mais ampla Granite Libraries; confira o inventário de adaptadores antes de projetar um fluxo de verificação factual.
Em resumo: um endpoint ainda precisa de um rastro de evidências
O Granite Switch 4.1 é mais útil quando o chat explica, a fala fornece palavras que podem ser revisadas e decisões delimitadas organizam o que acontece em seguida. O projeto modular de serviço reduz a duplicação de infraestrutura; seu fluxo continua responsável pelo consentimento, pelas evidências e pela autoridade para agir.
Comece com uma gravação curta e uma decisão reversível. Amplie o uso somente quando a transcrição, a interpretação e a ação continuarem compreensíveis para quem responde pelo resultado.
Fontes
Datas de lançamento: o artigo de lançamento da IBM é de 15 de outubro de 2026; o cartão do modelo 8B informa 14 de outubro de 2026. A documentação vinculada foi consultada em 18 de outubro de 2026. As instruções de configuração foram adaptadas da documentação primária, não de resultados de desempenho medidos na prática. Os diagramas são esquemas editoriais originais; imagens de fornecedores não foram reproduzidas.
- Artigo de lançamento da IBM, cartão do modelo 8B, cartão do modelo 30B e cartão da prévia 3B: escopo do lançamento e diferenças entre checkpoints.
- Repositório Granite Switch, requisitos fixados do pacote e guia de áudio: instalação, arquitetura e limites de fala.
- Demonstração oficial de fala, documentação da demonstração e notebook oficial de comparação aLoRA: demonstrações para explorar, não resultados medidos neste guia.
- Explicação da IBM sobre aLoRA, de 17 de abril de 2025 e documentação do vLLM: mecanismos e requisitos operacionais discutidos acima.
Recomendação opcional do Telli.sh: mantenha as fontes por trás da decisão
Guarde gravações originais, notas e resultados revisados juntos para que decisões posteriores tenham contexto. Crie uma conta no Telli.sh para organizar esse material de referência à medida que seu fluxo evolui.