Granite Switch 4.1: Englische Spracheingaben in sinnvolle nächste Schritte verwandeln
Probiere Granite Switch 4.1 aus und richte anschließend einen praktischen Chat-, Englisch-Transkriptions- und Entscheidungsablauf ein: mit realistischer Einrichtung, Speicher, Datenschutz und Kosten.
Eine gesprochene Anfrage erfordert meist drei verschiedene Arbeitsschritte: die Worte erkennen, ihre Bedeutung erklären und entscheiden, was als Nächstes geschehen soll. Granite Switch 4.1 stellt diese Funktionen über einen einzigen Endpunkt bereit, statt dich drei unabhängige Modellserver zusammenbauen zu lassen.
IBMs Ankündigung vom 15. Oktober 2026 stellte die fertig zusammengestellten Versionen 8B und 30B mit Chat, einem allgemeinen Entscheidungsadapter, Guardian-Sicherheitsprüfung und Spracherkennung vor. Der praktische Vorteil: Der Weg von einer englischen Sprachnotiz zu einer überprüfbaren Handlung wird kürzer. IBM-Ankündigung vom 15. Oktober 2026.
Dieser Leitfaden beginnt mit einer kleinen Browserübung, zeigt danach eine lokale Einrichtung und drei realistische Arbeitsabläufe. Außerdem erfährst du, wo die Grenzen wichtig sind: Englisches Audio bedeutet nicht mehrsprachiges Audio, ein Entscheidungsscore ist kein Beweis, und Modellgewichte bilden nicht den gesamten GPU-Speicherbedarf ab.
Titelgrafik: eigene redaktionelle Schemazeichnung, in der englisches Audio erst zu einem Transkript wird und sich dann in Chatantwort, Entscheidungsoptionen und Sicherheitsprüfung verzweigt. Die abschließende Handlung wird von einem Menschen geprüft. Es handelt sich weder um einen offiziellen Screenshot noch um eine Leistungsangabe.
Erziele ein erstes brauchbares Ergebnis, bevor du etwas installierst
Starte mit der offiziellen Demo „Speech to Decisions“. IBM verlinkt sie in der Ankündigung vom 15. Oktober; die Dokumentation der Demo beschreibt Live-Mikrofoneingabe, eine kurze Themenbeschreibung, Sicherheitsprüfungen und Ja/Nein-Urteile. Dokumentation der offiziellen Demo, geprüft am 18. Oktober 2026.
-
Öffne die Demo und verwende nur erfundene, nicht vertrauliche Inhalte. Es ist ein gehosteter Dienst, keine lokale Verarbeitung.
-
Wenn die Anwendung verfügbar ist, erlaube den Mikrofonzugriff und sage Folgendes auf Englisch, der unterstützten ASR-Sprache:
KlartextThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow.Auf Deutsch heißt das: „Die Ersatz-Tastatur ist beschädigt angekommen. Bitte schicken Sie eine neue. Morgen kann ich ein Foto senden.“ Der gesprochene Text bleibt Englisch, weil der mitgelieferte Spracherkenner nur Englisch unterstützt.
-
Beende die Aufnahme und vergleiche das angezeigte Transkript mit dem Gesagten. Prüfe Themenbeschreibung und verfügbare Entscheidungsmerkmale getrennt.
-
Kontrolliere, ob die Bitte, der beschädigte Gegenstand und die angekündigte Rückmeldung erhalten geblieben sind. Eine plausibel klingende Themenkategorie zählt nicht als Erfolg, wenn im Transkript eine Verneinung fehlt oder der Gegenstand falsch ist.
Das ist ein sinnvoller erster Prüfpunkt: eine verständliche Eingabe und Ausgaben, die du kontrollieren kannst. Es ist keine Garantie für wortgetreue Erkennung, Latenz oder dauerhafte Verfügbarkeit der Demo. Ist der Space nicht verfügbar oder verbietet deine Organisation externe Audio-Uploads, wechsle zum lokalen Weg unten, statt vertrauliches Material anderswo einzureichen.
Was schaltet der Switch eigentlich um?
Das Basissprachmodell verarbeitet gewöhnlichen Chat. Ein Adapter ist ein kleinerer Satz trainierter Anpassungen, der das Modell auf eine bestimmte Aufgabe spezialisiert. Der decision-Adapter wählt aus gekennzeichneten Optionen; guardian-core prüft Text auf bestimmte Sicherheitsrisiken. Deine Anwendung wählt den Adapter über die Chat-Vorlage, statt ein vollständiges zweites Sprachmodell zu laden. Granite-Switch-Repository, geprüft am 18. Oktober 2026.
Spracheingabe folgt einem anderen Pfad. Automatische Spracherkennung, kurz ASR, wandelt die Wellenform in Text um, bevor das Sprachmodell ihn liest. Der enthaltene Erkenner ist IBMs englisches Granite Speech TurboCTC mit 470 Millionen Parametern, geprüft am 18. Oktober 2026. Betrachte das Transkript als Übergabebeleg: Alles, was danach kommt, hängt von den dort festgehaltenen Worten ab. Bewahre es neben einer geglätteten Zusammenfassung auf, damit sich eine fragwürdige Entscheidung auf ihre Eingabe zurückführen lässt.
| Prüfpunkt | Status und vorgesehener Einstieg | Audio-Unterstützung |
|---|---|---|
granite-switch-4.1-8b | Veröffentlicht; die kleinere fertig zusammengestellte Option | Englische ASR enthalten |
granite-switch-4.1-30b | Veröffentlicht; größeres Basismodell mit demselben Funktionspaket | Englische ASR enthalten |
granite-switch-4.1-3b-preview | Vorschau mit einem anderen Adapterpaket | Nicht das veröffentlichte sprachfähige Bundle |
Die Modellkarte für 8B, veröffentlicht am 14. Oktober 2026, unterscheidet die audiotauglichen Versionen von der Vorschaufamilie ohne Audio. Die 30B-Karte und die 3B-Vorschaukarte, geprüft am 18. Oktober, beschreiben ihre jeweiligen Zusammenstellungen. Eine kleinere Vorschau ist kein direkter Ersatz für die Spracherkennung.
Die 8B-Karte nennt zwölf Chatsprachen: Englisch, Deutsch, Spanisch, Französisch, Japanisch, Portugiesisch, Arabisch, Tschechisch, Italienisch, Koreanisch, Niederländisch und Chinesisch. Diese Liste erweitert den standardmäßigen Spracherkenner nicht über Englisch hinaus.
Entscheide dich für ein Betriebssystem, bevor du Befehle kopierst
Wähle für die hier beschriebene CUDA-/vLLM-Einrichtung Linux mit einer kompatiblen NVIDIA-GPU und einem passenden Treiber. Unter Windows brauchst du eine korrekt eingerichtete WSL-Umgebung mit GPU-Zugriff; diese Bash-Befehle sind keine nativen PowerShell-Befehle. Auf macOS beginnst du mit der gehosteten Übung oder einem Linux-GPU-Host, statt anzunehmen, dass dieses CUDA-Rezept auf Apple Silicon übertragbar ist. vLLM-Installationshinweise für GPUs, geprüft am 18. Oktober 2026.
vLLM-Metal und andere Laufzeitumgebungen haben eigene Kompatibilitätspfade. Dass eine Laufzeit dein Betriebssystem unterstützt, belegt nicht, dass genau dieser Switch-Checkpoint samt Adaptern und Sprachkaskade dort funktioniert. Verlange vor der Entscheidung ein passendes Beispiel.
Richte zuerst Chat ein und ergänze danach Audio und Entscheidungen
Verwende in einem Linux- oder WSL-Bash-Terminal einen neuen Arbeitsordner. Installiere zuerst Git und Python 3.12 und bestätige, dass nvidia-smi die GPU erkennt. Der hier verwendete Stand des Repositorys erfordert Python >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 und vLLM >=0.26.0,<0.31.0. Paketdefinitionen in Revision 7e72456, geprüft am 18. Oktober 2026.
- Installiere das Switch-Paket und die Audioabhängigkeiten gemeinsam. So verwendest du das Quellrezept statt dich auf ein älteres veröffentlichtes Wheel zu verlassen.
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
Die Extras sind aufgabenspezifisch: [hf] ergänzt Hugging-Face-Inferenz, [compose] fügt Kompositionswerkzeuge hinzu und [audio] installiert vLLMs Abhängigkeiten zur Audiodekodierung. Nur vllm zu installieren, installiert das Switch-Plugin nicht. Achte darauf, dass die aufgelöste PyTorch-/CUDA-Kombination zum Treiber passt; behebe Resolver-Fehler nicht, indem du Abhängigkeitsprüfungen entfernst. Bei der ersten Verwendung werden Modellgewichte heruntergeladen. Plane also genug Bereitstellungszeit und Festplattenspeicher ein, bevor du eine Aufnahme startest.
- Starte einen Server, der nur an Loopback gebunden ist. Die Kontext- und Parallelitätsgrenzen unten sind vorsichtige Startwerte, keine Garantie, dass die Konfiguration auf jeder Hardware passt.
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
Das Paket registriert register_granite_switch unter vllm.general_plugins. vLLM findet installierte Entry-Points; die Umgebungsvariable wählt dieses Plugin ausdrücklich aus. Für dieses Rezept brauchst du weder ein kopiertes Registrierungsskript noch einen Workaround mit --trust-remote-code. Registrierungsquelle von Switch und vLLM-Plugin-System, geprüft am 18. Oktober 2026.
- Prüfe eine gewöhnliche Chatantwort. Warte in einem zweiten Bash-Terminal, bis der Server bereit ist, und führe dann Folgendes aus:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
Lies die Assistentennachricht in der JSON-Antwort. Erfolgreich ist das Ergebnis, wenn die Bitte erhalten bleibt und weder Bestellnummer noch Frist oder Rückerstattung erfunden werden. Eine HTTP-Antwort allein belegt keine brauchbare Antwort.
- Sende eine kurze englische WAV-Datei. Lege eine freigegebene, nicht vertrauliche Aufnahme namens
request.wavin den Repository-Ordner. Aktiviere im zweiten Terminal dieselbe virtuelle Umgebung, speichere den folgenden Inhalt alstry_audio.pyund führepython try_audio.pyaus.
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
Die Antwort des Sprachmodells beruht auf dem intern eingefügten Transkript und ist kein unveränderter ASR-Export. Die Audioanleitung erläutert Kaskade und Eingabeformat. Wenn du beide Stufen getrennt prüfen musst, verwende eine Anwendung, die das Transkript offenlegt. Audiodokumentation, geprüft am 18. Oktober 2026.
- Probiere eine klar begrenzte Entscheidung mit geprüftem Text aus. Lass den Server laufen und sende Folgendes:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
Damit prüfst du die Adapterauswahl und verlangst genau eine Kennzeichnung, keinen Wahrscheinlichkeitsbericht. Für Wahrscheinlichkeiten folgst du dem Entscheidungsbeispiel der Modellkarte, geprüft am 18. Oktober 2026: Verifiziere Ein-Token-Kennzeichnungen, fordere ihre logprob_token_ids an und normalisiere über die Kandidaten. Die Dokumentation zur Ausgabe des Entscheidungsadapters, geprüft am 18. Oktober erklärt die Softmax-Ausgabe pro Option. Ersetze sie nicht durch einen Chat-Satz wie „Ich bin zu 95 % sicher“.
Gestalte drei Arbeitsabläufe so, dass sie überprüfbar sind und nicht nur automatisch laufen
Die folgenden Beispiele sind veranschaulichte Anwendungsmöglichkeiten, keine berichteten Tests. Beginne mit Ausgaben, die jemand überprüfen kann; ergänze folgenreiche Aktionen erst, wenn du repräsentative Fälle ausgewertet hast.
Eine Kunden-Sprachnachricht weiterleiten. Verwende ASR für die Anfrage, Chat für einen neutralen Entwurf und eine Entscheidungsfrage, um zwischen Ersatz, Kontohilfe und menschlicher Prüfung zu wählen. Verknüpfe die Originalaufnahme mit dem geprüften Transkript. Eine Aussage wie „Bitte stornieren Sie meine Bestellung nicht“ sollte ein gezielter Testfall sein, nicht erst dann auffallen, wenn eine Stornierungsautomatisierung existiert.
Das Abnahmekriterium ist konkret: Passt die gewählte Warteschlange zu den tatsächlichen Worten, und kann ein Supportmitarbeiter sie korrigieren, bevor etwas versendet wird? Ein Sicherheitsmerkmal kann eine zusätzliche Prüfung anfordern, sollte die Beschwerde eines frustrierten Kunden aber nicht stillschweigend verwerfen.
Aus einem Projektbericht einen Aufgabenentwurf machen. In einer englischen Aufnahme sagt ein Kollege: „I can review the draft Friday, but I cannot approve the budget.“ Das heißt: „Ich kann den Entwurf am Freitag prüfen, aber das Budget kann ich nicht genehmigen.“ Bitte den Chat, Zusagen und Ausschlüsse zu trennen; frage anschließend den Entscheidungsadapter, ob eine Budgetfreigabe ausdrücklich vorliegt, fehlt oder unklar ist. Lass „unklar“ zu, wenn Aufnahme oder Kontext nicht ausreichen. Ein Mensch prüft Datum und Zuständigkeit, bevor die Aufgabe in einen gemeinsamen Tracker kommt.
Eine Liste mit Interview-Nachfragen vorbereiten. Hole die Zustimmung der sprechenden Person ein, transkribiere einen kurzen englischen Interviewausschnitt und entwirf Fragen zu fehlenden Details. Verwende abgegrenzte Entscheidungen wie „Nennt diese Passage ausdrücklich ein Lieferdatum?“ statt „Ist diese Person vertrauenswürdig?“. Bewahre den Ausschnitt zu jedem Merkmal auf. So lassen sich Meinungsverschiedenheiten klären, ohne eine Interpretation des Modells als Urteil über die Person zu behandeln.
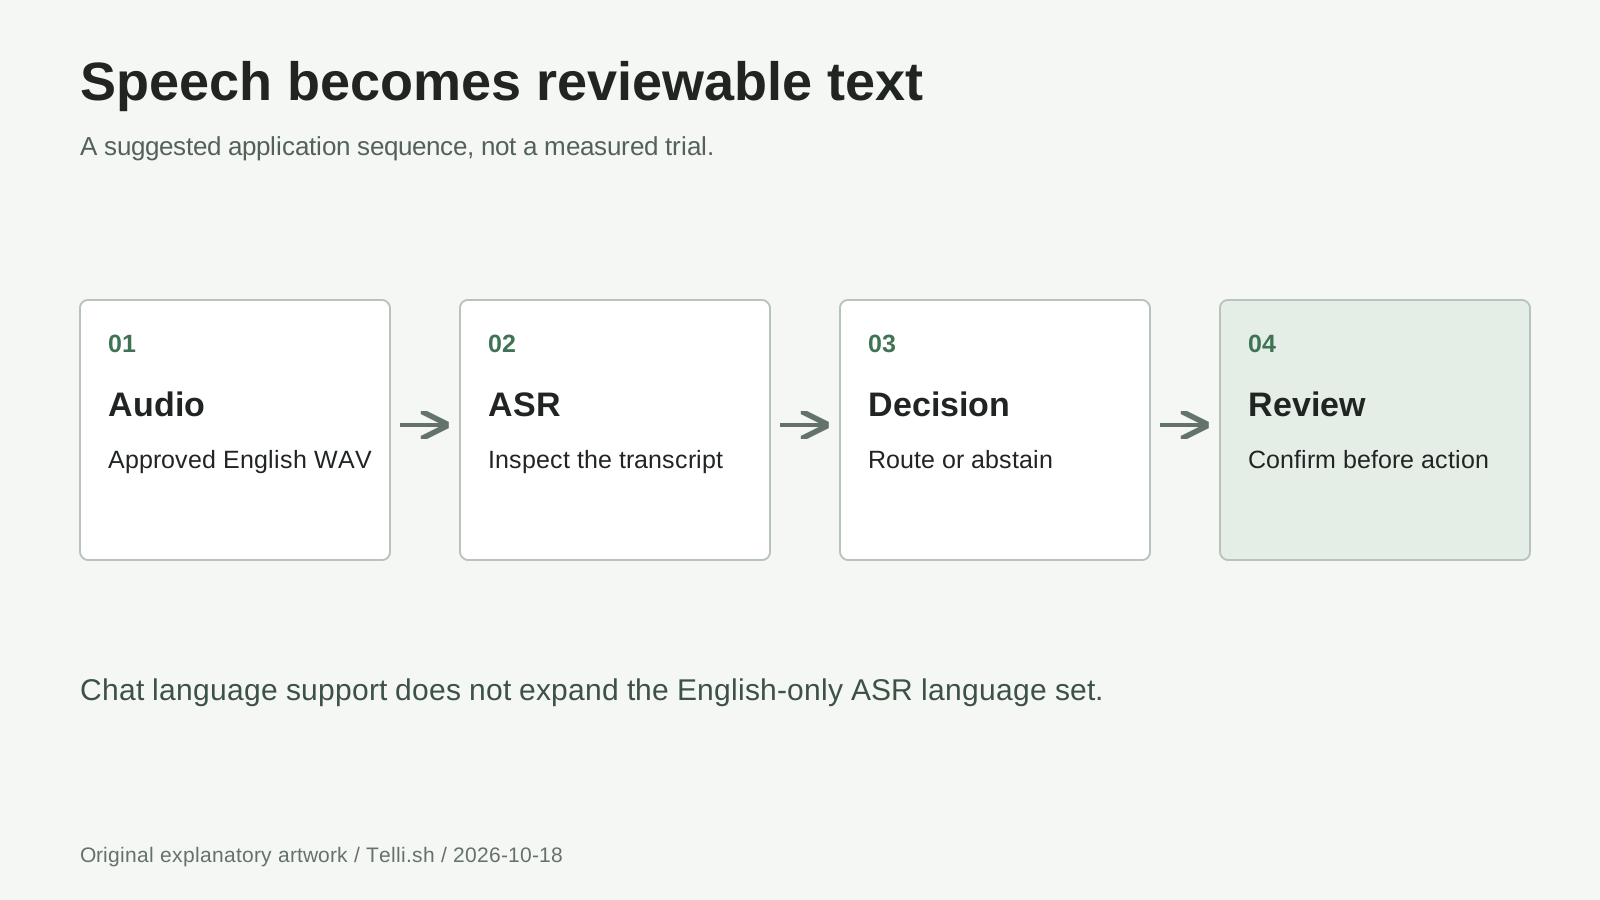
Eigene Ablaufgrafik: Audio und Transkript bleiben erhalten, daraus abgeleitete Ergebnisse werden getrennt erstellt und vor einer Handlung geprüft. Sie veranschaulicht die genannten Anwendungen, nicht eine offizielle Oberfläche. Die Kaskade wird in der Audioanleitung beschrieben; geprüft am 18. Oktober 2026.
Warum können mehrere Funktionen denselben Kontext gemeinsam nutzen?
Ein Key/Value-Cache speichert Aufmerksamkeitsinformationen, die aus früheren Tokens berechnet wurden. Aktiviertes LoRA, kurz aLoRA, lässt einen spezialisierten Adapter nach einem gemeinsam genutzten Kontext aktiv werden, statt wie bei gewöhnlichen Adaptern den gesamten Präfix erneut spezifisch verarbeiten zu müssen. IBM erläuterte den zugrunde liegenden Ansatz am 17. April 2025. IBM Research zu aLoRA.
Switch verwendet einen normalisierten Cache-Zustand des Basismodells, damit Spezialisten nicht den jeweils angepassten privaten Zustand anderer übernehmen. Für die Anwendung heißt das: Lass den Evidenz-Präfix identisch und hänge die aufgabenspezifische Frage an. Schreibst du das Transkript für jede Prüfung anders um, erschwert das die Wiederverwendung des Präfixes. Dokumentation des Switch-Mechanismus, geprüft am 18. Oktober 2026.
Ein gemeinsamer Cache ist ein Effizienzmechanismus, keine kostenlose Inferenz. Präfix-Caching spart wiederholte Promptverarbeitung, beseitigt aber weder die Antwortgenerierung noch die Spracherkennung. Dokumentation zum vLLM-Präfix-Caching, geprüft am 18. Oktober 2026. Unser Fazit: Vergleiche vollständige, überprüfte Arbeitsabläufe und keine isolierten Spitzengeschwindigkeiten.
Plane die gesamte Arbeitslast ein, nicht nur die 8B-Gewichte
Als Überschlagsrechnung belegen 8 Milliarden Parameter bei zwei Byte je Parameter etwa 16 GB beziehungsweise 14,9 GiB; 30 Milliarden belegen etwa 60 GB beziehungsweise 55,9 GiB. Das sind Rechenbeispiele für Basisgewichte, keine Checkpoint-Größen und keine Mindest-VRAM-Angaben. Adapter, Sprachencoder, Cache, temporäre Puffer und Laufzeitaufwand sind nicht eingerechnet.
Längerer Kontext und mehr gleichzeitige Sequenzen erhöhen den Speicherdruck. Das beworbene Kontextmaximum des Modells ist keine Empfehlung, es für den ersten Versuch zu reservieren. vLLM nennt max_model_len und max_num_seqs als Stellschrauben zur Speicherbegrenzung. vLLM-Hinweise zum Speicher, geprüft am 18. Oktober 2026.
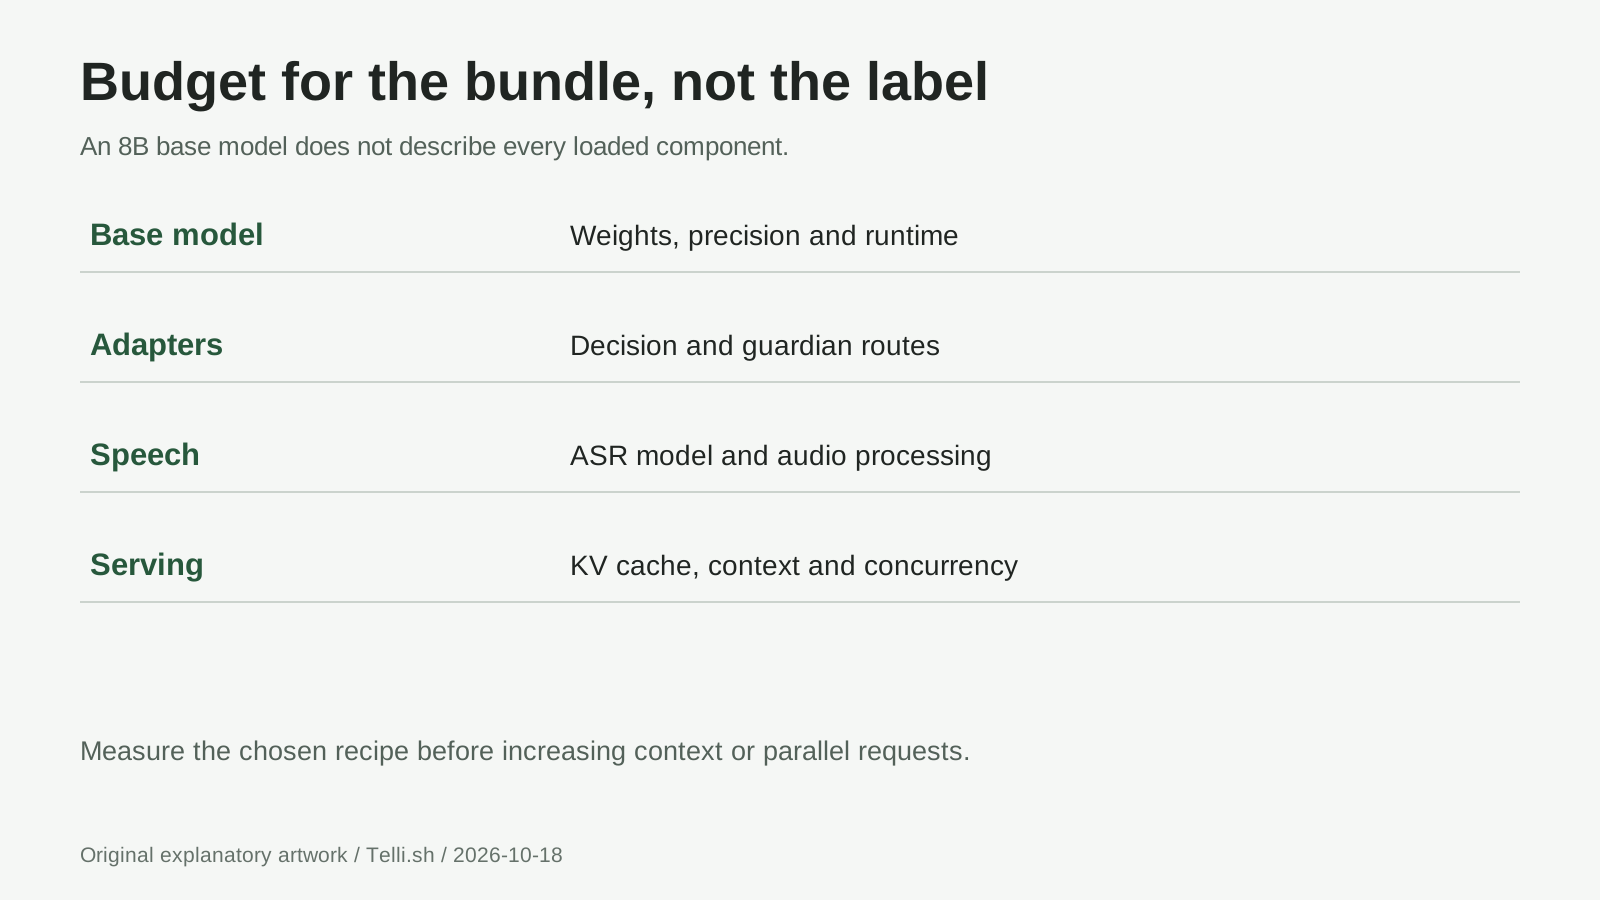
Eigene Speicherübersicht, nicht maßstabsgetreu: Basisgewichte + Adapter + ASR-Gewichte und Aktivierungen + KV-Cache + Reserve für Laufzeit und Anzeige. Die Audioanleitung warnt, dass eine vorab belegte Cache-Zuweisung zu wenig Platz für ASR lassen kann; geprüft am 18. Oktober 2026.
Teste kurzen Chat, kurzen Clip und deine längste übliche Eingabe getrennt. Notiere Spitzenwerte des Speicherverbrauchs, Antwortzeit und Fehler. Eine geringere Cache-Zuweisung kann mehr Raum für Sprache lassen, aber zu große Gewichte nicht passend machen. Eine quantisierte Alternative braucht eine eigene Kompatibilitätsprüfung für Switch-Adapter und Audio, nicht nur einen kleineren Download.
Verknüpfe Kosten und Datenschutz mit der Bereitstellungsentscheidung
Eine Apache-2.0-Modelllizenz macht den Betrieb nicht kostenlos. Lokale Nutzung beansprucht Hardware, Strom, Speicher und Wartungszeit; ein gehosteter Endpunkt verursacht Anbieterkosten und unterliegt dessen Datenbedingungen. Gehe nicht von einem allgemein gültigen Minutenpreis für Granite Switch aus. Teile für einen Pilotversuch die gesamten Rechen- und Prüfkosten durch die erfolgreich abgeschlossenen Vorgänge, einschließlich fehlgeschlagener Anfragen und Korrekturen.
Ein einfaches hypothetisches Budget macht das greifbar: Zehn Stunden zu einem Anbietertarif von 1 US-Dollar pro Stunde kosten 10 US-Dollar für Rechenleistung, noch ohne Speicher, Übertragung und menschliche Prüfung. Das sind Beispielwerte, kein Angebot eines Dienstes. Auch Leerlaufstunden eines Endpunkts zählen.
Bei sensiblen Aufgaben entscheidest du vor der Aufnahme, wo Audio, Transkripte, Cache, Protokolle und Sicherungen liegen. Die Bindung an Loopback begrenzt den Netzwerkzugriff, legt aber keine Aufbewahrungsfristen fest und schaltet nicht jede Telemetrie einer Bibliothek ab. Halte den Server von öffentlichen Schnittstellen fern, prüfe Abhängigkeiten und Protokollierung, hole die Zustimmung der sprechenden Person ein und definiere getrennte Löschfristen für Originalaudio und abgeleitete Datensätze. Eine gehostete Demo eignet sich zum Lernen, nicht als Standardziel für vertrauliche Besprechungen.
Behebe die fehlerhafte Stufe, bevor du den ganzen Stack austauschst
Die Architektur ist unbekannt. Prüfe, ob die virtuelle Umgebung granite-switch enthält, vLLM dieselbe Umgebung verwendet und VLLM_PLUGINS register_granite_switch enthält. Lies den ersten Plugin-Importfehler, bevor du Pakete austauschst.
Chat funktioniert, Audio aber nicht. Bestätige die Kennung der audiotauglichen Version, die Abhängigkeiten [audio] und eine echte WAV-Datei statt einer bloß umbenannten Datei. Prüfe Transformers-Version und verfügbaren Speicher. Dekodierungsbibliotheken machen aus einer Vorschauversion ohne Audio keinen Audiocheckpoint.
Namen oder Satzzeichen stimmen nicht. Der standardmäßige englische CTC-Erkenner liefert kleingeschriebenen Text ohne Satzzeichen und lässt sich beim Dekodieren nicht auf eine Sprache ausrichten. Bewahre den Rohtext auf; eine nachträgliche Zeichensetzung ist eine abgeleitete Bearbeitung. Erkennungsfehler können sich in nachfolgenden Entscheidungen fortpflanzen. Einschränkungen der Audiofunktion, geprüft am 18. Oktober 2026.
Ein langer Clip überschreitet den Kontext. Kürze die Eingabe oder teile sie in sinnvolle Abschnitte und behalte Quellenverweise bei. Das Transkript belegt Textkontext; für Frage und Antwort muss noch genügend Platz bleiben. Eine höhere Kontextgrenze verändert auch den Speicherbedarf.
Was solltest du wissen, bevor du dich darauf verlässt?
Kann das System seine Antworten laut vorlesen? Dieser gebündelte Sprachpfad ist ASR, keine Sprachsynthese. Für eine Sprachausgabe braucht eine Anwendung eine separate TTS-Komponente.
Kann es alle zwölf Chatsprachen transkribieren? Nicht mit dem standardmäßigen englischen Erkenner. Die Audioanleitung beschreibt den Austausch des ASR-Backends für mehrsprachige Eingaben; das ist eine andere Konfiguration, die evaluiert werden muss.
Bedeutet eine Optionswahrscheinlichkeit von 0,95, dass die Antwort in der Praxis zu 95 % stimmt? Nein. Sie beschreibt die Verteilung des Modells über die vorgegebenen Auswahlmöglichkeiten, keine geprüfte Erfolgsquote für deinen Bereich. Fehlende Optionen, fehlerhafte Transkripte und mehrdeutige Fragen können trotzdem zu einer starken Präferenz führen. Werte gekennzeichnete Beispiele aus und definiere Regeln für Enthaltung, bevor du Handlungen automatisierst. Dokumentation zum Entscheidungsadapter, geprüft am 18. Oktober 2026.
Beweist Guardian, dass eine Antwort wahr ist? Nein. Sicherheitsprüfung ist etwas anderes als Faktenüberprüfung. Die fertig zusammengestellte Version enthält nicht jeden Spezialisten aus der breiteren Granite-Libraries-Sammlung. Prüfe den Adapterbestand, bevor du einen Ablauf zur Faktenprüfung entwirfst.
Fazit: Auch ein einzelner Endpunkt braucht eine nachvollziehbare Belegkette
Granite Switch 4.1 ist am nützlichsten, wenn Chat erklärt, Sprache überprüfbare Worte liefert und begrenzte Entscheidungen den nächsten Schritt ordnen. Das modulare Serving-Design reduziert doppelte Infrastruktur; Verantwortung für Zustimmung, Belege und Handlungsbefugnis bleibt dennoch bei deinem Arbeitsablauf.
Beginne mit einer kurzen Aufnahme und einer reversiblen Entscheidung. Erweitere den Ablauf erst, wenn Transkript, Interpretation und Handlung für die verantwortliche Person nachvollziehbar bleiben.
Quellen
Die Ankündigung von IBM ist auf den 15. Oktober 2026 datiert; die 8B-Modellkarte nennt den 14. Oktober 2026. Die verlinkte Dokumentation wurde am 18. Oktober 2026 geprüft. Die Einrichtungsanweisungen beruhen auf Primärdokumentation, nicht auf eigenen Leistungstests. Die Diagramme sind redaktionelle Originalgrafiken; Herstellerbilder werden nicht wiedergegeben.
- IBM-Ankündigung, 8B-Modellkarte, 30B-Modellkarte und 3B-Vorschaukarte: Veröffentlichungsumfang und Unterschiede zwischen den Checkpoints.
- Granite-Switch-Repository, festgelegte Paketanforderungen und Audioanleitung: Installation, Architektur und Grenzen der Spracherkennung.
- Offizielle Sprachdemo, Demodokumentation und offizielles aLoRA-Rennen-Notebook: Beispiele zum Erkunden, keine gemessenen Ergebnisse dieses Leitfadens.
- IBMs Erläuterung zu aLoRA vom 17. April 2025 und vLLM-Dokumentation: Mechanismen und Betriebsanforderungen.
Empfehlung von Telli.sh (optional): Bewahre die Quellen hinter der Entscheidung auf
Bewahre Originalaufnahmen, Notizen und geprüfte Ergebnisse zusammen auf, damit spätere Entscheidungen ihren Kontext behalten. Erstelle ein Telli.sh-Konto, um dieses Quellenmaterial im Verlauf deines Arbeitsablaufs zu ordnen.