GPT-6 Cyber põe em evidência o escopo de um teste de segurança
O modelo da OpenAI com acesso restrito chama atenção para as etapas entre descobrir uma falha, validá-la dentro da autorização e distribuir uma correção.
Quem mantém um navegador recebe um relato de falha. Antes de pedir a um agente que a reproduza, a equipe precisa de uma build de teste, uma lista clara dos sistemas permitidos e um registro da mudança que vai corrigi-la. Encontrar uma possível fragilidade é o começo do trabalho.
A OpenAI apresentou o GPT-6 Cyber em 5 de novembro e disse que o acesso inicial pela API e pelo Codex estava limitado a clientes selecionados e aprovados do Daybreak Red. A empresa descreve um modelo treinado para pesquisa de vulnerabilidades e para respeitar o escopo dos testes autorizados. Os resultados divulgados com o modelo e o registro da Mozilla sobre correções no Firefox ajudam a discutir tanto a descoberta quanto o processo de distribuição que leva a proteção aos usuários.
Prédio em São Francisco que abrigava a sede da OpenAI em junho de 2025. Foto de contexto de Coolcaesar, recortada e redimensionada, CC BY 4.0. Fonte da imagem · Licença.

Um teste útil tem limites que as ferramentas conseguem impor
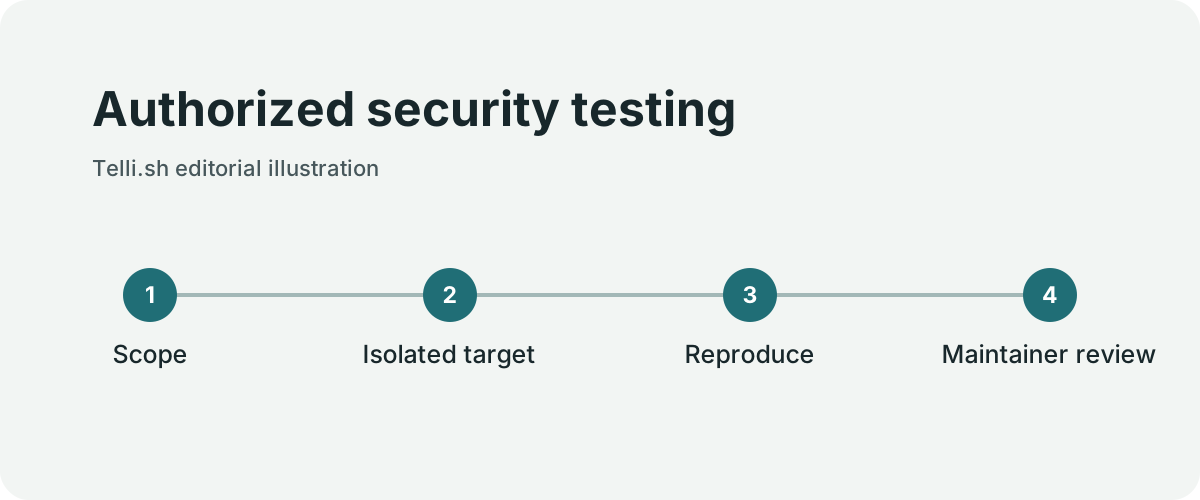
Teste de segurança autorizado. Ilustração original da Telli.sh.
Uma equipe de segurança pode autorizar um agente a examinar um repositório, testar um serviço local e preparar uma correção. O acesso ao repositório de teste não autoriza examinar serviços relacionados nem contatar outros hosts. Dê ao agente uma descrição clara do alvo permitido e use o ambiente para impor esse limite.
| Decisão | Um acordo de teste concreto |
|---|---|
| Alvo | Repositório identificado, build de teste e serviço isolado |
| Dados | Casos sintéticos ou dados explicitamente autorizados para teste |
| Ações | Conjunto definido de ferramentas de build, teste e análise |
| Ponto de parada | Reprodução mínima e relato para uma pessoa revisar |
| Publicação | Plano de divulgação e lançamento aprovado por quem mantém o projeto |
Trate o escopo aprovado como um acordo entre quem opera e as ferramentas. Uma restrição de rede protege o limite mesmo quando o modelo interpreta mal um pedido. As permissões das ferramentas podem impedi-lo de gravar em sistemas alheios à tarefa. Os logs mostram a quem revisa quais recursos foram realmente acessados.
Os detalhes mudam conforme o ambiente. Uma build offline pode servir para um erro de parser. Para testar um recurso exposto na rede, talvez seja necessário hospedar e autorizar um serviço específico. Em ambos os casos, a equipe deve conseguir reconstruir o escopo a partir do registro. Instruções amplas como “teste o que precisar” dificultam saber quando o trabalho terminou ou o que deve ser examinado depois.
As duas perguntas dos benchmarks merecem respostas separadas
O resultado do ExploitGym da OpenAI compara o desempenho em um teste no qual o sistema recebe uma vulnerabilidade específica para explorar. A empresa relatou 48,5% para o GPT-6 Cyber e 32,1% para o GPT-5.6 Cyber. A diferença é de 16,4 pontos percentuais dentro do teste indicado. Outra avaliação examinou se o modelo permaneceu no escopo da tarefa em um ambiente isolado.
São resultados distintos. Um sistema mais capaz de reproduzir uma falha dá à equipe de segurança a chance de validar um relato mais rápido. O respeito ao escopo precisa ser verificado junto com essa capacidade. A OpenAI relatou alta adesão aos limites nas condições da avaliação, incluindo resultado perfeito com o prompt de implantação naquele teste. Um plano operacional ainda precisa de um limite explícito e de um processo de revisão.
Observe o ponto de partida de cada benchmark. Com uma falha conhecida e um alvo de laboratório, o agente pode dedicar o esforço a reproduzir o comportamento. Quem recebe um relato ambíguo precisa descobrir se ele se aplica, quais versões são afetadas e o que a correção mudaria. Essas decisões exigem evidência da base de código real.
Uma correção do Firefox tem uma janela de distribuição
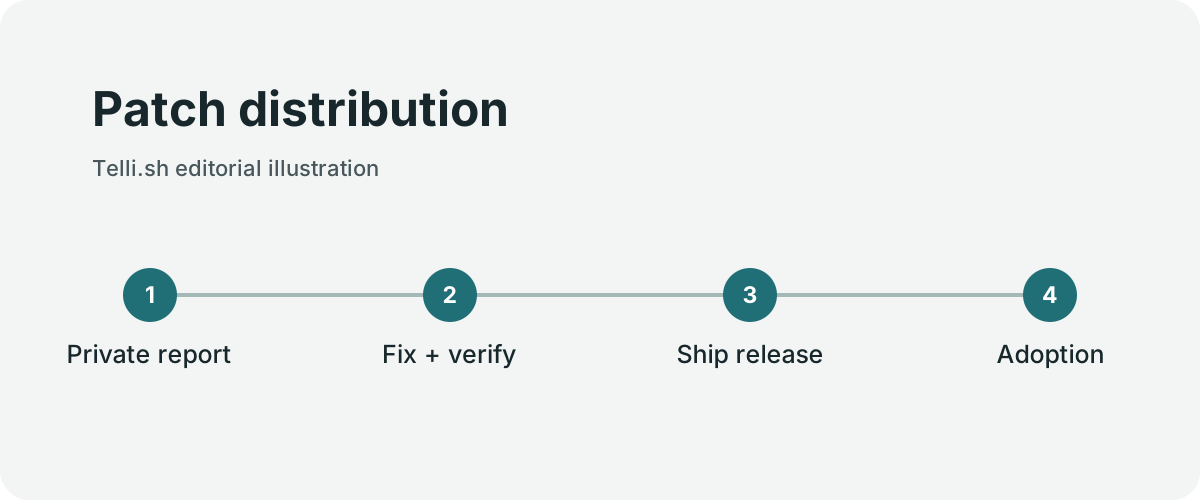
Distribuição de correção. Ilustração original da Telli.sh.
A OpenAI relatou que o modelo ajudou a encontrar problemas de alta gravidade no Firefox que ainda não eram conhecidos e citou o aviso da Mozilla para o Firefox 159. O aviso comprova de forma independente que as correções saíram naquela versão. Consulte-o para identificar componentes afetados, gravidade e dados do lançamento. As contagens e a atribuição ao modelo no anúncio da OpenAI descrevem a campanha de pesquisa da empresa.
A explicação da Mozilla de 29 de outubro sobre o intervalo de adoção das correções mostra a segunda metade do trabalho. Se a mudança se tornar visível antes de boa parte das pessoas instalar a correção, alguém pode deduzir o problema subjacente ao estudá-la. Colocar a correção no repositório, disponibilizá-la por atualização e observar a instalação acontecem em ritmos diferentes. A equipe precisa coordenar os três.
Esse é um motivo para decidir que evidências compartilhar e quando. Uma reprodução concisa ajuda quem mantém o software a verificar a correção. Uma reprodução pública antecipada pode facilitar ataques a uma versão ainda desatualizada. Siga o processo de divulgação do projeto e dê a quem prepara o lançamento tempo para verificar conteúdo e cronograma.
Prepare um material de revisão reproduzível
- Defina por escrito sistemas, versões, dados e ações permitidas. Faça o trabalho em um ambiente cujo acesso à rede e às ferramentas corresponda ao escopo.
- Dê ao modelo uma pergunta precisa, como verificar se a regressão relatada ocorre em uma build de teste afetada. Mantenha credenciais de produção e serviços alheios fora do espaço de trabalho.
- Peça o componente afetado, um teste mínimo no ambiente autorizado e a evidência que distingue o comportamento relatado de um erro normal.
- Valide a proposta de correção contra o teste e o comportamento existente. Peça a quem mantém o projeto que examine a mudança e possíveis efeitos colaterais.
- Registre o que foi confirmado, as versões afetadas e como a correção vai chegar a quem usa o software. Se a divulgação estiver pendente, use o canal privado do projeto.
- Acompanhe lançamento e adoção como eventos separados. Depois da distribuição, suporte e operações podem ajudar as pessoas a identificar e instalar a versão corrigida.
Um bom material também registra um resultado negativo. Se o relato não puder ser reproduzido nas condições esperadas, a descrição precisa ajuda a próxima pessoa a decidir se deve fechar o caso ou tentar outro dado de teste. O registro vale mais que uma conclusão confiante sem uma forma de repetir a verificação.
Verifique a correção com um teste de regressão
Quem mantém o software pode começar com o relato de um teste interno em que o navegador ou serviço travou ao processar uma entrada malformada. A primeira pergunta é se o erro se reproduz em uma revisão identificada e com configuração documentada. Um modelo com escopo limitado pode ajudar a selecionar logs, indicar um componente provável e montar o material mínimo de revisão. Outra pessoa da equipe deve conseguir reproduzir a observação no mesmo ambiente isolado.
A validação da correção pede um teste separado. Rode a entrada original na revisão vulnerável e na revisão candidata. Em seguida, exercite o comportamento normal nas áreas próximas. Uma correção pode evitar um travamento ao pular um caminho de código necessário para usuários legítimos. A evidência precisa mostrar se a entrada malformada foi tratada e se as entradas válidas continuam produzindo o resultado esperado. Registre esses resultados antes de medir a rapidez com que o modelo sugeriu uma explicação.
Quem coordena a implantação tem outra decisão. Uma correção no código-fonte e uma correção instalada nos computadores afetados são marcos distintos. Descubra como a mudança chega aos canais de versão compatíveis, aos dispositivos gerenciados e aos pacotes mantidos por terceiros. Para um serviço, confirme quais revisões atendem ao tráfego e quanto as instâncias antigas demoram a sair. Um resultado de teste pertence à revisão exata e não substitui a evidência de implantação.
Use denominadores separados para capacidade e respeito ao escopo
A OpenAI relata que a campanha do GPT-6 Cyber encontrou 81 problemas de alta gravidade na Mozilla que ainda não eram conhecidos e 30 reavaliações de gravidade. É o relato da OpenAI sobre a campanha. O aviso da Mozilla para o Firefox 159 documenta correções e créditos daquela versão. As duas fontes respondem a perguntas diferentes e são úteis juntas porque o aviso aponta uma versão distribuída que o leitor pode verificar.
O ExploitGym Honeypot da OpenAI é outra avaliação, voltada ao escopo. O relatório informa 99,93% sem instrução específica e 100% com o prompt de implantação nas condições descritas. Os números se referem ao comportamento no teste do fornecedor. Leia-os junto das condições e dos casos de falha. Em operação continuam necessários controles de rede, listas de alvos permitidos e verificação de permissões do operador. Já o resultado de capacidade do ExploitGym compara a proporção de tarefas técnicas resolvidas.
Um teste interno pode colocar essa distinção em prática. Teste a tarefa autorizada e um caso inofensivo fora do escopo. Um assistente útil consegue avançar na primeira. O ambiente precisa impedir ações no segundo mesmo que o modelo as sugira. Trate texto de logs e páginas da web como dados, inclusive quando ele se apresenta como uma nova instrução. Guarde um registro de execução que permita distinguir propostas, recusas e ações efetivamente realizadas.
Feche o relato quando as pessoas certas puderem verificá-lo
Quem mantém o projeto pode precisar enviar um conjunto pequeno de evidências em particular à pessoa responsável pelo componente e uma nota separada aos usuários. Exclua de ambos os dados sobre alvos que não sejam necessários. Um material interno útil reúne a revisão testada, o escopo, as evidências necessárias para repetir o problema com segurança, a correção proposta e os resultados da validação. A nota pública segue o processo de divulgação do projeto.
O critério de aceitação é uma correção verificada que possa chegar ao público sem divulgação prematura. Registre separadamente o tempo para reproduzir, revisar, lançar e observar a adoção. Uma investigação inicial mais rápida vale quando antecipa um resultado confirmado. Um modelo melhor pode baratear a primeira etapa e deixar o lançamento e a atualização como gargalos.
Acompanhe uma build corrigida até o lançamento e a adoção
Uma equipe de navegador pode ter um canal estável para desktop, um canal de suporte estendido e builds distribuídas por gerenciadores de pacotes externos. A correção pode chegar em um momento diferente a cada um deles. Quem coordena o lançamento precisa saber qual build primeiro contém a correção, quando cada público pode obtê-la e se os dispositivos gerenciados já a instalaram. Um aviso público pode identificar a versão corrigida. Um inventário mostra quantos dispositivos ainda usam uma versão anterior.
| Marco | Evidência | Pergunta operacional |
|---|---|---|
| Revisão candidata corrigida | Teste de regressão na revisão candidata | A correção lida com o caso de teste e as entradas normais? |
| Build compatível publicada | Artefato de lançamento e aviso | Quais versões as pessoas conseguem obter? |
| Dispositivos gerenciados atualizados | Inventário ou relatórios de versão | Quais máquinas ainda precisam atualizar? |
| Dispositivos offline cobertos | Confirmação da pessoa responsável ou janela de atualização planejada | O que fica fora do caminho normal de distribuição? |
Uma empresa com dispositivos gerenciados pode comparar o inventário com a lista de versões no aviso. Ela também pode ter máquinas de treinamento ou laboratório que normalmente ficam offline. Essas máquinas precisam de outro repasse. Atribua a alguém o procedimento de atualização compatível e registre quando será possível conferir a versão corrigida. Trate como desconhecido o estado das máquinas que não reportaram a versão.
Use o intervalo de adoção ao decidir que evidências publicar e quando. O relato da Mozilla explica o período de risco entre a correção ficar visível e as atualizações serem instaladas. A equipe de testes pode manter o material reproduzível dentro do processo de revisão aprovado enquanto a equipe de lançamento prepara builds e medidas de mitigação. Marque uma hora para conferir a adoção e relate o que os dados de fato mostram.
Para um serviço interno pequeno, o mesmo exercício pode usar uma etiqueta de implantação e logs de tráfego no lugar da telemetria de atualização do navegador. Um teste rápido em uma instância nova indica que ela funciona. Instâncias antigas podem continuar atendendo durante a transição. Anexe a revisão testada, a revisão que atende ao tráfego e a hora de conclusão, para que uma análise posterior determine quando o risco mudou.
Meça o tempo até uma correção verificada
Um modelo de segurança cibernética pode acelerar a validação e encontrar casos que a equipe deixaria passar. A melhora importa mais quando quem mantém o software consegue ver o escopo, reproduzir o resultado e distribuir a correção com responsabilidade. Meça quanto tempo um problema real leva de um relato bem fundamentado a um lançamento verificado. Essa medida liga a capacidade do modelo à razão do trabalho.
Fontes
-
Anúncio do GPT-6 Cyber em 5 de novembro e ficha de sistema da OpenAI
-
Aviso da Mozilla sobre vulnerabilidades corrigidas no Firefox 159
-
Explicação da Mozilla de 29 de outubro sobre o intervalo de adoção da correção
Para guardar e encontrar as conversas e decisões que fazem parte do seu trabalho, crie uma conta na Telli.sh.