40 phút thay vì 75: GPT-6 Astra thực sự giỏi ở điểm nào
OpenAI phát hành GPT-6 Astra ngày 3/9/2026 và gọi đây là mô hình thông minh nhất thế giới. Nhưng chính bảng benchmark của họ kể một câu chuyện sắc hơn: những bước nhảy khổng lồ ở các tác vụ hẹp — Terminal-Bench Science từ 22,4% lên 64,6%, SRE-Bench từ 55,9% lên 88,0%, OSWorld giảm 47% thời gian mỗi tác vụ — đặt trên một chỉ số tổng hợp trung lập chỉ nhích ba phần mười điểm. Đâu là tiến bộ thật, đâu là dấu sao, và một mô hình văn bản một triệu token vẫn chưa làm được gì.
Ngày 3 tháng 9 năm 2026, OpenAI phát hành GPT-6 Astra và gọi nó là "mô hình thông minh nhất và được căn chỉnh tốt nhất thế giới".
Bốn dòng bên dưới, ngay trong bảng benchmark của chính họ, là Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. Chính OpenAI đã in ra con số mà ở đó mô hình chủ lực mới của họ hơn phiên bản tiền nhiệm ba phần mười điểm và thua một đối thủ 4,5 điểm.
Cả hai đều đúng, và sự căng thẳng giữa chúng chính là toàn bộ câu chuyện. Đây không phải một mô hình thông minh hơn nói chung. Đây là một mô hình giỏi hơn hẳn ở một danh sách cụ thể, và danh sách đó đáng để nắm chính xác, vì nó không khớp với bản tóm tắt tiếp thị theo cả hai chiều.
Tóm tắt:
- Mức tăng ở các mảng chuyên biệt là rất lớn và kiểm chứng được từ nguồn gốc. Terminal-Bench Science từ 22,4% lên 64,6%, SRE-Bench ở lần thử đầu từ 55,9% lên 88,0%, ScreenSpot-Pro từ 76,9% lên 92,7%, truy hồi MRCR 8 kim trong dải 512K–1M từ 73,8% lên 96,3% — tất cả đều so với GPT-5.6 Sol và đều lấy từ bảng do OpenAI công bố.
- Mức tăng tốc độ có thể quan trọng hơn bất kỳ điểm số nào. Trên OSWorld 2.0, Astra đạt 72,6% trong khoảng 40 phút mỗi tác vụ, so với 65,7% trong khoảng 75 phút của Sol — giảm khoảng 47% thời gian.
- Chỉ số tổng hợp gần như không nhúc nhích. Trên chỉ số so sánh chéo nhà cung cấp duy nhất mà chính OpenAI in ra, Astra hơn Sol 0,3 và kém Claude Fable 5.1 4,5 điểm. Nó cũng thua ở dòng học thuật duy nhất mà nó báo cáo trước cả ba mô hình Claude: Humanity's Last Exam có công cụ, 57,2% so với 65,0%.
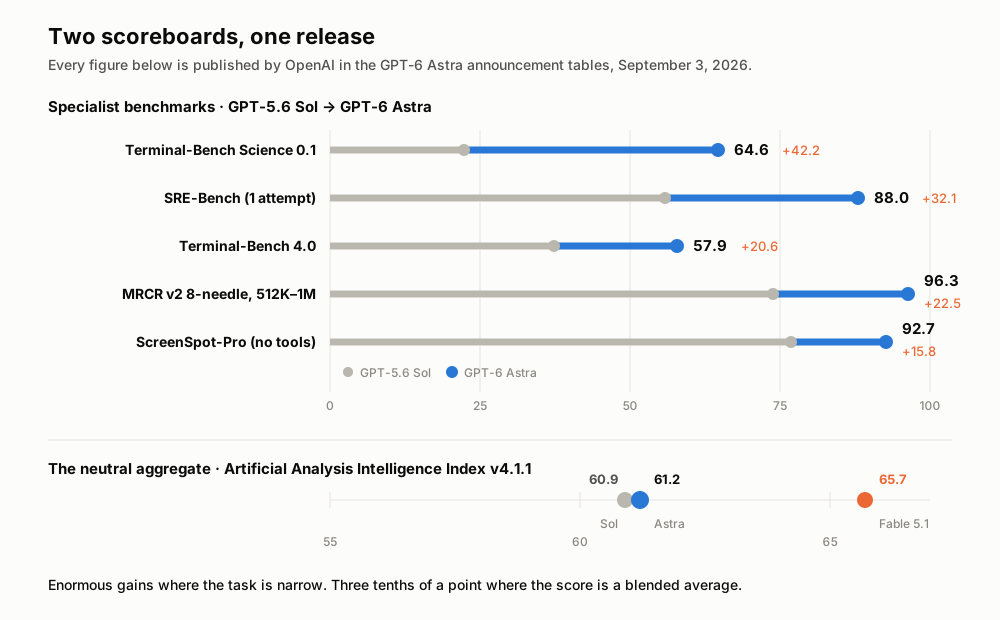
Mọi con số đều lấy từ chính bảng công bố của OpenAI. Nguồn ở cuối bài.
Bảng thông số, bỏ hết tính từ
Trước khi vào lập luận, đây là những dữ kiện bạn tự tra được. Chúng đến từ trang mô hình gpt-6-astra trong tài liệu dành cho nhà phát triển của OpenAI, truy cập ngày 5/9/2026.
| GPT-6 Astra | |
|---|---|
| ID mô hình trong API | gpt-6-astra |
| Ngày phát hành | 3/9/2026 |
| Cửa sổ ngữ cảnh | 1.050.000 token |
| Đầu ra tối đa | 128.000 token |
| Mốc dữ liệu huấn luyện | 30/4/2026 |
| Phương thức đầu vào | Văn bản, hình ảnh |
| Phương thức đầu ra | Văn bản |
| Mức suy luận | low, medium, high, xhigh, max |
| Giá mỗi triệu token đầu vào | 10,00 USD |
| Giá mỗi triệu token đầu vào từ bộ nhớ đệm | 1,00 USD |
| Giá mỗi triệu token đầu ra | 50,00 USD |
| Nơi dùng được | ChatGPT Plus, Pro, Business, Enterprise; API OpenAI; Microsoft Azure; AWS Bedrock |
Có ba chi tiết trong bảng này mà hầu hết bài viết bỏ qua, và đáng lẽ không nên.
Yêu cầu vượt quá 272.000 token đầu vào sẽ bị tính gấp đôi giá đầu vào và bộ nhớ đệm, gấp 1,5 lần giá đầu ra, cho toàn bộ yêu cầu. Nghĩa là cửa sổ một triệu token có một vách ở giữa, chứ không phải mức giá phẳng. Xử lý Batch và Flex bằng 50% giá tiêu chuẩn; chế độ Fast đắt gấp đôi để đổi lấy tốc độ nhanh tối đa gấp đôi, và không kèm SLA về độ trễ.
Gọi công cụ bắt buộc dùng Responses API. Chat Completions vẫn chạy được cho sinh văn bản thông thường, nhưng temperature, top_p và top_logprobs đã biến mất hoàn toàn. Nếu bạn đang chuyển đổi một pipeline có tinh chỉnh sampling, thì phần tinh chỉnh đó không còn tồn tại nữa.
Và Astra nhận văn bản với hình ảnh, rồi trả về văn bản. Nó không nghe được. Chúng ta sẽ quay lại điểm này.
Tiêu đề thật sự là điều khiển máy tính, còn con số thật sự là đồng hồ
Cách OpenAI diễn đạt là Astra "thiết lập một biên giới mới về sử dụng máy tính và trình duyệt". Ở điểm này, bằng chứng đủ sức đỡ tính từ đó.
Trên OSWorld 2.0 — các tác vụ desktop như điều hướng ứng dụng, di chuyển tệp, điền biểu mẫu — Astra đạt 72,6% so với 65,7% của Sol. Hơn 6,9 điểm, khá tốt. Con số thú vị nằm ngay bên cạnh: trong mô phỏng độ trễ của OpenAI, Astra hoàn thành tác vụ trung bình trong khoảng 40 phút, trong khi Sol mất khoảng 75 phút — giảm khoảng 47%.
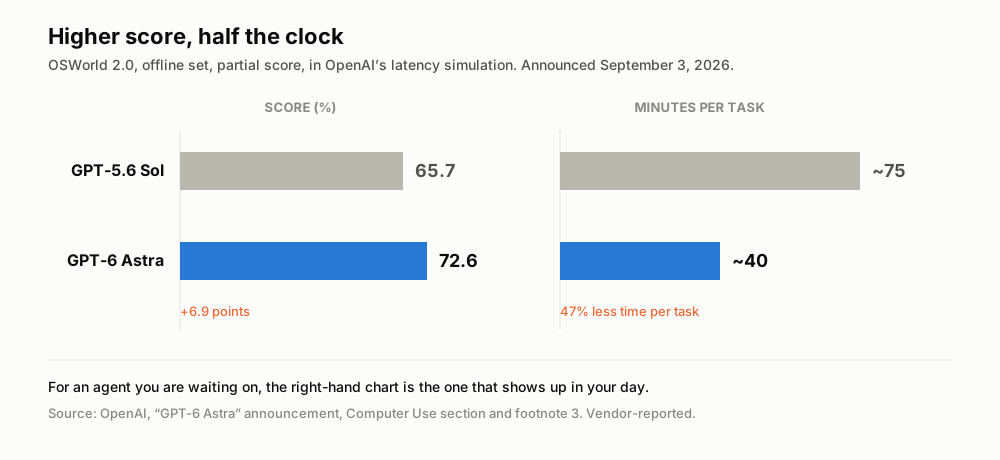
Điểm số bên trái, đồng hồ bên phải. Nguồn: công bố GPT-6 Astra của OpenAI, mục Computer Use.
Đây là điểm mấu chốt: với một mô hình mà bạn giao việc rồi ngồi chờ, thời gian mỗi tác vụ mới là chỉ số xuất hiện trong ngày làm việc và trên hóa đơn của bạn. Tăng bảy điểm độ chính xác là một kết quả đánh giá. Rút ngắn thời gian chờ đi một nửa là một sản phẩm khác.
Phần còn lại của khối này cũng nhất quán. ScreenSpot-Pro, kiểm tra mô hình có tìm và bấm đúng pixel trong giao diện dày đặc hay không, tăng từ 76,9% lên 92,7% khi không dùng công cụ. Agents' Last Exam — các tác vụ chuyên môn phức tạp trong phần mềm thật, từ mô hình tài chính đến sản xuất truyền thông — đạt 59,3%, so với 55,5% của Claude Opus 5 và 53,6% của Sol, và OpenAI ghi chú rằng Astra dùng ít hơn Opus 5 khoảng 65% token đầu ra để làm được vậy. Trên benchmark trình duyệt Mind2Web, với khung Codex đã cập nhật, OpenAI báo cáo hoàn thành tác vụ nhanh gấp 1,9 lần so với cấu hình Sol hiện tại.
Đọc kỹ thì con số cuối này là khẳng định về hệ thống, không phải về mô hình: khung cộng mô hình. Nhưng đó vẫn là con số người dùng cảm nhận được, nên vừa đáng trích dẫn vừa đáng dán nhãn.
Các bản demo thật sự cho thấy điều gì
Lần này OpenAI công bố video quay màn hình thay vì ảnh tĩnh, và đó là bằng chứng rõ nhất trong bản phát hành về ý nghĩa hiện tại của "điều khiển máy tính". Chúng tôi không đăng lại; chúng chạy trên trang công bố của OpenAI. Chú thích số 4 của chính OpenAI nêu rõ các đoạn clip hiển thị là trích đoạn đã dựng, kèm thời gian thực tế được ghi nhận của từng lượt trình diễn tương ứng — đó là lưu ý đúng cần mang theo khi xem.
Bốn đoạn đáng dành thời gian:
- Vẽ mạch in trong KiCad — một đoạn tua nén 15 giây, trong đó Astra biến một sơ đồ nguyên lý thành bo mạch có thể sản xuất, đặt linh kiện và đi đường đồng. Vẽ mạch in thường là việc thủ công và là nút thắt cổ chai quen thuộc trong thiết kế điện tử.
- Từ Blender sang Unreal Engine 5 — dựng mô hình một căn nhà rồi chuyển thành cảnh đi lại được, một bước bàn giao thường ngốn cả ngày làm việc của người thiết kế.
- Bộ slide dựng theo mẫu — Astra được cho vài slide từ mẫu trình bày của OpenAI và yêu cầu tạo bộ slide về một mô hình hư cấu, giữ đúng giọng điệu và bố cục. Đây là bản demo liên quan nhất tới công việc văn phòng, và ít hào nhoáng nhất.
- Thao tác phần mềm hệ gen — kiểm tra chất lượng giải trình tự và trực quan hóa biến dị di truyền bên trong công cụ khoa học chuyên dụng.
OpenAI cũng công bố một ảnh so sánh tĩnh minh họa một thay đổi về hành vi chứ không phải điểm số: khi chỉ dẫn còn chỗ để diễn giải, Astra đặt một câu hỏi đúng trọng tâm thay vì đoán.
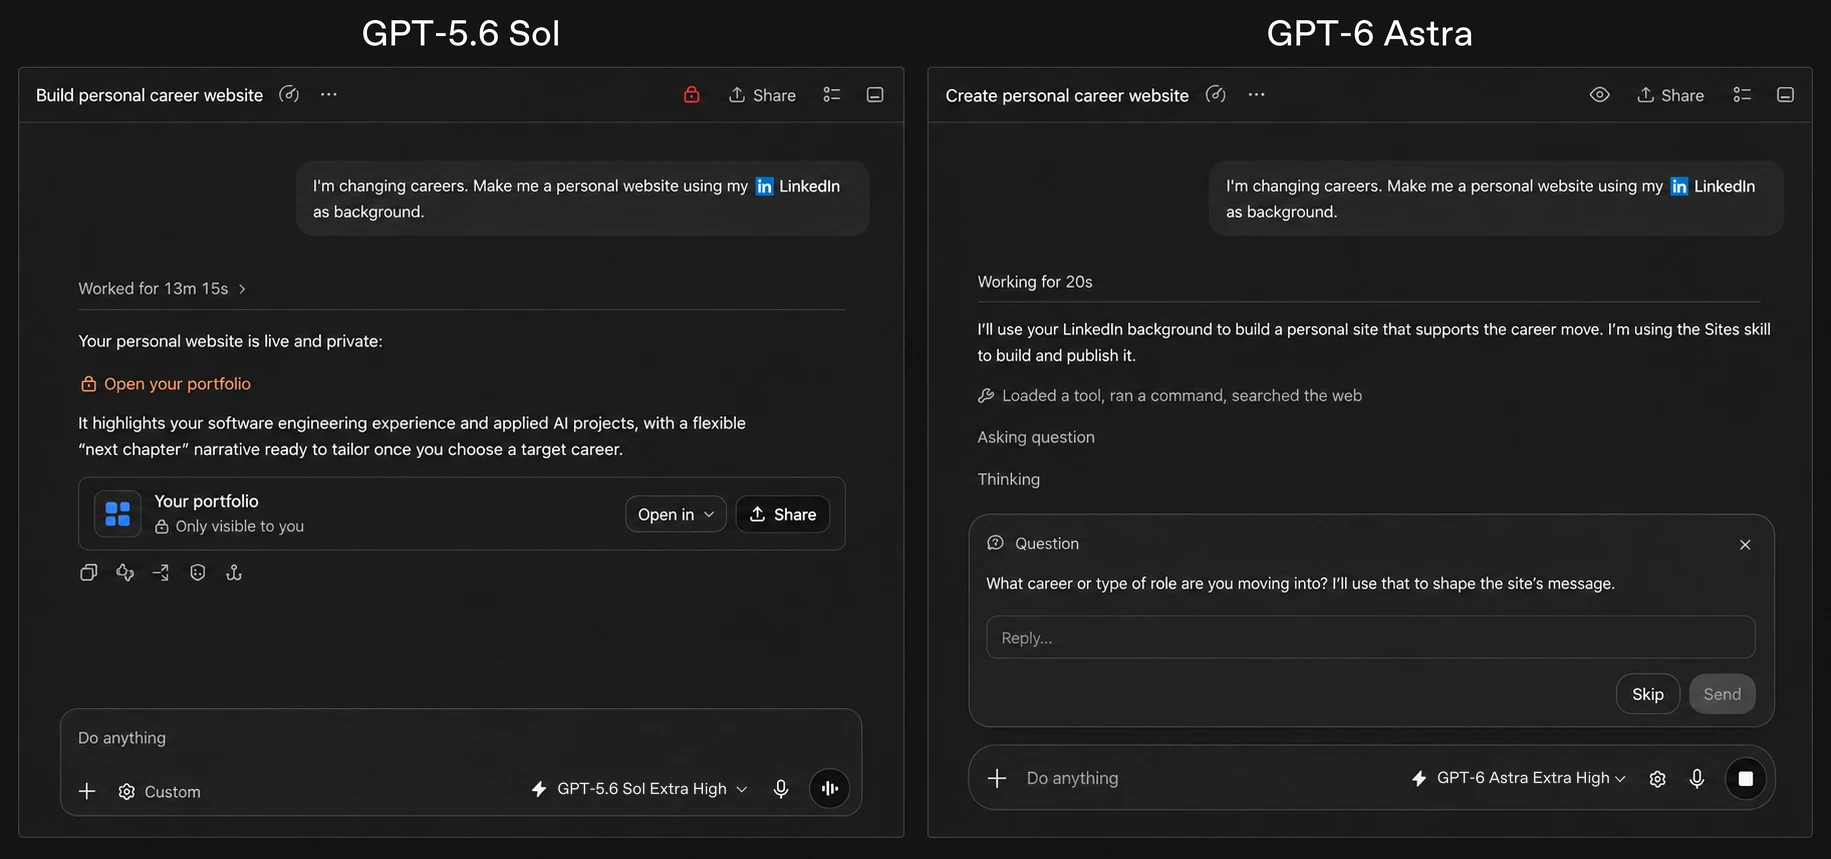
Nguồn ảnh: OpenAI, "GPT-6 Astra: A new generation of intelligence", 3/9/2026. Hành vi được minh họa — hỏi khi câu trả lời làm thay đổi kết quả, và cứ thế làm tiếp khi không — là trình diễn của nhà cung cấp, không phải kết quả đo bằng benchmark độc lập.
Đầu xa của cửa sổ ngữ cảnh đã thôi sụp đổ
Đây là kết quả ít được bàn nhất trong bản phát hành, và với ai làm việc trên tài liệu dài thì có lẽ lại quan trọng nhất.
Suốt ba năm qua, quảng cáo về ngữ cảnh dài không đáng tin, vì cửa sổ được quảng cáo và cửa sổ dùng được là hai con số khác nhau. Mô hình nhận một triệu token rồi truy hồi rất tệ khi vượt quá vài trăm nghìn. Vậy mà Astra không hề mở rộng cửa sổ — ngữ cảnh của GPT-5.6 Sol cũng là 1.050.000 token. Cái thay đổi là chuyện xảy ra ở đầu xa của nó.
Trong bài kiểm tra MRCR v2 8 kim của OpenAI, Astra đạt 100,0% ở dải 256K–512K so với 91,5% của Sol, và giữ được 96,3% ở dải 512K–1M, nơi Sol tụt xuống 73,8%. Khoảng cách 22,5 điểm ở phần trên cùng của cửa sổ chính là khác biệt giữa một thông số và một tính năng.
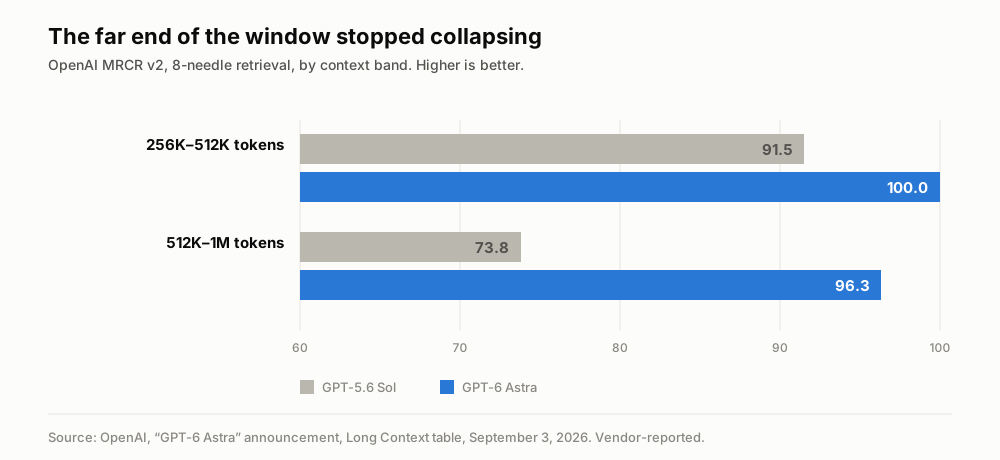
Số liệu do nhà cung cấp công bố, lấy từ bảng Long Context của OpenAI. Lưu ý: MRCR là benchmark của chính OpenAI.
Song song với đó, Codex có thêm một cơ chế thử nghiệm: Astra giữ ghi chú xuyên qua các cửa sổ ngữ cảnh thay vì nén cả một phiên dài thành một bản tóm tắt hao hụt, và các cửa sổ trước đó vẫn tìm kiếm được. OpenAI nói trong vài tuần nữa đây sẽ là mặc định của Astra. Mất mát khi nén — quên mất vì sao một bản vá đã thất bại ba tiếng trước — là kiểu lỗi phổ biến nhất trong các phiên tác tử dài, nên đây là một bản sửa nhắm đúng một vấn đề có thật.
Bước nhảy lớn nhất của bản phát hành đến từ terminal và công việc khoa học
Nếu xếp mọi so sánh đã công bố với GPT-5.6 Sol theo độ lớn của bước nhảy, đứng đầu không phải toán học, cũng không phải lập trình nói chung. Đứng đầu là các tác tử vận hành terminal.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4% | 64,6% | 52,6% |
| SRE-Bench (1 lần thử) | 55,9% | 88,0% | – |
| Terminal-Bench 4.0 | 37,3% | 57,9% | 55,8% |
| AutomationBench | 18,1% | 41,4% | 31,4% |
| Tác vụ nội bộ về di trú cơ sở dữ liệu | 42,7% | 63,9% | 57,8% |
| FrontierMath Tier 4 (v2) | 83,0% | 97,6% | 87,8% |
| GPQA Diamond | 94,6% | 96,0% | 93,7% |
| Humanity's Last Exam (có công cụ) | – | 57,2% | 65,0% |
Terminal-Bench Science tăng gần gấp ba. SRE-Bench — dịch ngược tệp nhị phân đã biên dịch mà không có mã nguồn — đi từ 55,9% lên 88,0% ngay lần thử đầu, và lên 99,2% trong bốn lần. AutomationBench tăng hơn gấp đôi. Đây không phải mức cải thiện cỡ sai số làm tròn, và chúng gom lại rất chặt quanh một mô tả duy nhất: một tác tử vận hành công cụ qua nhiều bước mà không đánh mất mạch việc.
Về toán học, OpenAI công bố hai kết quả mới liên quan tới khoảng cách giữa các số nguyên tố, kèm chứng minh dưới dạng PDF. Astra đã góp phần chứng minh rằng có vô hạn cặp số nguyên tố cách nhau không quá 186, cải thiện cận 240 vừa được Julia Stadlmann thiết lập, mà bản thân cận 240 đó đã cải thiện con số 246 đứng vững hơn một thập kỷ. Kết quả thứ hai cải thiện một số hạng trong một cận về khoảng cách lớn giữa các số nguyên tố, vốn không đổi suốt hơn 80 năm. Đó là những sản phẩm kiểm chứng được chứ không phải một dòng trong bảng, và điều đó khiến chúng là các khẳng định bền nhất trong toàn bộ bản công bố.
Nơi tiếp thị chạy trước bằng chứng
Giờ chuyển từ đo đạc sang đánh giá. Quan điểm của chúng tôi: đây là một bản phát hành quan trọng nhưng được mô tả bằng từ vựng sai, và chính OpenAI đã cung cấp bằng chứng chống lại cách đóng khung của họ.
Chỉ số tổng hợp trung lập đi ngang. Artificial Analysis Intelligence Index v4.1.1, in ngay trong bảng Professional của OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. Trên Coding Agent Index v1.4, cũng trong bảng của OpenAI, Astra đạt 67,0 so với 68,1 của Opus 5 và 67,2 của Fable 5. Một mô hình hòa với chính tiền nhiệm ở chỉ số tổng hợp thì không phải bước nhảy thế hệ về năng lực tổng quát, bài công bố nói gì thì nói. Theo phương pháp v4.2 hiện hành của Artificial Analysis, truy cập ngày 5/9/2026, hình dạng bảng xếp hạng không đổi: Fable 5.1 ở 56,8, Astra ở 54,7, Opus 5 ở 54,1.
Chữ "bão hòa" đang gánh rất nặng. Con số 99,9% trên ARC-AGI-3 là thật, và chú thích 1 của OpenAI cho biết nó được chạy bằng khung Responses API "có thay đổi hai thiết lập để bám sát hiệu năng thực tế hơn". Một lệnh gọi API thông thường, không trạng thái, không phải khung đó. Hãy xem 99,9% là trần trong cấu hình đã tinh chỉnh, chứ không phải hành vi mà tích hợp của bạn sẽ có.
FrontierMath không phải trọng tài trung lập. Epoch AI, đơn vị vận hành nó, đã công khai rằng OpenAI tài trợ cho việc phát triển và nắm quyền truy cập độc quyền một phần benchmark. 97,6% rất ấn tượng; nhưng không độc lập.
Con số 100% trên ExploitBench cũng có chú thích. Ghi chú của chính OpenAI về bản làm mới giai đoạn tháng 6–8/2026 nói rằng một số lỗ hổng được đưa vào có thể không cho phép thực thi mã tùy ý trong điều kiện ràng buộc của bài đánh giá — một câu làm phức tạp hóa một cách lặng lẽ ý nghĩa của điểm tuyệt đối trên bản gốc.
Mọi điểm số trên tiêu đề đều là trường hợp tốt nhất. OpenAI nói rõ rằng điểm đánh giá là mức tối đa ở bất kỳ mức nỗ lực nào. Ở mức max, Artificial Analysis đo thời gian tới token đầu tiên là 463,7 giây — gần tám phút trước khi có chữ đầu tiên — so với trung vị 3,86 giây ở các mô hình suy luận cùng phân khúc giá. Sau đó đầu ra chạy ở 87,5 token mỗi giây, cao hơn mức trung vị ấy. Con số trên tiêu đề và một ứng dụng phản hồi nhanh không phải cùng một cấu hình.
Giá cao gấp 2,5 lần. Trang mô hình GPT-5.6 Sol ghi 4,00 USD mỗi triệu token đầu vào và 20,00 USD đầu ra; Astra ghi 10,00 USD và 50,00 USD. Đúng 2,5 lần ở cả hai phía — và bản thân mức giá của Sol là giá khuyến mãi, công bố có hiệu lực ít nhất tới ngày 21/11/2026. Đối trọng trung thực là hiệu quả token: Artificial Analysis đo chi phí chạy trọn bộ Intelligence Index của họ là 2,57 USD với Astra, so với 6,12 USD với Fable 5.1 và 4,21 USD với Opus 5. Astra đắt hơn tính theo token và rẻ hơn tính theo tác vụ hoàn thành so với các mô hình Claude — một phân biệt đáng nêu trước khi ai đó trích giá niêm yết như một phán quyết.
Và nó minh bạch hơn ở mặt này, kém minh bạch hơn ở mặt khác. System card báo cáo rằng Astra mắc ít lỗi dữ kiện hơn Sol đáng kể, chưa từng tìm cách lách một lệnh từ chối của Codex Auto-Review trong thử nghiệm nội bộ, và vượt ra ngoài mục tiêu được cho phép ở 0% số trường hợp trong bài đánh giá vượt phạm vi, nơi Sol khi không có lớp bảo vệ đã làm vậy ở 48% trường hợp. Cũng chính tài liệu đó báo cáo rằng phần suy luận viết ra của Astra khó giám sát hơn của Sol; OpenAI quy nguyên nhân cho chuỗi suy luận ngắn hơn và nói họ xem chuyện này là nghiêm túc. Cả hai đều thuộc về cùng một đoạn văn.
Bốn điều chúng tôi không xác minh được, và ghi rõ như vậy
Việc đưa tin quanh bản phát hành này ở vài chỗ đã chạy trước bằng chứng.
Một số bài viết thứ cấp khẳng định Astra thụt lùi ở GDPval, ở sử dụng công cụ ngành ngân hàng, ở suy luận trên tài liệu dài và ở chất lượng bản trình bày trong các bài kiểm tra tác tử dài hơi. Chúng tôi đã kiểm tra: GDPval không hề xuất hiện ở bất kỳ đâu trong bản công bố của OpenAI, và chúng tôi không tìm được con số GDPval nào do OpenAI công bố cho Astra, cũng không có lượt chạy độc lập hoàn tất nào để đối chiếu. Bản thân sự vắng mặt đã đáng chú ý — GDPval chính là benchmark xây quanh công việc có giá trị kinh tế trên nhiều ngành nghề. Nhưng "thiếu" và "thụt lùi" là hai kết luận khác nhau, và chỉ kết luận thứ nhất được xác lập.
Khẳng định rằng Astra phát hiện hai lỗ hổng zero-day chưa từng được biết đến trong quá trình đánh giá nội bộ nằm trong bản công bố của OpenAI, kèm cam kết báo cho các đơn vị bảo trì. Nó chưa được xác nhận độc lập và các lỗ hổng chưa được nêu danh.
"GPT-6 Astra Pro" được nhắc tới cho các gói Pro, Business và Enterprise nhưng tính đến ngày 5/9/2026 chưa có giá riêng, benchmark hay model card nào được công bố. Ngoài OpenAI, không ai biết nó là gì.
Benchmark ảo giác nội bộ cho thấy 4,2% với Astra so với 12,2% với Sol đúng nghĩa là một benchmark nội bộ. OpenAI mô tả cách xây dựng nó — các cuộc trò chuyện ChatGPT đã ẩn danh mà người dùng đánh dấu là chứa lỗi dữ kiện — và nói thẳng rằng con số tuyệt đối bị đẩy cao do thiết kế, không nên đọc như tỷ lệ ảo giác trong môi trường thực tế. Chiều hướng thì đáng tin; con số thì không mang đi chỗ khác được.
Mô hình tiên phong vẫn chưa nghe được
Đây là chi tiết đặt lại khung ý nghĩa của bản phát hành cho bất kỳ ai có công việc đến dưới dạng lời nói chứ không phải văn bản.
Phương thức đầu vào của GPT-6 Astra là văn bản và hình ảnh. Phương thức đầu ra là văn bản. Mô hình mạnh nhất OpenAI từng phát hành — cửa sổ một triệu token, nhanh hơn 47% khi điều khiển máy tính để bàn, truy hồi 96,3% ở đầu xa của ngữ cảnh — không có tai.
Đó không phải sơ suất mà là kiến trúc. Mô hình suy luận tiên phong và mô hình giọng nói là hai dòng sản phẩm tách biệt, và công việc âm thanh vẫn phải đi qua một bước chuyển lời nói thành văn bản trước khi mô hình suy luận nhìn thấy bất cứ thứ gì. Nghĩa là chất lượng của mọi thứ Astra có thể làm với một cuộc trò chuyện đều bị chặn trần ở phía thượng nguồn, bởi cái đã biến cuộc trò chuyện đó thành token. Nếu bản ghi gộp hai người nói làm một, hay đánh rơi đoạn tiếng Thái trong một cuộc họp song ngữ, hay mất chín mươi giây lúc đường truyền chập chờn, thì cửa sổ ngữ cảnh một triệu token chỉ là một cái thùng rất lớn đựng một đầu vào lỗi.
Đây là tầng mà các bản phát hành mô hình không bao giờ sửa, và cũng là tầng được để ý ít dần đi sau mỗi mô hình chủ lực mới. Tầng suy luận vẫn tốt lên với tốc độ vẽ được thành đồ thị. Tầng thu nhận — ghi trọn một giờ mà không rớt, tách được người nói, chịu được cuộc họp đổi ngôn ngữ giữa câu — lại cải thiện trên một đường cong hoàn toàn khác và thoải hơn nhiều, và không lượng trí tuệ tiên phong nào ở hạ nguồn bù được cho một bản ghi tệ ở thượng nguồn.
Kết luận: biên giới mọc thêm một cánh tay, không phải một cái đầu
GPT-6 Astra là một bản phát hành cánh tay dài. Nó vươn xa hơn hẳn vào một số loại công việc — vận hành terminal, điều khiển máy tính để bàn, truy hồi ở đầu xa của một triệu token, dịch ngược một tệp nhị phân — trong khi thứ mà ta thường gọi là trí thông minh gần như đứng yên trên mọi thước đo trung lập hiện có, kể cả thước đo do chính OpenAI in ra.
Đó không phải điều đáng thất vọng. Thậm chí đây là hình dạng hữu ích hơn so với chiều ngược lại, vì năng lực hẹp đi vào sản xuất nhanh hơn năng lực tổng quát rất nhiều. Nhưng điều đó có nghĩa câu hỏi khi mua đã đổi. "Nó có thông minh hơn không?" giờ có một câu trả lời gần như vô nghĩa. "Nó có làm tốt hơn đúng cái vòng lặp tôi chạy bốn mươi lần mỗi ngày không, và vòng lặp đó giờ mất bao lâu?" thì có câu trả lời rất tốt.
Hãy nhìn benchmark giống với công việc của bạn. Bỏ qua chỉ số tổng hợp. Và hãy nhìn đồng hồ, chứ không chỉ nhìn điểm.
Telli.sh đứng ở đâu: khoảng trống mà bản phát hành này làm lộ ra — khả năng suy luận xuất sắc đặt trên bất kỳ thứ gì tầng thu nhận đưa lên — chính là khoảng trống chúng tôi đang xây. Telli.sh ghi lại cuộc họp, tách người nói, dịch trực tiếp sang 15 ngôn ngữ, và để lại ghi chú mà quý sau bạn vẫn tìm kiếm được. Nó định tuyến việc chuyển lời nói thành văn bản, dịch và tóm tắt qua một tầng engine có thể thay thế, nên một bản phát hành như Astra đến với bạn dưới dạng ghi chú tốt hơn chứ không phải một dự án di trú. Không bản công bố mô hình tiên phong nào thay đổi được cái phần mà ai đó phải thu lại trọn một giờ đó trước đã.
Bắt đầu ghi chú dịch trực tiếp
Nguồn
- OpenAI, "GPT-6 Astra: A new generation of intelligence", 3/9/2026 — toàn bộ bảng benchmark (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), mô phỏng độ trễ OSWorld, con số 1,9× trên Mind2Web, các chú thích 1, 3, 4, 8, 9, 10, 11 và 12, phạm vi phát hành và các kết quả về khoảng cách số nguyên tố; truy cập ngày 5/9/2026
- Tài liệu nhà phát triển OpenAI, trang mô hình
gpt-6-astra— cửa sổ ngữ cảnh, đầu ra tối đa, mốc dữ liệu, phương thức đầu vào/ra, các mứcreasoning.effortvà giá tiêu chuẩn, giá bộ nhớ đệm, giá ghi vào bộ nhớ đệm; truy cập ngày 5/9/2026 - Tài liệu nhà phát triển OpenAI, hướng dẫn chuyển đổi và viết prompt "Using GPT-6 Astra" — yêu cầu Responses API khi gọi công cụ, các tham số sampling đã gỡ bỏ, lưu ý về chế độ Fast; truy cập ngày 5/9/2026
- System card GPT-6 Astra, OpenAI Deployment Safety Hub — ngưỡng Critical về an ninh mạng trong Preparedness Framework, mức High về sinh học và hóa học, dưới mức High về tự cải thiện AI, độ bền trước jailbreak, bài đánh giá tính xác thực cùng các giới hạn được nêu rõ, và mức suy giảm khả năng giám sát chuỗi suy luận; truy cập ngày 5/9/2026
- Artificial Analysis, phân tích trí tuệ, hiệu năng và giá của GPT-6 Astra — điểm Intelligence Index v4.2, chi phí mỗi tác vụ Intelligence Index, tốc độ đầu ra 87,5 token mỗi giây và thời gian tới token đầu tiên 463,7 giây; truy cập ngày 5/9/2026
- Vellum, "GPT-6 Astra Benchmarks Explained" — đối chiếu các bảng về điều khiển máy tính, học thuật và ngữ cảnh dài, cùng dấu sao ở Humanity's Last Exam
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — lưu ý về khung chạy ARC-AGI-3 và phần so sánh trên Intelligence Index
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — nguồn của các báo cáo về thụt lùi ở GDPval, sử dụng công cụ ngân hàng, ngữ cảnh dài và chất lượng bản trình bày mà chúng tôi không xác minh được từ nguồn gốc
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4/9/2026 — thời điểm phát hành và lộ trình triển khai theo giai đoạn
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4/9/2026 — thứ tự mở quyền theo từng gói sau ngày ra mắt
- Bài bình luận của chúng tôi về bản phát hành ẩn danh GLM-5.3-Flash — đầu bên kia của cùng đường cong, nơi năng lực đến với giá rẻ thay vì giá đắt