40 นาทีแทนที่จะเป็น 75: GPT-6 Astra เก่งจริงเรื่องอะไร
OpenAI ปล่อย GPT-6 Astra เมื่อวันที่ 3 กันยายน 2026 และเรียกมันว่าโมเดลที่ฉลาดที่สุดในโลก แต่ตารางเบนช์มาร์กของ OpenAI เองเล่าเรื่องที่คมกว่านั้น คือกระโดดมหาศาลในงานเฉพาะทาง (Terminal-Bench Science จาก 22.4% เป็น 64.6%, SRE-Bench จาก 55.9% เป็น 88.0%, OSWorld ใช้เวลาต่องานลดลง 47%) แต่ดัชนีรวมที่เป็นกลางขยับแค่สามในสิบคะแนน บทความนี้แยกว่าตรงไหนคือของจริง ตรงไหนมีเชิงอรรถ และอะไรที่โมเดลข้อความหนึ่งล้านโทเคนยังทำไม่ได้
วันที่ 3 กันยายน 2026 OpenAI ปล่อย GPT-6 Astra และเรียกมันว่า "โมเดลที่ฉลาดที่สุดและสอดคล้องกับเจตนามนุษย์ที่สุดในโลก"
แต่ถัดลงมาสี่แถวในตารางเบนช์มาร์กของ OpenAI เองคือ Artificial Analysis Intelligence Index v4.1.1: Astra 61.2, GPT-5.6 Sol 60.9, Claude Fable 5.1 65.7 นั่นคือ OpenAI พิมพ์ตัวเลขที่เรือธงรุ่นใหม่ของตัวเองชนะรุ่นก่อนหน้าเพียงสามในสิบคะแนน และแพ้คู่แข่งอยู่ 4.5 คะแนน ด้วยมือตัวเอง
ทั้งสองอย่างเป็นความจริง และความตึงระหว่างสองอย่างนี้คือเนื้อเรื่องทั้งหมด นี่ไม่ใช่โมเดลที่ฉลาดขึ้นในภาพรวม แต่เป็นโมเดลที่เก่งขึ้นอย่างมหาศาลในรายการงานเฉพาะชุดหนึ่ง และรายการนั้นควรรู้ให้แม่น เพราะมันไม่ตรงกับบทสรุปทางการตลาดทั้งสองทิศทาง
สรุปสั้น:
- การพัฒนาในด้านเฉพาะทางนั้นมหาศาลและตรวจสอบได้จากต้นทาง Terminal-Bench Science จาก 22.4% เป็น 64.6%, SRE-Bench ในความพยายามครั้งแรกจาก 55.9% เป็น 88.0%, ScreenSpot-Pro จาก 76.9% เป็น 92.7%, การค้นคืน MRCR แบบ 8 เข็มในช่วง 512K–1M จาก 73.8% เป็น 96.3% ทั้งหมดเทียบกับ GPT-5.6 Sol และทั้งหมดมาจากตารางที่ OpenAI เผยแพร่เอง
- การเพิ่มความเร็วอาจสำคัญกว่าคะแนนใด ๆ บน OSWorld 2.0 Astra ได้ 72.6% ในเวลาราว 40 นาทีต่องาน เทียบกับ 65.7% ในราว 75 นาทีของ Sol หรือลดเวลาลงราว 47%
- ดัชนีรวมแทบไม่ขยับ บนดัชนีข้ามผู้ให้บริการเพียงตัวเดียวที่ OpenAI พิมพ์เอง Astra สูงกว่า Sol อยู่ 0.3 และต่ำกว่า Claude Fable 5.1 อยู่ 4.5 ทั้งยังแพ้ในแถวงานวิชาการแถวเดียวที่รายงานเทียบกับ Claude ทั้งสามรุ่น นั่นคือ Humanity's Last Exam แบบมีเครื่องมือ 57.2% ต่อ 65.0%
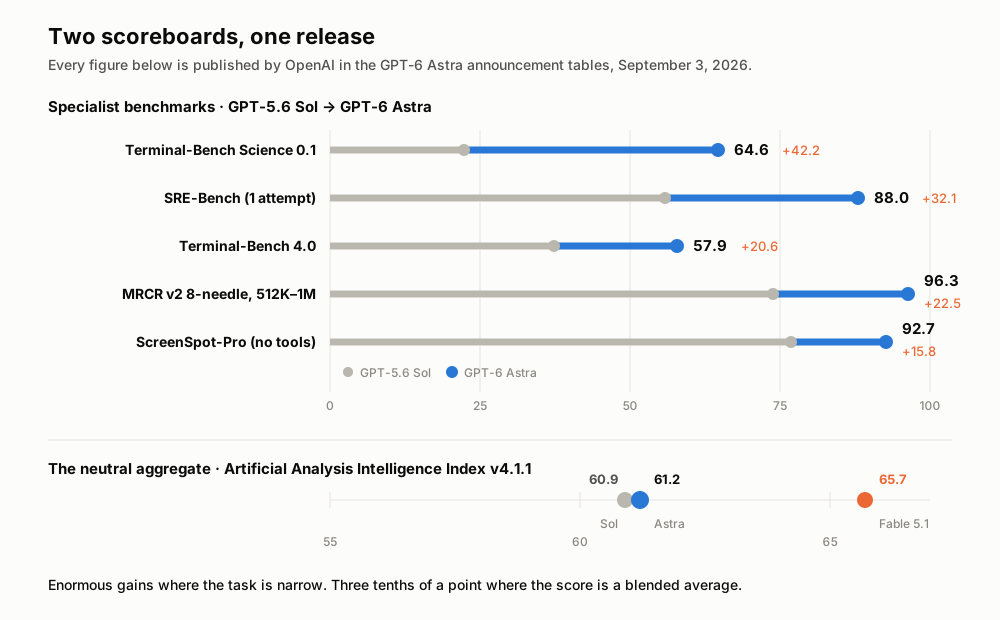
ตัวเลขทุกตัวมาจากตารางประกาศของ OpenAI เอง แหล่งอ้างอิงอยู่ท้ายบทความ
สเปกที่ตัดคำคุณศัพท์ออกแล้ว
ก่อนเข้าสู่ข้อถกเถียง นี่คือข้อเท็จจริงที่ตรวจสอบได้เอง ข้อมูลมาจากหน้าโมเดล gpt-6-astra ในเอกสารสำหรับนักพัฒนาของ OpenAI ดึงข้อมูลวันที่ 5 กันยายน 2026
| GPT-6 Astra | |
|---|---|
| รหัสโมเดลใน API | gpt-6-astra |
| วันเปิดตัว | 3 กันยายน 2026 |
| หน้าต่างบริบท | 1,050,000 โทเคน |
| เอาต์พุตสูงสุด | 128,000 โทเคน |
| จุดตัดความรู้ | 30 เมษายน 2026 |
| รูปแบบอินพุต | ข้อความ, ภาพ |
| รูปแบบเอาต์พุต | ข้อความ |
| ระดับการใช้เหตุผล | low, medium, high, xhigh, max |
| ราคาต่อล้านโทเคนอินพุต | 10.00 ดอลลาร์ |
| ราคาต่อล้านโทเคนอินพุตจากแคช | 1.00 ดอลลาร์ |
| ราคาต่อล้านโทเคนเอาต์พุต | 50.00 ดอลลาร์ |
| ช่องทางใช้งาน | ChatGPT Plus, Pro, Business, Enterprise; OpenAI API; Microsoft Azure; AWS Bedrock |
มีสามรายละเอียดในตารางนี้ที่รายงานส่วนใหญ่ข้ามไป และไม่ควรข้าม
คำขอที่มีอินพุตเกิน 272,000 โทเคนจะถูกคิดเงินสองเท่าของอัตราอินพุตและแคช และ 1.5 เท่าของอัตราเอาต์พุต โดยคิดทั้งคำขอ นั่นแปลว่าหน้าต่างหนึ่งล้านโทเคนมีหน้าผาอยู่ตรงกลาง ไม่ใช่อัตราเดียวตลอด การประมวลผลแบบ Batch และ Flex อยู่ที่ 50% ของอัตรามาตรฐาน ส่วนโหมด Fast คิดสองเท่าเพื่อความเร็วสูงสุดสองเท่า และไม่มี SLA ด้านความหน่วง
การเรียกใช้เครื่องมือต้องใช้ Responses API ส่วน Chat Completions ยังใช้สร้างข้อความธรรมดาได้ แต่ temperature, top_p และ top_logprobs หายไปทั้งหมด ถ้าคุณกำลังย้ายไปป์ไลน์ที่ปรับค่าการสุ่ม การปรับนั้นไม่มีอยู่แล้ว
และ Astra รับข้อความกับภาพเข้าไป แล้วส่งข้อความออกมา มันไม่ได้ยิน เดี๋ยวเราจะกลับมาที่จุดนี้
พาดหัวจริงคือการใช้คอมพิวเตอร์ และตัวเลขจริงคือนาฬิกา
OpenAI วางกรอบว่า Astra "สร้างพรมแดนใหม่ในการใช้คอมพิวเตอร์และเบราว์เซอร์" ตรงจุดนี้หลักฐานรับน้ำหนักคำคุณศัพท์ไหว
บน OSWorld 2.0 ซึ่งวัดงานบนเดสก์ท็อปอย่างการเปิดใช้แอป ย้ายไฟล์ กรอกแบบฟอร์ม Astra ได้ 72.6% เทียบกับ 65.7% ของ Sol ห่างกัน 6.9 คะแนน ถือว่าดี แต่ตัวเลขที่น่าสนใจอยู่ข้าง ๆ ในการจำลองความหน่วงของ OpenAI Astra ทำงานเฉลี่ยเสร็จในราว 40 นาที ขณะที่ Sol ใช้ราว 75 นาที ลดลงราว 47%
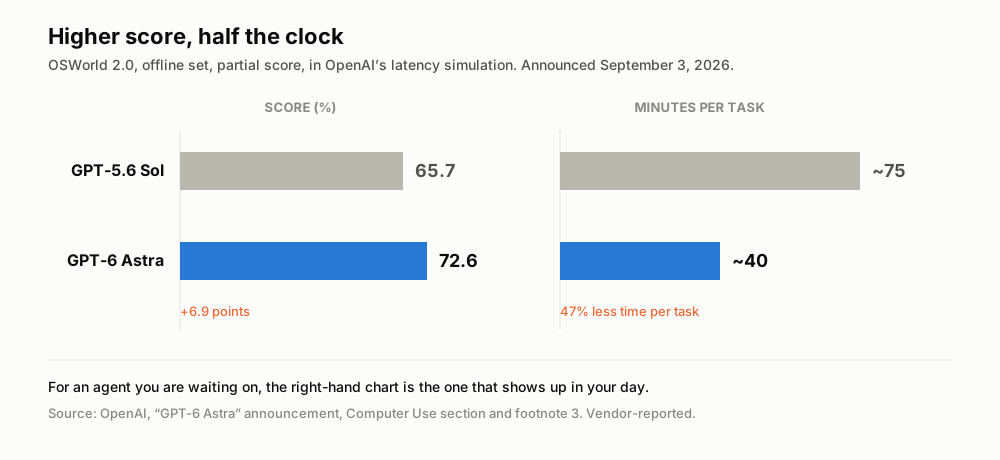
คะแนนอยู่ซ้าย เวลาจริงอยู่ขวา ที่มา: ประกาศ GPT-6 Astra ของ OpenAI ส่วน Computer Use
ประเด็นอยู่ตรงนี้ สำหรับโมเดลที่คุณมอบงานให้แล้วนั่งรอ เวลาต่องานคือตัวชี้วัดที่โผล่มาในตารางงานและในบิลของคุณจริง ๆ ความแม่นยำที่เพิ่มขึ้นเจ็ดคะแนนคือผลการประเมิน แต่เวลารอที่หายไปครึ่งหนึ่งคือผลิตภัณฑ์คนละตัว
ส่วนที่เหลือของบล็อกนี้ก็สอดคล้องกัน ScreenSpot-Pro ซึ่งวัดว่าโมเดลหาและคลิกพิกเซลที่ถูกต้องในอินเทอร์เฟซที่หนาแน่นได้หรือไม่ เพิ่มจาก 76.9% เป็น 92.7% โดยไม่ใช้เครื่องมือ ส่วน Agents' Last Exam ซึ่งเป็นงานวิชาชีพซับซ้อนในซอฟต์แวร์จริง ตั้งแต่การสร้างแบบจำลองทางการเงินไปจนถึงงานผลิตสื่อ ได้ 59.3% เทียบกับ 55.5% ของ Claude Opus 5 และ 53.6% ของ Sol โดย OpenAI ระบุว่า Astra ใช้โทเคนเอาต์พุตน้อยกว่า Opus 5 ราว 65% ในการทำคะแนนนั้น ส่วนบนเบนช์มาร์กเบราว์เซอร์ Mind2Web เมื่อใช้ร่วมกับ Codex harness เวอร์ชันอัปเดต OpenAI รายงานว่าทำงานเสร็จเร็วกว่าการตั้งค่า Sol ปัจจุบัน 1.9 เท่า
ถ้าอ่านให้ละเอียด ตัวเลขสุดท้ายเป็นข้อกล่าวอ้างเกี่ยวกับระบบ ไม่ใช่ตัวโมเดล คือ harness บวกโมเดล แต่มันก็ยังเป็นตัวเลขที่ผู้ใช้สัมผัสได้จริง จึงควรทั้งอ้างอิงและติดป้ายกำกับไว้
เดโมแสดงอะไรจริง ๆ
คราวนี้ OpenAI เผยแพร่คลิปบันทึกหน้าจอแทนภาพนิ่ง และมันคือหลักฐานที่ชัดที่สุดในการเปิดตัวครั้งนี้ว่า "การใช้คอมพิวเตอร์" หมายถึงอะไรในตอนนี้ เราไม่ได้นำมาโฮสต์ซ้ำ คลิปเล่นได้ที่หน้าประกาศของ OpenAI โดยเชิงอรรถที่ 4 ของ OpenAI เองระบุว่าคลิปที่แสดงเป็นข้อความตัดต่อ พร้อมเวลาที่บันทึกได้จากการสาธิตแต่ละครั้ง ซึ่งเป็นข้อสงวนที่ควรถือติดตัวไว้ตอนดู
สี่คลิปที่คุ้มค่าเวลา:
- การวางลายวงจร PCB ใน KiCad — คลิปย่อความยาว 15 วินาทีที่ Astra แปลงผังวงจรอิเล็กทรอนิกส์เป็นแผ่นวงจรที่ผลิตได้จริง ด้วยการวางชิ้นส่วนและเดินลายทองแดง งานวางลายปกติเป็นงานมือและเป็นคอขวดคลาสสิกในการออกแบบอิเล็กทรอนิกส์
- จาก Blender ไป Unreal Engine 5 — สร้างโมเดลบ้านแล้วแปลงเป็นฉากที่เดินเข้าไปได้ ซึ่งเป็นการส่งต่องานที่ปกติกินเวลานักออกแบบทั้งวัน
- สไลด์ที่สร้างจากเทมเพลต — ให้ Astra ดูสไลด์ไม่กี่แผ่นจากเทมเพลตงานนำเสนอของ OpenAI แล้วให้ทำชุดสไลด์เกี่ยวกับโมเดลสมมติ โดยรักษาโทนและเลย์เอาต์ให้ตรง เป็นเดโมที่เกี่ยวข้องกับงานออฟฟิศมากที่สุดและหวือหวาน้อยที่สุด
- การใช้ซอฟต์แวร์จีโนมิกส์ — ตรวจคุณภาพการหาลำดับพันธุกรรมและสร้างภาพความผันแปรทางพันธุกรรมภายในเครื่องมือวิทยาศาสตร์เฉพาะทาง
OpenAI ยังเผยแพร่ภาพเปรียบเทียบนิ่งอีกหนึ่งภาพ ซึ่งแสดงการเปลี่ยนแปลงเชิงพฤติกรรมมากกว่าคะแนน คือเมื่อคำสั่งเปิดช่องให้ตีความได้ Astra จะถามคำถามที่ตรงจุดแทนที่จะเดา
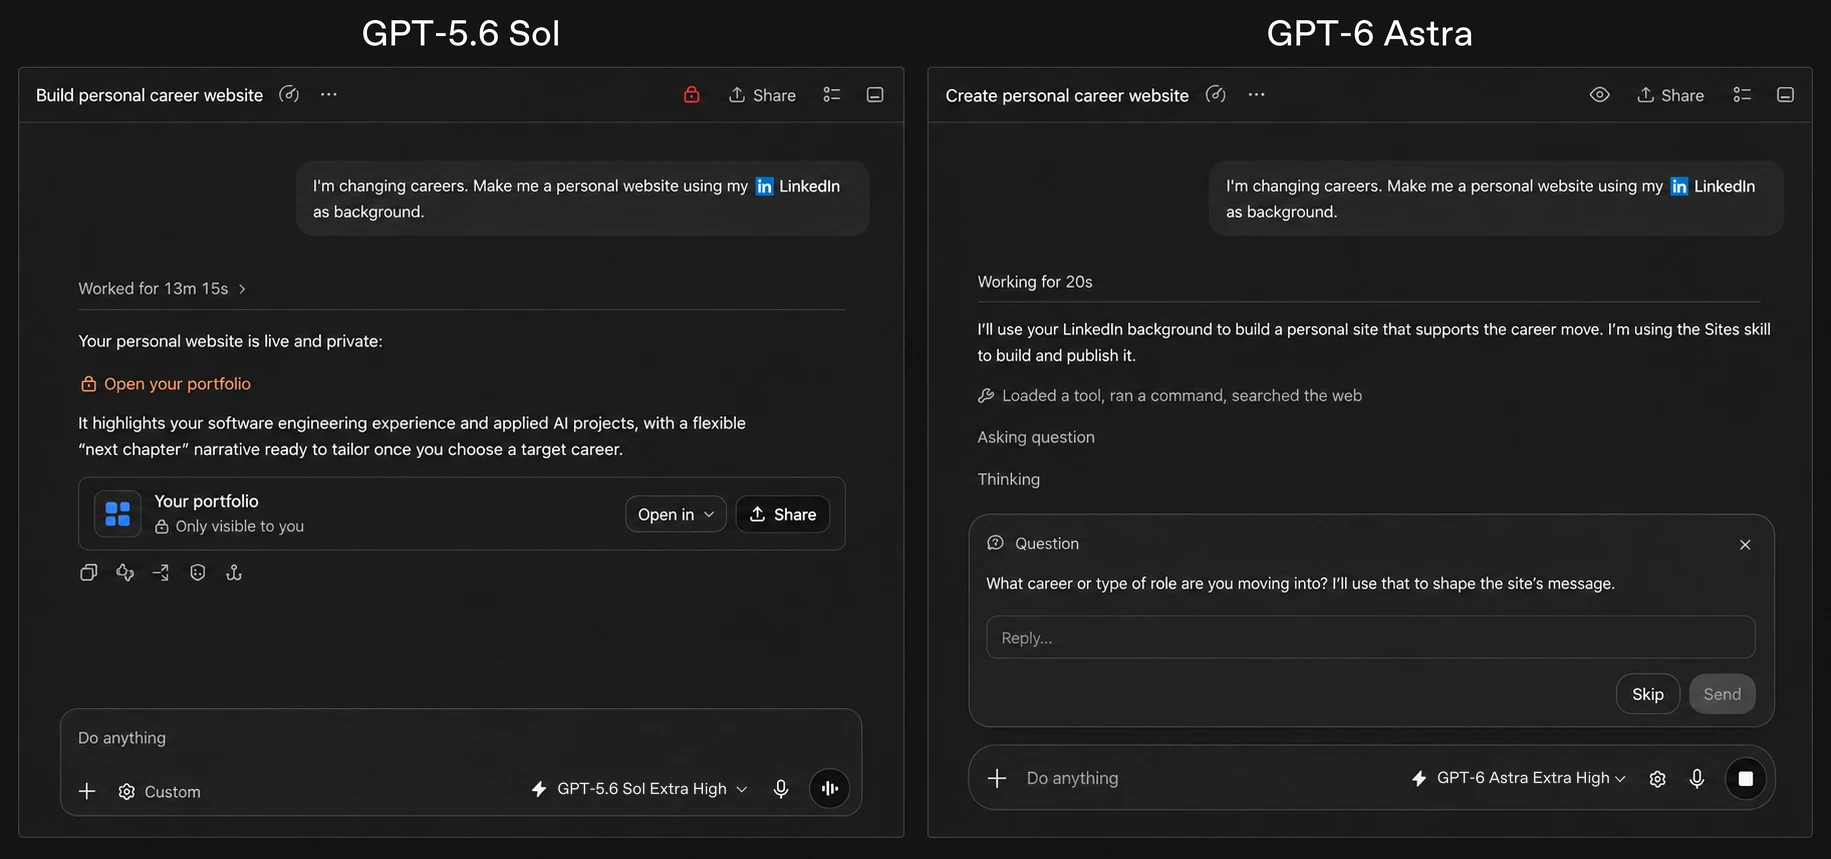
เครดิตภาพ: OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 กันยายน 2026 พฤติกรรมที่ภาพนี้แสดง คือถามเมื่อคำตอบจะเปลี่ยนผลลัพธ์ และเดินหน้าต่อเมื่อไม่เปลี่ยน เป็นการสาธิตของผู้ผลิต ไม่ใช่ผลวัดจากเบนช์มาร์กอิสระ
ปลายไกลของหน้าต่างบริบทเลิกพังทลายแล้ว
นี่คือผลลัพธ์ที่ถูกพูดถึงน้อยที่สุดในการเปิดตัวครั้งนี้ และสำหรับใครก็ตามที่ทำงานกับเอกสารยาว มันน่าจะสำคัญที่สุด
การตลาดเรื่องบริบทยาวไม่น่าเชื่อถือมาสามปีแล้ว เพราะหน้าต่างที่โฆษณากับหน้าต่างที่ใช้ได้จริงเป็นคนละตัวเลข โมเดลรับหนึ่งล้านโทเคนแล้วค้นคืนได้แย่เมื่อเกินไม่กี่แสนโทเคน แต่ Astra ไม่ได้ขยายหน้าต่างเลยแม้แต่นิดเดียว บริบทของ GPT-5.6 Sol ก็คือ 1,050,000 โทเคนเท่ากัน สิ่งที่เปลี่ยนคือสิ่งที่เกิดขึ้นที่ปลายของมัน
ในการทดสอบ MRCR v2 แบบ 8 เข็มของ OpenAI Astra ได้ 100.0% ในช่วง 256K–512K เทียบกับ 91.5% ของ Sol และรักษาไว้ที่ 96.3% ในช่วง 512K–1M ซึ่ง Sol ร่วงลงเหลือ 73.8% ช่องว่าง 22.5 คะแนนที่ปลายบนของหน้าต่างคือเส้นแบ่งระหว่างสเปกกับฟีเจอร์
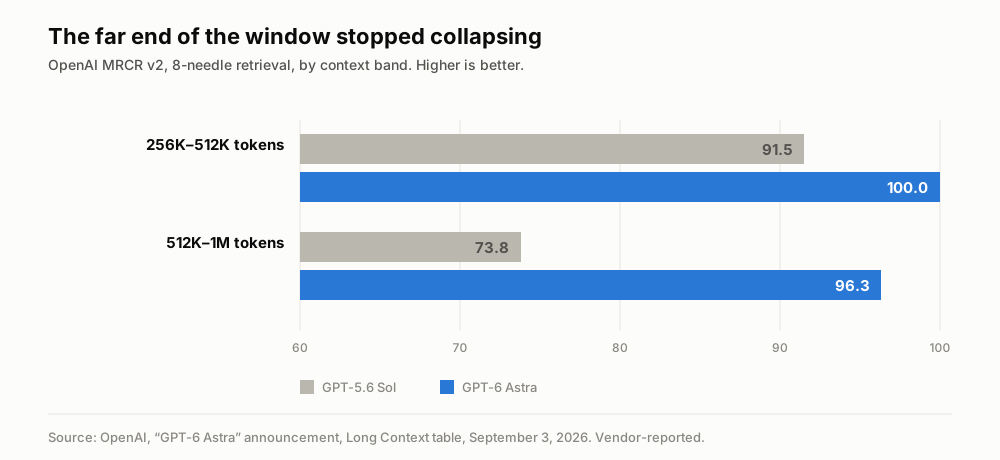
ตัวเลขที่ผู้ผลิตรายงานเอง จากตาราง Long Context ของ OpenAI ข้อสงวนคือ MRCR เป็นเบนช์มาร์กของ OpenAI เอง
ควบคู่กันไป Codex ได้กลไกทดลองที่ให้ Astra เก็บบันทึกข้ามหน้าต่างบริบท แทนที่จะบีบเซสชันยาวให้เหลือบทสรุปเดียวที่สูญเสียรายละเอียด และหน้าต่างก่อนหน้ายังค้นหาได้อยู่ OpenAI บอกว่าอีกไม่กี่สัปดาห์สิ่งนี้จะกลายเป็นค่าเริ่มต้นของ Astra การสูญเสียจากการบีบอัด เช่นลืมไปแล้วว่าทำไมการแก้เมื่อสามชั่วโมงก่อนถึงล้มเหลว เป็นรูปแบบความล้มเหลวที่พบบ่อยที่สุดในเซสชันเอเจนต์ยาว ๆ ดังนั้นนี่คือการแก้ที่เล็งตรงปัญหาจริง
การพัฒนาที่ก้าวกระโดดที่สุดในรอบนี้มาจากเทอร์มินัลและงานวิทยาศาสตร์
ถ้าเรียงการเปรียบเทียบทั้งหมดที่เผยแพร่เทียบกับ GPT-5.6 Sol ตามขนาดการกระโดด อันดับต้น ๆ ไม่ใช่คณิตศาสตร์ และไม่ใช่การเขียนโค้ดโดยรวม แต่คือเอเจนต์ที่ใช้งานเทอร์มินัล
| เบนช์มาร์ก | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22.4% | 64.6% | 52.6% |
| SRE-Bench (ลองครั้งเดียว) | 55.9% | 88.0% | – |
| Terminal-Bench 4.0 | 37.3% | 57.9% | 55.8% |
| AutomationBench | 18.1% | 41.4% | 31.4% |
| งานย้ายฐานข้อมูลภายใน | 42.7% | 63.9% | 57.8% |
| FrontierMath Tier 4 (v2) | 83.0% | 97.6% | 87.8% |
| GPQA Diamond | 94.6% | 96.0% | 93.7% |
| Humanity's Last Exam (มีเครื่องมือ) | – | 57.2% | 65.0% |
Terminal-Bench Science เพิ่มขึ้นเกือบสามเท่า ส่วน SRE-Bench ซึ่งคือการวิศวกรรมย้อนกลับไฟล์ไบนารีที่คอมไพล์แล้วโดยไม่มีซอร์สโค้ด ขยับจาก 55.9% เป็น 88.0% ในความพยายามครั้งแรก และถึง 99.2% ภายในสี่ครั้ง AutomationBench เพิ่มขึ้นกว่าสองเท่า นี่ไม่ใช่การปรับปรุงระดับความคลาดเคลื่อนจากการปัดเศษ และทั้งหมดกระจุกตัวแน่นรอบคำอธิบายเดียว คือเอเจนต์ที่ใช้งานเครื่องมือต่อเนื่องหลายขั้นโดยไม่หลุดเส้นเรื่อง
ด้านคณิตศาสตร์ OpenAI รายงานผลลัพธ์ใหม่สองชิ้นเกี่ยวกับช่องว่างระหว่างจำนวนเฉพาะ พร้อมบทพิสูจน์เผยแพร่เป็น PDF Astra ช่วยพิสูจน์ว่ามีคู่จำนวนเฉพาะจำนวนอนันต์ที่ห่างกันไม่เกิน 186 ซึ่งปรับปรุงขอบเขต 240 ที่ Julia Stadlmann เพิ่งตั้งไว้ และตัวเลข 240 นั้นเองก็ปรับปรุงจาก 246 ที่ยืนมากว่าทศวรรษ ส่วนผลลัพธ์ที่สองปรับปรุงพจน์หนึ่งในขอบเขตเรื่องช่องว่างขนาดใหญ่ระหว่างจำนวนเฉพาะ ซึ่งไม่เปลี่ยนแปลงมากว่า 80 ปี ทั้งสองเป็นผลงานที่ตรวจสอบได้จริง ไม่ใช่แถวในตาราง จึงเป็นข้อกล่าวอ้างที่ทนทานที่สุดในประกาศทั้งฉบับ
จุดที่การตลาดวิ่งนำหลักฐาน
ตอนนี้ขอเปลี่ยนจากการวัดไปสู่การตัดสิน ความเห็นของเราคือ นี่เป็นการเปิดตัวสำคัญที่ถูกอธิบายด้วยคำศัพท์ผิดชุด และหลักฐานที่ค้านกรอบของตัวเองนั้น OpenAI เป็นผู้จัดหามาเอง
ดัชนีรวมที่เป็นกลางนั้นแบนราบ Artificial Analysis Intelligence Index v4.1.1 ที่พิมพ์อยู่ในตาราง Professional ของ OpenAI เอง: Astra 61.2, Sol 60.9, Fable 5.1 65.7, Opus 5 63.1 ส่วนบน Coding Agent Index v1.4 ซึ่งอยู่ในตารางของ OpenAI เช่นกัน Astra ได้ 67.0 เทียบกับ 68.1 ของ Opus 5 และ 67.2 ของ Fable 5 โมเดลที่เสมอกับรุ่นก่อนหน้าตัวเองบนคะแนนรวมไม่ใช่การก้าวกระโดดข้ามรุ่นของความสามารถทั่วไป ไม่ว่าบทประกาศจะเขียนอย่างไร และตามระเบียบวิธี v4.2 ปัจจุบันของ Artificial Analysis ที่ดึงข้อมูลวันที่ 5 กันยายน 2026 รูปทรงของอันดับก็ไม่เปลี่ยน คือ Fable 5.1 ที่ 56.8, Astra ที่ 54.7, Opus 5 ที่ 54.1
คำว่า "อิ่มตัว" แบกน้ำหนักไว้เยอะมาก ตัวเลข 99.9% บน ARC-AGI-3 เป็นของจริง และเชิงอรรถที่ 1 ของ OpenAI ระบุว่ารันด้วย Responses API harness "ซึ่งเปลี่ยนการตั้งค่าสองอย่างเพื่อให้ใกล้เคียงกับประสิทธิภาพในโลกจริงมากขึ้น" การเรียก API แบบไร้สถานะตามปกติไม่ใช่ harness ตัวนั้น ให้มอง 99.9% เป็นเพดานภายใต้การตั้งค่าที่จูนมาแล้ว ไม่ใช่พฤติกรรมที่ระบบของคุณจะได้
FrontierMath ไม่ใช่กรรมการที่เป็นกลาง Epoch AI ซึ่งดูแลเบนช์มาร์กนี้ได้เปิดเผยว่า OpenAI ให้ทุนพัฒนาและมีสิทธิ์เข้าถึงบางส่วนแต่เพียงผู้เดียว ตัวเลข 97.6% นั้นน่าประทับใจ แต่ไม่ได้เป็นอิสระ
ตัวเลข 100% บน ExploitBench ก็มีเชิงอรรถ หมายเหตุของ OpenAI เองเกี่ยวกับเวอร์ชันที่ปรับปรุงด้วยช่องโหว่ช่วงมิถุนายนถึงสิงหาคม 2026 ระบุว่าช่องโหว่บางรายการที่รวมอยู่อาจไม่เปิดให้รันโค้ดตามอำเภอใจได้ภายใต้ข้อจำกัดของการประเมิน ประโยคนี้ทำให้ความหมายของคะแนนเต็มบนเวอร์ชันดั้งเดิมซับซ้อนขึ้นอย่างเงียบ ๆ
คะแนนพาดหัวทุกตัวคือกรณีดีที่สุด OpenAI ระบุตรง ๆ ว่าคะแนนการประเมินคือค่าสูงสุดจากระดับความพยายามใดก็ได้ ที่ระดับ max Artificial Analysis วัดเวลาถึงโทเคนแรกได้ 463.7 วินาที หรือเกือบแปดนาทีกว่าจะได้คำแรก เทียบกับค่ามัธยฐาน 3.86 วินาทีของโมเดลใช้เหตุผลในช่วงราคาเดียวกัน หลังจากนั้นเอาต์พุตวิ่งที่ 87.5 โทเคนต่อวินาที ซึ่งสูงกว่าค่ามัธยฐานนั้น ตัวเลขพาดหัวกับแอปพลิเคชันที่ตอบสนองไวไม่ใช่การตั้งค่าเดียวกัน
ราคาแพงขึ้น 2.5 เท่า หน้าโมเดลของ GPT-5.6 Sol ระบุ 4.00 ดอลลาร์ต่อล้านโทเคนอินพุตและ 20.00 ดอลลาร์ต่อล้านโทเคนเอาต์พุต ส่วน Astra ระบุ 10.00 และ 50.00 ดอลลาร์ นั่นคือ 2.5 เท่าพอดีทั้งสองฝั่ง และอัตราของ Sol เองก็เป็นราคาโปรโมชัน ประกาศว่ามีผลอย่างน้อยถึงวันที่ 21 พฤศจิกายน 2026 น้ำหนักถ่วงที่ซื่อตรงคือประสิทธิภาพด้านโทเคน Artificial Analysis วัดค่าใช้จ่ายในการรัน Intelligence Index ครบชุดได้ 2.57 ดอลลาร์สำหรับ Astra เทียบกับ 6.12 ดอลลาร์สำหรับ Fable 5.1 และ 4.21 ดอลลาร์สำหรับ Opus 5 Astra แพงกว่าเมื่อคิดต่อโทเคน แต่ถูกกว่าเมื่อคิดต่องานที่ทำเสร็จเมื่อเทียบกับตระกูล Claude เป็นความต่างที่ควรชี้ให้ชัดก่อนที่ใครจะยกราคาป้ายมาเป็นคำตัดสิน
และมันโปร่งใสขึ้นในบางแง่ ลดลงในบางแง่ ระบบการ์ดรายงานว่า Astra ทำผิดพลาดเชิงข้อเท็จจริงน้อยกว่า Sol อย่างมีนัยสำคัญ ไม่เคยพยายามเลี่ยงคำปฏิเสธของ Codex Auto-Review ในการทดสอบภายในเลยแม้แต่ครั้งเดียว และล้ำออกนอกเป้าหมายที่ได้รับอนุญาตที่ 0% ของกรณีในการประเมินการทำเกินขอบเขต ขณะที่ Sol เมื่อไม่มีมาตรการป้องกันทำเช่นนั้นที่ 48% ของกรณี แต่เอกสารฉบับเดียวกันก็รายงานว่าการใช้เหตุผลที่ Astra เขียนออกมานั้นตรวจสอบติดตามได้ยากกว่าของ Sol โดย OpenAI มองว่าเป็นเพราะห่วงโซ่ความคิดสั้นลง และบอกว่าให้ความสำคัญกับเรื่องนี้อย่างจริงจัง ทั้งสองข้อควรอยู่ในย่อหน้าเดียวกัน
สี่เรื่องที่เราตรวจสอบไม่ได้ และขอระบุไว้ตรง ๆ
การรายงานรอบการเปิดตัวนี้วิ่งนำหลักฐานอยู่ในบางจุด
รายงานมือสองบางแห่งอ้างว่า Astra ถอยหลังในเรื่อง GDPval, การใช้เครื่องมือด้านธนาคาร, การให้เหตุผลบนเอกสารยาว และคุณภาพงานนำเสนอในการทดสอบเอเจนต์ระยะยาว เราตรวจสอบแล้ว GDPval ไม่ปรากฏอยู่ที่ใดเลยในประกาศของ OpenAI และเราไม่พบทั้งตัวเลข GDPval ของ Astra ที่ OpenAI เผยแพร่ และผลการรันอิสระที่เสร็จสมบูรณ์ซึ่งจะใช้ตรวจทานข้ออ้างนี้ได้ ตัวการหายไปเองก็น่าสังเกต เพราะ GDPval คือเบนช์มาร์กที่สร้างขึ้นรอบงานที่มีมูลค่าทางเศรษฐกิจในหลายสาขาอาชีพ แต่ "หายไป" กับ "ถอยหลัง" เป็นข้อค้นพบคนละเรื่อง และมีเพียงข้อแรกที่ยืนยันได้
ข้ออ้างที่ว่า Astra ค้นพบช่องโหว่ zero-day ที่ยังไม่เคยมีใครรู้จักสองรายการระหว่างการประเมินภายในนั้นอยู่ในประกาศของ OpenAI พร้อมคำมั่นว่าจะแจ้งผู้ดูแล ยังไม่มีการยืนยันจากภายนอกและยังไม่มีการระบุว่าเป็นช่องโหว่ใด
"GPT-6 Astra Pro" ถูกกล่าวถึงสำหรับแพ็กเกจ Pro, Business และ Enterprise แต่ ณ วันที่ 5 กันยายน 2026 ยังไม่มีการเผยแพร่ราคาแยก เบนช์มาร์ก หรือโมเดลการ์ด นอกวง OpenAI ไม่มีใครรู้ว่ามันคืออะไร
เบนช์มาร์กการหลอนภายในที่แสดง 4.2% สำหรับ Astra เทียบกับ 12.2% สำหรับ Sol เป็นเบนช์มาร์กภายในตามชื่อ OpenAI อธิบายวิธีสร้างไว้ คือใช้บทสนทนา ChatGPT ที่ลบข้อมูลระบุตัวตนแล้ว ซึ่งผู้ใช้ทำเครื่องหมายว่ามีข้อผิดพลาดเชิงข้อเท็จจริง และระบุตรง ๆ ว่าอัตราสัมบูรณ์ถูกทำให้สูงเกินจริงโดยการออกแบบ จึงไม่ควรอ่านเป็นอัตราการหลอนในการใช้งานจริง ทิศทางน่าเชื่อถือ แต่ตัวเลขยกไปใช้ที่อื่นไม่ได้
โมเดลแนวหน้ายังฟังไม่ได้
นี่คือรายละเอียดที่จัดกรอบการเปิดตัวครั้งนี้ใหม่ สำหรับใครก็ตามที่งานมาถึงในรูปของเสียงพูดแทนที่จะเป็นข้อความ
รูปแบบอินพุตของ GPT-6 Astra คือข้อความและภาพ รูปแบบเอาต์พุตคือข้อความ โมเดลที่เก่งที่สุดเท่าที่ OpenAI เคยส่งออกมา ทั้งหน้าต่างหนึ่งล้านโทเคน ทั้งเร็วขึ้น 47% ในการควบคุมเดสก์ท็อป ทั้งค้นคืนได้ 96.3% ที่ปลายบริบท กลับไม่มีหู
นี่ไม่ใช่ความหลงลืม แต่เป็นสถาปัตยกรรม โมเดลใช้เหตุผลแนวหน้ากับโมเดลเสียงพูดเป็นสายผลิตภัณฑ์คนละสาย และงานเสียงยังต้องผ่านขั้นตอนถอดเสียงเป็นข้อความก่อนที่โมเดลใช้เหตุผลจะได้เห็นอะไรเลย นั่นแปลว่าคุณภาพของทุกอย่างที่ Astra ทำกับบทสนทนาได้นั้นถูกจำกัดเพดานไว้ที่ต้นน้ำ โดยสิ่งที่แปลงบทสนทนานั้นให้เป็นโทเคน ถ้าการถอดเสียงรวมผู้พูดสองคนเข้าด้วยกัน หรือทำช่วงภาษาไทยในการประชุมสองภาษาหายไป หรือตกไปเก้าสิบวินาทีตอนสัญญาณสะดุด หน้าต่างบริบทหนึ่งล้านโทเคนก็เป็นเพียงภาชนะขนาดใหญ่มากที่บรรจุอินพุตที่บกพร่อง
นี่คือชั้นที่การเปิดตัวโมเดลไม่เคยแก้ให้ และเป็นชั้นที่ได้รับความสนใจน้อยลงทุกครั้งที่มีเรือธงลำใหม่ออกมา ชั้นการใช้เหตุผลดีขึ้นเรื่อย ๆ ด้วยอัตราที่วาดเป็นกราฟได้ ส่วนชั้นการบันทึก ไม่ว่าจะเป็นการอัดหนึ่งชั่วโมงโดยไม่ตกหล่น การแยกผู้พูด หรือการรับมือการประชุมที่เปลี่ยนภาษากลางประโยค กลับดีขึ้นบนเส้นโค้งคนละเส้นที่ลาดกว่ามาก และไม่ว่าปลายน้ำจะมีปัญญาระดับแนวหน้าแค่ไหน ก็ชดเชยการถอดเสียงที่แย่ตั้งแต่ต้นน้ำไม่ได้
บทสรุป: แนวหน้างอกแขนออกมา ไม่ใช่งอกหัว
GPT-6 Astra คือการเปิดตัวแบบแขนยาว มันเอื้อมไปได้ไกลกว่าเดิมมากในงานบางประเภท ทั้งการใช้เทอร์มินัล การควบคุมเดสก์ท็อป การค้นคืนที่ปลายไกลของหนึ่งล้านโทเคน และการวิศวกรรมย้อนกลับไฟล์ไบนารี ในขณะที่สิ่งที่เรามักเรียกว่าความฉลาดแทบไม่ขยับเลยบนทุกมาตรวัดที่เป็นกลางเท่าที่มี รวมถึงมาตรวัดที่ OpenAI พิมพ์ออกมาเอง
นี่ไม่ใช่เรื่องน่าผิดหวัง มันเป็นรูปทรงที่มีประโยชน์กว่าทางเลือกอีกทางเสียด้วยซ้ำ เพราะความสามารถเฉพาะทางเดินทางไปถึงการใช้งานจริงเร็วกว่าความสามารถทั่วไปมาก แต่มันแปลว่าคำถามตอนตัดสินใจซื้อเปลี่ยนไปแล้ว "มันฉลาดขึ้นไหม" ตอนนี้มีคำตอบที่แทบไม่มีความหมาย ส่วน "มันทำลูปที่ผมรันวันละสี่สิบรอบได้ดีขึ้นไหม แล้วตอนนี้ลูปนั้นใช้เวลาเท่าไหร่" มีคำตอบที่ดีมาก
ดูเบนช์มาร์กที่คล้ายกับงานของคุณ มองข้ามคะแนนรวม และดูนาฬิกา ไม่ใช่แค่ดูคะแนน
Telli.sh อยู่ตรงไหน: ช่องว่างที่การเปิดตัวครั้งนี้ทำให้มองเห็น คือการใช้เหตุผลที่ยอดเยี่ยมซึ่งวางอยู่บนสิ่งที่ชั้นการบันทึกส่งมาให้ นั่นคือช่องว่างที่เราสร้างงานอยู่พอดี Telli.sh บันทึกการประชุม แยกผู้พูด แปลสดข้ามภาษา 15 ภาษา และทิ้งไว้เป็นโน้ตที่ไตรมาสหน้าคุณยังค้นเจอ ระบบส่งงานถอดเสียง งานแปล และงานสรุปผ่านชั้นเอนจินที่สลับเปลี่ยนได้ การเปิดตัวอย่าง Astra จึงมาถึงคุณในรูปของโน้ตที่ดีขึ้น ไม่ใช่โครงการย้ายระบบ ไม่มีการเปิดตัวโมเดลแนวหน้าครั้งไหนเปลี่ยนส่วนที่ว่าต้องมีใครสักคนบันทึกชั่วโมงนั้นเอาไว้ให้ได้ก่อน
แหล่งอ้างอิง
- OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 กันยายน 2026 — ตารางเบนช์มาร์กทั้งหมด (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), การจำลองความหน่วง OSWorld, ตัวเลข 1.9 เท่าบน Mind2Web, เชิงอรรถ 1, 3, 4, 8, 9, 10, 11 และ 12, ช่องทางใช้งาน และผลลัพธ์เรื่องช่องว่างจำนวนเฉพาะ ดึงข้อมูลวันที่ 5 กันยายน 2026
- เอกสารนักพัฒนา OpenAI หน้าโมเดล
gpt-6-astra— หน้าต่างบริบท เอาต์พุตสูงสุด จุดตัดความรู้ รูปแบบอินพุตและเอาต์พุต ระดับreasoning.effortและราคามาตรฐาน ราคาแคช และราคาเขียนแคช ดึงข้อมูลวันที่ 5 กันยายน 2026 - เอกสารนักพัฒนา OpenAI คู่มือการย้ายระบบและการเขียนพรอมป์ "Using GPT-6 Astra" — ข้อกำหนดให้ใช้ Responses API สำหรับการเรียกเครื่องมือ พารามิเตอร์การสุ่มที่ถูกถอดออก และข้อสงวนของโหมด Fast ดึงข้อมูลวันที่ 5 กันยายน 2026
- ระบบการ์ด GPT-6 Astra, OpenAI Deployment Safety Hub — เกณฑ์ Critical ด้านความมั่นคงไซเบอร์ใน Preparedness Framework, ระดับ High ด้านชีวภาพและเคมี, ต่ำกว่า High ด้านการพัฒนาตนเองของ AI, ความทนทานต่อการเจลเบรก, การประเมินความถูกต้องเชิงข้อเท็จจริงพร้อมข้อจำกัดที่ระบุไว้ และการลดลงของความสามารถในการตรวจสอบห่วงโซ่ความคิด ดึงข้อมูลวันที่ 5 กันยายน 2026
- Artificial Analysis, การวิเคราะห์ความฉลาด ประสิทธิภาพ และราคาของ GPT-6 Astra — คะแนน Intelligence Index v4.2, ค่าใช้จ่ายต่องานของ Intelligence Index, ความเร็วเอาต์พุต 87.5 โทเคนต่อวินาที และเวลาถึงโทเคนแรก 463.7 วินาที ดึงข้อมูลวันที่ 5 กันยายน 2026
- Vellum, "GPT-6 Astra Benchmarks Explained" — การตรวจทานไขว้ตารางด้านการใช้คอมพิวเตอร์ ด้านวิชาการ และด้านบริบทยาว รวมถึงข้อสงวนเรื่อง Humanity's Last Exam
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — ข้อสงวนเรื่อง harness ของ ARC-AGI-3 และการเปรียบเทียบบน Intelligence Index
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — แหล่งที่มาของรายงานเรื่องการถอยหลังใน GDPval, การใช้เครื่องมือด้านธนาคาร, บริบทยาว และคุณภาพงานนำเสนอ ซึ่งเราตรวจสอบจากแหล่งต้นทางไม่ได้
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4 กันยายน 2026 — ช่วงเวลาเปิดตัวและการทยอยปล่อยเป็นระยะ
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4 กันยายน 2026 — ลำดับการเปิดให้ใช้ตามแพ็กเกจหลังวันเปิดตัว
- บทวิเคราะห์ของเราเรื่องการปล่อย GLM-5.3-Flash แบบไม่เปิดชื่อ — ปลายอีกด้านของเส้นโค้งเดียวกัน ที่ความสามารถมาถึงในราคาถูกแทนที่จะแพง