40 minit dan bukan 75: apa yang GPT-6 Astra benar-benar kuasai
OpenAI melancarkan GPT-6 Astra pada 3 September 2026 dan menggelarnya model paling pintar di dunia. Jadual penanda aras mereka sendiri menceritakan kisah yang lebih tajam: lonjakan besar pada tugasan sempit — Terminal-Bench Science daripada 22.4% kepada 64.6%, SRE-Bench daripada 55.9% kepada 88.0%, OSWorld dengan masa setiap tugasan 47% lebih singkat — bertumpu pada indeks umum neutral yang bergerak tiga persepuluh mata sahaja. Di mana peningkatannya benar, di mana tanda bintangnya, dan apa yang model teks sejuta token masih tidak mampu lakukan.
Pada 3 September 2026, OpenAI melancarkan GPT-6 Astra dan menggelarnya "model paling pintar dan paling terjajar di dunia".
Empat baris di bawahnya, dalam jadual penanda aras mereka sendiri, terletak Artificial Analysis Intelligence Index v4.1.1: Astra 61.2, GPT-5.6 Sol 60.9, Claude Fable 5.1 65.7. OpenAI sendiri yang mencetak angka di mana kapal utama barunya menang tiga persepuluh mata ke atas pendahulunya dan tewas 4.5 mata kepada seorang pesaing.
Kedua-duanya benar, dan ketegangan antara keduanya itulah keseluruhan ceritanya. Ini bukan model yang menjadi lebih pintar secara umum. Ini model yang menjadi jauh lebih baik pada satu senarai perkara yang khusus, dan senarai itu berbaloi diketahui dengan tepat, kerana ia tidak sepadan dengan ringkasan pemasaran daripada kedua-dua arah.
Ringkasan:
- Peningkatan pada bidang khusus adalah amat besar dan boleh disahkan daripada sumber utama. Terminal-Bench Science daripada 22.4% kepada 64.6%, SRE-Bench pada percubaan pertama daripada 55.9% kepada 88.0%, ScreenSpot-Pro daripada 76.9% kepada 92.7%, capaian semula MRCR 8 jarum pada julat 512K–1M daripada 73.8% kepada 96.3% — semuanya berbanding GPT-5.6 Sol dan semuanya daripada jadual yang diterbitkan OpenAI.
- Peningkatan kelajuan mungkin lebih penting daripada mana-mana markah. Pada OSWorld 2.0, Astra mencapai 72.6% dalam kira-kira 40 minit setiap tugasan, berbanding 65.7% dalam kira-kira 75 minit bagi Sol — kira-kira 47% lebih jimat masa.
- Agregat umumnya hampir tidak bergerak. Pada satu-satunya indeks merentas vendor yang OpenAI cetak sendiri, Astra +0.3 di atas Sol dan −4.5 di bawah Claude Fable 5.1. Ia juga kalah pada satu-satunya baris akademik yang dilaporkannya berbanding ketiga-tiga model Claude: Humanity's Last Exam dengan alat, 57.2% berbanding 65.0%.
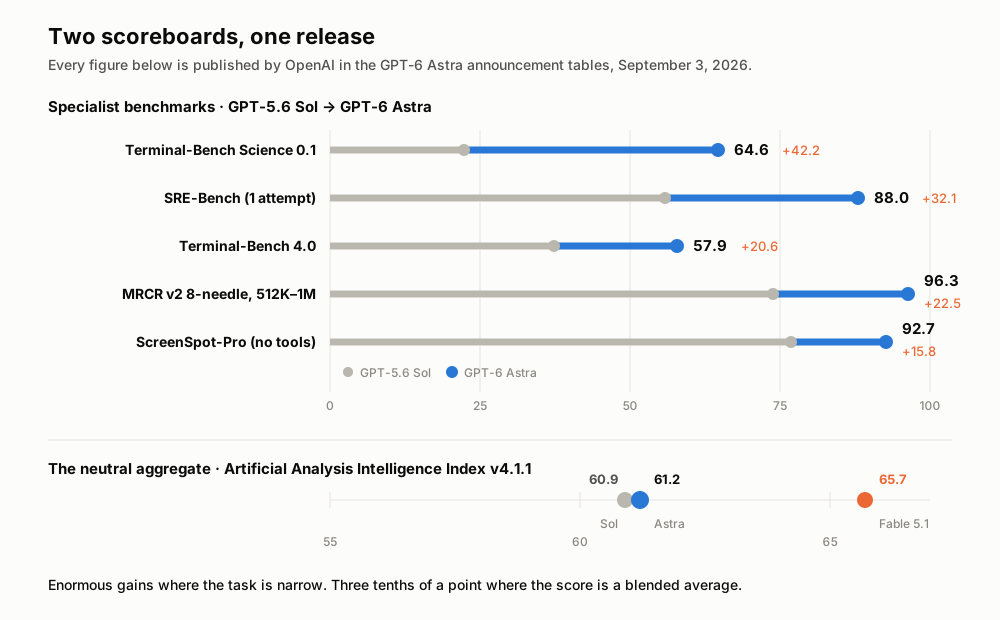
Semua angka datang daripada jadual pengumuman OpenAI sendiri. Sumber di bahagian akhir.
Helaian spesifikasi, tanpa kata sifat
Sebelum hujah, inilah fakta yang boleh anda semak sendiri. Ia datang daripada halaman model gpt-6-astra dalam dokumentasi pembangun OpenAI, dicapai pada 5 September 2026.
| GPT-6 Astra | |
|---|---|
| ID model dalam API | gpt-6-astra |
| Dilancarkan | 3 September 2026 |
| Tetingkap konteks | 1,050,000 token |
| Output maksimum | 128,000 token |
| Had pengetahuan | 30 April 2026 |
| Modaliti input | Teks, imej |
| Modaliti output | Teks |
| Tahap penaakulan | low, medium, high, xhigh, max |
| Harga bagi 1 juta token input | AS$10.00 |
| Harga bagi 1 juta token input daripada cache | AS$1.00 |
| Harga bagi 1 juta token output | AS$50.00 |
| Ketersediaan | ChatGPT Plus, Pro, Business, Enterprise; API OpenAI; Microsoft Azure; AWS Bedrock |
Terdapat tiga butiran dalam jadual ini yang dilangkau oleh kebanyakan liputan, dan sepatutnya tidak.
Permintaan melebihi 272,000 token input dicaj pada dua kali kadar input dan cache serta 1.5 kali kadar output, bagi keseluruhan permintaan. Ertinya tetingkap sejuta token mempunyai satu tebing di tengahnya, bukan kadar rata. Pemprosesan Batch dan Flex dikenakan 50% daripada kadar standard; mod Fast dikenakan dua kali ganda untuk kelajuan sehingga dua kali, tanpa SLA kependaman.
Panggilan alat memerlukan Responses API. Chat Completions masih berfungsi untuk penjanaan biasa, tetapi temperature, top_p dan top_logprobs telah hilang sepenuhnya. Jika anda memindahkan saluran paip yang menala pensampelan, penalaan itu sudah tidak wujud.
Dan Astra menerima teks serta imej, lalu mengeluarkan teks. Ia tidak mendengar. Kita akan kembali kepada perkara ini.
Tajuk sebenarnya ialah pengendalian komputer, dan angka sebenarnya ialah jam
Bingkai OpenAI ialah Astra "menetapkan sempadan baharu dalam penggunaan komputer dan pelayar". Di sini buktinya mampu menyokong kata sifat itu.
Pada OSWorld 2.0 — tugasan desktop seperti menavigasi aplikasi, memindahkan fail, mengisi borang — Astra mencapai 72.6% berbanding 65.7% bagi Sol. Itu 6.9 mata yang wajar. Angka yang menarik terletak di sebelahnya: dalam simulasi kependaman OpenAI, Astra menyiapkan tugasan purata dalam kira-kira 40 minit sedangkan Sol mengambil kira-kira 75 minit — pengurangan kira-kira 47%.
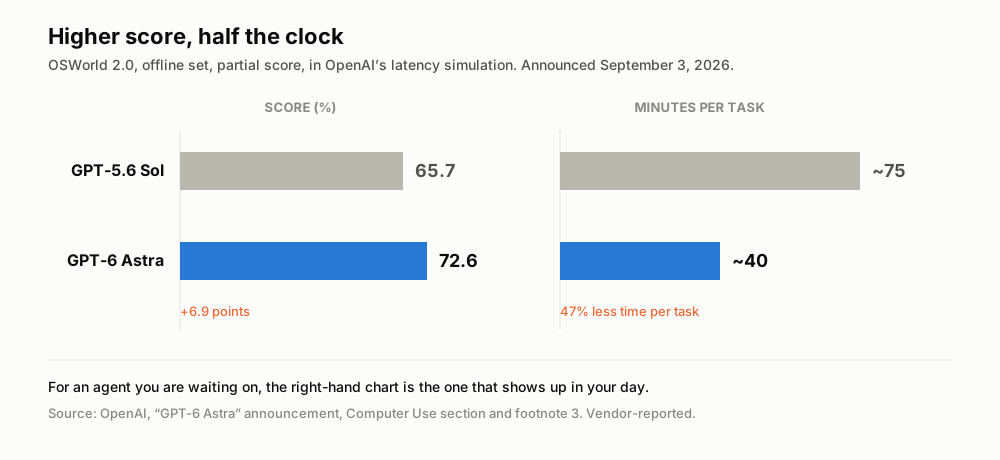
Markah di kiri, jam di kanan. Sumber: pengumuman GPT-6 Astra oleh OpenAI, bahagian Computer Use.
Inilah intinya: bagi model yang anda serahkan kerja lalu anda tunggu, masa setiap tugasan ialah metrik yang benar-benar muncul dalam hari kerja dan dalam bil anda. Tambahan tujuh mata ketepatan ialah keputusan penilaian. Memotong separuh masa menunggu ialah produk yang berbeza.
Selebihnya blok ini konsisten. ScreenSpot-Pro, yang menguji sama ada model dapat mencari dan mengklik piksel yang betul dalam antara muka yang padat, naik daripada 76.9% kepada 92.7% tanpa alat. Agents' Last Exam — tugasan profesional kompleks dalam perisian sebenar, daripada pemodelan kewangan hingga penerbitan media — mendarat pada 59.3%, berbanding 55.5% bagi Claude Opus 5 dan 53.6% bagi Sol, dan OpenAI mencatat bahawa Astra menggunakan kira-kira 65% lebih sedikit token output berbanding Opus 5 untuk sampai ke situ. Pada penanda aras pelayar Mind2Web, dengan harness Codex yang dikemas kini, OpenAI melaporkan penyiapan tugasan 1.9 kali lebih pantas berbanding konfigurasi Sol semasa.
Dibaca dengan teliti, angka terakhir itu ialah dakwaan tentang sistem, bukan tentang model: harness campur model. Namun ia tetap angka yang dialami pengguna, sebab itu ia berbaloi dipetik dan berbaloi dilabel.
Apa yang demo itu sebenarnya tunjukkan
OpenAI menerbitkan rakaman skrin dan bukan imej pegun, dan itulah bukti paling jelas dalam pelancaran ini tentang apa maksud "pengendalian komputer" sekarang. Kami tidak mengehos semula; kesemuanya dimainkan di halaman pengumuman OpenAI. Nota kaki 4 OpenAI sendiri menyatakan bahawa klip yang dipaparkan ialah petikan yang disunting dengan masa berlalu yang dilaporkan bagi setiap sesi demonstrasi berkenaan — itulah kaveat yang wajar dibawa semasa menontonnya.
Empat yang berbaloi dengan masa anda:
- Susun atur PCB dalam KiCad — main balik padat selama 15 saat di mana Astra menukar skema elektronik kepada papan yang boleh dikilangkan, meletakkan komponen dan menghalakan laluan kuprum. Susun atur lazimnya kerja tangan dan merupakan sekatan klasik dalam reka bentuk elektronik.
- Daripada Blender ke Unreal Engine 5 — memodelkan sebuah rumah lalu menukarnya menjadi adegan yang boleh dijelajah, satu serah tugas yang biasanya memakan sehari kerja pereka.
- Set slaid yang dibina daripada templat — Astra diberi beberapa slaid daripada templat pembentangan OpenAI dan diminta menghasilkan dek tentang sebuah model rekaan, sambil mengekalkan nada dan susun atur. Demo paling relevan untuk kerja pejabat, dan paling kurang menggamit perhatian.
- Navigasi perisian genomik — memeriksa kualiti penjujukan dan memvisualkan variasi genetik di dalam perkakas saintifik khusus.
OpenAI turut menerbitkan satu perbandingan pegun yang menggambarkan perubahan tingkah laku, bukan markah: apabila arahan meninggalkan ruang tafsiran, Astra mengajukan satu soalan yang tepat sasaran dan bukan meneka.
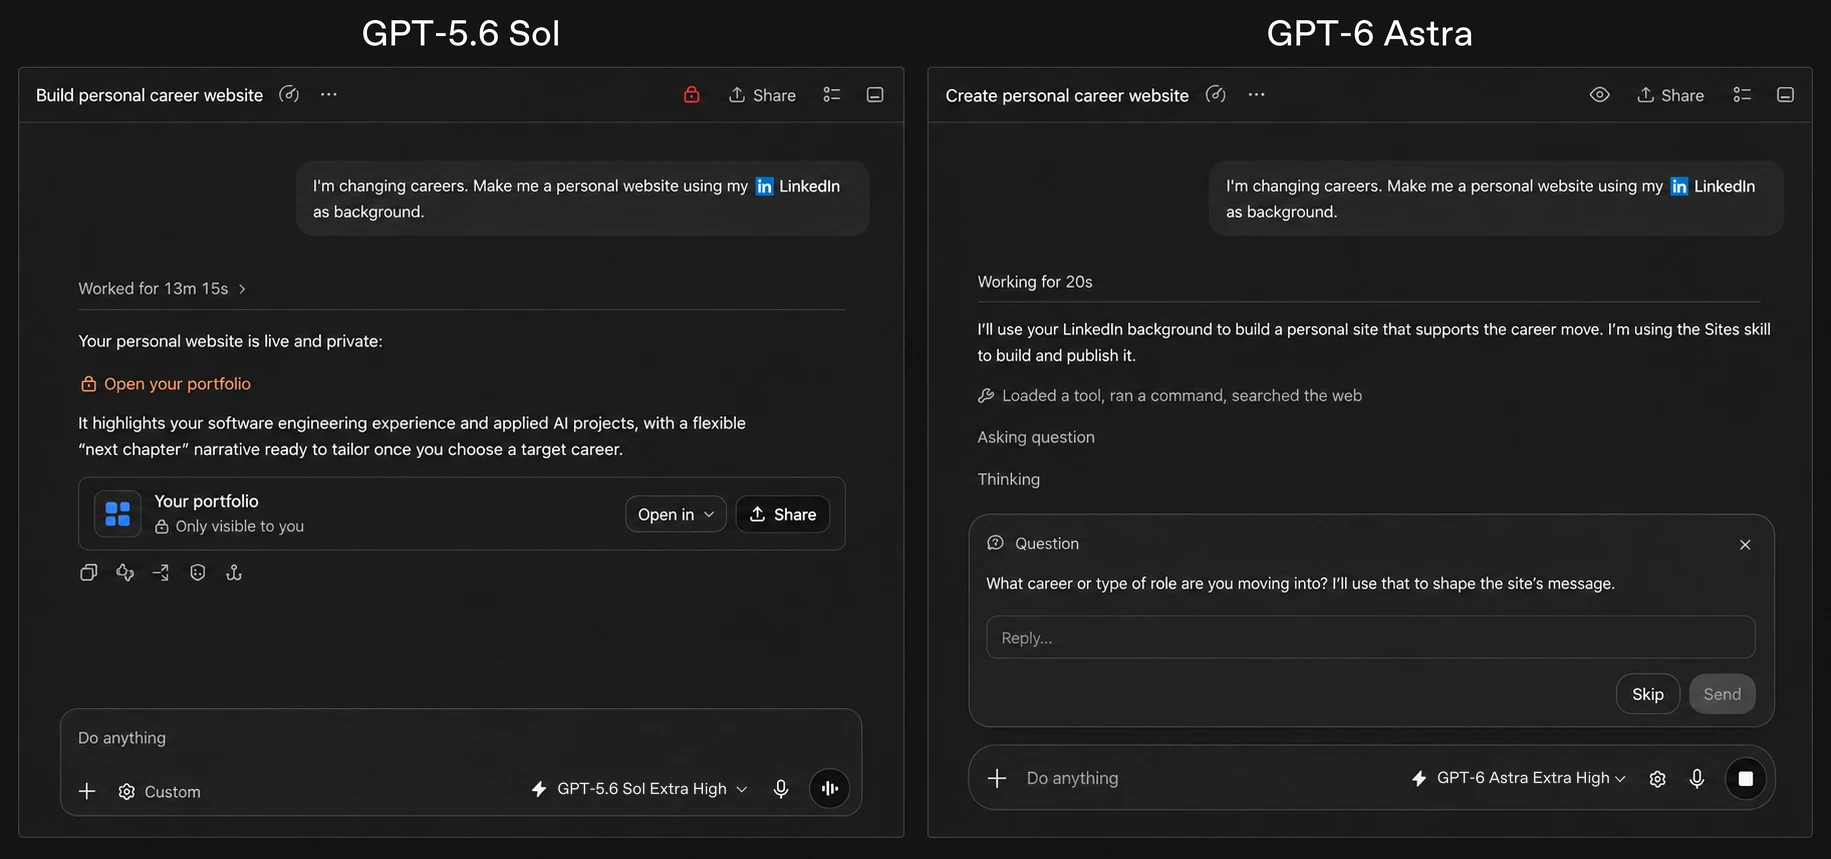
Kredit imej: OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 September 2026. Tingkah laku yang ditunjukkan — bertanya apabila jawapannya akan mengubah hasil, dan meneruskan apabila tidak — ialah demonstrasi vendor, bukan ukuran penanda aras bebas.
Hujung jauh tetingkap konteks berhenti runtuh
Inilah keputusan yang paling kurang diperkatakan dalam pelancaran ini dan, bagi sesiapa yang bekerja dengan dokumen panjang, mungkin yang paling besar kesannya.
Pemasaran konteks panjang sudah tiga tahun tidak boleh dipercayai kerana tetingkap yang diiklankan dan tetingkap yang boleh digunakan ialah dua angka berbeza. Model menerima sejuta token lalu gagal mencapai semula maklumat melebihi beberapa ratus ribu. Namun Astra langsung tidak melebarkan tetingkap itu — konteks GPT-5.6 Sol juga 1,050,000 token. Yang berubah ialah apa yang berlaku di hujungnya.
Dalam ujian MRCR v2 8 jarum milik OpenAI, Astra mencapai 100.0% pada julat 256K–512K berbanding 91.5% bagi Sol, dan bertahan pada 96.3% dalam julat 512K–1M di mana Sol jatuh kepada 73.8%. Jurang 22.5 mata di hujung atas tetingkap ialah beza antara satu spesifikasi dan satu ciri.
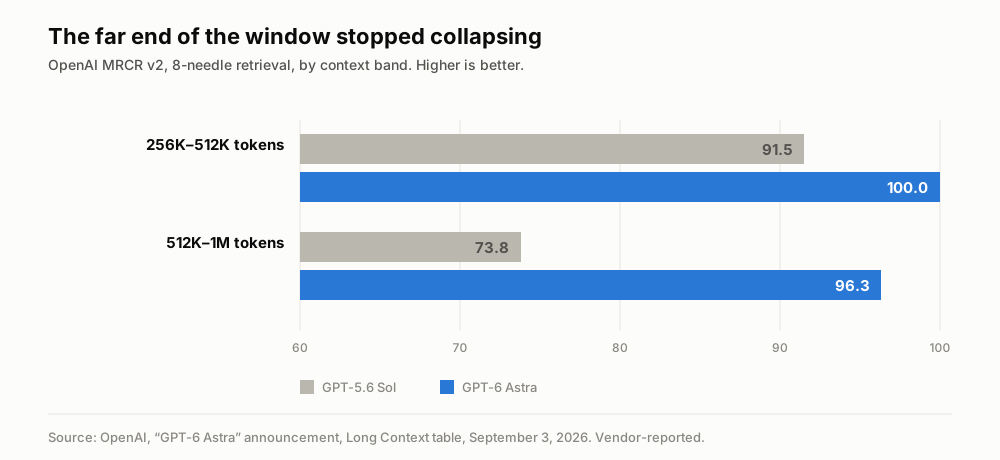
Angka yang dilaporkan vendor, daripada jadual Long Context OpenAI. Kaveatnya: MRCR ialah penanda aras milik OpenAI sendiri.
Seiring dengan itu, Codex memperoleh satu mekanisme eksperimen di mana Astra menyimpan nota merentas tetingkap konteks dan bukannya memampatkan sesi panjang menjadi satu ringkasan yang kehilangan butiran, sementara tetingkap terdahulu kekal boleh dicari. OpenAI menyatakan ini akan menjadi tetapan lalai Astra dalam beberapa minggu. Kehilangan akibat pemampatan — terlupa mengapa satu pembetulan gagal tiga jam lalu — ialah mod kegagalan paling lazim dalam sesi ejen yang panjang, jadi ini pembetulan yang menyasar satu masalah sebenar.
Lonjakan terbesar pelancaran ini datang daripada terminal dan kerja saintifik
Jika semua perbandingan yang diterbitkan berbanding GPT-5.6 Sol disusun mengikut saiz lonjakan, di bahagian atas bukanlah matematik dan bukan pengaturcaraan secara umum. Di atas ialah ejen yang mengendalikan terminal.
| Penanda aras | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22.4% | 64.6% | 52.6% |
| SRE-Bench (1 percubaan) | 55.9% | 88.0% | – |
| Terminal-Bench 4.0 | 37.3% | 57.9% | 55.8% |
| AutomationBench | 18.1% | 41.4% | 31.4% |
| Tugasan migrasi pangkalan data dalaman | 42.7% | 63.9% | 57.8% |
| FrontierMath Tier 4 (v2) | 83.0% | 97.6% | 87.8% |
| GPQA Diamond | 94.6% | 96.0% | 93.7% |
| Humanity's Last Exam (dengan alat) | – | 57.2% | 65.0% |
Terminal-Bench Science hampir tiga kali ganda. SRE-Bench — kejuruteraan balikan binari terkompil tanpa akses kepada kod sumber — melonjak daripada 55.9% kepada 88.0% pada percubaan pertama, dan 99.2% dalam empat percubaan. AutomationBench lebih daripada dua kali ganda. Ini bukan penambahbaikan sebesar ralat pembundaran, dan kesemuanya berkumpul rapat di sekitar satu penerangan: ejen yang mengendalikan alat merentas banyak langkah tanpa hilang jalan cerita.
Dalam matematik, OpenAI melaporkan dua keputusan baharu tentang jurang antara nombor perdana, dengan bukti diterbitkan sebagai PDF. Astra membantu menetapkan bahawa terdapat pasangan nombor perdana yang tak terhingga banyaknya dengan jarak tidak melebihi 186, memperbaiki batas 240 yang baru sahaja ditetapkan oleh Julia Stadlmann, yang dengan sendirinya memperbaiki angka 246 yang bertahan lebih sedekad. Keputusan kedua memperbaiki satu sebutan dalam batas bagi jurang besar antara nombor perdana yang tidak berubah selama lebih 80 tahun. Ini artifak yang boleh disemak dan bukan baris jadual, menjadikannya dakwaan paling tahan lama dalam keseluruhan pengumuman ini.
Di mana pemasaran mendahului bukti
Kini beralih daripada pengukuran kepada pertimbangan. Pandangan kami: ini pelancaran penting yang diperihalkan dengan perbendaharaan kata yang salah, dan bukti yang menentang bingkainya sendiri disediakan oleh OpenAI.
Agregat neutralnya mendatar. Artificial Analysis Intelligence Index v4.1.1, dicetak dalam jadual Professional milik OpenAI: Astra 61.2, Sol 60.9, Fable 5.1 65.7, Opus 5 63.1. Pada Coding Agent Index v1.4, juga dalam jadual OpenAI, Astra mencatat 67.0 berbanding 68.1 milik Opus 5 dan 67.2 milik Fable 5. Model yang seri dengan pendahulunya pada skor komposit bukanlah lonjakan generasi dalam keupayaan umum, apa pun kata pengumuman itu. Menurut metodologi v4.2 Artificial Analysis yang berkuat kuasa kini, dicapai pada 5 September 2026, bentuk kedudukannya tidak berubah: Fable 5.1 pada 56.8, Astra pada 54.7, Opus 5 pada 54.1.
Perkataan "menepu" memikul beban yang berat. Angka 99.9% pada ARC-AGI-3 memang benar, dan nota kaki 1 OpenAI menyebut ia dijalankan dengan harness Responses API "yang mengubah dua tetapan supaya lebih sepadan dengan prestasi dunia sebenar". Panggilan API biasa tanpa keadaan bukanlah harness itu. Anggap 99.9% sebagai siling di bawah konfigurasi yang ditala, bukan tingkah laku yang akan diperoleh integrasi anda.
FrontierMath bukan pengadil neutral. Epoch AI, yang mengendalikannya, telah mendedahkan bahawa OpenAI membiayai pembangunannya dan memegang akses eksklusif kepada sebahagian daripadanya. Angka 97.6% memang mengagumkan; bebas ia tidak.
Angka 100% pada ExploitBench juga bernota. Catatan OpenAI sendiri tentang versi yang disegarkan bagi tempoh Jun–Ogos 2026 menyatakan bahawa sebahagian kerentanan yang disertakan mungkin tidak membenarkan pelaksanaan kod sewenang-wenang di bawah kekangan penilaian itu — satu ayat yang senyap-senyap merumitkan maksud markah sempurna pada versi asal.
Setiap markah tajuk utama ialah kes terbaik. OpenAI menyatakan dengan jelas bahawa markah penilaian ialah nilai maksimum pada mana-mana tahap usaha. Pada usaha max, Artificial Analysis mengukur masa ke token pertama sebanyak 463.7 saat — hampir lapan minit sebelum perkataan pertama — berbanding median 3.86 saat bagi model penaakulan dalam julat harga yang sama. Selepas itu outputnya berjalan pada 87.5 token sesaat, iaitu di atas median tersebut. Angka tajuk utama dan aplikasi yang responsif bukanlah konfigurasi yang sama.
Harganya 2.5 kali ganda. Halaman model GPT-5.6 Sol menyenaraikan AS$4.00 bagi sejuta token input dan AS$20.00 bagi output; Astra menyenaraikan AS$10.00 dan AS$50.00. Itu tepat 2.5 kali di kedua-dua belah — dan kadar Sol itu sendiri ialah harga promosi, diterbitkan sebagai sah sekurang-kurangnya sehingga 21 November 2026. Pengimbang yang jujur ialah kecekapan token: Artificial Analysis mengukur kos menjalankan Intelligence Index penuh mereka pada AS$2.57 bagi Astra berbanding AS$6.12 bagi Fable 5.1 dan AS$4.21 bagi Opus 5. Astra lebih mahal setiap token dan lebih murah setiap tugasan yang siap berbanding model Claude — satu pembezaan yang wajar dibuat sebelum sesiapa memetik harga senarai sebagai keputusan muktamad.
Dan ia lebih telus dalam sesetengah perkara, kurang telus dalam yang lain. Kad sistemnya melaporkan bahawa Astra melakukan jauh lebih sedikit kesilapan fakta berbanding Sol, tidak pernah sekali pun cuba memintas penolakan Codex Auto-Review dalam ujian dalaman, dan melangkaui sasaran yang dibenarkan pada 0% kes dalam penilaian pelanggaran skop, sedangkan Sol tanpa perlindungan melakukannya pada 48% kes. Dokumen yang sama melaporkan bahawa penaakulan bertulis Astra lebih sukar dipantau berbanding Sol; OpenAI mengaitkannya dengan rantaian pemikiran yang lebih pendek dan menyatakan mereka memandangnya serius. Kedua-duanya wajar berada dalam perenggan yang sama.
Empat perkara yang kami tidak dapat sahkan, dan kami tandakan sedemikian
Liputan sekitar pelancaran ini mendahului bukti pada beberapa titik tertentu.
Beberapa liputan sekunder mendakwa Astra merosot pada GDPval, pada penggunaan alat perbankan, pada penaakulan atas dokumen panjang, dan pada kualiti pembentangan dalam ujian ejen jangka panjang. Kami menyemaknya: GDPval langsung tidak muncul di mana-mana dalam pengumuman OpenAI, dan kami tidak menemui angka GDPval bagi Astra yang diterbitkan OpenAI mahupun larian bebas yang telah selesai untuk menyemak dakwaan itu. Ketiadaannya itu sendiri memang patut diberi perhatian — GDPval ialah penanda aras yang dibina sekitar kerja bernilai ekonomi merentas banyak pekerjaan. Tetapi "tiada" dan "merosot" ialah dua penemuan berbeza, dan hanya yang pertama yang sabit.
Dakwaan bahawa Astra menemui dua kerentanan zero-day yang sebelum ini tidak diketahui semasa penilaian dalaman tercatat dalam pengumuman OpenAI, dengan janji pendedahan kepada penyelenggara. Ia belum disahkan secara bebas dan kerentanannya belum dikenal pasti.
"GPT-6 Astra Pro" disebut untuk pelan Pro, Business dan Enterprise tanpa harga berasingan, penanda aras atau kad model yang diterbitkan setakat 5 September 2026. Di luar OpenAI, tiada siapa tahu ia apa.
Penanda aras halusinasi dalaman yang menunjukkan 4.2% bagi Astra berbanding 12.2% bagi Sol memang penanda aras dalaman. OpenAI memerihalkan cara ia dibina — perbualan ChatGPT yang telah dinyahkenal pasti dan ditanda pengguna sebagai mengandungi kesilapan fakta — dan menyatakan secara terus terang bahawa kadar mutlaknya memang sengaja dibesarkan dan tidak wajar dibaca sebagai kadar halusinasi dalam pengeluaran. Arah alirannya boleh dipercayai; angkanya tidak boleh dipindahkan.
Model barisan hadapan masih tidak boleh mendengar
Inilah butiran yang membingkai semula pelancaran ini bagi sesiapa yang kerjanya tiba dalam bentuk pertuturan dan bukan teks.
Modaliti input GPT-6 Astra ialah teks dan imej. Modaliti outputnya ialah teks. Model paling berkeupayaan yang pernah dihantar OpenAI — tetingkap sejuta token, 47% lebih pantas memandu desktop, capaian semula 96.3% di hujung atas konteksnya — tidak mempunyai telinga.
Ini bukan kecuaian, ini seni bina. Model penaakulan barisan hadapan dan model pertuturan ialah barisan produk yang berasingan, dan kerja audio masih melalui peringkat transkripsi sebelum model penaakulan melihat apa-apa. Ertinya kualiti segala yang Astra boleh lakukan dengan sebuah perbualan disiling di hulu, oleh apa jua yang menukar perbualan itu menjadi token. Jika transkripnya menggabungkan dua penutur, atau kehilangan segmen bahasa Thai dalam mesyuarat dwibahasa, atau menggugurkan sembilan puluh saat ketika sambungan tersekat, maka tetingkap konteks sejuta token hanyalah bekas yang amat besar bagi input yang cacat.
Inilah lapisan yang tidak pernah dibaiki oleh pelancaran model dan yang mendapat semakin kurang perhatian setiap kali ada kapal utama baharu. Lapisan penaakulan terus bertambah baik pada kadar yang boleh dilukis grafiknya. Lapisan rakaman — merakam sejam tanpa kehilangan apa-apa, mengasingkan penutur, menangani mesyuarat yang bertukar bahasa di tengah ayat — bertambah baik pada lengkung yang sama sekali berbeza dan jauh lebih landai, dan sebanyak mana pun kecerdasan barisan hadapan di hilir tidak menampung transkrip yang buruk di hulu.
Kesimpulan: barisan hadapan menumbuhkan lengan, bukan kepala
GPT-6 Astra ialah pelancaran berlengan panjang. Ia menjangkau jauh lebih dalam ke jenis kerja tertentu — mengendalikan terminal, memandu desktop, mencapai semula di hujung jauh sejuta token, mengejuruterakan balik sebuah binari — sementara apa yang biasa kita panggil kecerdasan hampir tidak bergerak pada setiap ukuran neutral yang ada, termasuk ukuran yang OpenAI cetak sendiri.
Itu bukan satu kekecewaan. Ia malah bentuk yang lebih berguna berbanding sebaliknya, kerana keupayaan sempit sampai ke pengeluaran jauh lebih cepat daripada keupayaan umum. Tetapi ia bermakna soalan ketika membeli sudah berubah. "Adakah ia lebih pintar?" kini mempunyai jawapan yang hampir tidak bermakna. "Adakah ia lebih baik pada gelung khusus yang saya jalankan empat puluh kali sehari, dan berapa lama gelung itu sekarang?" mempunyai jawapan yang sangat baik.
Semak penanda aras yang menyerupai kerja anda. Abaikan skor komposit. Dan lihat jamnya, bukan sekadar markahnya.
Di mana Telli.sh masuk: jurang yang ditonjolkan oleh pelancaran ini — penaakulan cemerlang yang bertumpu pada apa jua yang diserahkan lapisan rakaman — ialah tepat jurang tempat kami membina. Telli.sh merakam mesyuarat, mengasingkan penutur, menterjemah secara langsung ke 15 bahasa, dan meninggalkan nota yang masih boleh dicari suku tahun hadapan. Ia menghalakan transkripsi, terjemahan dan peringkasan melalui satu lapisan enjin yang boleh ditukar ganti, jadi pelancaran seperti Astra tiba sebagai nota yang lebih baik dan bukan sebagai projek migrasi. Tiada pengumuman model barisan hadapan yang mengubah bahagian di mana seseorang perlu merakam jam itu terlebih dahulu.
Mulakan nota terjemahan langsung
Sumber
- OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 September 2026 — kesemua jadual penanda aras (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), simulasi kependaman OSWorld, angka 1.9× pada Mind2Web, nota kaki 1, 3, 4, 8, 9, 10, 11 dan 12, ketersediaan, serta keputusan tentang jurang nombor perdana; dicapai 5 September 2026
- Dokumentasi pembangun OpenAI, halaman model
gpt-6-astra— tetingkap konteks, output maksimum, had pengetahuan, modaliti, tahapreasoning.effort, serta harga standard, cache dan tulis-cache; dicapai 5 September 2026 - Dokumentasi pembangun OpenAI, panduan migrasi dan prompting "Using GPT-6 Astra" — keperluan Responses API bagi panggilan alat, parameter pensampelan yang dibuang, dan kaveat mod Fast; dicapai 5 September 2026
- Kad sistem GPT-6 Astra, OpenAI Deployment Safety Hub — ambang Critical keselamatan siber dalam Preparedness Framework, tahap High bagi biologi dan kimia, di bawah High bagi peningkatan diri AI, keteguhan terhadap jailbreak, penilaian kefaktaan berserta batasannya yang dinyatakan, dan penurunan keupayaan memantau rantaian pemikiran; dicapai 5 September 2026
- Artificial Analysis, analisis kecerdasan, prestasi dan harga GPT-6 Astra — skor Intelligence Index v4.2, kos setiap tugasan Intelligence Index, kelajuan output 87.5 token sesaat, dan masa ke token pertama 463.7 saat; dicapai 5 September 2026
- Vellum, "GPT-6 Astra Benchmarks Explained" — semakan silang jadual pengendalian komputer, akademik dan konteks panjang, serta tanda bintang pada Humanity's Last Exam
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — kaveat tentang harness ARC-AGI-3 dan perbandingan pada Intelligence Index
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — punca dakwaan kemerosotan pada GDPval, penggunaan alat perbankan, konteks panjang dan kualiti pembentangan yang tidak dapat kami sahkan daripada sumber utama
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4 September 2026 — masa pelancaran dan pelaksanaan berperingkat
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4 September 2026 — susunan pelancaran mengikut pelan selepas hari pelancaran
- Ulasan kami tentang pelancaran senyap GLM-5.3-Flash — hujung lain lengkung yang sama, tempat keupayaan tiba dengan murah dan bukan mahal