40 minuti invece di 75: in cosa GPT-6 Astra è davvero bravo
OpenAI ha rilasciato GPT-6 Astra il 3 settembre 2026 definendolo il modello più intelligente al mondo. Le sue stesse tabelle di benchmark raccontano una storia più netta: balzi enormi su compiti stretti — Terminal-Bench Science dal 22,4% al 64,6%, SRE-Bench dal 55,9% all'88,0%, OSWorld con il 47% di tempo in meno per attività — poggiati su un indice generale neutrale che si è mosso di tre decimi. Dove i guadagni sono reali, dove stanno gli asterischi e cosa un modello testuale da un milione di token continua a non saper fare.
Il 3 settembre 2026 OpenAI ha rilasciato GPT-6 Astra definendolo «il modello più intelligente e meglio allineato al mondo».
Quattro righe più in basso, nella sua stessa tabella di benchmark, compare l'Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. OpenAI ha pubblicato di persona il numero in cui la nuova ammiraglia guadagna tre decimi sul proprio predecessore e ne perde 4,5 su un concorrente.
Entrambi i fatti sono veri, e la tensione tra i due è tutta la storia. Non è un modello diventato più intelligente in generale. È un modello diventato drasticamente migliore su un elenco preciso di cose, ed è un elenco che vale la pena conoscere con esattezza, perché non coincide con il riassunto di marketing in nessuna delle due direzioni.
In sintesi:
- I guadagni specialistici sono enormi e verificabili alla fonte. Terminal-Bench Science dal 22,4% al 64,6%, SRE-Bench al primo tentativo dal 55,9% all'88,0%, ScreenSpot-Pro dal 76,9% al 92,7%, recupero MRCR a 8 aghi nella fascia 512K–1M dal 73,8% al 96,3%: tutto contro GPT-5.6 Sol e tutto tratto dalle tabelle pubblicate da OpenAI.
- Il guadagno di velocità può contare più di qualsiasi punteggio. Su OSWorld 2.0 Astra ottiene il 72,6% in circa 40 minuti per attività, contro il 65,7% in circa 75 di Sol: circa il 47% di tempo in meno.
- L'aggregato generale si è mosso appena. Sull'unico indice trasversale ai fornitori che OpenAI stessa ha stampato, Astra è a +0,3 su Sol e a −4,5 su Claude Fable 5.1. E perde l'unica riga accademica che riporta contro tutti e tre i Claude: Humanity's Last Exam con strumenti, 57,2% contro 65,0%.
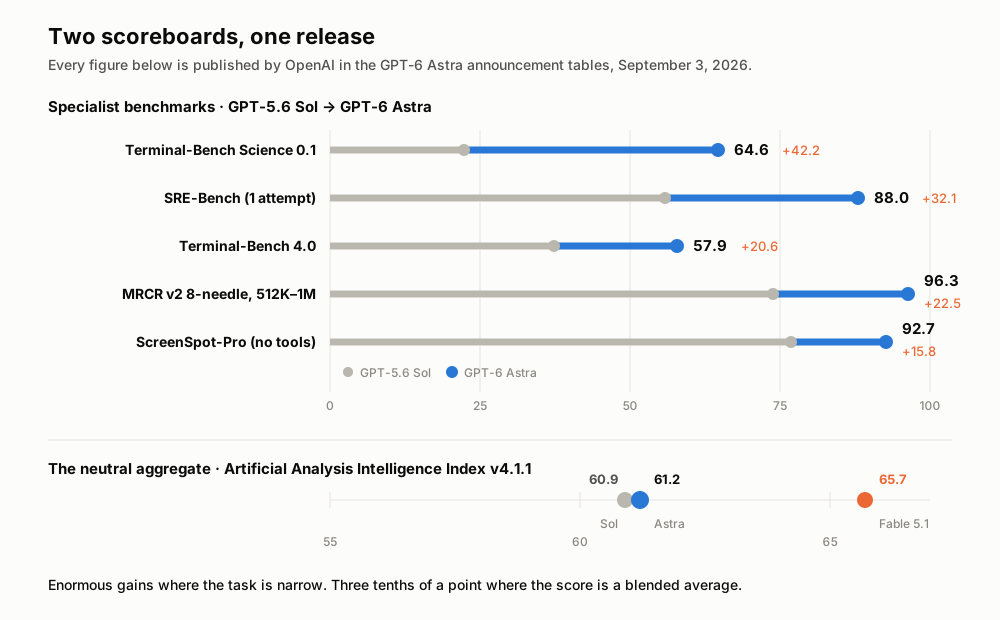
Tutti i numeri provengono dalle tabelle di annuncio di OpenAI. Fonti in fondo.
La scheda tecnica, senza aggettivi
Prima dell'argomentazione, i fatti verificabili. Vengono dalla pagina per sviluppatori del modello gpt-6-astra, consultata il 5 settembre 2026.
| GPT-6 Astra | |
|---|---|
| ID modello API | gpt-6-astra |
| Rilascio | 3 settembre 2026 |
| Finestra di contesto | 1.050.000 token |
| Output massimo | 128.000 token |
| Taglio delle conoscenze | 30 aprile 2026 |
| Modalità di input | Testo, immagine |
| Modalità di output | Testo |
| Livelli di ragionamento | low, medium, high, xhigh, max |
| Prezzo per 1 milione di token in input | 10,00 $ |
| Prezzo per 1 milione di token in input da cache | 1,00 $ |
| Prezzo per 1 milione di token in output | 50,00 $ |
| Disponibilità | ChatGPT Plus, Pro, Business, Enterprise; API OpenAI; Microsoft Azure; AWS Bedrock |
Tre dettagli di questa tabella vengono saltati da quasi tutta la copertura e non dovrebbero esserlo.
Le richieste sopra i 272.000 token in input vengono fatturate al doppio delle tariffe di input e cache e a 1,5 volte quella di output, per l'intera richiesta. La finestra da un milione di token ha quindi uno scalino a metà, non una tariffa piatta. L'elaborazione Batch e Flex costa il 50% dello standard; la modalità Fast costa il doppio per una velocità fino a due volte superiore, senza SLA di latenza.
Le chiamate a strumenti richiedono l'API Responses. Chat Completions funziona ancora per la generazione semplice, ma temperature, top_p e top_logprobs sono spariti del tutto. Se state migrando una pipeline che regola il campionamento, quella regolazione non esiste più.
E Astra riceve testo e immagini, e produce testo. Non sente. Ci torneremo.
Il vero titolo è l'uso del computer, e il vero numero è l'orologio
L'inquadratura di OpenAI è che Astra «segna una nuova frontiera nell'uso del computer e del browser». Qui le prove reggono l'aggettivo.
Su OSWorld 2.0 — attività desktop come navigare tra applicazioni, spostare file, compilare moduli — Astra ottiene il 72,6% contro il 65,7% di Sol. Sono 6,9 punti rispettabili. Il numero interessante sta accanto: nella simulazione di latenza di OpenAI, Astra ha completato l'attività media in circa 40 minuti dove Sol ne impiegava circa 75, una riduzione di circa il 47%.
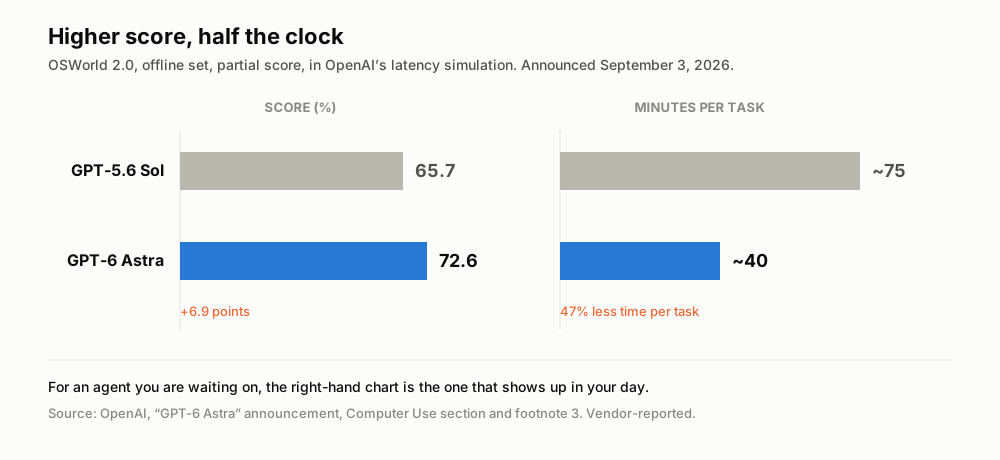
Il punteggio a sinistra, l'orologio a destra. Fonte: annuncio GPT-6 Astra di OpenAI, sezione Computer Use.
Il punto è questo: per un modello a cui si delega un lavoro e che poi si aspetta, il tempo per attività è la metrica che compare nella giornata e in fattura. Sette punti di accuratezza in più sono un risultato di valutazione. Dimezzare l'attesa è un altro prodotto.
Il resto del blocco è coerente. ScreenSpot-Pro, che misura se un modello sa trovare e cliccare il pixel giusto in un'interfaccia densa, passa dal 76,9% al 92,7% senza strumenti. Agents' Last Exam — compiti professionali complessi dentro software reale, dalla modellazione finanziaria alla produzione media — arriva al 59,3%, contro il 55,5% di Claude Opus 5 e il 53,6% di Sol, e OpenAI segnala che per riuscirci Astra ha usato circa il 65% di token in output in meno rispetto a Opus 5. Sul benchmark browser Mind2Web, con un harness Codex aggiornato, OpenAI riporta un completamento delle attività 1,9 volte più rapido rispetto all'attuale configurazione Sol.
Letto con attenzione, quest'ultimo numero è un'affermazione sul sistema, non sul modello: harness più modello. Resta comunque il numero che l'utente sperimenta, il che lo rende degno di essere citato e insieme di essere etichettato.
Cosa mostrano davvero le demo
OpenAI ha pubblicato registrazioni dello schermo anziché immagini fisse, e sono la prova più chiara di questo rilascio su cosa significhi oggi «uso del computer». Non le abbiamo ricaricate: si riproducono sulla pagina di annuncio di OpenAI. La nota 4 di OpenAI precisa che le clip mostrate sono estratti montati con i tempi rilevati nelle rispettive dimostrazioni, ed è la giusta cautela da portarsi dietro guardandole.
Le quattro che meritano il vostro tempo:
- Sbroglio di PCB in KiCad: una riproduzione condensata di 15 secondi in cui Astra trasforma uno schema elettronico in una scheda producibile, posizionando i componenti e instradando le piste di rame. Lo sbroglio è di norma lavoro manuale e un collo di bottiglia classico della progettazione elettronica.
- Da Blender a Unreal Engine 5: modellare una casa e convertirla in una scena percorribile, un passaggio di consegne che di solito costa una giornata di design.
- Una presentazione costruita su un template: ad Astra vengono date poche slide del template di presentazione di OpenAI e il compito di produrre un deck su un modello fittizio, rispettando tono e impaginazione. La demo più rilevante per il lavoro d'ufficio e la meno spettacolare.
- Navigazione in software di genomica: ispezionare la qualità del sequenziamento e visualizzare la variazione genetica dentro strumenti scientifici specialistici.
OpenAI ha pubblicato anche un confronto statico che illustra un cambiamento di comportamento anziché un punteggio: quando le istruzioni lasciano spazio all'interpretazione, Astra pone una domanda mirata invece di tirare a indovinare.
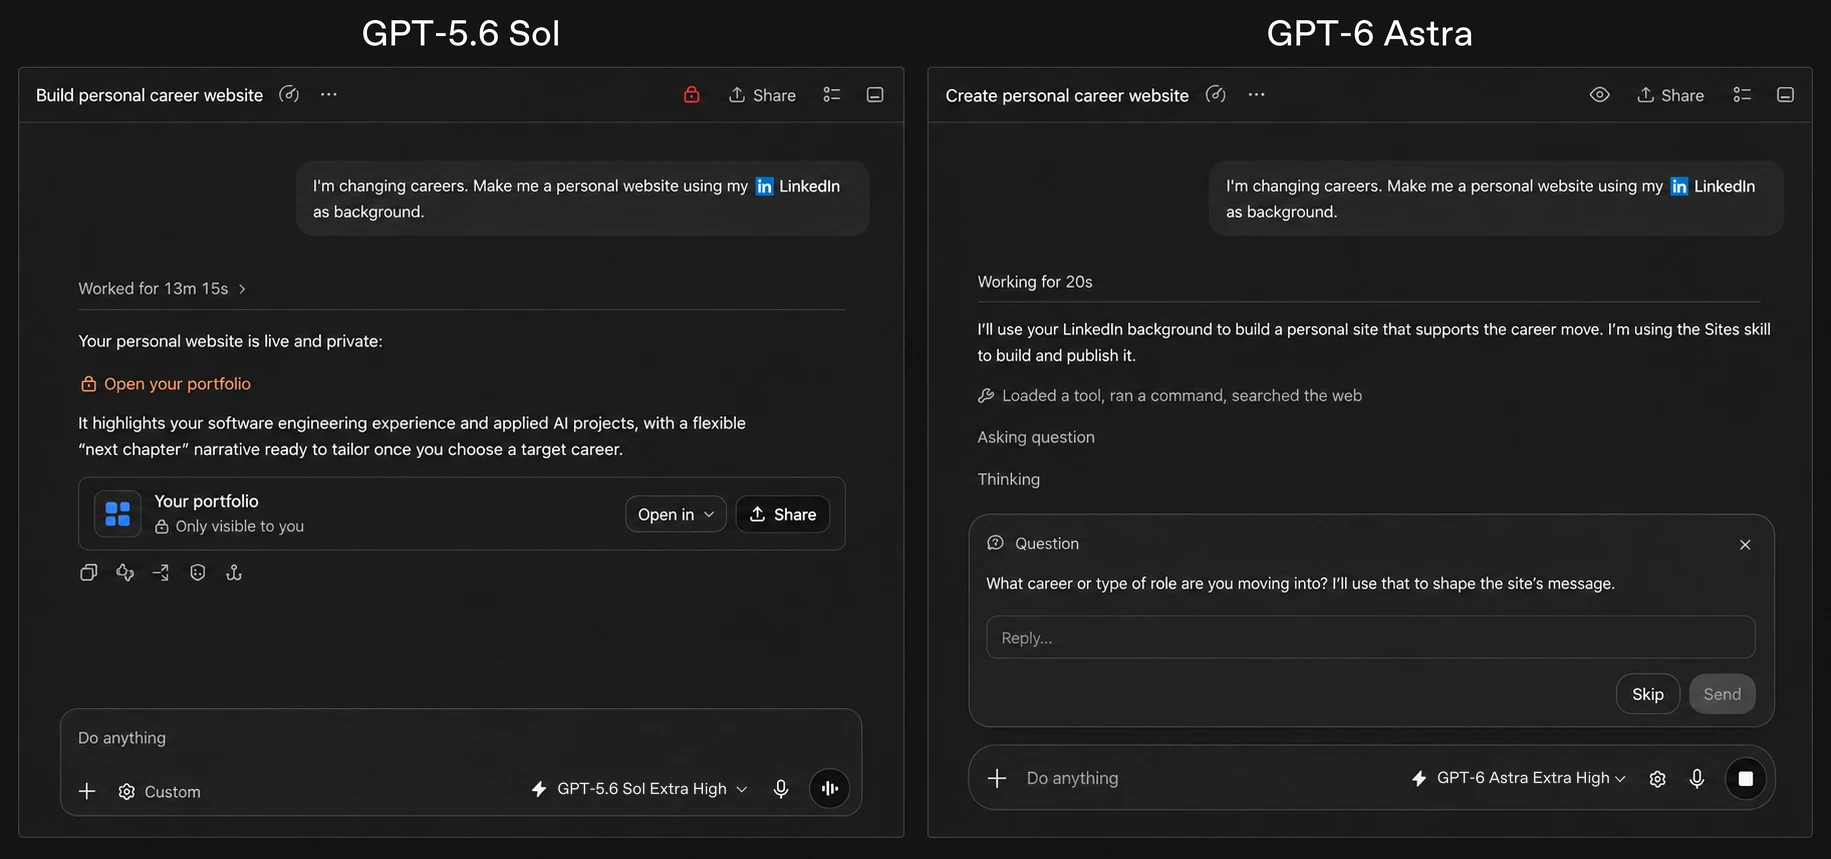
Credito immagine: OpenAI, «GPT-6 Astra: A new generation of intelligence», 3 settembre 2026. Il comportamento mostrato — chiedere quando la risposta cambierebbe l'esito, procedere quando non lo cambierebbe — è una dimostrazione del fornitore, non una misurazione di benchmark indipendente.
L'estremità della finestra di contesto ha smesso di crollare
È il risultato meno discusso del rilascio e, per chi lavora su documenti lunghi, probabilmente il più rilevante.
Il marketing sul contesto lungo è inaffidabile da tre anni perché la finestra pubblicizzata e quella utilizzabile erano due numeri diversi. I modelli accettavano un milione di token e poi recuperavano male oltre qualche centinaio di migliaia. Ebbene, Astra non ha allargato affatto la finestra: anche il contesto di GPT-5.6 Sol è di 1.050.000 token. Ciò che è cambiato è quello che succede alla sua estremità.
Nel test MRCR v2 a 8 aghi di OpenAI, Astra ottiene il 100,0% nella fascia 256K–512K contro il 91,5% di Sol, e tiene il 96,3% nella fascia 512K–1M dove Sol scende al 73,8%. Uno scarto di 22,5 punti nella parte alta della finestra è la differenza tra una specifica e una funzione.
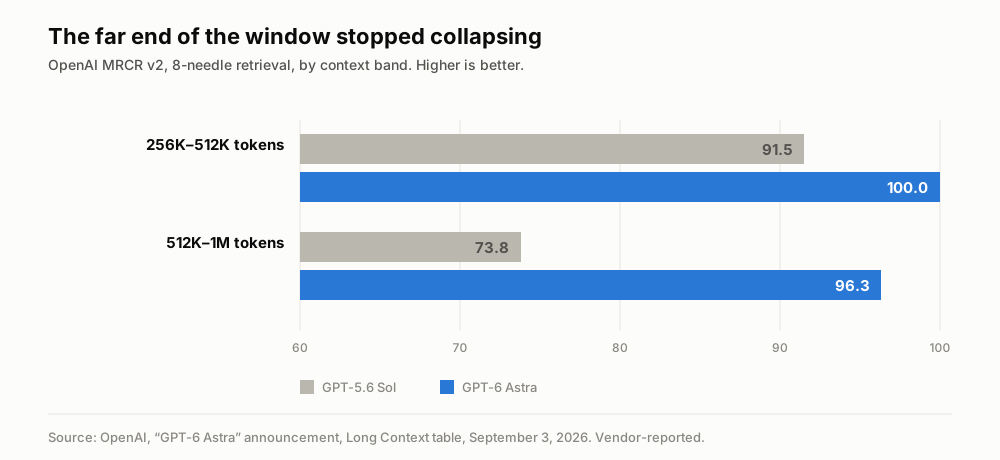
Dati dichiarati dal fornitore, dalla tabella Long Context di OpenAI. La cautela: MRCR è un benchmark interno di OpenAI.
In parallelo, Codex guadagna un meccanismo sperimentale in cui Astra mantiene appunti da una finestra di contesto all'altra invece di comprimere una lunga sessione in un unico riassunto con perdite, lasciando consultabili le finestre precedenti. OpenAI dichiara che diventerà il comportamento predefinito di Astra nel giro di settimane. La perdita da compattazione — dimenticare perché una correzione è fallita tre ore prima — è la modalità di guasto più comune nelle sessioni lunghe di agente: è quindi una correzione mirata a un problema reale.
I salti maggiori del rilascio arrivano dal terminale e dal lavoro scientifico
Ordinando tutti i confronti pubblicati contro GPT-5.6 Sol per ampiezza del balzo, in cima non ci sono né la matematica né la programmazione in generale. Ci sono gli agenti che pilotano un terminale.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4% | 64,6% | 52,6% |
| SRE-Bench (1 tentativo) | 55,9% | 88,0% | – |
| Terminal-Bench 4.0 | 37,3% | 57,9% | 55,8% |
| AutomationBench | 18,1% | 41,4% | 31,4% |
| Attività interne di migrazione database | 42,7% | 63,9% | 57,8% |
| FrontierMath Tier 4 (v2) | 83,0% | 97,6% | 87,8% |
| GPQA Diamond | 94,6% | 96,0% | 93,7% |
| Humanity's Last Exam (con strumenti) | – | 57,2% | 65,0% |
Terminal-Bench Science è quasi triplicato. SRE-Bench — reverse engineering di binari compilati senza accesso al sorgente — è passato dal 55,9% all'88,0% al primo tentativo e al 99,2% entro quattro. AutomationBench è più che raddoppiato. Non sono miglioramenti da arrotondamento, e si stringono attorno a un'unica descrizione: un agente che manovra strumenti lungo molti passaggi senza perdere il filo.
In matematica, OpenAI riporta due nuovi risultati sugli intervalli tra numeri primi, con le dimostrazioni pubblicate in PDF. Astra ha contribuito a stabilire che esistono infinite coppie di primi distanti al massimo 186, migliorando un limite di 240 fissato di recente da Julia Stadlmann, a sua volta un miglioramento del 246 rimasto valido per oltre un decennio. Un secondo risultato ha migliorato un termine di un limite sugli intervalli ampi tra primi rimasto invariato per più di 80 anni. Sono artefatti verificabili anziché righe di tabella, il che li rende le affermazioni più durevoli dell'intero annuncio.
Dove il marketing supera le prove
Ora il passaggio dalla misurazione al giudizio. La nostra lettura: è un rilascio importante descritto con il vocabolario sbagliato, e le prove contro la sua stessa inquadratura le ha fornite OpenAI.
L'aggregato neutrale è piatto. Artificial Analysis Intelligence Index v4.1.1, stampato nella tabella Professional di OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. Sul Coding Agent Index v1.4, sempre nella tabella di OpenAI, Astra segna 67,0 contro il 68,1 di Opus 5 e il 67,2 di Fable 5. Un modello che pareggia con il proprio predecessore sul composito non è un salto generazionale di capacità generale, comunque lo racconti il post. Con la metodologia v4.2 attuale di Artificial Analysis, consultata il 5 settembre 2026, la forma della classifica non cambia: Fable 5.1 a 56,8, Astra a 54,7, Opus 5 a 54,1.
«Satura» sta reggendo un peso notevole. Il 99,9% su ARC-AGI-3 è reale, e la nota 1 di OpenAI precisa che è stato ottenuto con un harness dell'API Responses «che modifica due impostazioni per avvicinarsi meglio alle prestazioni reali». Una normale chiamata API senza stato non è quell'harness. Trattate il 99,9% come un tetto in una configurazione ottimizzata, non come il comportamento della vostra integrazione.
FrontierMath non è un arbitro neutrale. Epoch AI, che lo gestisce, ha dichiarato che OpenAI ne ha finanziato lo sviluppo e detiene accesso esclusivo a una parte. Il 97,6% è impressionante; indipendente non lo è.
Anche il 100% su ExploitBench ha una nota. L'annotazione di OpenAI sulla versione aggiornata di giugno-agosto 2026 dice che alcune delle vulnerabilità incluse potrebbero non consentire l'esecuzione di codice arbitrario sotto i vincoli della valutazione: una frase che complica sottovoce il significato di un punteggio perfetto sull'originale.
Ogni punteggio da titolo è il caso migliore. OpenAI dichiara esplicitamente che i punteggi di valutazione sono il massimo su qualunque livello di sforzo. Con sforzo max, Artificial Analysis misura un tempo al primo token di 463,7 secondi — quasi otto minuti prima della prima parola — contro una mediana di 3,86 secondi tra i modelli di ragionamento della stessa fascia di prezzo. L'output scorre poi a 87,5 token al secondo, sopra quella mediana. I numeri da titolo e un'applicazione reattiva non sono la stessa configurazione.
Il prezzo è 2,5 volte. La pagina del modello GPT-5.6 Sol indica 4,00 $ per milione di token in input e 20,00 $ in output; Astra indica 10,00 $ e 50,00 $. È esattamente 2,5 volte su entrambi i lati, e per giunta la tariffa di Sol è promozionale, pubblicata come valida almeno fino al 21 novembre 2026. Il contrappeso onesto è l'efficienza in token: Artificial Analysis misura il costo di un giro completo del proprio Intelligence Index a 2,57 $ per Astra contro 6,12 $ per Fable 5.1 e 4,21 $ per Opus 5. Astra costa di più al token e meno ad attività completata rispetto ai Claude: una distinzione da fare prima che qualcuno citi il prezzo di listino come un verdetto.
Ed è più trasparente per certi versi, meno per altri. La system card riporta che Astra commette sensibilmente meno errori fattuali di Sol, che nei test interni non ha mai provato ad aggirare un rifiuto dell'Auto-Review di Codex e che è andato oltre l'obiettivo autorizzato nello 0% dei casi in una valutazione sullo sconfinamento, dove Sol senza salvaguardie lo faceva nel 48%. Lo stesso documento riporta che il ragionamento scritto di Astra è più difficile da monitorare di quello di Sol, cosa che OpenAI attribuisce a catene di pensiero più corte e dichiara di prendere sul serio. Entrambe le cose appartengono allo stesso paragrafo.
Quattro cose che non abbiamo potuto verificare, segnalate come tali
La copertura di questo rilascio corre davanti alle prove in punti precisi.
Alcune coperture secondarie hanno sostenuto che Astra sia regredito su GDPval, sull'uso di strumenti bancari, sul ragionamento su documenti lunghi e sulla qualità delle presentazioni in test agentici di lungo respiro. Abbiamo verificato: GDPval non compare da nessuna parte nell'annuncio di OpenAI, e non abbiamo trovato né un dato GDPval pubblicato da OpenAI per Astra né un'esecuzione indipendente completata con cui riscontrare l'affermazione. L'assenza in sé è degna di nota — GDPval è il benchmark costruito attorno al lavoro di valore economico in molte professioni — ma «manca» e «è regredito» sono due constatazioni diverse, e solo la prima è accertata.
L'affermazione che Astra abbia scoperto due vulnerabilità zero-day precedentemente ignote durante le valutazioni interne è contenuta nell'annuncio di OpenAI, con divulgazione promessa ai manutentori. Non è confermata in modo indipendente e le vulnerabilità non sono identificate.
«GPT-6 Astra Pro» è citato per i piani Pro, Business ed Enterprise senza prezzo, benchmark o model card pubblicati al 5 settembre 2026. Fuori da OpenAI nessuno sa cosa sia.
Il benchmark interno sulle allucinazioni che indica 4,2% per Astra contro 12,2% per Sol è un benchmark interno. OpenAI ne descrive la costruzione — conversazioni ChatGPT deidentificate che gli utenti avevano segnalato come contenenti errori fattuali — e afferma senza giri di parole che i tassi assoluti sono gonfiati per costruzione e non vanno letti come tassi di allucinazione in produzione. La direzione è credibile; il numero non è trasferibile.
Il modello di frontiera ancora non sente
Ecco il dettaglio che riformula il rilascio per chiunque riceva il proprio lavoro sotto forma di parlato anziché di testo.
Le modalità di input di GPT-6 Astra sono testo e immagine. La modalità di output è testo. Il modello più capace che OpenAI abbia mai rilasciato — una finestra da un milione di token, il 47% più rapido nel guidare un desktop, il 96,3% di recupero all'estremità del contesto — non ha orecchie.
Non è una svista, è architettura. I modelli di ragionamento di frontiera e i modelli vocali sono linee di prodotto separate, e il lavoro audio passa ancora per una fase di trascrizione prima che un modello di ragionamento veda alcunché. Significa che la qualità di tutto ciò che Astra può fare con una conversazione ha un tetto a monte, fissato da qualunque cosa abbia trasformato quella conversazione in token. Se la trascrizione ha fuso due interlocutori, o perso il tratto in thailandese di una riunione bilingue, o lasciato cadere novanta secondi durante un'oscillazione della connessione, allora una finestra di contesto da un milione di token è un contenitore molto grande per un input difettoso.
È lo strato che i rilasci di modelli non riparano mai e che riceve meno attenzione a ogni nuova ammiraglia. Lo strato di ragionamento continua a migliorare a un ritmo che si può tracciare. Lo strato di acquisizione — registrare un'ora senza perdere nulla, tenere distinti gli interlocutori, reggere una riunione che cambia lingua a metà frase — migliora su una curva completamente diversa e molto più lenta, e nessuna intelligenza di frontiera a valle compensa una cattiva trascrizione a monte.
In conclusione: alla frontiera è cresciuto un braccio, non una testa
GPT-6 Astra è un rilascio dal braccio lungo. Arriva molto più lontano in certi tipi di lavoro — pilotare un terminale, guidare un desktop, recuperare all'estremità di un milione di token, fare reverse engineering di un binario — mentre quella che di solito chiamiamo intelligenza è rimasta quasi ferma su ogni misura neutrale disponibile, compresa quella che OpenAI ha stampato di persona.
Non è una delusione. È anzi una forma più utile dell'alternativa, perché la capacità stretta arriva in produzione molto prima di quella generale. Ma significa che la domanda d'acquisto è cambiata. «È più intelligente?» ha ormai una risposta quasi priva di significato. «È migliore sul ciclo preciso che eseguo quaranta volte al giorno, e quel ciclo ora quanto dura?» ne ha una ottima.
Guardate il benchmark che somiglia al vostro lavoro. Ignorate il composito. E guardate l'orologio, non solo il punteggio.
Dove si inserisce Telli.sh: il divario che questo rilascio rende visibile — un ragionamento brillante appoggiato su ciò che lo strato di acquisizione gli ha consegnato — è esattamente il divario in cui costruiamo. Telli.sh registra la riunione, tiene distinti gli interlocutori, traduce dal vivo in 15 lingue e lascia appunti ancora ricercabili il trimestre prossimo. Instrada trascrizione, traduzione e sintesi attraverso uno strato di motori intercambiabili, così un rilascio come Astra arriva sotto forma di appunti migliori e non di progetto di migrazione. Nessun annuncio di modello di frontiera cambia la parte in cui qualcuno deve prima catturare quell'ora.
Avvia una nota tradotta dal vivo
Fonti
- OpenAI, «GPT-6 Astra: A new generation of intelligence», 3 settembre 2026 — tutte le tabelle di benchmark (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), la simulazione di latenza OSWorld, il dato Mind2Web di 1,9×, le note 1, 3, 4, 8, 9, 10, 11 e 12, la disponibilità e i risultati sugli intervalli tra numeri primi; consultato il 5 settembre 2026
- Documentazione per sviluppatori OpenAI, pagina del modello
gpt-6-astra— finestra di contesto, output massimo, taglio delle conoscenze, modalità, livelli direasoning.efforte prezzi standard, di cache e di scrittura in cache; consultato il 5 settembre 2026 - Documentazione per sviluppatori OpenAI, guida a migrazione e prompting «Using GPT-6 Astra» — requisito dell'API Responses per le chiamate a strumenti, parametri di campionamento rimossi, cautele sulla modalità Fast; consultato il 5 settembre 2026
- System card di GPT-6 Astra, OpenAI Deployment Safety Hub — soglia Critical in cybersicurezza nel Preparedness Framework, livello High in biologia e chimica, sotto High nell'auto-miglioramento dell'IA, robustezza ai jailbreak, la valutazione di fattualità e i suoi limiti dichiarati, e il calo di monitorabilità delle catene di pensiero; consultato il 5 settembre 2026
- Artificial Analysis, analisi di intelligenza, prestazioni e prezzo di GPT-6 Astra — punteggi dell'Intelligence Index v4.2, costo per attività dell'Intelligence Index, velocità di output di 87,5 token al secondo e tempo al primo token di 463,7 secondi; consultato il 5 settembre 2026
- Vellum, «GPT-6 Astra Benchmarks Explained» — riscontro incrociato delle tabelle su uso del computer, ambito accademico e contesto lungo, e l'asterisco su Humanity's Last Exam
- Emergent, «GPT-6 Astra Benchmarks: What the Numbers Actually Show» — la cautela sull'harness di ARC-AGI-3 e il confronto sull'Intelligence Index
- MindStudio, «GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?» — l'origine dei regressi riportati su GDPval, uso di strumenti bancari, contesto lungo e qualità delle presentazioni, che non abbiamo potuto verificare su fonte primaria
- Al Jazeera, «OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns», 4 settembre 2026 — tempi del rilascio e distribuzione a fasi
- 9to5Mac, «OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra», 4 settembre 2026 — l'ordine di distribuzione per piano dopo il giorno del lancio
- Il nostro commento sul rilascio stealth di GLM-5.3-Flash — l'altro capo della stessa curva, dove la capacità arriva a poco prezzo anziché a caro prezzo