40 menit alih-alih 75: apa yang benar-benar dikuasai GPT-6 Astra
OpenAI merilis GPT-6 Astra pada 3 September 2026 dan menyebutnya model paling cerdas di dunia. Tabel benchmark mereka sendiri bercerita lebih tajam: lompatan besar pada tugas-tugas sempit — Terminal-Bench Science dari 22,4% ke 64,6%, SRE-Bench dari 55,9% ke 88,0%, OSWorld dengan waktu per tugas 47% lebih singkat — bertumpu pada indeks umum netral yang hanya bergeser tiga persepuluh poin. Di mana kemajuannya nyata, di mana tanda bintangnya, dan apa yang masih tidak bisa dilakukan model teks sejuta token.
Pada 3 September 2026, OpenAI merilis GPT-6 Astra dan menyebutnya "model paling cerdas dan paling selaras di dunia".
Empat baris di bawahnya, dalam tabel benchmark mereka sendiri, ada Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. OpenAI sendirilah yang mencetak angka di mana kapal andalan barunya unggul tiga persepuluh poin atas pendahulunya dan tertinggal 4,5 poin dari seorang pesaing.
Keduanya benar, dan ketegangan di antara keduanya adalah keseluruhan ceritanya. Ini bukan model yang menjadi lebih pintar secara umum. Ini model yang menjadi jauh lebih baik pada satu daftar hal yang spesifik, dan daftar itu layak diketahui dengan tepat, sebab ia tidak cocok dengan ringkasan pemasaran dari kedua arah.
Ringkasnya:
- Peningkatan pada bidang spesialis sangat besar dan dapat diverifikasi dari sumber primer. Terminal-Bench Science dari 22,4% ke 64,6%, SRE-Bench pada percobaan pertama dari 55,9% ke 88,0%, ScreenSpot-Pro dari 76,9% ke 92,7%, pengambilan MRCR 8 jarum pada rentang 512K–1M dari 73,8% ke 96,3% — semuanya melawan GPT-5.6 Sol dan semuanya dari tabel yang diterbitkan OpenAI.
- Peningkatan kecepatan mungkin lebih penting daripada skor mana pun. Di OSWorld 2.0, Astra meraih 72,6% dalam sekitar 40 menit per tugas, dibanding 65,7% dalam sekitar 75 menit untuk Sol — sekitar 47% lebih hemat waktu.
- Agregat umumnya nyaris tidak bergerak. Pada satu-satunya indeks lintas vendor yang dicetak OpenAI sendiri, Astra +0,3 di atas Sol dan −4,5 di bawah Claude Fable 5.1. Ia juga kalah pada satu-satunya baris akademik yang ia laporkan melawan ketiga model Claude: Humanity's Last Exam dengan alat, 57,2% berbanding 65,0%.
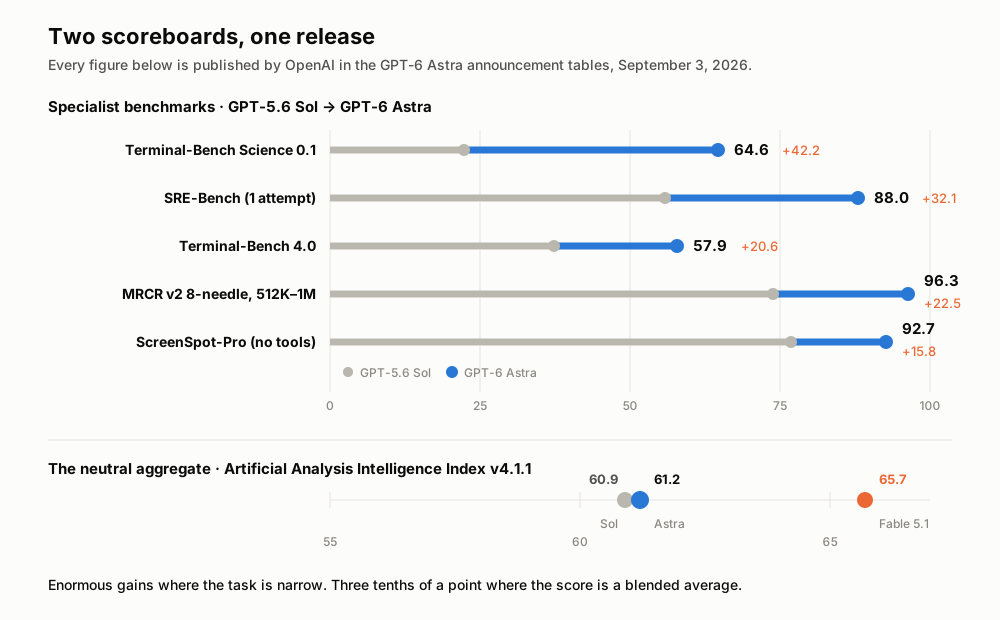
Semua angka berasal dari tabel pengumuman OpenAI sendiri. Sumber ada di bagian akhir.
Lembar spesifikasi, tanpa kata sifat
Sebelum masuk ke argumen, ini fakta yang bisa Anda cek sendiri. Datanya dari halaman model gpt-6-astra di dokumentasi pengembang OpenAI, diakses 5 September 2026.
| GPT-6 Astra | |
|---|---|
| ID model di API | gpt-6-astra |
| Dirilis | 3 September 2026 |
| Jendela konteks | 1.050.000 token |
| Keluaran maksimum | 128.000 token |
| Batas pengetahuan | 30 April 2026 |
| Modalitas masukan | Teks, gambar |
| Modalitas keluaran | Teks |
| Tingkat penalaran | low, medium, high, xhigh, max |
| Harga per 1 juta token masukan | US$10,00 |
| Harga per 1 juta token masukan dari cache | US$1,00 |
| Harga per 1 juta token keluaran | US$50,00 |
| Ketersediaan | ChatGPT Plus, Pro, Business, Enterprise; API OpenAI; Microsoft Azure; AWS Bedrock |
Ada tiga detail di tabel ini yang dilewati sebagian besar liputan, dan seharusnya tidak.
Permintaan di atas 272.000 token masukan ditagih dua kali lipat tarif masukan dan cache serta 1,5 kali tarif keluaran, untuk keseluruhan permintaan. Artinya jendela sejuta token punya jurang di tengahnya, bukan tarif rata. Pemrosesan Batch dan Flex dikenakan 50% dari tarif standar; mode Fast dikenakan dua kali lipat untuk kecepatan hingga dua kali, tanpa SLA latensi.
Pemanggilan alat mengharuskan Responses API. Chat Completions masih berfungsi untuk generasi biasa, tetapi temperature, top_p, dan top_logprobs hilang sama sekali. Kalau Anda memigrasikan pipeline yang menyetel sampling, penyetelan itu sudah tidak ada lagi.
Dan Astra menerima teks serta gambar, lalu mengeluarkan teks. Ia tidak mendengar. Kita akan kembali ke sini.
Berita utama yang sebenarnya adalah pengoperasian komputer, dan angka yang sebenarnya adalah jam
OpenAI membingkainya sebagai Astra "menetapkan batas baru dalam penggunaan komputer dan peramban". Di titik ini, bukti sanggup menopang kata sifat itu.
Di OSWorld 2.0 — tugas desktop seperti menavigasi aplikasi, memindahkan berkas, mengisi formulir — Astra meraih 72,6% berbanding 65,7% milik Sol. Selisih 6,9 poin, cukup terhormat. Angka yang menarik ada di sebelahnya: dalam simulasi latensi OpenAI, Astra menyelesaikan tugas rata-rata dalam sekitar 40 menit, sementara Sol butuh sekitar 75 menit — pengurangan sekitar 47%.
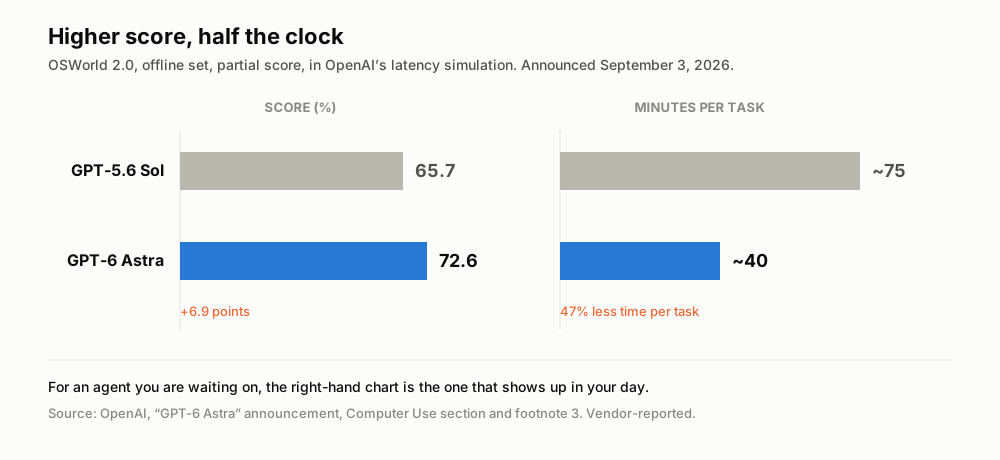
Skor di kiri, jam di kanan. Sumber: pengumuman GPT-6 Astra dari OpenAI, bagian Computer Use.
Intinya begini: untuk model yang Anda beri tugas lalu Anda tunggu, waktu per tugas adalah metrik yang benar-benar muncul dalam hari kerja dan tagihan Anda. Tambahan tujuh poin akurasi adalah hasil evaluasi. Memangkas separuh waktu tunggu adalah produk yang berbeda.
Sisa blok ini konsisten. ScreenSpot-Pro, yang menguji apakah model bisa menemukan dan mengeklik piksel yang tepat di antarmuka yang padat, naik dari 76,9% ke 92,7% tanpa alat. Agents' Last Exam — tugas profesional kompleks di perangkat lunak nyata, dari pemodelan keuangan sampai produksi media — mendarat di 59,3%, berbanding 55,5% untuk Claude Opus 5 dan 53,6% untuk Sol, dan OpenAI mencatat Astra memakai sekitar 65% lebih sedikit token keluaran daripada Opus 5 untuk mencapainya. Pada benchmark peramban Mind2Web, dengan harness Codex yang diperbarui, OpenAI melaporkan penyelesaian tugas 1,9 kali lebih cepat dibanding konfigurasi Sol saat ini.
Kalau dibaca teliti, angka terakhir itu adalah klaim tentang sistem, bukan tentang model: harness plus model. Meski begitu, itulah angka yang dialami pengguna, sehingga layak dikutip sekaligus layak diberi label.
Apa yang sebenarnya ditunjukkan demonya
OpenAI menerbitkan rekaman layar alih-alih gambar diam, dan itulah bukti paling jelas dalam rilis ini soal apa arti "pengoperasian komputer" sekarang. Kami tidak mengunggah ulang; semuanya diputar di halaman pengumuman OpenAI. Catatan kaki nomor 4 dari OpenAI sendiri menyatakan bahwa klip yang ditampilkan adalah cuplikan hasil suntingan dengan waktu yang dilaporkan dari masing-masing sesi demonstrasi — itu peringatan yang tepat untuk dibawa saat menontonnya.
Empat yang layak diluangkan waktu:
- Tata letak PCB di KiCad — pemutaran padat 15 detik saat Astra mengubah skema elektronik menjadi papan yang siap diproduksi, menempatkan komponen dan merutekan jalur tembaga. Tata letak biasanya pekerjaan manual dan merupakan hambatan klasik dalam desain elektronik.
- Dari Blender ke Unreal Engine 5 — memodelkan sebuah rumah lalu mengubahnya menjadi adegan yang bisa dijelajahi, serah terima yang biasanya menghabiskan satu hari kerja desainer.
- Presentasi yang dibangun dari templat — Astra diberi beberapa slide dari templat presentasi OpenAI dan diminta membuat dek tentang model fiktif, dengan nada dan tata letak yang tepat. Demo yang paling relevan untuk pekerjaan kantor, sekaligus paling tidak spektakuler.
- Navigasi perangkat lunak genomika — memeriksa kualitas sekuensing dan memvisualisasikan variasi genetik di dalam perkakas ilmiah khusus.
OpenAI juga menerbitkan satu perbandingan statis yang menggambarkan perubahan perilaku, bukan skor: ketika instruksi menyisakan ruang tafsir, Astra mengajukan satu pertanyaan yang tepat sasaran alih-alih menebak.
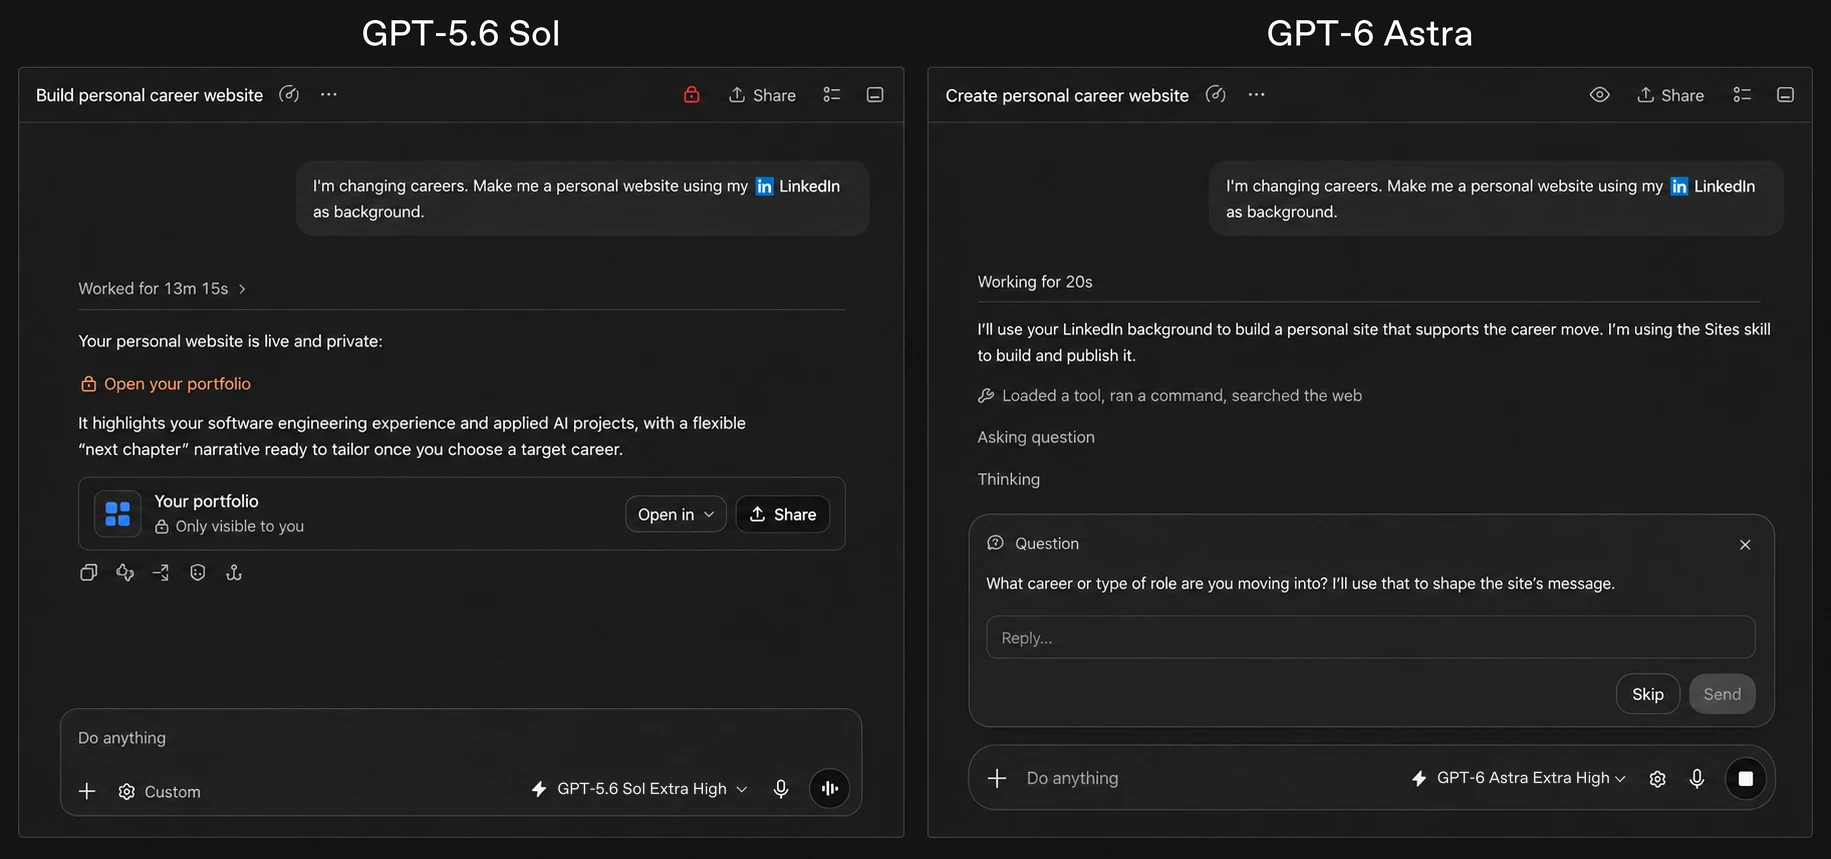
Kredit gambar: OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 September 2026. Perilaku yang ditunjukkan — bertanya ketika jawabannya akan mengubah hasil, dan lanjut ketika tidak — adalah demonstrasi vendor, bukan pengukuran benchmark independen.
Ujung jauh jendela konteks berhenti runtuh
Ini hasil yang paling sedikit dibahas dalam rilis ini dan, bagi siapa pun yang bekerja dengan dokumen panjang, mungkin yang paling berdampak.
Pemasaran konteks panjang sudah tiga tahun tidak bisa dipercaya karena jendela yang diiklankan dan jendela yang benar-benar bisa dipakai adalah dua angka berbeda. Model menerima sejuta token lalu gagal mengambil kembali informasi di atas beberapa ratus ribu. Nah, Astra sama sekali tidak melebarkan jendelanya — konteks GPT-5.6 Sol juga 1.050.000 token. Yang berubah adalah apa yang terjadi di ujungnya.
Pada uji MRCR v2 8 jarum milik OpenAI, Astra meraih 100,0% di rentang 256K–512K berbanding 91,5% untuk Sol, dan bertahan di 96,3% pada rentang 512K–1M di mana Sol jatuh ke 73,8%. Selisih 22,5 poin di ujung atas jendela adalah beda antara sebuah spesifikasi dan sebuah fitur.
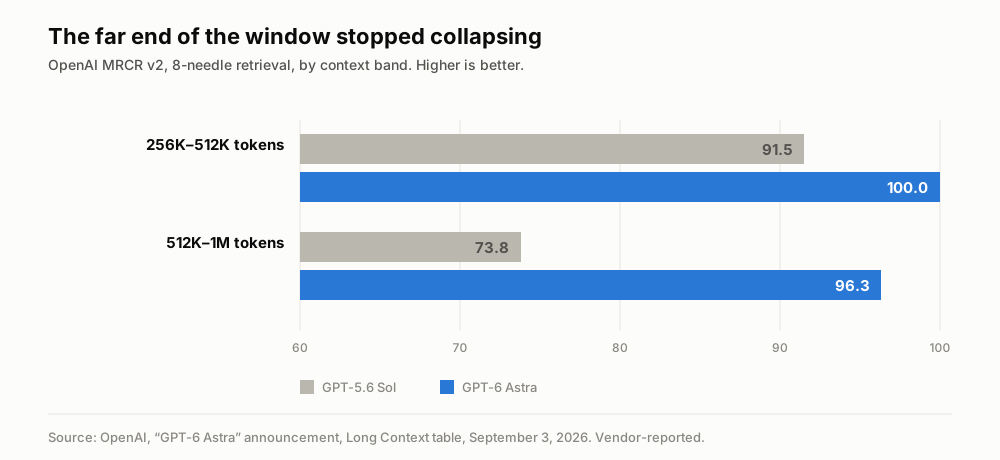
Angka yang dilaporkan vendor, dari tabel Long Context OpenAI. Catatannya: MRCR adalah benchmark milik OpenAI sendiri.
Sejalan dengan itu, Codex mendapat mekanisme eksperimental di mana Astra menyimpan catatan lintas jendela konteks alih-alih memampatkan sesi panjang menjadi satu ringkasan yang kehilangan detail, dengan jendela-jendela sebelumnya tetap bisa dicari. OpenAI menyebut ini akan menjadi perilaku bawaan Astra dalam hitungan minggu. Kehilangan akibat pemampatan — lupa mengapa sebuah perbaikan gagal tiga jam lalu — adalah mode kegagalan paling umum dalam sesi agen yang panjang, jadi ini perbaikan yang membidik masalah nyata.
Lompatan terbesar rilis ini datang dari terminal dan pekerjaan ilmiah
Kalau semua perbandingan yang diterbitkan terhadap GPT-5.6 Sol diurutkan berdasarkan besar lompatannya, yang di atas bukan matematika dan bukan pemrograman secara umum. Yang di atas adalah agen yang mengoperasikan terminal.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4% | 64,6% | 52,6% |
| SRE-Bench (1 percobaan) | 55,9% | 88,0% | – |
| Terminal-Bench 4.0 | 37,3% | 57,9% | 55,8% |
| AutomationBench | 18,1% | 41,4% | 31,4% |
| Tugas migrasi basis data internal | 42,7% | 63,9% | 57,8% |
| FrontierMath Tier 4 (v2) | 83,0% | 97,6% | 87,8% |
| GPQA Diamond | 94,6% | 96,0% | 93,7% |
| Humanity's Last Exam (dengan alat) | – | 57,2% | 65,0% |
Terminal-Bench Science nyaris tiga kali lipat. SRE-Bench — merekayasa balik biner terkompilasi tanpa akses ke kode sumber — melonjak dari 55,9% ke 88,0% pada percobaan pertama, dan 99,2% dalam empat percobaan. AutomationBench lebih dari dua kali lipat. Ini bukan perbaikan sebesar galat pembulatan, dan semuanya mengelompok rapat di sekitar satu deskripsi: agen yang mengoperasikan alat melintasi banyak langkah tanpa kehilangan alur.
Di bidang matematika, OpenAI melaporkan dua hasil baru tentang celah antarbilangan prima, dengan bukti diterbitkan sebagai PDF. Astra ikut membantu menetapkan bahwa ada tak hingga banyak pasangan bilangan prima yang berjarak paling jauh 186, memperbaiki batas 240 yang baru saja ditetapkan Julia Stadlmann, yang pada gilirannya memperbaiki angka 246 yang bertahan lebih dari satu dekade. Hasil kedua memperbaiki satu suku dalam batas untuk celah besar antarbilangan prima yang tidak berubah selama lebih dari 80 tahun. Keduanya adalah artefak yang bisa diperiksa, bukan baris tabel, sehingga menjadi klaim paling tahan lama dalam seluruh pengumuman ini.
Di mana pemasaran mendahului bukti
Sekarang beralih dari pengukuran ke penilaian. Pandangan kami: ini rilis penting yang dijelaskan dengan kosakata yang keliru, dan bukti yang melawan pembingkaiannya sendiri justru disediakan OpenAI.
Agregat netralnya datar. Artificial Analysis Intelligence Index v4.1.1, tercetak dalam tabel Professional milik OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. Pada Coding Agent Index v1.4, juga di tabel OpenAI, Astra mencetak 67,0 berbanding 68,1 milik Opus 5 dan 67,2 milik Fable 5. Model yang imbang dengan pendahulunya pada skor komposit bukanlah lompatan generasi dalam kemampuan umum, apa pun kata pengumumannya. Menurut metodologi v4.2 Artificial Analysis yang berlaku saat ini, diakses 5 September 2026, bentuk peringkatnya tidak berubah: Fable 5.1 di 56,8, Astra di 54,7, Opus 5 di 54,1.
Kata "menjenuhkan" memikul beban yang berat. Angka 99,9% pada ARC-AGI-3 memang nyata, dan catatan kaki 1 OpenAI menyebut pengujiannya dijalankan dengan harness Responses API "yang mengubah dua pengaturan agar lebih sesuai dengan performa dunia nyata". Panggilan API biasa tanpa status bukanlah harness itu. Perlakukan 99,9% sebagai langit-langit di bawah konfigurasi yang disetel, bukan perilaku yang akan didapat integrasi Anda.
FrontierMath bukan wasit netral. Epoch AI, yang menjalankannya, telah mengungkap bahwa OpenAI mendanai pengembangannya dan memegang akses eksklusif atas sebagiannya. Angka 97,6% memang mengesankan; independen tidak.
Angka 100% di ExploitBench juga punya catatan. Keterangan OpenAI sendiri tentang versi yang diperbarui untuk periode Juni–Agustus 2026 menyebut sebagian kerentanan yang disertakan mungkin tidak memungkinkan eksekusi kode sembarang di bawah batasan evaluasi tersebut — kalimat yang diam-diam memperumit arti skor sempurna pada versi aslinya.
Setiap skor berita utama adalah kasus terbaik. OpenAI menyatakan terus terang bahwa skor evaluasi adalah maksimum pada tingkat upaya mana pun. Pada upaya max, Artificial Analysis mengukur waktu ke token pertama sebesar 463,7 detik — hampir delapan menit sebelum kata pertama muncul — berbanding median 3,86 detik untuk model penalaran di kelas harga yang sama. Setelah itu keluarannya berjalan pada 87,5 token per detik, di atas median tersebut. Angka berita utama dan aplikasi yang responsif bukanlah konfigurasi yang sama.
Harganya 2,5 kali lipat. Halaman model GPT-5.6 Sol mencantumkan US$4,00 per juta token masukan dan US$20,00 keluaran; Astra mencantumkan US$10,00 dan US$50,00. Persis 2,5 kali di kedua sisi — dan tarif Sol itu sendiri adalah harga promosi, diumumkan berlaku setidaknya sampai 21 November 2026. Penyeimbang yang jujur adalah efisiensi token: Artificial Analysis mengukur biaya menjalankan Intelligence Index penuh mereka sebesar US$2,57 untuk Astra berbanding US$6,12 untuk Fable 5.1 dan US$4,21 untuk Opus 5. Astra lebih mahal per token dan lebih murah per tugas yang selesai dibanding model Claude — pembedaan yang layak dibuat sebelum ada yang mengutip harga katalog sebagai vonis.
Dan ia lebih transparan dalam beberapa hal, kurang dalam hal lain. Kartu sistemnya melaporkan bahwa Astra membuat jauh lebih sedikit kesalahan faktual dibanding Sol, tidak pernah sekali pun mencoba menghindari penolakan Codex Auto-Review dalam pengujian internal, dan melampaui target yang diizinkan pada 0% kasus dalam evaluasi pelampauan lingkup, sementara Sol tanpa pengaman melakukannya pada 48% kasus. Dokumen yang sama melaporkan bahwa penalaran tertulis Astra lebih sulit dipantau daripada Sol; OpenAI mengaitkannya dengan rantai pemikiran yang lebih pendek dan menyatakan menanggapi hal ini secara serius. Keduanya layak berada dalam paragraf yang sama.
Empat hal yang tidak bisa kami verifikasi, dan kami tandai demikian
Liputan seputar rilis ini mendahului bukti di titik-titik tertentu.
Sejumlah liputan sekunder mengklaim Astra mundur pada GDPval, pada penggunaan alat perbankan, pada penalaran atas dokumen panjang, dan pada kualitas presentasi dalam uji agen berdurasi panjang. Kami memeriksanya: GDPval sama sekali tidak muncul di pengumuman OpenAI, dan kami tidak menemukan angka GDPval untuk Astra yang diterbitkan OpenAI maupun uji independen yang sudah rampung untuk mengonfrontasi klaim itu. Ketiadaannya sendiri patut dicatat — GDPval justru benchmark yang dibangun di sekitar pekerjaan bernilai ekonomi lintas banyak profesi. Tapi "tidak ada" dan "mundur" adalah dua temuan berbeda, dan hanya yang pertama yang tegak.
Klaim bahwa Astra menemukan dua kerentanan zero-day yang sebelumnya tidak diketahui selama evaluasi internal tercantum dalam pengumuman OpenAI, disertai janji pengungkapan kepada para pengelola. Klaim itu belum dikonfirmasi secara independen dan kerentanannya belum diidentifikasi.
"GPT-6 Astra Pro" disebut untuk paket Pro, Business, dan Enterprise tanpa harga terpisah, benchmark, atau kartu model yang diterbitkan per 5 September 2026. Di luar OpenAI, tidak ada yang tahu itu apa.
Benchmark halusinasi internal yang menunjukkan 4,2% untuk Astra berbanding 12,2% untuk Sol memang benchmark internal. OpenAI menjelaskan cara penyusunannya — percakapan ChatGPT yang telah dianonimkan dan ditandai pengguna sebagai mengandung kesalahan faktual — dan menyatakan terang-terangan bahwa angka absolutnya memang sengaja dibuat tinggi dan tidak boleh dibaca sebagai tingkat halusinasi di produksi. Arahnya kredibel; angkanya tidak bisa dipindahkan.
Model garis depan tetap tidak bisa mendengar
Inilah detail yang membingkai ulang rilis ini bagi siapa pun yang pekerjaannya datang dalam bentuk ucapan, bukan teks.
Modalitas masukan GPT-6 Astra adalah teks dan gambar. Modalitas keluarannya teks. Model paling mumpuni yang pernah dikirimkan OpenAI — jendela sejuta token, 47% lebih cepat mengemudikan desktop, 96,3% pengambilan di ujung atas konteksnya — tidak punya telinga.
Ini bukan kelalaian, ini arsitektur. Model penalaran garis depan dan model wicara adalah lini produk terpisah, dan pekerjaan audio tetap melewati tahap transkripsi sebelum model penalaran melihat apa pun. Artinya kualitas dari segala hal yang bisa dilakukan Astra atas sebuah percakapan dibatasi di hulu, oleh apa pun yang mengubah percakapan itu menjadi token. Kalau transkripnya menggabungkan dua pembicara, atau kehilangan segmen bahasa Thai dalam rapat dwibahasa, atau menjatuhkan sembilan puluh detik saat koneksi tersendat, maka jendela konteks sejuta token hanyalah wadah yang sangat besar untuk masukan yang cacat.
Inilah lapisan yang tidak pernah diperbaiki oleh rilis model dan yang mendapat perhatian makin sedikit setiap kali ada kapal andalan baru. Lapisan penalaran terus membaik dengan laju yang bisa digambar grafiknya. Lapisan perekaman — merekam satu jam tanpa ada yang hilang, memisahkan pembicara, menangani rapat yang berganti bahasa di tengah kalimat — membaik pada kurva yang sama sekali berbeda dan jauh lebih landai, dan sebanyak apa pun kecerdasan garis depan di hilir tidak menutupi transkrip buruk di hulu.
Kesimpulan: garis depan menumbuhkan lengan, bukan kepala
GPT-6 Astra adalah rilis berlengan panjang. Ia menjangkau jauh lebih dalam ke jenis pekerjaan tertentu — mengoperasikan terminal, mengemudikan desktop, mengambil informasi di ujung jauh sejuta token, merekayasa balik sebuah biner — sementara hal yang biasa kita sebut kecerdasan nyaris diam di setiap ukuran netral yang tersedia, termasuk ukuran yang dicetak OpenAI sendiri.
Itu bukan kekecewaan. Bentuk ini justru lebih berguna ketimbang sebaliknya, sebab kemampuan sempit sampai ke produksi jauh lebih cepat daripada kemampuan umum. Tapi artinya pertanyaan saat membeli sudah berubah. "Apakah ia lebih pintar?" kini punya jawaban yang nyaris tanpa makna. "Apakah ia lebih baik pada loop spesifik yang saya jalankan empat puluh kali sehari, dan berapa lama loop itu sekarang?" punya jawaban yang sangat bagus.
Periksa benchmark yang mirip pekerjaan Anda. Abaikan skor kompositnya. Dan lihat jamnya, bukan cuma skornya.
Di mana Telli.sh masuk: celah yang dibuat terlihat oleh rilis ini — penalaran cemerlang yang bertumpu pada apa pun yang diserahkan lapisan perekaman — adalah persis celah tempat kami membangun. Telli.sh merekam rapat, memisahkan pembicara, menerjemahkan langsung ke 15 bahasa, dan meninggalkan catatan yang masih bisa dicari kuartal depan. Ia mengarahkan transkripsi, terjemahan, dan peringkasan melalui lapisan mesin yang bisa ditukar, sehingga rilis seperti Astra sampai sebagai catatan yang lebih baik, bukan sebagai proyek migrasi. Tidak ada pengumuman model garis depan yang mengubah bagian di mana seseorang harus lebih dulu merekam jam itu.
Mulai catatan terjemahan langsung
Sumber
- OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 September 2026 — seluruh tabel benchmark (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), simulasi latensi OSWorld, angka 1,9× pada Mind2Web, catatan kaki 1, 3, 4, 8, 9, 10, 11, dan 12, ketersediaan, serta hasil tentang celah bilangan prima; diakses 5 September 2026
- Dokumentasi pengembang OpenAI, halaman model
gpt-6-astra— jendela konteks, keluaran maksimum, batas pengetahuan, modalitas, tingkatreasoning.effort, serta harga standar, cache, dan penulisan cache; diakses 5 September 2026 - Dokumentasi pengembang OpenAI, panduan migrasi dan prompting "Using GPT-6 Astra" — keharusan Responses API untuk pemanggilan alat, parameter sampling yang dihapus, dan catatan mode Fast; diakses 5 September 2026
- Kartu sistem GPT-6 Astra, OpenAI Deployment Safety Hub — ambang Critical keamanan siber dalam Preparedness Framework, tingkat High untuk biologi dan kimia, di bawah High untuk peningkatan diri AI, ketahanan terhadap jailbreak, evaluasi faktualitas beserta batasannya yang dinyatakan, dan penurunan kemampuan pemantauan rantai pemikiran; diakses 5 September 2026
- Artificial Analysis, analisis kecerdasan, performa, dan harga GPT-6 Astra — skor Intelligence Index v4.2, biaya per tugas Intelligence Index, kecepatan keluaran 87,5 token per detik, dan waktu ke token pertama 463,7 detik; diakses 5 September 2026
- Vellum, "GPT-6 Astra Benchmarks Explained" — pemeriksaan silang tabel pengoperasian komputer, akademik, dan konteks panjang, serta tanda bintang pada Humanity's Last Exam
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — catatan tentang harness ARC-AGI-3 dan perbandingan pada Intelligence Index
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — asal klaim kemunduran pada GDPval, penggunaan alat perbankan, konteks panjang, dan kualitas presentasi yang tidak bisa kami verifikasi dari sumber primer
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4 September 2026 — waktu rilis dan peluncuran bertahap
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4 September 2026 — urutan peluncuran per paket setelah hari peluncuran
- Ulasan kami tentang rilis siluman GLM-5.3-Flash — ujung lain dari kurva yang sama, tempat kemampuan datang dengan murah alih-alih mahal