GPT-6.1 Terra kostet 1 Dollar je Million Eingabetokens. Was kostet eine erledigte Aufgabe?
OpenAIs GPT-6.1 Terra senkt die Standardpreise für visuelles Schlussfolgern und Computerbedienung. Ein praktischer Leitfaden zu abgeschlossener Arbeit, Wiederholungen, Prüfung und der Integration hinter dem Modell.
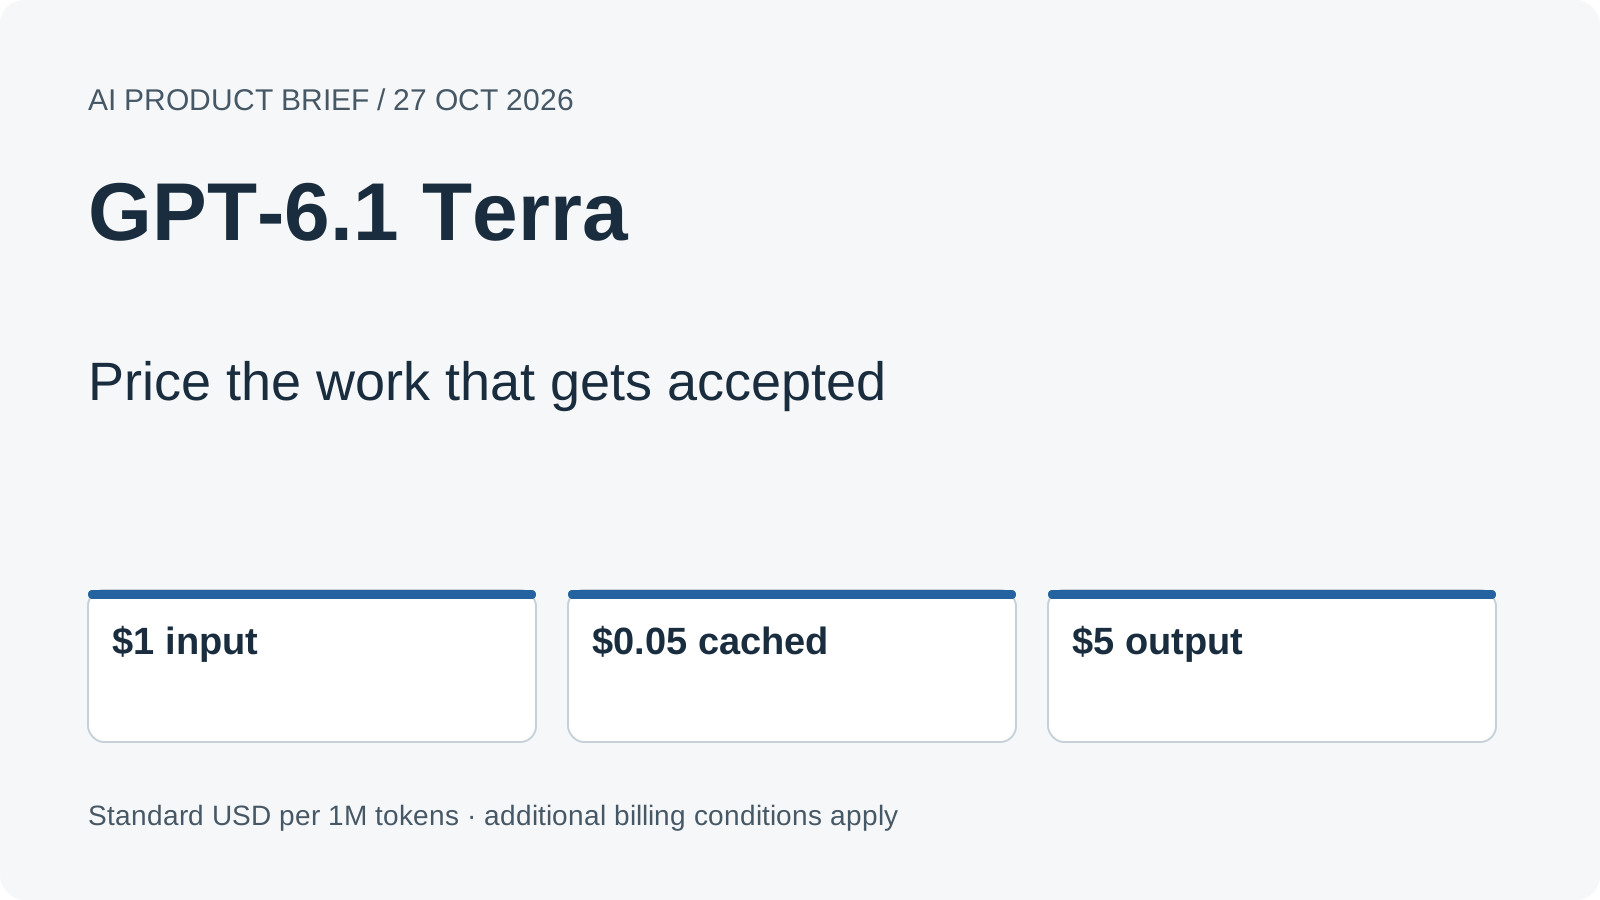
Eigene redaktionelle Grafik von Ken Jo auf Grundlage der unten aufgeführten Quellen.
Auf einer Bildschirmseite steht eine Rechnung, auf der anderen ein Buchhaltungsformular. Den Betrag zu lesen ist eine Aufgabe. Den richtigen Lieferanten zu wählen, die Währung einzutragen und zu erkennen, dass der gespeicherte Datensatz wirklich existiert, ist eine größere. Besonders wichtig wird dieser Unterschied, wenn ein KI-Modell klickt.
OpenAI stellte GPT-6.1 Terra am 26. Oktober 2026 vor. Die Standard-API-Preise betragen 1 Dollar je Million Eingabetokens, 0,05 Dollar je Million zwischengespeicherter Eingabetokens und 5 Dollar je Million Ausgabetokens. Das Unternehmen positioniert das Modell für visuelles Schlussfolgern, Computerbedienung und Schreiben. Die Standardtarife liegen laut OpenAI 50 % unter GPT-5.6 Terra und GPT-6.1 Sol. Offizielle Ankündigung, datierte System Card.
Niedrigere Preise machen mehr Versuche bezahlbar. Welche davon zu einem Arbeitsablauf werden sollten, verlangt eine andere Kennzahl: die Kosten eines akzeptablen Ergebnisses. Dieser Leitfaden betrachtet drei Anwendungen, rechnet ein transparentes Beispiel durch und zeigt eine Evaluation, die erfolgreiche Toolaufrufe von erledigter Arbeit unterscheidet.
Das Modell wählt eine Aktion im ausführenden System
Terra ist ein Modell von OpenAI, dem Unternehmen hinter ChatGPT und Codex. Seine Auswahl gibt einer Anwendung bestimmte sprachliche und visuelle Fähigkeiten. Die umgebende Anwendung entscheidet weiterhin, welchen Bildschirm es sieht, welche Tools es aufruft und auf welche Konten diese zugreifen.
Nehmen wir den Rechnungsfall als beispielhaften Ablauf. Das Modell sieht ein Formular, schlägt eine Aktion vor und bekommt nach ihrer Ausführung eine aktualisierte Ansicht. Diese ist entscheidend: Ein scheinbar richtiger Klick kann ein anderes Panel öffnen, einen Validierungsfehler zeigen oder einen Speichervorgang unvollendet lassen. Vor dem nächsten Schritt muss der resultierende Zustand erkannt werden.
Computerbedienung ist deshalb eine Schleife statt einer einzelnen Antwort. Eine brauchbare Integration verbindet Beobachtung, Handlung und Zustandsprüfung. Sie legt außerdem fest, wann angehalten, ein Mensch gefragt oder fehlende Eingabe gemeldet wird. Das gehört zum Anwendungsentwurf, auch wenn das Modell Bildschirme gut interpretiert.
OpenAIs Dokumentation zur Computerbedienung, geprüft am 27. Oktober, unterscheidet Browseraktivitätsereignisse vom abschließenden Status eines gesamten Turns. Sie bietet außerdem Einstellungen für Screenshots in gestreamten Ausgaben. Entwickler können damit Fortschritt sichtbar machen und separat überprüfen, ob das verlangte Ergebnis existiert.
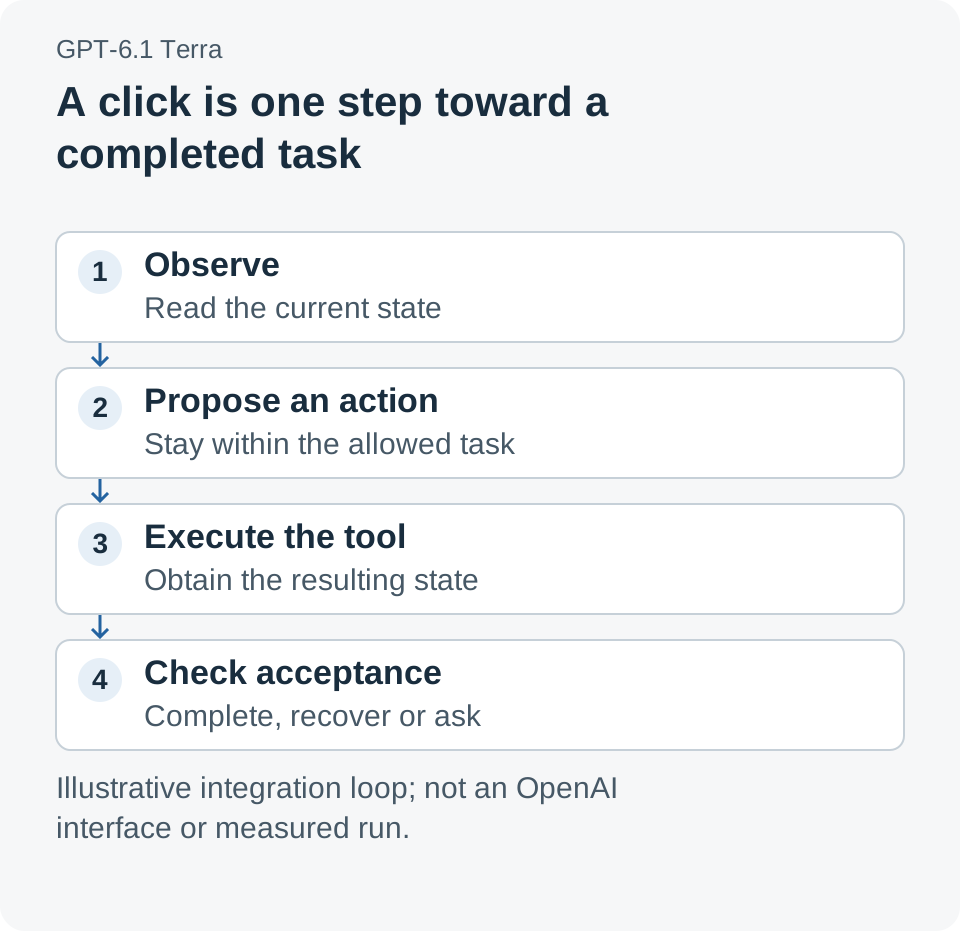
Beispielhafte Schleife der Computerbedienung. Die Anwendung liefert Tools und Berechtigungen; die Abnahme prüft, ob die Arbeit erledigt ist. Eigene Erklärung, kein Screenshot einer OpenAI-Oberfläche.
Die Preisliste ist der Anfang eines Aufgabenbudgets
Die Standardtarife vom 26. Oktober lassen sich einfach vergleichen, sofern dieselben Abrechnungsbedingungen gelten. Eingabe und Ausgabe kosten unterschiedlich viel, zwischengespeicherte Eingaben bilden eine eigene Kategorie. Lange Antworten oder wiederholte Beobachtungsschleifen verändern daher die Rechnung bei gleicher Anzahl von Nutzeranfragen.
| Tokenkategorie | Standardpreis je 1 Million Tokens | Im Versuch messen |
|---|---|---|
| Eingabe | $1.00 | Abgerechnete Eingabe über sämtliche Versuche |
| Zwischengespeicherte Eingabe | $0.05 | Tatsächliche Cachetreffer statt angenommener Wiederverwendung |
| Ausgabe | $5.00 | Gesamte abgerechnete Ausgabe des Laufs |
Die Model Card, geprüft am 27. Oktober, nennt weitere Bedingungen. Cache-Schreibvorgänge haben eigene Tarife, Prompts mit mehr als 272.000 Eingabetokens lösen Langkontextanpassungen aus, und Servicemodi können Preise verändern. Verwenden Sie den passenden Tarif der tatsächlichen Anfrage, statt den kleinsten Tabellenwert als allgemeinen Preis anzunehmen.
Im folgenden Rechenbeispiel gelten Standardverarbeitung, keine Cachenutzung und Anfragen unterhalb der Langkontextgrenze. Jeder Versuch verbraucht 10.000 abrechenbare Eingabe- und 1.000 Ausgabetokens. Daraus folgen $0.01 + $0.005 = $0.015 je Versuch. Die Tokenmengen sind gewählte Rechenannahmen, keine Messung von Terra oder eines Rechnungsablaufs.
Diese Unterscheidung bildet ein brauchbares Budget. Bestimmen Sie zunächst die Rechnung eines Versuchs unter ausdrücklichen Annahmen. Fragen Sie dann nach nötigen Versuchen, weiteren Diensten und dem Prüfaufwand bis zur Annahme des Ergebnisses.
Wiederholungen und Prüfung verändern die Kosten akzeptierter Arbeit
Eine hypothetische Charge umfasst 100 angeforderte Aufgaben. In einem Szenario gibt es 100 Versuche und 90 akzeptierte Ergebnisse. In einem anderen erhöht Fehlerbehebung die Zahl auf 150 Versuche und 95 akzeptierte Ergebnisse. Der zusätzliche Erfolg ist nützlich, verändert aber den Kostenvergleich.
Ein drittes Szenario ergänzt menschliche Prüfung: 30 Elemente werden je 20 Sekunden zu angenommenen 30 Dollar pro Stunde geprüft. Das sind 600 Sekunden beziehungsweise zehn Minuten und kosten 5 Dollar. Alle Mengen, Annahmezahlen und Lohnannahmen sind illustrativ; keine beschreibt gemessene Produktleistung.
| Beispielcharge | Tokenkosten | Prüfkosten | Akzeptierte Aufgaben | Kosten je akzeptierter Aufgabe |
|---|---|---|---|---|
| 100 Versuche | $1.50 | $0.00 | 90 | $0.0167 |
| 150 Versuche | $2.25 | $0.00 | 95 | $0.0237 |
| 150 Versuche plus genannte Prüfung | $2.25 | $5.00 | 95 | $0.0763 |
Der Nenner sind akzeptierte Aufgaben, nicht erzeugte Antworten. Eine elegante Abschlussmeldung erhöht ihn nicht, wenn der Datensatz falsch gespeichert wurde. Umgekehrt kann eine kurze Rückfrage ein nützlicheres Ergebnis liefern als selbstsicheres Fortfahren mit fehlenden Angaben.
Nennen wir den zusätzlichen Aufwand die Abschlussrechnung: alle Ressourcen, die aus einem Handlungsversuch ein akzeptiertes Ergebnis machen. Tokenpreise sind ein Posten; Tools, Ausführungsumgebung, Wiederherstellung und menschliche Prüfung können hinzukommen. Die Tabelle lässt weitere Dienste weg, damit die Rechnung sichtbar bleibt. Eine Produktionsschätzung muss die tatsächlich eingesetzten Dienste einbeziehen.
Unsere Einschätzung: Der wertvollste Effekt günstigerer Modelle ist mehr Spielraum für besseren Abschluss. Teams können Anweisungen vergleichen, Fehler untersuchen und Wiederherstellungswege testen. Eine ungeprüfte Antwort billiger zu machen hilft weniger, als die Ersparnis für Arbeit mit geringerem Reparaturbedarf zu nutzen.
Mit einem Rechnungsentwurf und klarer Ziellinie beginnen
Das erste Szenario ist ein Kreditorenassistent, der aus einer Rechnung einen Entwurf vorbereitet. Nutzen Sie ein Testkonto und eine begrenzte Dokumentauswahl. Definieren Sie Lieferant, Währung, Betrag und Referenzfelder, bevor das Modell mit dem Formular interagiert.
Akzeptabel ist hier ein gespeicherter Entwurf mit quellentreuen Feldern und abrufbarer Datensatzkennung. Der Klick auf Speichern ist ein Zwischenereignis. Der Ablauf sollte den gespeicherten Datensatz oder Bestätigungszustand prüfen und offene Felder melden, statt plausible Werte zu erraten.
Der Versuch braucht gewöhnliche und absichtlich schwierige Dokumente: unklare Währung, fehlende Lieferantenkennung oder bereits vorhandene Rechnungsnummer. Das sind unterschiedliche Fehlerarten. Richtiges Lesen, richtige Kontenauswahl und Vermeidung von Duplikaten sind getrennte Aufgabenbestandteile.
Halten Sie den Versuch klein genug, um jedes Ergebnis zu prüfen. Suchen Sie bei Fehlern nach der ersten falschen Beobachtung oder Aktion, statt sofort die gesamte Anweisung umzuschreiben. Eine engere Diagnose zeigt, ob das Problem in Dokumentverständnis, Navigation, Kontodaten oder Abnahme liegt.
Dies ist ein Beispiel für Anwendungsdesign. Es behauptet weder, Terra liefere einen Buchhaltungsconnector, noch dass ein bestimmtes Buchhaltungsprodukt getestet wurde. Das Modell ist eine Komponente; Tools und Geschäftsregeln müssen bereitgestellt werden.
Katalogzuordnung prüft visuelle Urteile vor einer Handlung
Das zweite Szenario ordnet ein Produktfoto einem vorhandenen Katalogeintrag zu. OpenAIs am 27. Oktober eingesehene Model Card nennt Produktfotozuordnung ausdrücklich als vorgesehenen Einsatz. Für Händler wäre ein Vorschlag mit genügend Informationen nützlich, um bloße Ähnlichkeit vom richtigen Artikel zu unterscheiden.
Erstellen Sie einen kleinen Satz mit einfachen Treffern, ähnlichen Verpackungen und Fotos mit fehlenden Details. Bewahren Sie erwartete Katalogkennungen außerhalb der Modellanweisungen auf. Verlangen Sie vorgeschlagene Kennung und sichtbare Merkmale als Begründung sowie eine ausdrückliche Option „ungeklärt“, wenn das Bild nicht genügt.
Ein ungeklärtes Ergebnis kann richtig sein. Unterscheiden sich zwei Packungen nur durch unsichtbare Angaben, braucht es ein weiteres Foto oder eine nichtvisuelle Kennung. Eine flüssige Beschreibung kann keine fehlenden Belege schaffen.
Beginnen Sie mit Vorschlägen, bevor Katalogänderungen erlaubt werden. So lässt sich die Abnahmeregel leichter prüfen, und das Team erhält verständliche Fehlerbeispiele. Kommt später ein Schreibschritt hinzu, prüfen Sie, ob der Entwurf bestätigte Katalogfakten erhält, statt unbestätigte Details aus Ähnlichkeiten zu übernehmen.
Ein altes Portal macht Wiederherstellung zum Teil der Aufgabe
Das dritte Szenario bereitet eine Entwurfsänderung in einem internen Browserportal vor. Die Aufgabe könnte sein, einen Datensatz zu finden, eine vorgegebene Beschreibung zu ändern und ihn zur menschlichen Freigabe bereitzustellen. Der Nutzen liegt in der Verbindung einer verständlichen Geschäftsanforderung mit einer Folge von Oberflächenaktionen.
Schwierige Fälle betreffen oft den Zustand. Eine Sitzung läuft ab, ein Pflichtfeld erscheint erst nach einer Auswahl oder eine Seite aktualisiert langsamer als erwartet. Eine nützliche Evaluation erfasst Reaktionen auf solche Fälle, nicht nur den einfachsten Navigationsweg.
Definieren Sie vorab ein Wiederherstellungsbudget. Beispielsweise darf die Anwendung nach unklarem Speichern einmal erneut beobachten und dann zur Prüfung anhalten, wenn das Ergebnis offen bleibt. Das ist eine illustrative Richtlinie, keine Terra-Produktgrenze. Sie schafft begrenztes, testbares Verhalten und verhindert ressourcenverbrauchende Endlosschleifen.
Unterscheiden Sie außerdem Integrations- und Modellfehler. Ein unerreichbares Ziel, ein Konto ohne Schreibrecht und die Auswahl des falschen Steuerelements benötigen andere Reparaturen. Diese Kategorien machen Kostenschätzungen und Qualitätsverbesserungen aussagekräftiger.
Verfügbarkeit zeigt den Einstieg, nicht die Rechte jedes Kontos
Die Ankündigung vom 26. Oktober nennt Terra in ChatGPT Work und Codex für Plus, Pro, Enterprise und Edu sowie die API-Kennung gpt-6.1-terra. Das sind Zugänge zum Modell. Welche Tools und Rechte ein konkreter Ablauf besitzt, hängt weiterhin von Produkt, Konto und Integration ab.
Für Entwickler nennt die am 27. Oktober eingesehene Model Card die Responses API für Toolaufrufe und medium als standardmäßigen Reasoning-Aufwand. Erfassen Sie Modell und Konfiguration, damit Versuchsläufe vergleichbar sind. Gleichzeitige Änderungen an Modell, Anweisung und Umgebung erschweren die Deutung unterschiedlicher Ergebnisse.
In Work oder Codex beginnen Sie mit einem bereits unterstützten Ablauf und seinen tatsächlichen Bedienelementen. Für eine eigene Anwendung verwenden Sie die aktuelle Dokumentation zur Computerbedienung, um Umgebung und erlaubte Aktionen einzurichten. Die Modellkennung allein stellt keine authentifizierte Verbindung zu Unternehmensanwendungen her.
Konfigurationen an denselben akzeptierten Aufgaben vergleichen
Ein guter erster Versuch ist klein genug zur Prüfung und vielfältig genug für reale Bedingungen. Legen Sie die Abnahme fest, bevor Ergebnisse vorliegen. Das folgende Verfahren ist ein Evaluationsvorschlag, kein Benchmarkresultat.
- Wählen Sie eine begrenzte Aufgabe. Benennen Sie Ergebnis und entscheidende Person. Bevorzugen Sie zunächst einen Entwurf oder eine Testumgebung.
- Bereiten Sie feste Fälle vor. Berücksichtigen Sie normale Eingaben, fehlende Angaben und passende Oberflächenunterbrechungen. Erwartete Ergebnisse bleiben außerhalb der Modellanweisung.
- Erfassen Sie die Konfiguration. Speichern Sie Modellkennung, Reasoning-Einstellung, Anweisungen, Toolversion und relevante Kontorechte.
- Definieren Sie Stopp- und Wiederherstellungsregeln. Legen Sie fest, wann erneut beobachtet oder versucht wird und wann ein Mensch Unsicherheit klären muss.
- Erfassen Sie beobachtbare Ergebnisse. Notieren Sie akzeptierte, falsche und ungeklärte Resultate, Versuche, Dauer und abgerechneten Verbrauch. Der Toolstatus ist nur ein Teil davon.
- Ergänzen Sie tatsächliche Betriebskosten. Nehmen Sie relevante Tool- und Umgebungskosten sowie gemessene Prüfzeit auf. Teilen Sie durch akzeptierte Aufgaben nach konsistenter Definition.
- Ändern Sie eine bedeutsame Variable. Vergleichen Sie eine neue Anweisung oder Reasoning-Einstellung an denselben Fällen und untersuchen Sie veränderte Fehler vor der Ausweitung.
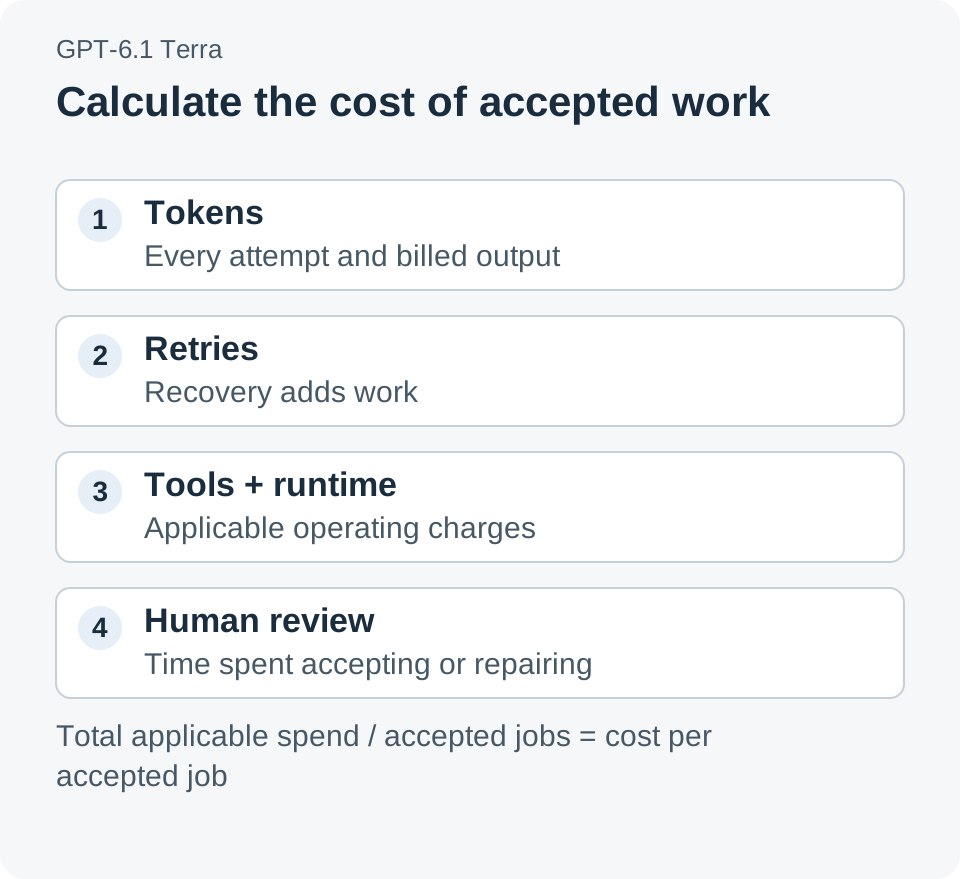
Vorgeschlagenes Kostenmodell: tatsächlich verbrauchte Ressourcen addieren und durch akzeptierte Aufgaben teilen. Die Komponenten sind ein Evaluationsrahmen, keine veröffentlichten Betriebsmessungen von Terra.
Die Aufzeichnung hilft auch bei einem enttäuschenden ersten Versuch. Sie zeigt, ob visuelles Verständnis, Prozessdesign, Toolzuverlässigkeit oder menschliche Reparatur verbessert werden müssen. Das ist eine bessere Grundlage für die nächste Automatisierung als durchschnittliche Anfragekosten allein.
Günstigere Computerbedienung zählt, wenn Abschluss bezahlbarer wird
Terras niedrigere Standardpreise bieten Spielraum für gründlichere Tests und mehr Arbeit innerhalb eines Budgets. Die geschäftliche Frage ist, ob eine konkrete Integration daraus akzeptierte Ergebnisse mit beherrschbarer Prüfung und Wiederherstellung macht.
Ein Modell, das Bildschirme liest und Klicks auswählt, ist nützlich. Ein Ablauf, der Änderungen zeigt, seinen Abschluss erkennt und den dafür nötigen Aufwand erfasst, lässt sich als Team bewerten und verbessern.
Quellen
- Vorstellung von GPT-6.1 Terra, OpenAI, 26. Oktober 2026: Positionierung, Standardpreise und Zugang.
- GPT-6.1 Terra System Card, OpenAI, 26. Oktober 2026: datierter Release- und Evaluationskontext.
- GPT-6.1 Terra Model Card, geprüft am 27. Oktober 2026: Modellkennung, Tool-Endpunkt, Reasoning und Abrechnungsbedingungen.
- Integration der Computerbedienung, geprüft am 27. Oktober 2026: Browseraktivität, Screenshots und Integrationsmechanik.
Die drei Abläufe, Kostenannahmen und Evaluationsschritte sind illustrativ. Die Dollarrechnung nutzt angegebene Standardtarife und ausdrücklich gewählte Annahmen; sie misst weder Latenz noch Genauigkeit oder Betriebskosten.
Empfehlung von Telli.sh: Halten Sie Versuchsnotizen, Referenzen und Entscheidungen hinter Prozessänderungen leicht auffindbar. Erstellen Sie ein Telli.sh-Konto, um Ihre Evaluationsnotizen zu organisieren.