GPT kommt in die Google Cloud: Der Einkaufsweg wird Teil der Modellwahl
Google Clouds private Vorschau auf OpenAI-Modelle verbindet Modellauswahl mit Unternehmenseinkauf und Governance. Was sich ändert, was noch geplant ist und wie sich ein neuer Weg prüfen lässt, ohne Zugang mit Betriebsreife gleichzusetzen.
Offizielles Google-Cloud-Zeichen aus den Press-Corner-Materialien, zur redaktionellen Kennzeichnung proportional skaliert und neutral eingefasst. Google Cloud ist eine Marke von Google LLC. Dieser unabhängige Artikel wird von Google weder unterstützt noch ist er mit Google verbunden. Das Bild kennzeichnet die Plattform und ist kein Screenshot der Vorschau.
Ein Entwickler kann ein Modell lange bevorzugen, bevor sein Unternehmen es kaufen oder betreiben kann. Oft fehlen ein freigegebener Vertrag, ein Budgetverantwortlicher, eine Entscheidung zur Datenverarbeitung und ein Supportweg. Eine bessere Antwort auf einen Testprompt überwindet diese Hürden nicht automatisch.
Am 21. Oktober 2026 kündigte Google Cloud OpenAI-Modelle in seinem Model Garden an, zunächst als private Vorschau für ausgewählte Unternehmenskunden. Genannt werden GPT-6 Astra, GPT-6.1 Sol und GPT-6 Luna. Google beschreibt den Kauf über Marketplace, eine gemeinsame Cloudrechnung und die mögliche Anrechnung auf bestehende Cloudabnahmeverpflichtungen als Teile des Angebots. Google-Cloud-Ankündigung.
Unsere Einschätzung: Hier ändert sich der Weg zwischen Modell und funktionierender Unternehmensanwendung. Organisationen erhalten neben der Modellqualität eine neue Beschaffungsoption zum Prüfen. Die nützliche Frage lautet, ob dieser Weg eine konkrete Arbeitslast leichter einkaufbar, kontrollierbar und verbesserbar macht, während die Vorschaugrenzen sichtbar bleiben.
Model Garden ist ein Katalog mit unterschiedlichen Betriebswegen
Google Cloud liefert Infrastruktur und verwaltete Dienste zum Entwickeln und Betreiben von Anwendungen. Model Garden dient zum Entdecken von Modellen und verfügbaren Bereitstellungswegen. Die Dokumentation unterscheidet verwaltete Modellservices von Modellen, die Kunden selbst bereitstellen. Ein gemeinsamer Katalog bedeutet daher nicht dieselbe Infrastruktur, dieselben Verträge oder dieselbe Betriebsverantwortung für jeden Eintrag. Model-Garden-Überblick, geprüft am 23. Oktober.
Dieser Kontext hilft Lesern, die Unternehmens-KI-Plattformen nicht kennen. Ein Modell erzeugt Antworten; eine Plattform gehört zu dem Weg, auf dem eine Organisation das System erhält, kontrolliert und betreibt. Ein anderer Einkaufsweg kann verändern, wer Ausgaben genehmigt und wo Administratoren Aktivitäten prüfen. Er verändert allein weder das Wissen des Modells noch dessen Zuverlässigkeit bei einer bestimmten Aufgabe.
Deshalb ist die Ankündigung mehr als ein bekannter Name in einem weiteren Katalog. Organisationen führen Modelle selten isoliert ein. Sie verbinden sie mit Dokumenten, Werkzeugen, Menschen und bestehenden Abläufen. Diese Verbindungen können einen großen Teil des Aufwands ausmachen, der einen scheinbar einfachen API-Aufruf alltagstauglich macht.
Die Einführung trennt Zugang und Zukunftsplan
Die Veröffentlichung vom 21. Oktober beschreibt API-Zugang sowie die Anbindung lokaler Inferenzabläufe von Codex CLI und Desktop für teilnehmende Kunden. Optionen für Zero Data Retention und Confidential Compute sollen bald folgen, ebenso spätere Integrationen in Gemini for business und Google Antigravity. Die private Vorschau ist der aktuelle Stand; künftige Funktionen müssen separat bewertet werden. Verfügbarkeit und Planung.
Interessierte Kunden können zunächst über das Formular in der Ankündigung Interesse bekunden und mit dem Accountteam ihre Berechtigung klären. Eine öffentliche Ankündigung hilft bei der Planung. Eine Produktionsentscheidung benötigt aber die tatsächlichen Zugangsbedingungen, unterstützten Funktionen, Vertragsbedingungen und Grenzen des Accounts. Diese Details sollten bei der Bewertung bleiben und nach einer gelungenen Demonstration nicht verschwinden.
Teams können schon vor dem Zugang sinnvoll vorbereiten: Arbeitslast bestimmen, akzeptable Antworten definieren und erlaubte Pilotdaten festlegen. Dafür muss keine zukünftige Datenschutzfunktion als vorhanden gelten. Zugleich erhält die Vorschau einen klareren Zweck, als alle Modelle auszuprobieren und die eindrucksvollste Antwort auszuwählen.
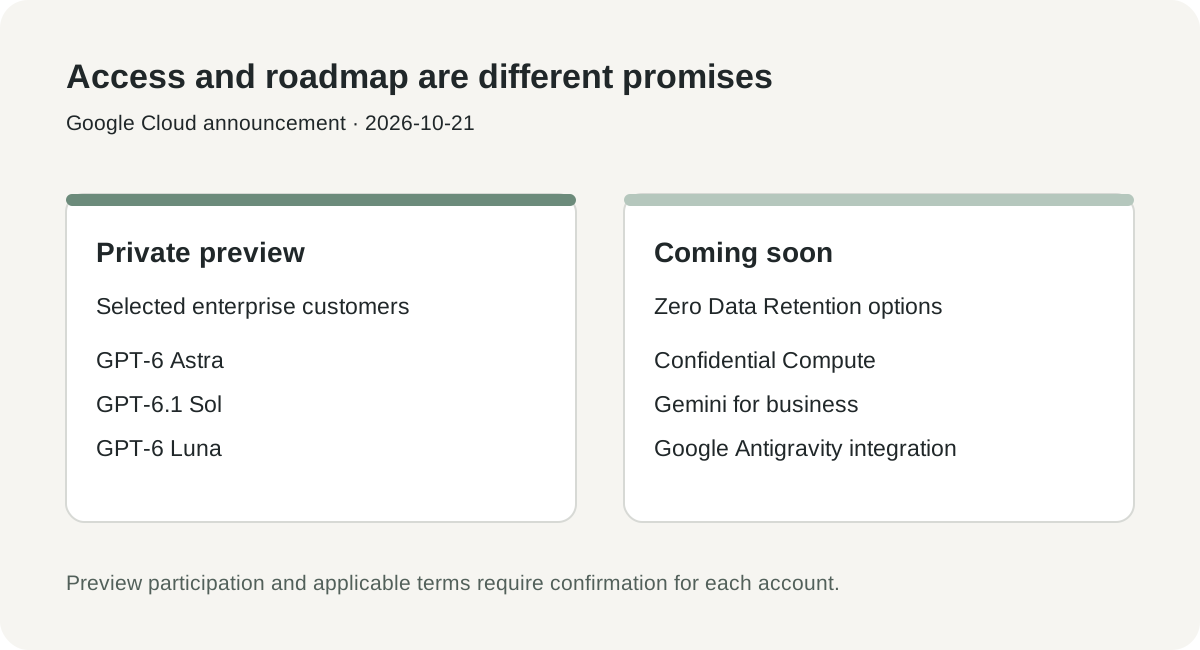
Eigene Infografik auf Basis der Ankündigung vom 21. Oktober. Teilnahme und geltende Bedingungen müssen pro Account bestätigt werden; für geplante Funktionen wird hier kein Veröffentlichungsdatum angedeutet.
Eine Rechnung vereinfacht Verwaltung, klärt aber nicht die Wirtschaftlichkeit
Die Google-Cloud-Marketplace-Dokumentation erklärt, dass Marketplace-Produktgebühren als separate Positionen in Cloudabrechnungsberichten und exportierten Abrechnungsdaten erscheinen. Sie unterscheidet außerdem Produktgebühren von den dazu verwendeten Cloudressourcen. Für jedes Anwendungsbudget ist das nützlich: Eine konsolidierte Rechnung ersetzt nicht das Verständnis ihrer Bestandteile. Marketplace-Abrechnung, geprüft am 23. Oktober.
Ein Unternehmen sollte die vollständigen Kosten seines eigenen Ablaufs vergleichen. Modellanfragen sind ein Posten. Retrieval, Speicherung, Wiederholungsversuche, Werkzeugausführung und menschliche Prüfung können ebenfalls zählen. Ein niedriger Preis pro Generierung verliert seinen Vorteil, wenn mehr Ausgaben korrigiert werden müssen, bevor sie nutzbar sind.
Cloudabnahmeverpflichtungen bringen einen weiteren Aspekt. Ausgaben über eine bestehende Vereinbarung können besser zum Unternehmensbudget passen als eine neue Anbieterbeziehung. Das ist möglicherweise ein echter betrieblicher Vorteil, ohne die Wirtschaftlichkeit der Anwendung zu verändern. Die Finanzfrage lautet, welche anrechenbare Ausgabenregel gilt; die technische Frage, wie viel nützliche Arbeit diese Ausgaben erledigen.
Ein beispielhafter interner Assistent bearbeitet im Pilotbetrieb 1.000 Anfragen. Ein Modell erledigt mehr davon beim ersten Versuch akzeptabel, ein anderes braucht wiederholtes Retrieval und manuelle Überarbeitung. Relevant sind Kosten pro akzeptierter Aufgabe und die Folgen fehlgeschlagener Aufgaben. Dieses Beispiel beschreibt eine Messmethode und prognostiziert kein Ergebnis der genannten Modelle.
Fähigkeiten, Beschaffung und Governance in getrennten Spalten führen
Eine nützliche Bewertung hat drei Spalten. Die erste fragt, ob das Modell die Arbeit erledigt. Die zweite, ob die Organisation diesen Weg kaufen und unterstützen kann. Die dritte, was mit Daten passiert und welche Aktionen die Anwendung ausführen darf. Eine gemeinsame Punktzahl kann den Grund verbergen, weshalb ein vielversprechender Pilot nicht produktionsgeeignet ist.
| Entscheidung | Nützliche Frage | Aufzubewahrende Belege |
|---|---|---|
| Fähigkeit | Erledigt das Modell diesen Ablauf genau genug? | Repräsentative Eingaben, akzeptierte Ausgaben und Fehlerfälle |
| Beschaffung | Kann der Account den angebotenen Dienst kaufen und budgetieren? | Geltendes Angebot, anrechenbare Ausgaben, Kontingente und Supportweg |
| Governance | Sind die tatsächlichen Daten- und Aktionskontrollen geeignet? | Accountspezifische Bedingungen, Konfiguration und beobachtetes Verhalten |
Die Spalten helfen auch bei produktiven Meinungsverschiedenheiten. Entwickler können bessere Ausgaben zeigen, während Sicherheitsprüfer eine fehlende Kontrolle erkennen. Die Finanzabteilung kann einen günstigeren Vertragsweg finden, während der Betrieb eine untragbare Supportlücke entdeckt. Alles kann gleichzeitig zutreffen. Gesucht ist eine Entscheidung mit erklärten Zielkonflikten, keine Debatte darüber, welches Team KI am besten versteht.
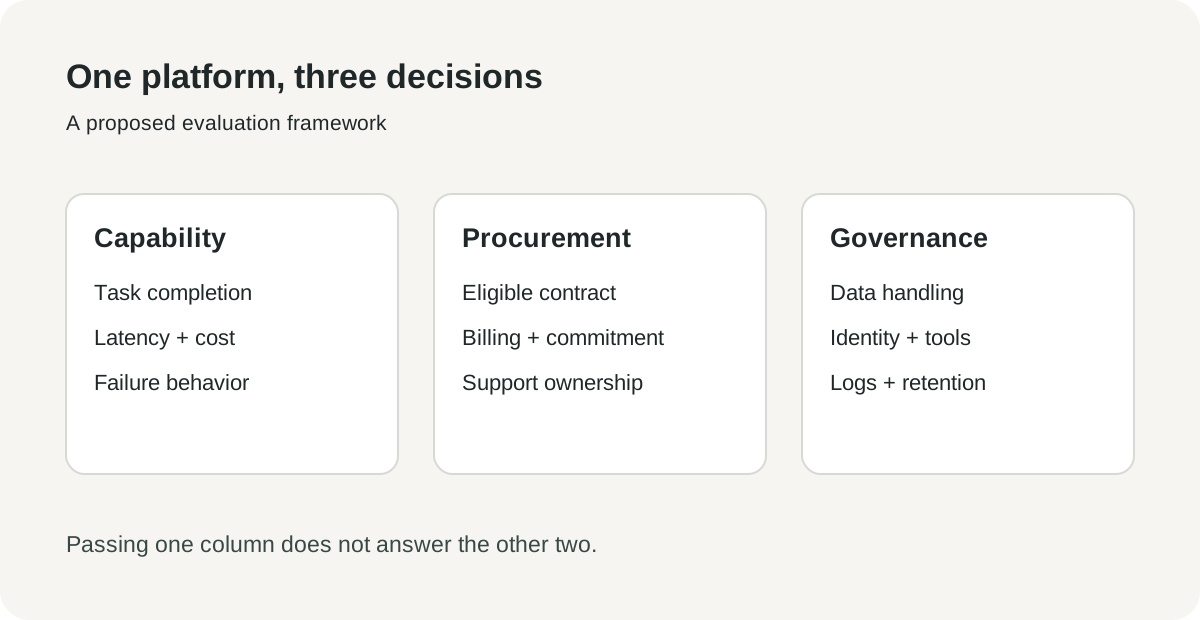
Eigener redaktioneller Rahmen. Dies sind vorgeschlagene Einkaufskriterien, keine Behauptung, eine Plattform liefere für jedes Modell jede genannte Kontrolle.
Ein interner Dokumentenassistent eignet sich für den ersten Vergleich
Ein beispielhafter Assistent beantwortet Fragen aus freigegebener Produktdokumentation. Das klingt einfach, bis Dokumente widersprechen, eine Antwort von einem Datum abhängt oder dem Nutzer die Zugriffsberechtigung fehlt. Solche schwierigen Fälle gehören in den Vergleich. Die schönste Antwort auf ein sauberes Dokument ist nur ein Teil der Aufgabe.
Ein Team kann einen kleinen geprüften Fragensatz mit erwarteten Belegstellen zusammenstellen. Bewertet wird, ob die Antwort die richtige Version verwendet, die relevante Quelle zitiert und fehlende Informationen eingesteht. Beim Modellvergleich bleibt die Retrievalkonfiguration stabil, damit Unterschiede aussagekräftig sind und nicht aus anderen gelieferten Dokumenten entstehen. Gemessen wird die Prüfung, die vor der Weitergabe an Kollegen nötig ist.
Die Zugriffsgrenze braucht einen eigenen Test. Ein Assistent sollte nicht allein deshalb aus einem Dokument antworten, weil die Anwendung es irgendwo abrufen kann. Auch der Nutzer benötigt die passende Berechtigung. Diese vorgeschlagene Anwendungsanforderung bleibt unabhängig vom Namen auf Modell oder Rechnung bestehen. Ein bequemer Einkaufsweg gleicht ein falsch angebundenes Dokumentensystem nicht aus.
Programmierpiloten sollten eine abgeschlossene Änderung messen
Ein zweiter Anwendungsfall ist ein interner Programmierassistent. Das Team hat vielleicht bereits eine genehmigte Entwicklungsumgebung und einen klaren Prüfprozess für Patches. Daraus ergeben sich beobachtbare Ergebnisse: Änderungsvorschlag, relevante Tests, Prüfentscheidung und nötige Überarbeitung. Die nützliche Arbeitseinheit ist die akzeptierte Änderung statt der erzeugten Codemenge.
Wählen Sie einige begrenzte Aufgaben aus echter Wartungsarbeit: etwa einen Eingabevalidierungsfehler korrigieren, eine kleine Abhängigkeitsintegration aktualisieren und einen fehlenden Regressionstest ergänzen. Ausgangszustand des Repositorys und Anweisungen bleiben gleich. Halten Sie fest, ob der Assistent den relevanten Code verstand, den Vertrag bewahrte und sein Ergebnis prüfbar erklärte.
Werkzeugzugriffe sollten bewusst vergeben werden. Quelldateien lesen, Tests ausführen und eine Version veröffentlichen haben sehr unterschiedliche Folgen. Ein Pilot kann mit wegwerfbarer Umgebung und engem Aktionsumfang beginnen und erst nach verstandenem Verhalten wachsen. Der Inferenzanbieter ist nur ein Bestandteil; Programmierwerkzeug und Berechtigungen bestimmen weiterhin, was der Assistent tatsächlich verändern kann.
Das verhindert auch irreführende Geschwindigkeitsvergleiche. Schnellere Textgenerierung spart wenig, wenn Prüfer länger einen falschen Ansatz korrigieren. Ein Modell mit längerer Anfragezeit kann die Aufgabe dennoch früher abschließen. Unternehmenspiloten sollten deshalb sowohl Anfragezeiten als auch die Zeit bis zum akzeptierten Ergebnis aufbewahren.
Wiederholter Support zeigt die Kosten von Ausnahmen
Ein drittes Beispiel ist das Entwerfen von Supportantworten aus einer freigegebenen Wissensbasis. Die meisten Nachrichten mögen Routine sein, einige betreffen aber Erstattungen, Kontozugriff oder ungelöste Dienstprobleme. Ein Modell mit guten Routineantworten ist hilfreich. Ein schlecht behandelter Ausnahmefall kann unverhältnismäßige Mehrarbeit erzeugen.
Trennen Sie im Pilot Entwurf und Handlung. Prüfer sollten verwendete Quelle, Antwortvorschlag und fehlende Informationen sehen, bevor eine Nachricht gesendet oder ein Konto geändert wird. Fälle mit notwendiger Übergabe gehören dazu. So lässt sich prüfen, ob der Assistent die Grenze seiner Belege erkennt, ohne ihn allein für die Eskalation eines schwierigen Falls zu bestrafen.
Der Plattformwert läge hier im einfacheren Betrieb eines begrenzten Ablaufs statt im abstrakten Versprechen vollständig autonomen Supports. Eine sinnvolle Einführung reduziert repetitive Aufgaben und regelt Ausnahmen klar. Dazu müssen Anwendungsdesign und tatsächliches Modellverhalten zusammenpassen.
Trainingsregeln, Aufbewahrung und Werkzeugrechte beantworten andere Fragen
Googles aktuelle Daten-Governance-Dokumentation unterscheidet Einschränkungen der Nutzung von Kundendaten zum Modelltraining von Aufbewahrung bei bestimmten Diensten und Funktionen. Sie beschreibt konkrete Schritte und Bedingungen für Zero Data Retention. Einige fortgeschrittene Funktionen können diese Konfiguration verhindern. Die allgemeine Dokumentation liefert nützliche Begriffe; die Bedingungen dieser Vorschau müssen dennoch accountspezifisch bestätigt werden. Daten-Governance-Dokumentation, geprüft am 23. Oktober.
Drei Fragen sollten im Einkaufsgespräch getrennt bleiben. Dürfen eingereichte Inhalte fürs Training genutzt werden? Dürfen sie gespeichert werden, wofür und wie lange? Welche verbundenen Werkzeuge dürfen andere Systeme lesen oder verändern? Eine günstige Antwort liefert nicht die anderen Antworten mit. Das ist besonders wichtig, wenn eine Präsentation Modellzugriff, Retrieval, Protokollierung und handelnde Agenten verbindet.
Auch Anwendungsprotokolle verdienen Aufmerksamkeit. Ein Ablauf kann sensible Inhalte in eigenen Debugging- oder Überwachungssystemen aufbewahren, selbst bei restriktiver Inferenzkonfiguration. Prüfen Sie den gesamten Weg von Nutzereingabe bis gespeichertem Ergebnis einschließlich Exporten und menschlicher Prüfung. Eine Darstellung dieses Wegs ist oft hilfreicher als die pauschale Versicherung, Unternehmens-KI sei eingeführt.
Mehr Modelle können eine Abhängigkeit verringern und eine andere vertiefen
Ein Katalog, der mehrere Anbieter leichter vergleichbar macht, kann Verhandlungs- und Technikoptionen verbessern. Teams können eher fragen, welches Modell zur Arbeitslast passt, statt die erste Integration als dauerhaft zu behandeln. Für Käufer, die Qualität, Latenz und Kosten bei Produktänderungen neu bewerten wollen, ist das sinnvoll.
Portabilität braucht weiterhin Gestaltung. Prompts, Werkzeugbeschreibungen, Ausgabestrukturen und betriebliche Annahmen können an einen Anwendungsstack gebunden werden. Ein über eine gemeinsame Plattform ausgewähltes Modell kann sich bei verändertem Endpunkt oder Umfeld trotzdem anders verhalten. Portabilität zeigt sich in einer wiederholbaren Migrationsübung mit erhaltenem Testsatz und erwarteten Verhaltensweisen.
Hinzu kommt ein Konzentrationskonflikt. Mehr KI-Ausgaben und Kontrollen in einer Cloud erleichtern die tägliche Verwaltung. Gleichzeitig steigen die Folgen plattformweiter Kontingent-, Richtlinien- oder Verfügbarkeitsprobleme. Teams sollten festlegen, welche Abhängigkeiten sie akzeptieren, welche Alternativen sie pflegen und wie sie wesentlich andere Ergebnisse eines Ausweichwegs erkennen.
Eine Vorschau ist nützlich, wenn die Abschlusskriterien zuerst feststehen
Googles Evaluationsdokumentation beschreibt die Bewertung generativer Ausgaben mit definierten Metriken und Bewertungsrastern. Ein Werkzeug kann diese Arbeit organisieren; die Organisation muss weiterhin bestimmen, was eine nützliche Antwort für ihre Aufgabe ist. Klare Kriterien erleichtern Diskussionen gegenüber einer informellen Sammlung beeindruckender Antworten. Überblick zum Evaluationsdienst, geprüft am 23. Oktober.
Ein praktischer Pilot bleibt konkret:
- Vorschauzulassung, angebotene Modellkennungen, Funktionen, Regionen, Kontingente und geltende Konditionen mit dem Accountteam bestätigen.
- Eine Arbeitslast und einen erlaubten Testdatensatz wählen. Annahme, Eskalation und verbotene Aktionen vor der Anbindung echter Systeme definieren.
- Eine Basislinie mit dem aktuellen Ablauf erstellen. Repräsentative Erfolge und Fehler statt nur schwieriger Beispiele behalten.
- Modelle bei gleichen Eingaben und Werkzeugrechten vergleichen. Akzeptierte Ergebnisse, Prüfaufwand, Gesamtlatenz und vollständige Ablaufkosten erfassen.
- Tatsächliche Protokollierung, Datenverarbeitung und Fehlerverhalten prüfen. Von Zukunftsfunktionen abhängige Kontrollen dokumentieren, statt sie als vorhanden zu behandeln.
- Über Erweiterung, Anpassung oder Ende des Piloten entscheiden. Belege bewahren, damit spätere Modelle oder Angebote an derselben Aufgabe gemessen werden können.
Die nützliche Einheit der Wahl ist eine funktionierende Aufgabe
OpenAI-Modelle über Google Cloud machen die Unternehmensauswahl konkreter. Eine technische Option wird mit einem Ort verbunden, an dem die Organisation möglicherweise bereits Software kauft und betreibt. Das kann Reibung entfernen, sofern Käufer Vorschauzugang, aktuelle Kontrollen und versprochene Ergänzungen auseinanderhalten.
Das stärkste Ergebnis wäre ein Team, das sein Modell wechseln kann, ohne das Verständnis seines Ablaufs zu verlieren. Der dauerhafte Vorteil besteht darin, erklären zu können, warum eine Aufgabe ausreichend genau, bezahlbar und kontrolliert läuft. Ein größerer Katalog ist wertvoll, wenn er zu dieser Antwort beiträgt.
Quellen
- Google Cloud stellt Kunden OpenAI-Modelle bereit, 21. Oktober 2026.
- Model-Garden-Überblick, Marketplace-Abrechnung, Daten-Governance und Gen-AI-Evaluationsüberblick, geprüft am 23. Oktober 2026.
- Google Cloud Press Corner und Google-Markenhinweise für Bücher und Medien, geprüft am 23. Oktober 2026.
Bewertung und Entscheidung zusammenhalten
Wer Quellenlinks, Pilotergebnisse und eigene geprüfte Entscheidungen in einem separaten Arbeitsbereich sammeln möchte, findet in Telli.sh eine Möglichkeit. Öffnen Sie Ihren Notizbereich.