GPU 笔记本暂停后,还能接着做同一个实验吗?
Google 自托管的 GKE Workspaces 结合了持久文件、可恢复的加速器会话和浏览器 IDE。每一层都有不同的成本。
晚上 6 点,笔记本终于把模型加载完,跑出了值得查看的结果。如果停掉会话,明天可能要花一段时间重建环境、再加载一遍模型。如果让它继续运行,紧缺的加速器可能会闲置一整晚。
Google 在 11 月 4 日发布了 GKE Workspaces。这是一套运行在团队 Google Kubernetes Engine 集群里的开源开发环境。用户可以从浏览器仪表盘用指定资源启动 JupyterLab 或 VS Code。项目建立在 Kubeflow Workspaces 之上,文档介绍了如何暂停和恢复受支持的会话。团队要弄清的是,明天需要保留哪种状态,为此又有哪些资源要继续分配。
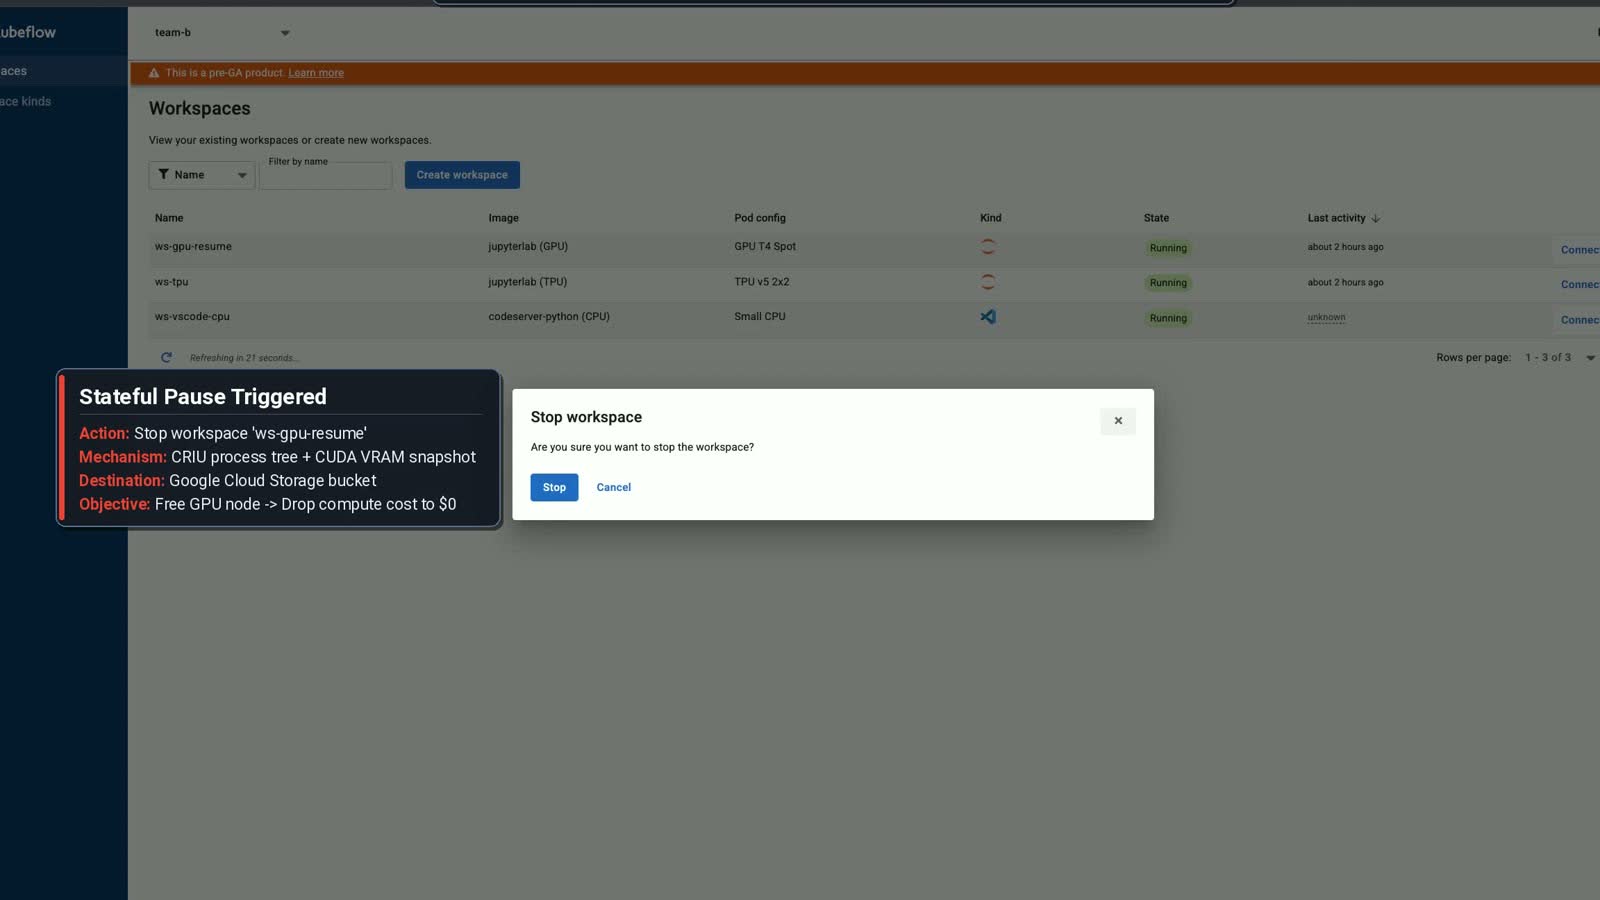
从 GKE Workspaces 可恢复笔记本演示裁剪的画面,Apache 2.0。图片来源 · 许可证。
笔记本文件和运行中的会话保留的是不同的东西
暂停 GPU 笔记本。Telli.sh 原创示意图。
保存笔记本会留下写好的单元格和已经保存的输出。磁盘上的数据集和检查点可以供新进程使用。这两种办法都不会自动捕获运行中会话的全部状态。一个实验可能有初始化过的变量、放在加速器上的模型,以及需要花时间才能重新得到的中间状态。
Google 介绍了使用 GKE Pod Snapshots 保存受支持的运行中工作区状态,同时释放计算资源的方法。工作区文件仍在持久存储上。恢复时,需要有兼容的计算容量和可用快照。因此,暂停更接近于续做实验,而非重新打开一个文件,但也受底层环境约束。
| 层次 | 示例 | 规划时的问题 |
|---|---|---|
| 持久文件 | 笔记本、缓存的权重、结果和依赖 | 干净重启后这些文件还在吗? |
| 应用检查点 | 训练检查点或已保存的运行状态 | 不依赖旧进程,任务能否恢复? |
| 工作区快照 | 运行中的进程或受支持的加速器状态 | 当前硬件和环境支持恢复吗? |
| 集群容量 | 节点、加速器配额或预留 | 计算资源会实际释放吗?之后还能获得吗? |
可复现性和便利性改善的是流程的不同部分。快照方便需要很快回到会话的人。可复现的笔记本和应用检查点让别人更容易重跑,也便于把工作迁到其他环境。重要实验可以同时保留两套东西。
研究团队可以在会议间暂停 GPU 会话,同时提交代码,把模型产物保存到可靠位置。即使后来快照恢复失败,也有清楚的备选方案。同样,长时间运行的训练任务可以按计划保存检查点,即使启动它的工作区本身支持暂停。
工作区停了,仍然会有成本
追踪实际账单。Telli.sh 原创示意图。
直接的经济收益是没人工作时不用计算资源。实际账单取决于会话停止后集群如何处理。其他 Pod 可能仍在用节点,节点就会继续运行。预留资源可能还有费用或用量承诺。持久磁盘和保存下来的快照也依然留在系统中。
以一个假设为例。研究人员下班后让一块本来闲置的加速器继续分配 12 小时,暂停给了平台释放这 12 个加速器小时的机会。这是可用容量上的机会。账单会不会变,取决于节点和加速器的供应和计费方式。如果还有别的任务离不开该节点,变化可能更有利于调度,未必直接反映在账单上。
公平的比较还要算时间。保存快照会占用资源,大状态恢复要花时间,所需的加速器也可能暂时拿不到。在繁忙的集群上,即使团队已承诺使用一批容量,能把设备交给别人使用也有价值。
记录实际工作结束、工作区停止、节点可用三个时间点。然后测量用户请求恢复后什么时候能运行下一个单元格。通过这些时刻,平台团队可以判断暂停策略是否归还了有意义的容量,同时又不会让下一个工作日从排队开始。
平台团队仍负责设定工作区的使用条件
自助服务改变的是谁来点按钮。管理员仍要决定用户可以启动哪些镜像、能申请哪些加速器,以及集群如何处理配额和隔离。GKE Workspaces 仓库将项目标为 Apache 2.0 代码,并说明它并非由 Google 官方提供支持的产品。评估是否在团队使用时,把安装和运营计入自己的工程职责。
机器学习工程师可能需要熟悉的 IDE、足够的内存和访问实验数据集的权限。平台负责人还要考虑默认身份、存储权限、如何停止工作负载,以及哪些镜像能接收更新。按工作区类型说明取舍,就能兼顾这些需求。一个小型 CPU 笔记本和一个 GPU 实验会话可以使用不同默认配置。
公告也提到了加速器选项和连接本地工具或代理。别急着把不同方式视为可以互换,先查看针对你的集群和场景的安装说明。依赖硬件的恢复、跨集群访问、本地开发连接,各有前提。先做一个简单案例,让团队成员能检查工作区,并确认它运行在哪个集群。
做一次暂停和恢复测试
- 阅读项目的部署指南,以及当前 GKE 环境对快照和加速器的要求。使用与目标流程相符的权限和资源限制设置测试工作区。
- 启动一个可复现的笔记本。保存输入、一个应用的中间检查点和一个小结果文件。暂停前记下时间和资源分配。
- 暂停工作区并查看集群的资源状态。检查 Pod 是否停止、加速器能否重新调度、还有哪些存储留着。
- 恢复工作区。确认预期文件和运行状态,运行一个会用到已加载模型的单元格。测量从请求恢复到笔记本可用的时间。
- 试着从保存的文件和应用检查点完成同样的恢复。快照恢复太慢或不可用时,这既是备选方案,也提供对照。
- 与团队复核空闲设置。定义什么算无活动,并决定长时间任务是否需要另一种工作区或明确的单独处理方式。
也在配额受限或集群繁忙时测试恢复。空集群上整齐的演示,可能看不出几名用户一起回来时争取容量的困难。测试是为了知道资源紧张时系统如何表现。
算清 GPU 时间用在了哪里
假设一台开发工作站每周使用 40 小时。一周始终分配的话,机器共占用 168 个小时。如果平台可以在停工时释放 GPU 节点,只在那 40 小时恢复,那么在计算快照和恢复开销前,有 128 小时无需分配节点。这是一个假设例子,不采用任何云价格或使用模式。共享节点在同一段时间仍可能执行有用的工作,因此这只是这种分配方式下的上限。
可以用团队自己的 GPU 池基线,让比较更贴近实际。对每个测试时段,记录节点用时、其他任务是否占用节点,以及保存了多少工作区数据。也记下从请求恢复到能运行下一单元格的时间。如果另一个负载还在运行,导致节点保留,暂停的笔记本可能给它让出容量,却未必减少账单。这也是一个有价值的结果,只是衡量的东西不同。
把快照时间也算进去。如果旧 Pod 继续占着资源,而暂停本身又很久,过短的空闲阈值可能增加中断,却省不了多少算力。如果自动扩缩组件要花好几分钟找兼容 GPU,短暂休息后回来的开发者可能等得比策略节约的时间还久。测量几种空闲时长,不要认定每次暂停都有价值。
启用暂停前,先选要保留的状态
GKE Workspaces 仓库介绍了无状态的 VS Code 流程,以及另一个有状态的 JupyterLab 示例。后者演示如何恢复有 GPU 的笔记本,包括在一张 T4 上运行 3B Qwen2.5 的例子。Kubernetes Pod 快照和示例都有具体的兼容性限制。Google 的 GKE 文档解释了 GKE Sandbox 和兼容节点及镜像配置的作用。对 GPU 示例,在依赖恢复前先确认新节点有同款受支持的 GPU 和兼容环境。
先确定用户看到暂停按钮时会期待什么。有人只需要文件、输出和编辑器状态,有人期待下一个 Python 单元格仍然能访问 RAM 中的对象或 VRAM 上的模型。共享数据集也可能在外部对象存储里,不进入快照。记录所选工作区可以恢复的状态、普通文件的存放位置,以及恢复失败时怎么办。
还可以试一次恢复前就遇到故障的情形。在测试命名空间里让兼容容量暂时不可用,观察工作区能否显示明确状态,避免创建多个互相竞争的恢复操作。检查内存进程不能恢复时,所有者是否能从文件或已存的输出找回工作。然后清理测试快照,核实相应的存储和保留规则是否如预期执行。
把成本和恢复结果带回团队
研究人员希望接着工作,平台团队想把紧缺的 GPU 容量归还给资源池,费用负责人想知道分配是否真的结束。分别记录空闲时间、节点位置、快照大小、成功恢复和恢复用时,一个测试样本就能服务于三个问题。补充失败处理说明,让用户知道工作区是已暂停、在等容量,还是已经可用。
有了这个基线,再按工作负载类别选空闲策略。加载模型要很久的笔记本,可能适合在两个工作时段之间保留内存。一个从已保存脚本启动的短实验,可能只需要持久文件和全新启动。两者可以共用一批容量,恢复时长却各有条件。
把恢复测试放进发布检查表
平台升级可能改变启动工作区使用的镜像,或提供 GPU 容量的节点池。给团队启用改动前,先用旧配置建一个测试笔记本,看看新配置下会发生什么。测试要能区分真正恢复,与新会话里打开了同一个笔记本文件。读取一个仅存在于测试进程中的值,再确认进程用到的文件是否仍然存在。
如果升级会让旧快照失效,给用户保存重要输出的机会,并说明备用办法。单独检查过期快照的清理。恢复测试只表明某个工作区能否回来,清理测试则表明用户停用之后留下了多少旧状态。
留下最难重做的部分
让人少操心机器的生命周期,仍然能找回工作,工作区就更有用。要做到这一点,需要分别处理文件、检查点、快照和容量。挑出能舒适地续做实验所需的最少状态,并确保没有原始会话也能复现实验。
如果团队能回答磁盘上留了什么、必须恢复什么,以及什么时候归还计算资源,就能制定一套大家实际愿意用的空闲策略。
来源
如果想把工作背后的对话和决定留成可搜索的记录,可以创建 Telli.sh 账号。