Dá para pausar um notebook com GPU e voltar ao mesmo experimento?
O GKE Workspaces, hospedado no próprio cluster, reúne arquivos persistentes, sessões com acelerador que podem ser retomadas e um IDE no navegador. Cada camada tem um custo diferente.
São seis da tarde. Um notebook finalmente carregou o modelo e produziu resultados que valem uma análise. Se você encerrar a sessão, pode gastar parte do dia seguinte refazendo o ambiente e carregando o modelo. Se deixar a sessão rodando, um acelerador disputado pode ficar ocioso durante a noite.
O Google anunciou o GKE Workspaces em 4 de novembro. O ambiente de desenvolvimento de código aberto roda no cluster Google Kubernetes Engine da equipe, onde um painel no navegador pode iniciar JupyterLab ou VS Code com recursos configurados. O projeto usa o Kubeflow Workspaces como base e documenta como pausar e retomar as sessões compatíveis. A equipe precisa decidir de que estado vai precisar amanhã e o que deve continuar alocado para preservá-lo.
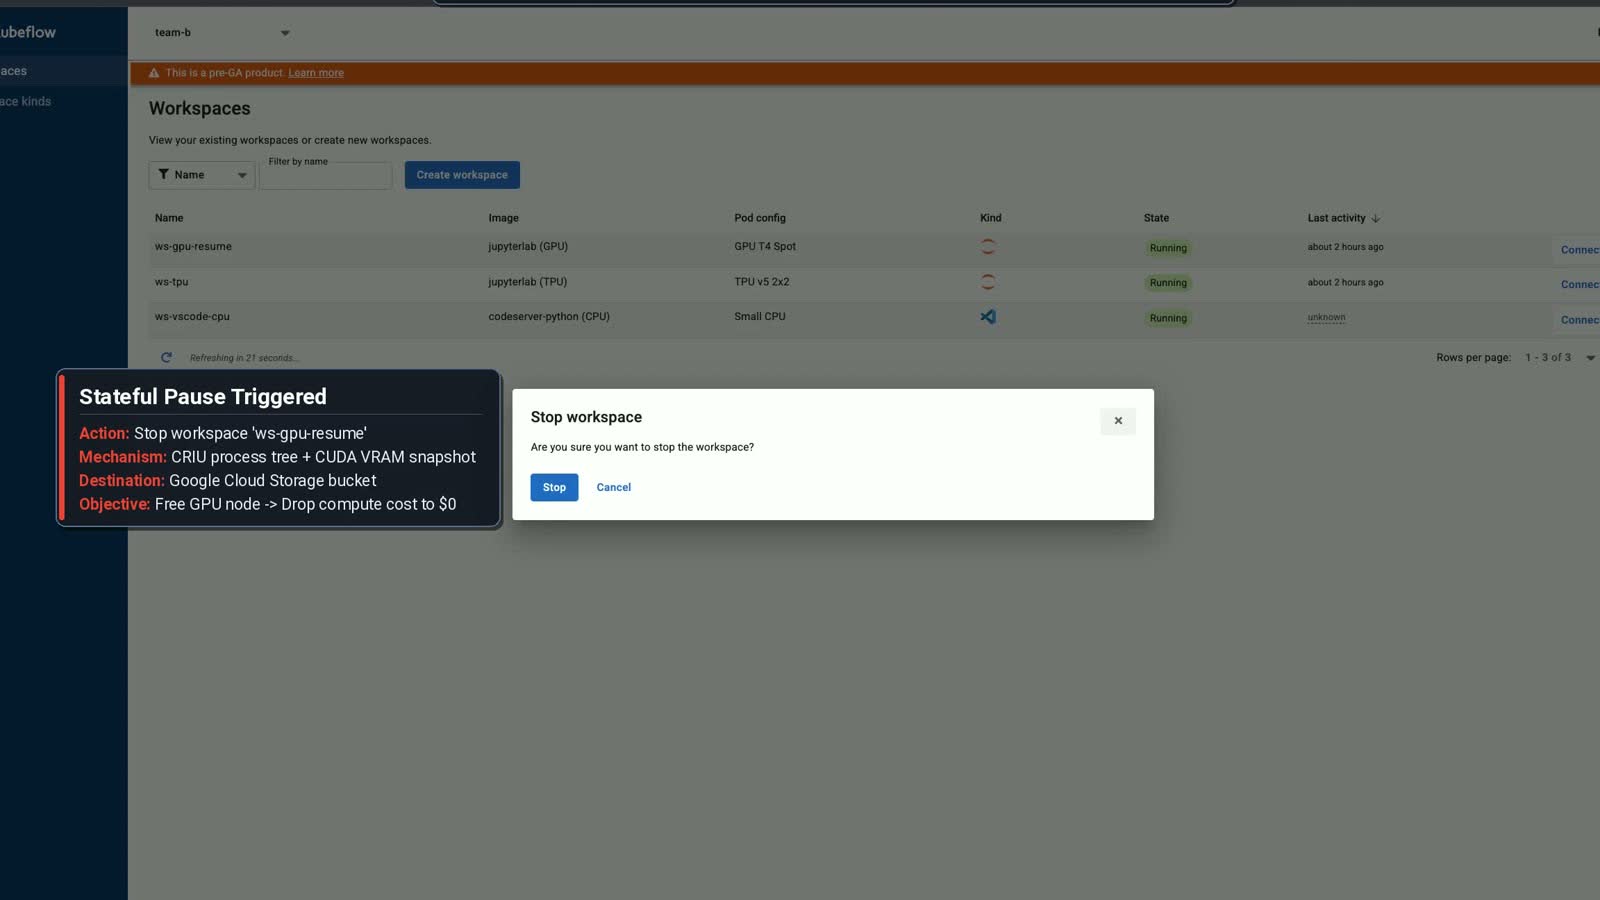
Quadro recortado da demonstração de notebooks que podem ser retomados no GKE Workspaces, Apache 2.0. Fonte da imagem · Licença.
O arquivo do notebook e a sessão ativa preservam coisas diferentes
Pausa de um notebook com GPU. Ilustração original da Telli.sh.
Salvar um notebook guarda as células que você escreveu e as saídas que foram salvas. Um disco pode manter conjuntos de dados e checkpoints disponíveis para um processo novo. Nenhuma dessas opções captura automaticamente tudo que existe em uma sessão ativa. Um experimento pode ter variáveis inicializadas, um modelo no acelerador e um estado intermediário que levaria tempo para reconstruir.
O Google descreve o uso de GKE Pod Snapshots para preservar o estado compatível de ambientes em execução enquanto libera recursos de computação. Os arquivos do ambiente ficam no armazenamento persistente. Na retomada, é preciso ter tanto o snapshot quanto capacidade compatível. Assim, pausar fica mais próximo de retomar um experimento, com as restrições práticas do ambiente que o executa.
| Camada | Exemplo | Pergunta para o planejamento |
|---|---|---|
| Arquivos persistentes | Notebook, pesos em cache, resultados e dependências | Esses arquivos sobrevivem a um reinício do zero? |
| Checkpoint da aplicação | Checkpoint de treinamento ou estado salvo da execução | A tarefa pode continuar sem o processo antigo? |
| Snapshot do ambiente | Processo ativo ou estado de acelerador compatível | O hardware e o ambiente permitem restaurá-lo? |
| Capacidade do cluster | Nó, cota de acelerador ou reserva | A capacidade será realmente liberada e estará disponível depois? |
Reprodutibilidade e praticidade melhoram partes diferentes do trabalho. Um snapshot ajuda quem quer retomar logo uma sessão. Um notebook reproduzível e um checkpoint da aplicação facilitam a reexecução ou a transferência para outro ambiente por outra pessoa. Guarde os dois quando o experimento for importante.
Uma equipe de pesquisa pode pausar uma sessão com GPU entre reuniões e ainda fazer o commit do código e salvar os artefatos do modelo em um local durável. Se o snapshot não puder ser restaurado, a equipe tem uma alternativa clara. Da mesma forma, um treinamento longo pode salvar checkpoints em intervalos regulares mesmo que o ambiente usado para iniciá-lo aceite pausa.
Um ambiente parado ainda tem custo
Acompanhamento do custo real. Ilustração original da Telli.sh.
O benefício econômico imediato vem de evitar o consumo de computação quando ninguém está trabalhando. A conta efetiva depende do que o cluster faz depois que a sessão para. Um nó pode continuar rodando porque outros pods o usam. Uma reserva ainda pode ter custo ou compromisso de uso. Discos persistentes e snapshots guardados continuam fazendo parte do sistema.
Comece por um exemplo hipotético. Se uma pesquisadora deixa um acelerador sem uso alocado por 12 horas depois do expediente, a pausa dá à plataforma a chance de liberar essas 12 horas. É uma oportunidade de recuperar capacidade. O efeito financeiro depende de como o nó e o acelerador são provisionados e cobrados. Se o nó precisar ficar ligado para outra tarefa, o ganho pode aparecer mais no agendamento do que na fatura.
Uma comparação justa considera o tempo. Salvar o snapshot usa recursos, restaurar um estado grande leva tempo e o acelerador desejado pode não estar disponível de imediato. Em um cluster movimentado, poder repassar o dispositivo para outra pessoa importa mesmo quando a equipe já se comprometeu com uma quantidade de capacidade.
Registre o fim do trabalho ativo, a hora em que o ambiente para e quando o nó fica disponível. Depois, meça quando a pessoa que volta consegue executar a próxima célula. Esses pontos mostram à equipe de plataforma se a política de pausa devolve capacidade relevante sem transformar o começo do próximo dia em uma fila.
A equipe de plataforma continua responsável pelo ambiente
O autosserviço muda quem clica no botão. A administração ainda determina quais imagens podem ser iniciadas, quais aceleradores podem ser solicitados e como o cluster trata cotas e isolamento. O repositório do GKE Workspaces informa que o código usa Apache 2.0 e que o projeto não é um produto com suporte oficial do Google. Na avaliação, trate instalação e operação como responsabilidades de engenharia da equipe.
Quem trabalha com aprendizado de máquina pode precisar de um IDE conhecido, memória suficiente e acesso ao conjunto de dados do experimento. A pessoa responsável pela plataforma também precisa pensar em identidades padrão, permissões de armazenamento, interrupção de cargas e atualização das imagens. Essas necessidades são compatíveis se os tipos de ambiente deixarem claras as diferenças. Um notebook pequeno em CPU e uma sessão de experimentação em GPU podem partir de configurações distintas.
O anúncio também descreve opções de aceleradores e conexões para ferramentas locais ou agentes. Consulte as instruções de configuração para seu cluster e seu caso antes de tratar essas opções como equivalentes. Restauração em hardware específico, acesso entre clusters e conexão com o ambiente local têm requisitos próprios. Comece pelo caso mais simples, em que alguém da equipe consegue inspecionar o ambiente e confirmar em qual cluster ele está rodando.
Faça um teste de pausa e recuperação
- Leia o guia de implantação do projeto e os requisitos atuais de snapshots e aceleradores no seu GKE. Configure um ambiente de teste com permissões e limites de recursos compatíveis com o fluxo proposto.
- Inicie um notebook reproduzível. Salve a entrada, um checkpoint intermediário da aplicação e um pequeno arquivo de resultado. Registre o horário e a alocação de recursos antes de pausar.
- Pause o ambiente e examine os recursos do cluster. Confira se o pod parou, se o acelerador pode ser agendado e que armazenamento permanece.
- Retome o ambiente. Confira os arquivos e o estado ativo esperados e execute uma célula que use o modelo já carregado. Meça o tempo entre pedir a retomada e ter um notebook utilizável.
- Tente fazer a mesma recuperação com os arquivos salvos e o checkpoint da aplicação. Isso dá uma alternativa e uma comparação se a restauração do snapshot for lenta ou indisponível.
- Revise a configuração de inatividade com a equipe. Decida o que conta como inatividade e se tarefas longas precisam de outro tipo de ambiente ou de tratamento explícito.
Teste a restauração com uma cota limitada ou em um cluster ocupado. Uma demonstração sem problemas em um cluster vazio pode esconder a dificuldade de conseguir capacidade quando várias pessoas voltam juntas. A ideia é entender como o sistema se comporta quando o recurso é escasso.
Calcule para onde vão as horas de GPU
Imagine uma estação de desenvolvimento usada por 40 horas em uma semana. Uma máquina alocada a semana toda soma 168 horas corridas. Se a plataforma puder liberar o nó de GPU sempre que o trabalho parar e restaurá-lo só nessas 40 horas, são 128 horas a menos de nó alocado antes de contar o custo de snapshot e restauração. É um exemplo sem pressupor preços de nuvem ou padrões de uso. Ele representa o limite superior desse padrão de alocação, pois um nó compartilhado ainda pode realizar trabalho útil no mesmo período.
A equipe pode tornar a comparação mais realista com uma referência do próprio conjunto de GPUs. Em cada intervalo de teste, registre as horas do nó, se outra tarefa o ocupou e a quantidade de dados guardados. Anote também o tempo entre pedir a retomada e conseguir executar a próxima célula. Se o nó ficar ligado porque outra carga está ativa, o notebook pausado pode abrir espaço para ela sem baixar a fatura. É um resultado diferente e ainda útil.
O tempo de snapshot entra na conta. Se a pausa demorar enquanto o pod anterior continua alocado, um limite de inatividade agressivo pode gerar mais interrupções e pouca economia de computação. Se a retomada levar vários minutos enquanto o escalonador obtém uma GPU compatível, quem volta de uma pausa curta pode gastar mais tempo esperando do que a política economiza. Meça durações diferentes de inatividade antes de pressupor que toda pausa compensa.
Escolha o que preservar antes de ativar a pausa
O repositório do GKE Workspaces descreve um fluxo sem estado no VS Code e um exemplo separado do JupyterLab com estado. O segundo mostra a restauração de um notebook com GPU, incluindo um modelo Qwen2.5 de 3 bilhões de parâmetros em uma T4. Os snapshots de pods do Kubernetes e o exemplo têm restrições específicas de compatibilidade. A documentação do GKE explica o papel do GKE Sandbox e da configuração compatível de imagem e nó. Para o exemplo com GPU, confira se o nó novo tem o mesmo modelo de GPU compatível e um ambiente adequado antes de depender da restauração.
Decida o que as pessoas esperam ao ver o botão de pausa. Algumas esperam encontrar arquivos, saídas e o estado do editor. Outras esperam que a próxima célula do Python veja um objeto já na RAM ou um modelo na VRAM. Um conjunto de dados compartilhado pode ficar em um armazenamento de objetos externo e fora do snapshot. Anote quais estados o ambiente escolhido consegue restaurar, onde ficam os arquivos comuns e o que fazer se a recuperação falhar.
Outro teste útil é provocar uma falha antes da retomada. Em um namespace de teste, deixe a capacidade compatível temporariamente indisponível e veja se o ambiente mostra uma situação clara, sem criar restaurações concorrentes. Confira se a pessoa responsável consegue recuperar o trabalho de arquivos ou resultados salvos quando o processo em memória não pode voltar. Depois, remova o snapshot de teste e verifique se o armazenamento e as regras de retenção se comportam como previsto.
Leve a visão de custos de volta à equipe
Quem pesquisa quer retomar o trabalho. A equipe de plataforma quer devolver GPUs disputadas ao conjunto compartilhado. Quem cuida da cobrança quer saber se uma alocação realmente deixou de existir. Uma amostra pode responder às três questões se o teste registrar separadamente tempo ocioso, alocação em nós, tamanho dos snapshots, retomadas bem-sucedidas e tempo de recuperação. Inclua instruções para os casos de falha e permita que as pessoas vejam se o ambiente está pausado, aguardando capacidade ou pronto.
Com essa referência, escolha uma política de inatividade por tipo de carga. Uma sessão longa cujo modelo demora a carregar pode se beneficiar da preservação da memória entre turnos. Um experimento breve iniciado por um script salvo pode precisar apenas de arquivos persistentes e um reinício limpo. Os dois podem usar o mesmo conjunto de recursos sem prometer o mesmo tempo de recuperação.
Inclua um teste de retomada na lista de verificação da versão
Uma atualização da plataforma pode mudar a imagem que inicia o ambiente ou o conjunto de nós que fornece GPUs. Antes de liberar a mudança para a equipe, crie um notebook de teste na configuração antiga e veja como ele se comporta na nova. A prova precisa distinguir uma restauração bem-sucedida de uma sessão nova com o mesmo arquivo de notebook aberto. Leia um valor que só existe no processo de teste ativo e confirme que os arquivos usados por ele continuam presentes.
Se a atualização invalidar snapshots antigos, dê às pessoas tempo para salvar resultados críticos e explique a alternativa. Verifique separadamente a limpeza dos snapshots vencidos. Um teste de restauração prova apenas que um ambiente específico consegue voltar. Um teste de limpeza mostra quanto estado obsoleto fica depois que as pessoas deixam de usar o recurso.
Preserve o trabalho mais difícil de refazer
Um ambiente fica mais útil quando as pessoas podem parar de pensar no ciclo de vida da máquina e ainda recuperar o trabalho. Isso depende de tratar arquivos, checkpoints, snapshots e capacidade como questões distintas. Escolha o menor conjunto de estado necessário para retomar com tranquilidade e garanta que o projeto possa ser reproduzido sem a sessão original.
Se sua equipe sabe o que fica no disco, o que precisa ser restaurado e quando a computação volta a ficar disponível, ela pode definir uma política de inatividade que as pessoas de fato usem.
Fontes
-
Exemplo de notebook que pode ser retomado na revisão da demonstração
-
Anúncio de 4 de novembro e demonstração no blog de código aberto do Google
-
Código do GKE Workspaces, situação de suporte e documentação de instalação
Para guardar e encontrar as conversas e decisões que fazem parte do seu trabalho, crie uma conta na Telli.sh.