Quanto sobra de 128 GB com um modelo de IA e o editor de vídeo abertos?
O AI TOP AERO da GIGABYTE reúne até 128 GB de memória unificada em um desktop Windows compacto. Veja como testar um modelo local de legendagem com um projeto real de edição.
Você tem uma entrevista de 20 minutos na linha do tempo e quer um rascunho da transcrição antes de cortar a próxima cena. Pode esperar pelas legendas ou iniciar o modelo de transcrição e continuar editando. A segunda opção é o que torna o AI TOP AERO da GIGABYTE interessante. Ela exige que o hardware dê conta de tarefas simultâneas, uma situação que um modelo rodando sozinho no computador não enfrenta.
No anúncio global, datado de 11 de novembro, a GIGABYTE informa que o desktop foi lançado em 10 de novembro de 2026. O computador compacto com Windows 11 usa NVIDIA RTX Spark N1X com uma CPU Grace de 20 núcleos e uma GPU Blackwell RTX. A fabricante lista até 128 GB de memória de sistema unificada LPDDR5x e até 4 TB de armazenamento em SSD PCIe Gen 5. Para saber as configurações, os preços e a disponibilidade, orienta o público a consultar os anúncios regionais. Anúncio da GIGABYTE e imagem oficial do produto.
Se você está avaliando um computador para legendar, fazer cortes preliminares ou analisar material de vídeo localmente, escolha um projeto e meça o desempenho duas vezes. Rode o mesmo modelo primeiro com o editor aberto e parado, depois enquanto você usa a linha do tempo. Observe quanta memória fica disponível, quanto tempo as legendas levam para sair e se a reprodução continua fluida. Essa comparação mostra o que os 128 GB entregam para quem edita.
Os 128 GB indicam a memória instalada
Um desktop com placa de vídeo dedicada costuma ter memória de sistema e uma reserva separada na própria placa. No RTX Spark, a CPU e a GPU integrada compartilham a memória física. O guia de portabilidade da NVIDIA para Windows on Arm, de 10 de setembro, descreve três regiões lógicas dentro dessa memória. O Windows indica uma região dedicada à GPU que usa a DRAM do sistema, gerencia uma região compartilhada à qual ambos os processadores têm acesso e reserva uma região à CPU fora das alocações da GPU. Guia da NVIDIA sobre a arquitetura de memória unificada.
Essas regiões importam quando um modelo informa seus requisitos e o editor informa um limite de memória da GPU. Os processadores usam os mesmos chips físicos, e o ambiente de execução e o sistema operacional determinam onde cada recurso pode ser alocado. Os dois aplicativos também podem manter cópias próprias dos dados ou reter buffers temporários. Use a capacidade instalada para escolher quais máquinas avaliar e considere os limites e o comportamento observados nos aplicativos ao dimensionar a carga.
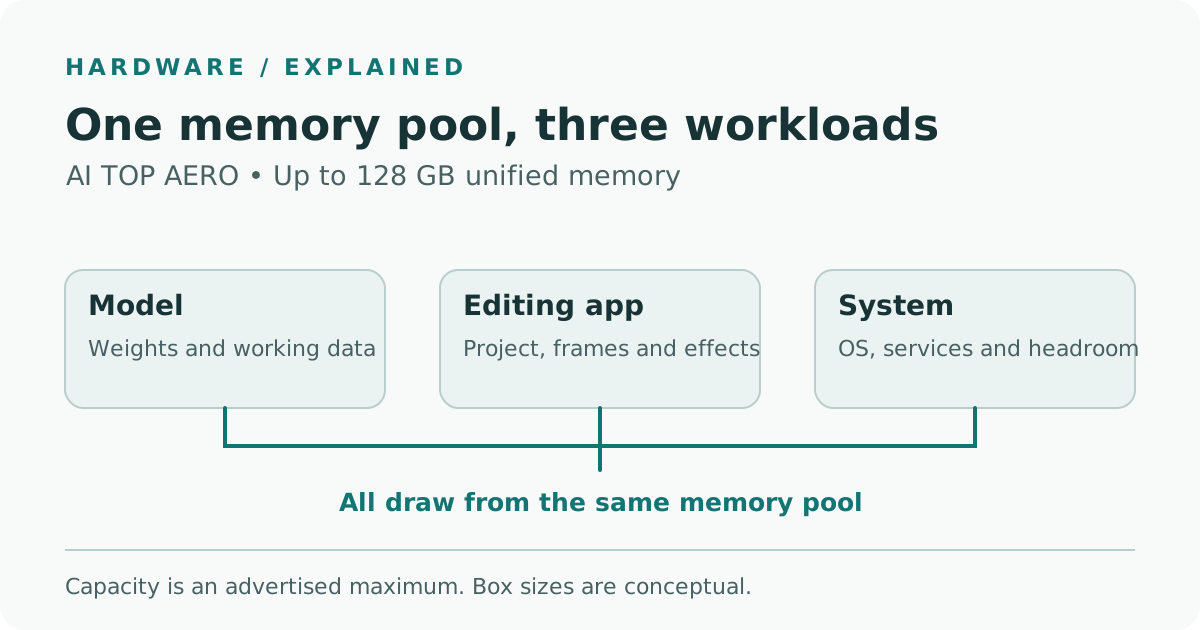
O esquema agrupa as demandas de memória que você pode observar durante uma sessão de edição. Os blocos ilustram o conceito e não representam medições nem o tamanho das partições de firmware.
Vale anotar três números. O primeiro é a memória instalada na configuração exata à venda. O segundo é a memória física disponível indicada pelo Windows no momento de maior atividade. O terceiro é a capacidade utilizável, ou o limite de memória, informado pelo aplicativo ou pelo backend da GPU, quando esse dado está disponível. O primeiro número permanece fixo durante o teste. Os outros dois podem variar conforme a linha do tempo, o modelo e os demais programas abertos recebem trabalho.
| O que medir | O que isso ajuda a entender | O que conferir junto |
|---|---|---|
| Capacidade instalada na unidade exata | Qual configuração está sendo avaliada? | SKU do vendedor e especificação regional |
| Menor valor de memória de sistema disponível durante a execução | Quanta memória física ficou livre na sessão? | Atividade do disco e responsividade no mesmo momento |
| Limite de memória e uso da GPU, quando informados pelo aplicativo | O caminho gráfico ou de IA escolhido está atingindo o limite de trabalho? | Mensagens de transferência do modelo ou de uso de um caminho alternativo e comportamento da linha do tempo |
| Tempo total e interrupções na reprodução | É possível editar enquanto as legendas ficam prontas? | Qualidade da transcrição e consistência em várias execuções |
O Windows oferece aos aplicativos gráficos um orçamento de memória de vídeo que pode variar quando outros aplicativos entram na sessão. Na documentação do DXGI, a Microsoft descreve como ultrapassar esse limite pode causar engasgos ou perda de desempenho. O backend de computação do modelo pode apresentar outro tipo de dado. Anote o que cada valor mede. Somar o total de memória do sistema ao da GPU em uma planilha pode contar duas vezes parte da mesma memória física. Documentação da Microsoft sobre o orçamento de memória do DXGI.
O arquivo do modelo responde por uma parte da carga
Ao baixar um modelo, o tamanho do arquivo é um ponto de partida. O aplicativo em execução também pode precisar de buffers para as entradas e para o processamento intermediário. A memória necessária depende de como o ambiente de execução carrega os pesos, da precisão que usa internamente e do volume de trabalho agrupado por lote. Se você aumentar o número de clipes de áudio processados juntos, meça o aumento no pico de memória e o tempo economizado. Uma configuração que funciona para um clipe curto pode se comportar de outro jeito quando várias tarefas se sobrepõem.
As demandas do editor também mudam. Abrir um projeto pode preencher caches de mídia e reservar recursos gráficos mesmo com a reprodução pausada. Navegar rapidamente pela linha do tempo, pré-visualizar efeitos e exportar podem alterar a atividade da CPU, da GPU e do disco em momentos diferentes. Manter o mesmo projeto e as mesmas configurações de prévia permite medir a carga adicional de uma ação que você pode repetir. Assim dá para separar o custo de deixar o editor aberto do custo de colocá-lo para trabalhar.
Para uma entrevista, use o modelo local para gerar legendas com marcação de tempo e importe o resultado em um formato aceito pelo editor, como SRT. Comece conferindo um minuto mais movimentado, com vozes sobrepostas e nomes próprios. A transcrição precisa chegar ao trecho certo da linha do tempo e reduzir o número de correções. Um rascunho rápido perde o valor se o tempo ganho for gasto movendo legendas ou corrigindo nomes.
Em outro fluxo de trabalho, reúna quadros conferidos de um projeto e peça a um modelo de visão local compatível que sugira etiquetas para os planos. Isso ajuda a encontrar imagens de apoio em vários clipes sem enviar esses quadros a um serviço remoto de inferência, se os aplicativos estiverem configurados para mantê-los no computador. Confira as etiquetas nas imagens originais. Um lote de quadros também serve para testar o efeito da resolução e da quantidade de itens no consumo de memória e no tempo de execução. Compare as saídas antes de abrir mão de detalhes para processar mais imagens.
Confira o fluxo de que você precisa no Windows on Arm
Liste a versão do editor, os plug-ins necessários em trabalhos pagos, o driver da placa de captura ou da interface de áudio e o aplicativo ou ambiente que vai rodar o modelo. Consulte a documentação dos fornecedores para essas versões e para o backend da GPU. Abra um projeto existente com um efeito que você realmente usa. Confira se o editor reproduz a linha do tempo, renderiza o efeito e exporta com o codec que você entrega. Ao mesmo tempo, verifique se o ambiente de execução de IA carrega o modelo e informa que está usando a aceleração esperada.
A Microsoft documenta a emulação de aplicativos de usuário x86 e x64 no Windows 11 on Arm. Suas orientações para desenvolvedores exigem binários Arm64 nativos nos drivers de kernel e destacam plug-ins e dependências de terceiros entre os itens a conferir. Um editor pode abrir o projeto e ainda encontrar problemas ao carregar um plug-in ou se comunicar com um dispositivo. Avalie a compatibilidade em separado das medições de memória para identificar a origem de uma eventual falha. Guia de emulação da Microsoft para Windows on Arm e orientações sobre compatibilidade de aplicativos no Arm.
Procure saber também para onde vão os dados. Rodar a transcrição no desktop dá controle sobre o caminho do áudio original ao arquivo local de legendas. O editor ou o aplicativo de transcrição também pode oferecer opções de processamento em nuvem, monitoramento ou sincronização. Se o projeto contém imagens confidenciais, confirme como essas opções estão ajustadas e teste o fluxo aprovado com material sem conteúdo sensível antes de usá-lo em trabalhos para clientes. Mantenha o resultado e os arquivos intermediários nos locais de armazenamento que pretende usar em um trabalho real.
Cronometre o mesmo modelo com a linha do tempo parada e em reprodução
Escolha um clipe representativo e uma ação de edição que possa repetir. Na entrevista de 20 minutos do exemplo, comece as duas execuções da mesma posição na mesma linha do tempo. Mantenha fixos o arquivo do modelo, a precisão, o backend, o áudio de origem, o formato de saída e as configurações de prévia. Se você sabe que a carga muda bastante em projetos longos, acrescente um teste específico depois de medir o cenário de referência.
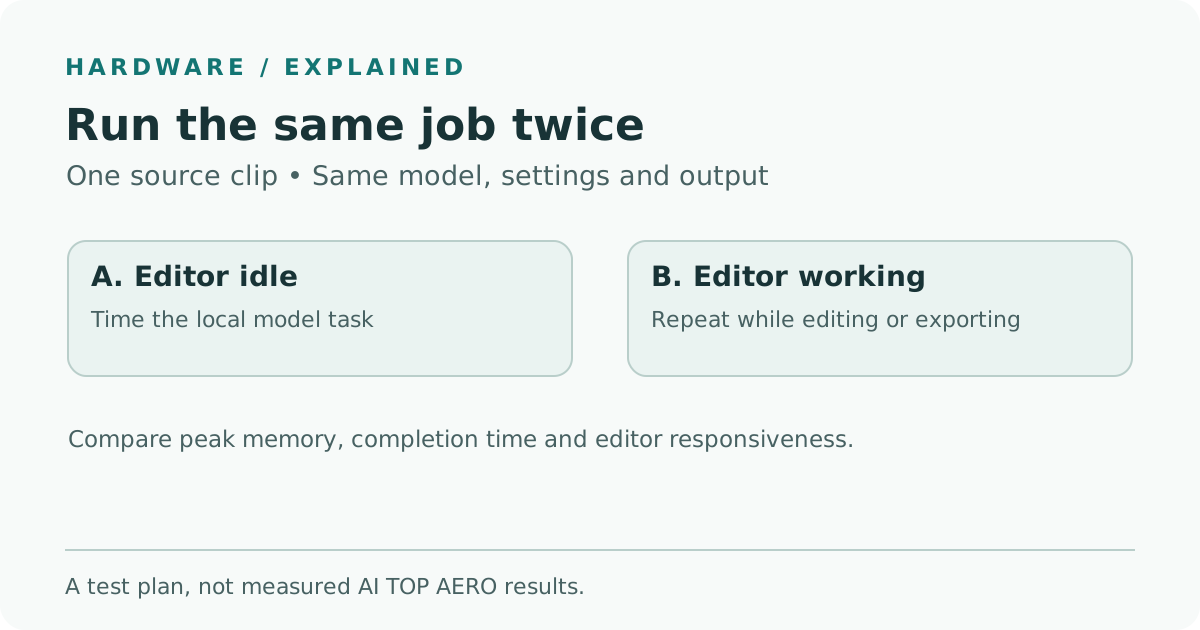
Nas duas execuções, o modelo e o clipe permanecem iguais. Compare a memória disponível, o tempo até as legendas ficarem prontas e a responsividade da linha do tempo com a edição parada e em andamento.
- Registre a configuração inicial. Anote a capacidade instalada, o sistema operacional, o driver da GPU, a versão do editor, a versão do modelo e o caminho de aceleração. Mantenha o mesmo perfil de energia, o mesmo local de armazenamento e as mesmas configurações do projeto. Anote os aplicativos que você costuma deixar abertos.
- Crie uma referência com o editor sozinho. Com o modelo parado, faça uma ação fixa, como reproduzir um trecho marcado de um minuto com os efeitos ativados e sua configuração de prévia habitual. Registre as interrupções ou use o contador de quadros perdidos do editor, se ele oferecer um. A referência mostra como a reprodução se comporta antes da transcrição.
- Rode o modelo com o editor parado. Deixe o projeto aberto com o cursor de reprodução parado. Inicie a legendagem. Registre a memória disponível no início e o menor valor durante o processamento. Anote o tempo até obter o arquivo de legendas e eventuais mensagens do ambiente de execução sobre alocação ou uso de um caminho alternativo. Trate a primeira execução após o carregamento separadamente se quiser medir a contribuição do tempo de inicialização.
- Repita enquanto edita. Inicie a mesma legendagem e faça a sequência de reprodução usada na referência com o editor sozinho. Registre os dois conjuntos de sinais no mesmo intervalo. Confira o rascunho das legendas no mesmo trecho da entrevista após cada execução. Repita cada condição duas ou três vezes para que uma única tarefa em segundo plano não defina a comparação.
- Confira o comportamento contínuo se o trabalho durar muito. Mantenha a carga pretendida por tempo suficiente para incluir várias tarefas ou um bloco representativo. Registre se os tempos de conclusão, a reprodução, o ruído das ventoinhas ou as temperaturas informadas mudam à medida que a máquina aquece. O material de lançamento descreve o projeto de refrigeração da GIGABYTE. O teste mostra o que a unidade específica faz no seu ambiente. Anúncio da GIGABYTE.
A comparação funciona melhor quando você define um limite com antecedência. Um assistente de edição pode precisar das legendas antes da primeira revisão e de uma reprodução fluida o suficiente para fazer cortes. Para uma equipe que processa material durante a noite, pode importar mais o total de arquivos gerados, com pouca necessidade de manter o editor ativo. Use um limite que faça sentido para a tarefa. O mesmo desktop pode servir bem para um desses ritmos e mal para o outro.
Capacidade e velocidade de processamento podem falhar em momentos diferentes
Se ainda há memória disponível com folga e a legendagem só fica mais lenta durante a reprodução da linha do tempo, verifique se tanto o editor quanto o modelo mantêm a GPU ocupada. Observe a atividade da CPU e do disco no mesmo intervalo. Essas medidas indicam onde investigar. Repetir o teste mudando uma configuração por vez pode mostrar se o comportamento acompanha os efeitos da linha do tempo, as leituras em segundo plano ou as tarefas simultâneas do modelo.
Se a memória disponível baixar muito, confira os registros do ambiente de execução e se o sistema está gastando tempo com paginação ou relendo dados. Reduza o lote e teste o mesmo clipe de novo. Ao baixar a precisão ou trocar de modelo, compare também a qualidade das legendas nas mesmas falas. Se os dois programas responderem bem depois de uma dessas mudanças, você terá uma configuração que atende à tarefa e um registro da troca que fez.
Se o modelo funcionar e a reprodução ainda não estiver boa, tente pausar a inferência na revisão em tempo real e rodá-la enquanto faz tarefas que exigem menos da GPU. Assim você usa a mesma máquina e mantém o tratamento dos dados local. Se precisa com frequência fazer uma exportação longa e rodar várias tarefas de IA ao mesmo tempo, teste esse cenário em separado. Se as tarefas disputarem recursos de modo recorrente, os resultados ajudam a decidir se é melhor distribuir o trabalho em horários diferentes ou em outras máquinas.
Escolha o computador para a sessão de edição que quer manter aberta
O desktop compacto da GIGABYTE dá um bom motivo para avaliar a IA local e a criação de conteúdo como uma só carga de trabalho. A configuração mais alta oferece até 128 GB de memória instalada, um ambiente Windows baseado em Arm e uma GPU que os dois aplicativos podem usar. A questão para a compra é quanto você consegue editar enquanto produz legendas ou etiquetas. Peça o SKU local. Se houver uma demonstração prática, leve seu próprio clipe e os plug-ins indispensáveis e compare os resultados no mesmo minuto com os do computador que já usa.
A especificação ganha valor quando leva a uma sessão que você consegue reproduzir. Se o modelo termina dentro do prazo, a linha do tempo continua responsiva e a importação das legendas funciona, você sabe o que esperar do desktop da próxima vez que chegar uma entrevista.
Fontes
- Anúncio global da GIGABYTE de 11 de novembro de 2026, com data de lançamento de 10 de novembro, especificações e imagem oficial
- Guia de portabilidade da NVIDIA para Windows on Arm, arquitetura de memória unificada, atualizado em 10 de setembro de 2026
- Referência da Microsoft sobre o orçamento de memória de vídeo para aplicativos gráficos
- Guia de emulação da Microsoft para Windows on Arm
- Orientações da Microsoft sobre compatibilidade de aplicativos e drivers com Arm
Para reunir transcrições revisadas e notas do projeto, crie uma conta no Telli.sh.