A promessa mais difícil do Gemini 4 Carbon: trabalho útil depois do primeiro dia
O novo modelo de fronteira do Google prioriza engenharia prolongada e defesa cibernética. Entenda o acesso por etapas, os benchmarks e os limites práticos de uma tarefa de vários dias.
Um bug difícil raramente chega como um exercício organizado de programação. Aparece como relato, falha intermitente ou sintoma a várias camadas da causa. O trabalho útil pode envolver ler o histórico, testar explicações concorrentes e descartar uma correção que parecia promissora uma hora antes.
O Google anunciou o Gemini 4 Carbon em 28 de outubro de 2026, enfatizando engenharia de longo horizonte e defesa cibernética. O Google DeepMind afirma que equipes internas viram o modelo persistir por dias em trabalhos complexos, incluindo bugs sutis em grandes bases de código. É uma observação interna, não uma promessa de que toda tarefa de cliente funcionará por dias. O anúncio do Google também esclarece o acesso: a disponibilidade inicial é para defensores cibernéticos selecionados, com mais parceiros de confiança pelo Fairwind e ampliação planejada.
A pergunta prática é o que um modelo de execução prolongada deve deixar para trás. Este guia explica a posição do modelo, como ler as comparações publicadas e como preparar uma tarefa de engenharia que continue revisável depois de muitas horas.
 Exemplo de quadro de tarefas Scrumban de 2013, ilustrando estados visíveis em um projeto contínuo. Não é interface do Gemini ou resultado do modelo. Imagem: Dr ian mitchell, CC BY-SA 3.0; redimensionada com margens. Fonte da imagem · Licença e notas da imagem. Referência oficial do produto.

A duração só é útil quando a tarefa preserva seu sentido
Um agente pode continuar ocupado sem esclarecer o problema. Pode buscar mais arquivos, tentar mais correções e executar mais comandos enquanto se afasta da falha original. Mais tempo amplia a oportunidade de progresso e de acumular suposições erradas. O desafio do produto é preservar a finalidade da tarefa durante essa atividade.
Nossa avaliação é que uma tarefa prolongada precisa de um contrato duradouro. Ele declara problema, evidência que comprovaria a correção, escopo permitido e ações que ainda exigem uma pessoa. Deve sobreviver às mudanças de hipótese e implementação. Caso contrário, o modelo pode chegar a um final convincente resolvendo um problema mais fácil que o solicitado.
Considere um bug ilustrativo de sincronização. O relato diz que um item parece salvo, mas desaparece ao atualizar. Uma tarefa útil é reproduzir o comportamento, identificar a falha de responsabilidade ou persistência, propor correção delimitada e verificar o mesmo caminho visível ao usuário. Um resultado menos útil é uma grande refatoração com um teste aprovado que nunca exercitou a atualização.
A distinção importa mais com o tempo. Depois de horas, revisores precisam de um registro das evidências mais fortes e incertezas restantes, não de uma transcrição de todos os comandos. O registro deve dizer onde continuar se a execução parar e o que justificaria aceitar o resultado.
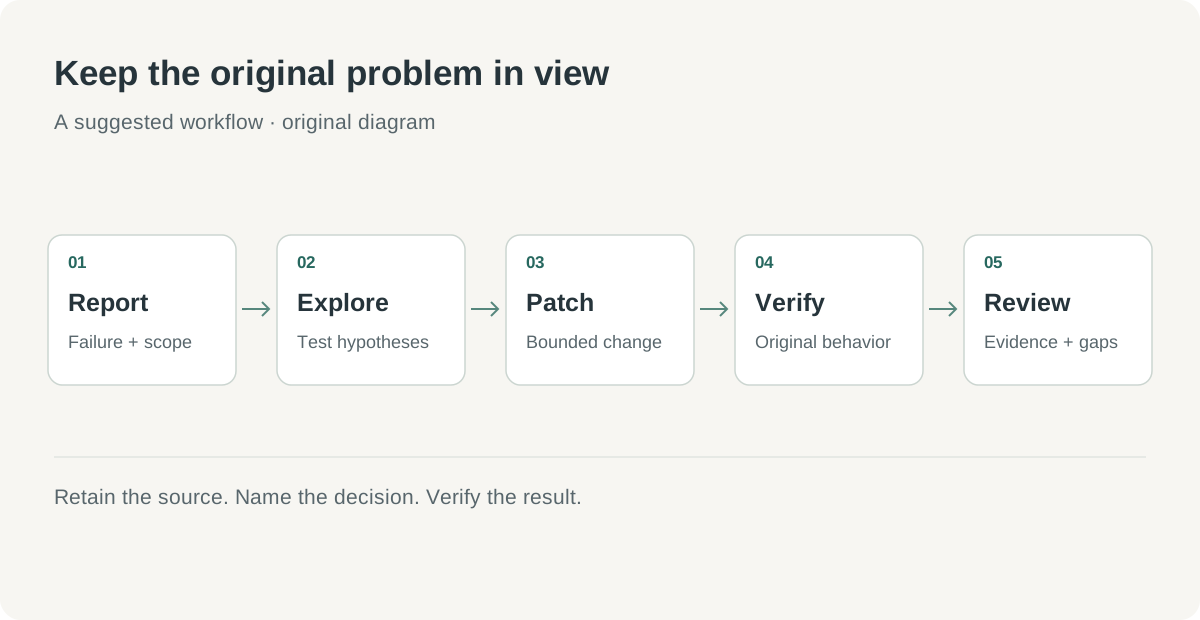 Diagrama original: trabalho sustentado deve produzir uma correção rastreável, preservando o critério original de aceitação durante a exploração.
As comparações do Carbon descrevem trabalhos de tipos diferentes
A página de comparação do Google DeepMind, consultada em 2 de novembro, lista Carbon e Argon em várias avaliações. Por exemplo, informa 65.2% contra 57.1% no Terminal-Bench 4.0 e 61.2% contra 55.0% no FrontierSWE 2. São resultados publicados com nomes e condições distintos; não devem ser somados em uma taxa única de sucesso do produto.
A equipe deve começar pela tarefa semelhante ao próprio processo. Terminal, reparo de repositório e trabalho em navegador exigem coisas diferentes. Um modelo forte em uma avaliação ainda pode precisar de outra configuração de ferramentas ou mais contexto humano em produção. O benchmark ajuda a escolher um experimento; o comportamento do repositório determina seu sucesso.
| Pergunta de avaliação | Evidência a buscar no piloto | O que a nota do benchmark deixa em aberto |
|---|---|---|
| O agente encontra a causa? | Reprodução e explicação causal sustentada | Se a falha da equipe está representada no benchmark |
| Corrige o comportamento? | Mudança focada e verificação de regressão | Se contratos ocultos de integração ficam intactos |
| Usa ferramentas com responsabilidade? | Permissões claras e ações verificáveis | Se a configuração de produção corresponde à avaliação |
| Outro engenheiro consegue revisar? | Alterações concisas, resultados e lacunas | Quanto esforço exigem os padrões da equipe |
| O trabalho pode parar e retomar? | Estado preservado e entrega acionável | Se o sistema do agente preserva os artefatos necessários |
A tabela é uma estrutura de avaliação, não uma reprodução da metodologia do Google. Transforma uma capacidade ampla em perguntas respondíveis pela equipe. Um resultado local forte deve incluir falhas e etapas bloqueadas para mostrar onde o modelo ajuda e onde o processo ao redor ainda precisa melhorar.
A comparação também exige referência estável. Mantenha revisão do repositório, permissões, enunciado e ambiente iguais ao comparar configurações. Se uma execução recebe a reprodução e outra precisa descobri-la, a diferença de tempo não isola o modelo. Registre condições antes de interpretar o resultado.
Defesa cibernética precisa ligar a descoberta à correção verificada
O anúncio de 28 de outubro informa notas do Carbon de 88.2% no SEC-bench Pro, 54.8% no ExploitGym e 71.0% no CWE-bench, observando que essas avaliações externas foram feitas sem mecanismos de proteção. Os números tratam de tarefas diferentes de localizar, validar e corrigir vulnerabilidades. O anúncio do Google é a fonte dos resultados publicados pelo fornecedor.
Para um defensor, a sequência útil começa com um alvo autorizado e uma descoberta examinável. A validação deve estabelecer o risco no ambiente combinado. A correção precisa resolver a causa e preservar o comportamento legítimo. As etapas exigem evidências diferentes, mesmo com um agente ajudando em todas.
Uma revisão ilustrativa de biblioteca interna mostra a diferença. A equipe dá ao agente uma cópia isolada e uma preocupação definida sobre tratamento de entrada. O resultado desejado é uma descoberta específica, uma reprodução delimitada no teste e uma correção com cobertura de regressão. O agente não deve expandir a tarefa a sistemas alheios só porque encontra links ou credenciais no projeto.
Um segundo cenário ilustrativo é triar um relato existente. O agente pode conectar o relato aos caminhos do código e determinar testes que distinguem um problema real de uma suposição incorreta. Uma conclusão útil de “não é necessário corrigir” também exige evidência. Encerrar com explicação confiante é mais fraco que mostrar por que o caminho alegado não se aplica à revisão avaliada.
O responsável final continua sendo a equipe de engenharia ou segurança do sistema. Uma proposta precisa de revisão contra fronteira real do serviço, processo de implantação e requisitos de compatibilidade. Testes isolados bem-sucedidos são parte da decisão; implantação e monitoramento de produção continuam etapas separadas.
O resultado de segurança de um modelo não define suas permissões de implantação
O Google descreve melhorias de alinhamento, resistência à injeção de prompts e redução de afirmações sem sustentação. São áreas relevantes para um modelo que continua trabalhando em meio à ambiguidade. A implicação operacional é avaliá-las no processo pretendido, não tratar um destaque de segurança como autorização para conectar todas as ferramentas.
Trabalhos prolongados se beneficiam de autoridade por etapas. Ler um repositório, alterar um checkout isolado e implantar um serviço são ações diferentes. A equipe pode permitir coleta de evidências e preparação de mudanças revisáveis mantendo aprovação distinta para publicar ou afetar a produção. A fronteira deve ser aplicada pelo ambiente, além de descrita na tarefa.
Material não confiável cria outra preocupação. Arquivos, descrições de tickets e páginas podem conter instruções conflitantes com o trabalho atribuído. Um sistema bem projetado separa autoridade da tarefa e conteúdo lido. As evidências de revisão devem revelar mudanças inesperadas de escopo, sobretudo quando a execução dura tanto que ninguém observa cada ação.
O mesmo vale para credenciais. Dê apenas o acesso necessário e prefira um ambiente em que ações acidentais tenham efeito delimitado. Um piloto útil verifica se o modelo pede contexto ausente e deixa um estado honesto de bloqueio. Isso importa tanto quanto quantos arquivos altera antes de parar.
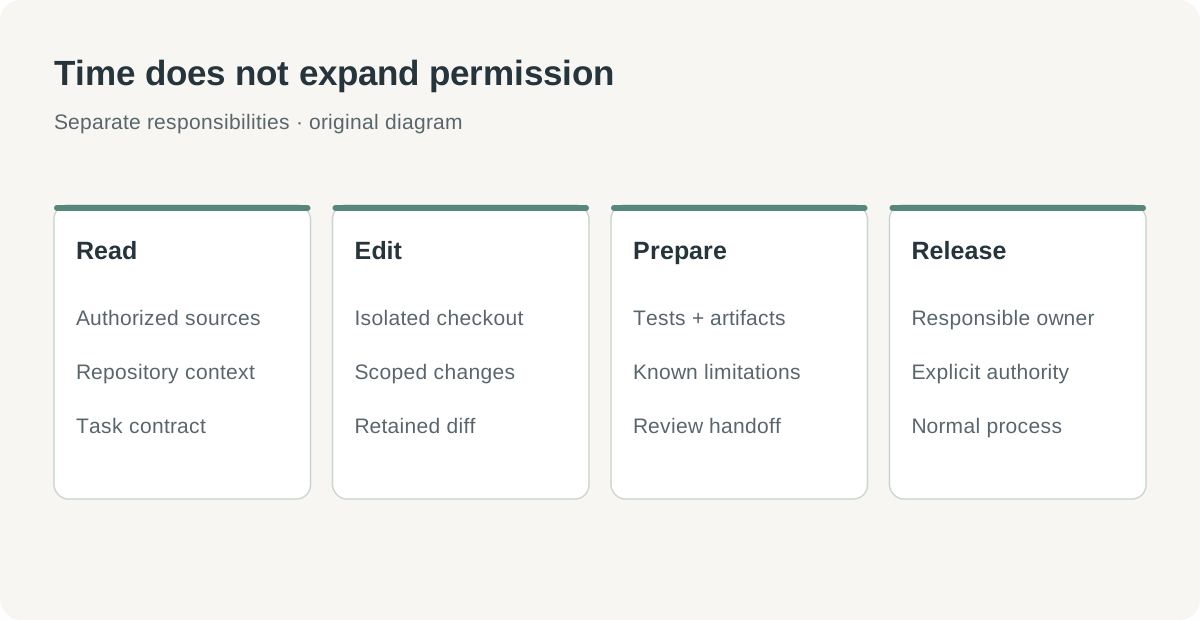 Diagrama original de autoridade: mais tempo de execução não amplia permissões automaticamente. Cada etapa tem responsável e condição de conclusão distintos.
O acesso por etapas dá à maioria das equipes primeiro uma tarefa de preparação
O lançamento público descreve acesso a defensores selecionados, depois a mais parceiros Fairwind de confiança; as interfaces gerais para desenvolvedores, empresas e consumidores ainda virão. Anunciar um modelo e disponibilizar amplamente um produto são eventos separados. Confira o caminho atual pelos canais oficiais antes de planejar uma entrega dependente do Carbon. Anúncio de 28 de outubro, consultado em 2 de novembro de 2026.
Equipes sem acesso ainda podem preparar trabalho útil. Escolha uma tarefa difícil, mas delimitada, preserve a revisão relevante e reúna as evidências que a tornam difícil. Defina testes e expectativas do revisor. A preparação poderá ser reutilizada quando houver acesso e melhora as comparações com ferramentas disponíveis hoje.
Evite tratar a preparação como promessa de conclusão sem supervisão. Uma boa tarefa pode revelar infraestrutura de testes ausente, responsabilidade pouco clara ou reprodução instável antes de qualquer modelo novo executar. Corrigir isso melhora a engenharia independentemente do modelo que fará a exploração.
Um terceiro uso ilustrativo é um defeito entre camadas da aplicação. O estado do frontend parece correto, mas o servidor armazena outro valor. A tarefa pode exigir rastreamento completo de solicitação, persistência e interface atualizada, seguido de correção restrita. O valor do raciocínio sustentado é manter essas camadas conectadas, não apenas gerar mais código em cada uma.
O custo de uma tarefa longa inclui revisão e recuperação
Preços publicados de tokens são apenas parte de um trabalho prolongado. Ferramentas, contexto repetido, infraestrutura de testes e revisão de engenheiros compõem o custo real. Uma tarefa terminada com correção legível e sustentada pode valer mais que uma execução barata que deixa horas de incerteza ao revisor.
No primeiro piloto, defina um limite de tempo e gasto no sistema quando possível. Decida qual evidência precisa existir para prolongar a execução. Uma tarefa parada deve deixar um ponto útil de retomada: último fato confirmado, hipótese restante mais forte e próximo teste. A continuação se torna decisão por progresso, não esperança de que mais tempo ajude.
A carga de revisão também é mensurável. Acompanhe se um colega entende a causa, examina as alterações e reproduz os controles sem refazer a sessão inteira. Se não, melhore o formato da entrega antes de ampliar a autoridade. Uma tarefa longa deve condensar a incerteza da equipe, não transferi-la a um documento maior.
Comece com uma correção que tenha uma linha de chegada clara
- Confirme o acesso disponível e o modelo exato oferecido. Separe o lançamento anunciado do Carbon do acesso a outro Gemini.
- Selecione tarefa autorizada e isolada, revisão estável e falha reproduzível. Evite depender de produção não controlada na primeira avaliação.
- Escreva o critério de aceitação em termos de comportamento do sistema ou visível ao usuário. Inclua contratos preservados e ações externas que exigem aprovação.
- Forneça ferramentas necessárias e permissões mínimas. Preserve mudanças, registros e artefatos de teste acessíveis a outro engenheiro.
- Exija pontos de controle que distingam evidência confirmada, hipóteses e bloqueios. Revise antes de ampliar escopo ou orçamento.
- Avalie a correção contra a falha original e a suíte de regressão afetada. Examine mudanças alheias e migrações ocultas de contratos.
- Peça a um revisor responsável que decida se a correção está pronta para o processo normal de lançamento. Registre explicitamente controles incompletos e verificação externa necessária.
Inclua uma condição deliberadamente inconveniente, como um teste alheio falhando ou um serviço opcional indisponível. Observe se a entrega separa essa limitação das evidências reais da correção. Um modelo que informa uma lacuna honesta é mais fácil de integrar que um que transforma toda incerteza em conclusão.
Um agente de vários dias deve deixar um caminho mais curto até a decisão
O anúncio do Carbon aponta outra expectativa para IA de programação: persistir entre caminhos sem saída e produzir uma correção que mereça revisão. O sistema de engenharia precisa tornar essa persistência útil. Escopo claro, evidências preservadas e autoridade delimitada dão ao modelo uma tarefa com conclusão significativa.
Nossa expectativa é que as melhores avaliações foquem a qualidade da entrega. O modelo preservou a pergunta original? Identificou o que realmente falhou? Um engenheiro verifica o resultado e decide o próximo passo? Essas perguntas ligam execução longa a um resultado prático de engenharia.
A promessa da IA prolongada é encurtar o caminho de um relato difícil a uma decisão justificada. O tempo trabalhando ganha valor quando a próxima pessoa pode confiar no que ficou.
Fontes
- Google: apresentação do Gemini 4 Carbon, 28 de outubro de 2026; consultado em 2 de novembro de 2026. Observações internas e benchmarks são atribuídos ao Google.
- Google DeepMind: comparação dos modelos Gemini, consultada em 2 de novembro de 2026. Versões e condições dos benchmarks devem acompanhar as notas.
Mantenha uma decisão de engenharia conectada à fonte
O Telli.sh é uma opção para guardar fontes autorizadas e as notas por trás de uma decisão de engenharia. Criar um espaço de notas.