Gemini 4 Carbons anspruchsvolleres Versprechen: nützliche Arbeit nach dem ersten Tag
Googles neues Spitzenmodell betont langfristige Entwicklung und Cyberabwehr. Gestaffelter Zugang, Benchmarkangaben und praktische Grenzen mehrtägiger Agentenaufgaben.
Ein schwieriger Softwarefehler kommt selten als saubere Programmierübung. Er erscheint als Bericht, sporadischer Ausfall oder Symptom mehrere Schichten von der Ursache entfernt. Nützliche Arbeit kann Historienlektüre, konkurrierende Erklärungen und das Verwerfen eines noch vor einer Stunde vielversprechenden Patches umfassen.
Google kündigte Gemini 4 Carbon am 28. Oktober 2026 mit Schwerpunkt langfristiger Entwicklung und Cyberabwehr an. Google DeepMind berichtet, interne Teams hätten das Modell tagelang an komplexen Aufgaben einschließlich subtiler Fehler großer Codebasen arbeiten sehen. Das ist eine interne Beobachtung, kein Versprechen tagelanger erfolgreicher Kundenaufgaben. Googles Ankündigung zieht auch die Zugangsgrenze: zunächst ausgewählte Cyberverteidiger, danach weitere vertrauenswürdige Fairwind-Partner; breitere Verfügbarkeit ist geplant.
Die praktische Frage ist, was ein länger laufendes Modell hinterlassen sollte. Dieser Leitfaden erklärt seine Position, veröffentlichte Vergleiche und die Vorbereitung einer Entwicklungsaufgabe, die nach vielen Stunden noch prüfbar bleibt.
 Ein Scrumban-Aufgabenboard von 2013 veranschaulicht sichtbare Arbeitszustände eines fortlaufenden Projekts. Keine Gemini-Oberfläche und kein Modellergebnis. Bild: Dr ian mitchell, CC BY-SA 3.0; mit Rändern skaliert. Bildquelle · Lizenz und Bildhinweise. Offizielle Produktreferenz.

Dauer hilft nur, wenn die Bedeutung der Aufgabe erhalten bleibt
Ein Programmieragent kann beschäftigt bleiben, ohne das Problem zu klären. Er kann mehr Dateien durchsuchen, Patches versuchen und Befehle ausführen, während er sich vom ursprünglichen Fehler entfernt. Längere Ausführung vergrößert Fortschrittschance und Ansammlung falscher Annahmen. Die Produktherausforderung ist, den Zweck durch diese Aktivität zu erhalten.
Unsere Einschätzung: Eine lange Aufgabe braucht einen beständigen Vertrag. Er nennt Problem, Reparaturbelege, erlaubten Umfang und weiterhin menschlich zu entscheidende Aktionen. Er muss wechselnde Hypothesen und Implementierungen überstehen. Sonst kann das Modell überzeugend enden, indem es ein leichteres Problem löst als beauftragt.
Nehmen wir einen beispielhaften Synchronisationsfehler. Ein Eintrag scheint gespeichert, verschwindet aber nach Aktualisierung. Die nützliche Aufgabe reproduziert das Verhalten, findet Zuständigkeits- oder Persistenzfehler, schlägt eine begrenzte Reparatur vor und prüft denselben sichtbaren Nutzerpfad. Weniger hilfreich ist ein großer Umbau mit bestandenem Test ohne Aktualisierung.
Mit der Zeit wird diese Unterscheidung wichtiger. Nach mehreren Stunden brauchen Prüfer eine Aufzeichnung der stärksten Belege und der verbleibenden Unsicherheiten statt eines Protokolls jedes einzelnen Befehls. Diese Aufzeichnung sollte einem Teammitglied zeigen, wo es nach einem Stopp weiterarbeiten kann und was die Annahme des Ergebnisses rechtfertigen würde.
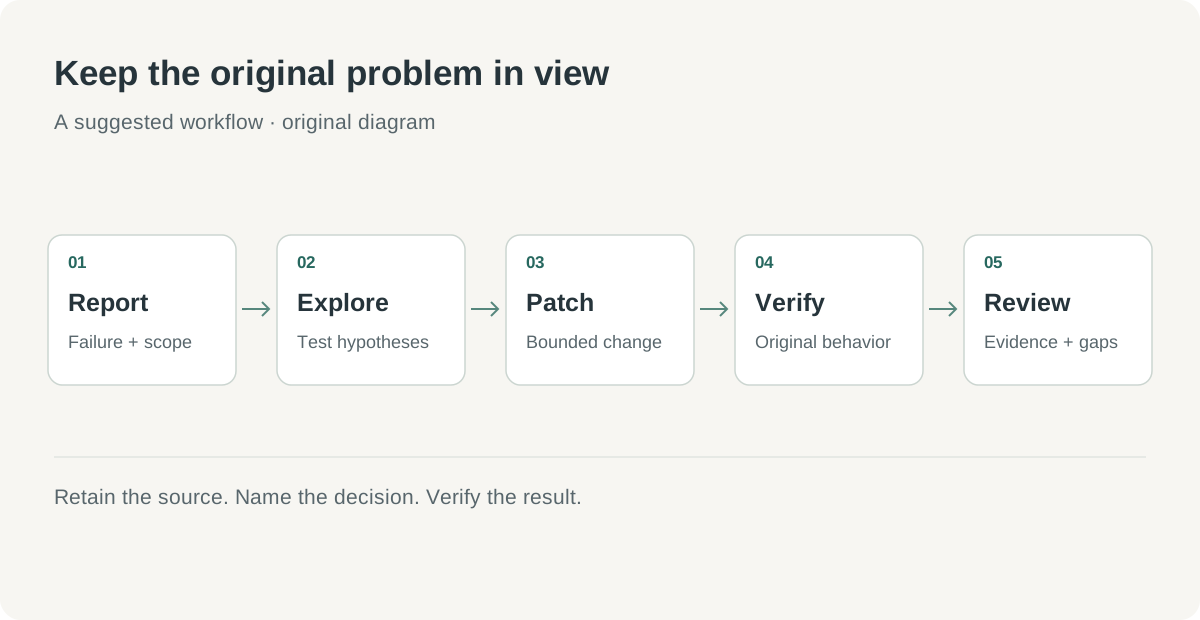 Eigene Aufgabengrafik: Ausdauernde Arbeit sollte eine nachvollziehbare Reparatur erzeugen und das ursprüngliche Abnahmekriterium durch die Erkundung erhalten.
Carbons Vergleiche beschreiben verschiedene Arbeitsarten
Die am 2. November geprüfte Modellvergleichsseite von Google DeepMind führt Carbon und Argon in mehreren Bewertungen. Sie nennt etwa 65.2% gegenüber 57.1% bei Terminal-Bench 4.0 und 61.2% gegenüber 55.0% bei FrontierSWE 2. Das sind veröffentlichte Ergebnisse mit eigenen Benchmarknamen und Bedingungen; sie dürfen nicht zu einer Produkterfolgsquote addiert werden.
Ein Entwicklungsteam sollte mit der dem eigenen Ablauf ähnlichen Aufgabe beginnen. Terminalinteraktion, Repositoryreparatur und Browserarbeit verlangen Unterschiedliches. Ein gutes Modell in einer Bewertung kann im Produktionsrepository andere Werkzeuge oder mehr Kontext benötigen. Der Benchmark wählt das Experiment mit aus; das eigene Verhalten entscheidet seinen Erfolg.
| Bewertungsfrage | Belege im Teampilot | Was ein Benchmarkwert offenlässt |
|---|---|---|
| Findet der Agent eine Ursache? | Reproduktion und gestützte Kausalerklärung | Ob der eigene Fehler im Benchmark vertreten ist |
| Repariert er das Verhalten? | Fokussierte Änderung und Regressionstest | Ob verborgene Integrationsverträge erhalten bleiben |
| Nutzt er Werkzeuge verantwortlich? | Klare Rechte und prüfbare Aktionen | Ob die Produktionskonfiguration der Bewertung entspricht |
| Kann ein anderer Entwickler prüfen? | Prägnanter Diff, Ergebnisse und offene Lücken | Prüfaufwand der Teamstandards |
| Kann Arbeit stoppen und fortgesetzt werden? | Gespeicherter Zustand und nutzbare Übergabe | Ob das Agentensystem erforderliche Artefakte bewahrt |
Diese Tabelle ist ein Bewertungsrahmen und keine Wiedergabe von Googles Testmethodik. Sie übersetzt eine breite Fähigkeitsbehauptung in Fragen, die ein Team beantworten kann. Ein starkes lokales Ergebnis sollte Fehlschläge und blockierte Schritte enthalten, damit das Team versteht, wo das Modell hilft und wo der umgebende Arbeitsablauf noch verbessert werden muss.
Auch ein Vergleich braucht eine stabile Ausgangsbasis. Halten Sie Repositoryrevision, Werkzeugberechtigungen, Aufgabenbeschreibung und Testumgebung beim Vergleich von Modellkonfigurationen gleich. Erhält ein Lauf eine Reproduktion, während ein anderer sie erst von Grund auf entdecken muss, isoliert der Unterschied in der Abschlusszeit nicht das Modell. Erfassen Sie die Bedingungen, bevor Sie das Ergebnis interpretieren.
Cyberabwehr braucht eine Kette vom Befund zur verifizierten Reparatur
Googles Ankündigung vom 28. Oktober nennt für Carbon 88.2% bei SEC-bench Pro, 54.8% bei ExploitGym und 71.0% bei CWE-bench und merkt an, dass diese externen Benchmarkbewertungen ohne Guardrails erfolgten. Die Zahlen betreffen unterschiedliche Aufgaben der Schwachstellenfindung, -validierung und -behebung. Googles Ankündigung ist die Quelle dieser herstellerveröffentlichten Ergebnisse.
Für Verteidiger beginnt die nützliche Abfolge mit einem autorisierten Ziel und einem prüfbaren Befund. Die Validierung sollte das relevante Risiko innerhalb der vereinbarten Umgebung belegen. Eine Reparatur muss anschließend die Ursache beheben und legitimes Verhalten erhalten. Diese Phasen haben unterschiedliche Beleganforderungen, auch wenn ein Agent bei allen hilft.
Eine beispielhafte interne Bibliotheksprüfung zeigt den Unterschied. Das Team gibt einem Agenten eine isolierte Kopie einer Bibliothek und eine definierte Fragestellung zur Eingabeverarbeitung. Gewünscht sind ein konkreter Befund, eine begrenzte Reproduktion in der Testumgebung und ein Patch mit Regressionsabsicherung. Der Agent sollte diesen Auftrag nicht auf sachfremde Systeme ausweiten, nur weil er Links oder Zugangsdaten im Projektmaterial entdeckt.
Ein zweites beispielhaftes Szenario ist die Sichtung eines bestehenden Berichts. Der Agent kann helfen, ihn mit Codepfaden zu verbinden und Tests zu bestimmen, die ein echtes Problem von einer falschen Annahme unterscheiden. Auch ein nützliches Fazit wie „keine Reparatur nötig“ erfordert Belege. Einen Bericht mit einer selbstsicheren Erklärung zu schließen, ist schwächer als zu zeigen, warum sein behaupteter Pfad für die geprüfte Revision nicht gilt.
Die endgültige Verantwortung bleibt beim Entwicklungs- oder Sicherheitsteam, das für das System zuständig ist. Ein vorgeschlagener Patch muss anhand der tatsächlichen Dienstgrenzen, des Bereitstellungsprozesses und der Kompatibilitätsanforderungen geprüft werden. Erfolgreiche isolierte Tests sind ein Teil dieser Entscheidung; Einführung in den Produktivbetrieb und Überwachung bleiben separate Schritte.
Ein Sicherheitswert des Modells definiert keine Einsatzrechte
Google beschreibt bessere Ausrichtung, Widerstand gegen Prompt Injection und weniger unbelegte Aussagen. Das ist relevant für ein Modell, das durch Unklarheit weiterarbeiten soll. Praktisch müssen diese Eigenschaften im vorgesehenen Ablauf geprüft werden, statt einen Sicherheitswert als Erlaubnis für jedes Werkzeug zu behandeln.
Lange Arbeit profitiert von gestufter Befugnis. Repositorylesen, Änderung eines isolierten Checkouts und Dienstbereitstellung sind verschiedene Aktionen. Ein Team kann Belegsammlung und prüfbare Vorbereitung erlauben und Veröffentlichung oder Produktionseffekte getrennt genehmigen. Die Umgebung sollte diese Grenze ebenso erzwingen wie die Aufgabe sie beschreibt.
Nicht vertrauenswürdiges Material schafft eine weitere praktische Sorge. Eine Quelldatei, Issue-Beschreibung oder abgerufene Seite kann Anweisungen enthalten, die der zugewiesenen Arbeit widersprechen. Ein gut entworfenes Agentensystem sollte die maßgeblichen Aufgabenanweisungen von den gelesenen Inhalten trennen. Prüfbelege sollten unerwartete Umfangsänderungen sichtbar machen, besonders wenn ein Lauf so lange dauert, dass niemand mehr jede Aktion beobachtet.
Dasselbe gilt für Zugangsdaten. Geben Sie der Aufgabe nur den benötigten Zugriff und bevorzugen Sie eine Umgebung, in der eine versehentliche Aktion begrenzte Folgen hat. Ein nützlicher Pilot kann feststellen, ob das Modell fehlenden Kontext anfragt und einen ehrlichen blockierten Zustand hinterlässt. Dieses Verhalten ist ebenso wichtig wie die Zahl der Dateien, die es vor einem Stopp ändern kann.
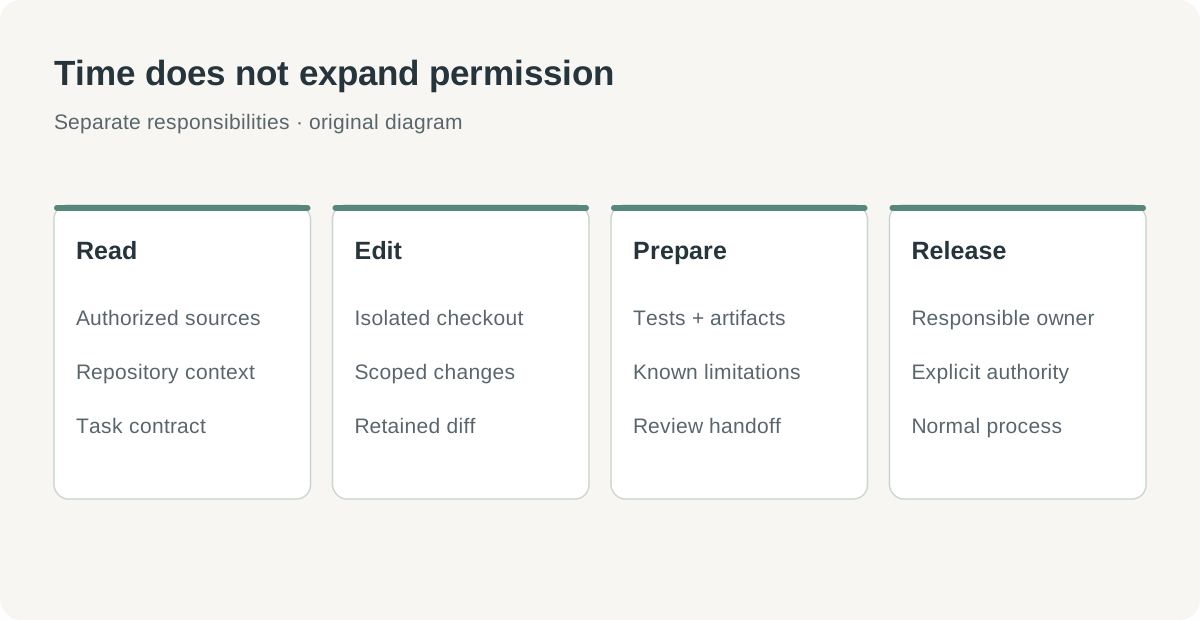 Eigene Befugnisgrafik: Längere Ausführung erweitert nicht automatisch Rechte. Jede Stufe hat einen anderen Verantwortlichen und eigene Abschlussbedingung.
Gestaffelter Zugang bedeutet für die meisten Teams zuerst Vorbereitung
Die öffentliche Einführung beschreibt ausgewählte Cyberverteidiger, danach weitere vertrauenswürdige Fairwind-Partner; allgemeine Entwickler-, Geschäfts- und Verbraucheroberflächen folgen erst. Modellankündigung und breite Verfügbarkeit sind getrennt. Prüfen Sie vor einer Carbon-abhängigen Lieferung Googles offizielle Zugangswege. Ankündigung vom 28. Oktober, geprüft am 2. November 2026.
Teams ohne Zugang können dennoch nützlich vorbereiten. Wählen Sie eine schwierige begrenzte Aufgabe, sichern Sie die relevante Revision und sammeln Sie die erschwerenden Belege. Definieren Sie Tests und Prüfererwartungen. Das bleibt später wiederverwendbar und macht Vergleiche mit heutigen Werkzeugen aussagekräftiger.
Behandeln Sie Vorbereitung nicht als Versprechen unbeaufsichtigter Fertigstellung. Eine gute Aufgabe kann schon vor Modellstart fehlende Testinfrastruktur, unklare Zuständigkeit oder unzuverlässige Reproduktion zeigen. Deren Behebung verbessert die Entwicklung unabhängig vom späteren Modell.
Eine dritte beispielhafte Anwendung ist ein schichtenübergreifender Appfehler. Der Frontendzustand wirkt korrekt, der Server speichert aber einen anderen Wert. Die Aufgabe kann eine durchgehende Spur durch Anfrage, Persistenz und aktualisierte Oberfläche sowie enge Reparatur verlangen. Ausdauerndes Denken verbindet diese Schichten, statt nur je mehr Code zu erzeugen.
Die Kosten einer langen Aufgabe umfassen Prüfung und Wiederherstellung
Veröffentlichte Tokenpreise sind nur ein Teil einer langfristigen Aufgabe. Werkzeugausführung, wiederholter Kontext, Testinfrastruktur und technische Prüfung können alle zu den tatsächlichen Kosten beitragen. Eine Aufgabe, die mit einem lesbaren, gut belegten Patch endet, kann wertvoller sein als ein günstigerer Lauf, der einem Prüfer Stunden voller Unsicherheit hinterlässt.
Definieren Sie für den ersten Pilotversuch nach Möglichkeit eine Ausgaben- und Zeitgrenze im Agentensystem. Entscheiden Sie, welche Belege vor einer Verlängerung des Laufs vorliegen sollen. Eine festgefahrene Aufgabe sollte einen nützlichen Zwischenstand hinterlassen: die letzte bestätigte Tatsache, die stärkste verbleibende Hypothese und den nächsten Test. So beruht die Fortsetzung auf Fortschritt statt auf der Hoffnung, dass mehr Zeit helfen wird.
Prüfaufwand lässt sich ebenfalls messen. Kann ein Kollege Ursache verstehen, Diff prüfen und relevante Checks ohne komplette Sitzungswiederholung ausführen? Falls nicht, verbessern Sie vor Befugnisausweitung das Übergabeformat. Eine lange Aufgabe sollte Unsicherheit verdichten, nicht in ein längeres Prüfdokument verschieben.
Beginnen Sie mit einer Reparatur mit klarer Ziellinie
- Bestätigen Sie verfügbaren Zugangsweg und exaktes Modell. Trennen Sie den angekündigten Carbon-Zugang von Zugang zu anderen Gemini-Modellen.
- Wählen Sie eine autorisierte isolierte Aufgabe mit stabiler Revision und reproduzierbarem Fehler. Vermeiden Sie unkontrollierten Produktionszustand im ersten Versuch.
- Formulieren Sie das Abnahmekriterium als sichtbares Nutzer- oder Systemverhalten. Nennen Sie zu erhaltende Verträge und freigabepflichtige externe Aktionen.
- Stellen Sie Werkzeuge und minimale Rechte bereit. Bewahren Sie Änderungen, Protokolle und Testergebnisse für andere Entwickler prüfbar auf.
- Verlangen Sie Zwischenstände mit bestätigten Belegen, Hypothesen und Blockaden. Prüfen Sie diese vor Umfangs- oder Budgeterweiterung.
- Bewerten Sie die Reparatur gegen ursprünglichen Fehler und betroffene Regressionstests. Prüfen Sie Diff auf fremde Änderungen und versteckte Vertragsmigrationen.
- Lassen Sie einen verantwortlichen Prüfer über die normale Releasebereitschaft entscheiden. Dokumentieren Sie unvollständige Checks und nötige externe Verifikation ausdrücklich.
Der Pilot sollte eine absichtlich unangenehme Bedingung enthalten, etwa einen fremden fehlschlagenden Test oder fehlenden optionalen Dienst. Beobachten Sie, ob die Übergabe diese Grenze von echten Reparaturbelegen trennt. Ein Modell mit ehrlichen Prüflücken ist leichter integrierbar als eines, das Unsicherheit stets in Fertigmeldung verwandelt.
Ein mehrtägiger Agent sollte den Entscheidungsweg verkürzen
Carbons Ankündigung weist auf eine andere Erwartung an Programmier-KI: Sackgassen überstehen und eine prüfenswerte Reparatur liefern. Das umgebende Entwicklungssystem muss die Ausdauer nützlich machen. Klarer Umfang, gespeicherte Belege und begrenzte Befugnis schaffen eine sinnvoll abschließbare Aufgabe.
Wir erwarten, dass die stärksten Bewertungen der Übergabequalität gelten. Blieb die Ursprungsfrage erhalten? Wurde der tatsächliche Fehler erkannt? Kann ein Entwickler das Ergebnis verifizieren und den nächsten Schritt bestimmen? Diese Fragen verbinden lange Laufzeit mit praktischem Entwicklungsergebnis.
Länger laufende KI verspricht einen kürzeren Weg vom schwierigen Bericht zur begründeten Entscheidung. Arbeitszeit wird wertvoll, wenn die nächste Person dem Verbleibenden vertrauen kann.
Quellen
- Google: Einführung von Gemini 4 Carbon, 28. Oktober 2026; geprüft am 2. November 2026. Interne Beobachtungen und Benchmarks werden Google zugeschrieben.
- Google DeepMind: Gemini-Modellvergleich, geprüft am 2. November 2026. Benchmarkversionen und Bedingungen müssen bei den Werten bleiben.
Verbinden Sie Entwicklungsentscheidungen mit ihren Quellen
Telli.sh ist eine Möglichkeit, autorisiertes Quellenmaterial und die Notizen hinter einer Entwicklungsentscheidung aufzubewahren. Notizbereich anlegen.