Google avança na tradução ao vivo, OpenAI abre a voz full-duplex: o que fica depois da conversa?
O GPT-Live-1 chega à API por US$ 0,05 o minuto de voz, três meses depois da tradução de fala ao vivo do Google em 70 idiomas. O que os preços e benchmarks publicados medem, o que deixam de fora e por que atas, ideias compartilhadas e fontes salvas ganham importância à medida que conversar fica mais fácil.
Uma ilustração conceitual original. Uma conversa mais natural e um registro útil dessa conversa são objetivos de design complementares, e não estágios medidos do lançamento de um produto.
A possibilidade mais animadora dos novos anúncios de IA de voz é bem cotidiana: concluir um raciocínio no próprio idioma, esclarecê-lo no meio da fala e participar com naturalidade. Menos espera pela tradução e menos frases ensaiadas mentalmente antes de tomar a palavra. Sobra mais atenção para entender o que a outra pessoa quer dizer.
Google introduziu Gemini 3.5 Live Translate em 9 de junho de 2026. OpenAI introduziu seus modelos full-duplex GPT-Live em ChatGPT em 8 de julho e, em seguida, lançou GPT-Live-1 na API em 10 de setembro. interação falada contínua. O último anúncio do OpenAI amplia o acesso para desenvolvedores; não é a primeira aparição de GPT-Live. Anúncio de junho de Google, Introdução de julho de OpenAI, Lançamento da API de setembro de OpenAI.
Vejo esses avanços como um passo em direção a um cotidiano com menos barreiras linguísticas. Eles também tornam outra pergunta mais importante: quando conversar fica mais fácil, como preservar o que deu valor à conversa? Atas, ideias compartilhadas e fontes salvas fazem parte da resposta.
A voz full-duplex muda a espera durante uma conversa
Full-duplex significa que um sistema pode ouvir e falar ao mesmo tempo. OpenAI descreve GPT-Live-1 dessa forma em sua documentação de modelo atual, juntamente com a capacidade de delegar o raciocínio e o uso de ferramentas a um agente de back-end. Esta é uma afirmação sobre interação simultânea, não um certificado de tradução perfeita. Documentação do modelo GPT-Live-1, verificada em 11 de setembro de 2026.
Imagine corrigir um assistente enquanto ele explica um plano: “Na verdade, o cliente está em Madrid, não na Cidade do México”. Uma interface falada útil precisa perceber essa correção antes de continuar com a suposição errada. Também precisa distinguir uma correção de um breve reconhecimento, ou uma pausa para pensar de um convite para assumir o controle. A qualidade da troca depende desses pequenos julgamentos.
Interfaces de voz mais antigas muitas vezes tornavam sua estrutura de turnos visível. Você falou, esperou o processamento, ouviu e tentou novamente. O processamento mais rápido ajuda, mas uma interação ainda pode parecer estranha quando o sistema adivinha que você terminou muito cedo. O design full-duplex aborda a sobreposição em si, em vez de tratar cada momento da fala como uma mensagem bem fechada.
Já existe um sinal concreto, embora limitado, de por que isso é importante. OpenAI relata que a empresa de aprendizagem de idiomas Speak viu quase 80% menos interrupções durante as pausas para pensar dos alunos nas primeiras avaliações em comparação com os sistemas anteriores baseados em turnos. Esse é um resultado de parceiro relatado pelo fornecedor, e não uma descoberta independente para cada idioma ou configuração. Ele mede o comportamento de interrupção, e não uma melhoria de 80% na precisão da tradução. Relatório de lançamento da API de OpenAI, 10 de setembro de 2026.
Os números mais amplos da OpenAI apontam na mesma direção e têm o mesmo limite. Segundo a empresa, o GPT-Live-1 marca 30 pontos percentuais a mais que o GPT-Realtime-2.1 no Full Duplex Bench, um teste de pausas, alternância de turnos, interrupções e sinais breves de escuta. Combinado com o GPT-6 Astra em esforço de raciocínio médio, ele fica em primeiro lugar no Tau3, que avalia por Pass@1 tarefas faladas de atendimento ao cliente e de serviços bancários, incluindo 97 tarefas de conhecimento bancário. As duas são avaliações da própria OpenAI sobre comportamento conversacional e conclusão de tarefas; nenhuma é uma pontuação de precisão de tradução. Resumo das avaliações da OpenAI, 10 de setembro de 2026.
Para alguém que fala uma segunda língua, uma pausa para pensar pode ser exatamente onde a participação se torna difícil. Um assistente que espera adequadamente deixa espaço para encontrar uma palavra. Um assistente que aceita uma correção torna a tentativa menos dispendiosa. Essas são razões práticas para ficar entusiasmado com a interação de voz natural, além do quão impressionante uma demonstração soa.
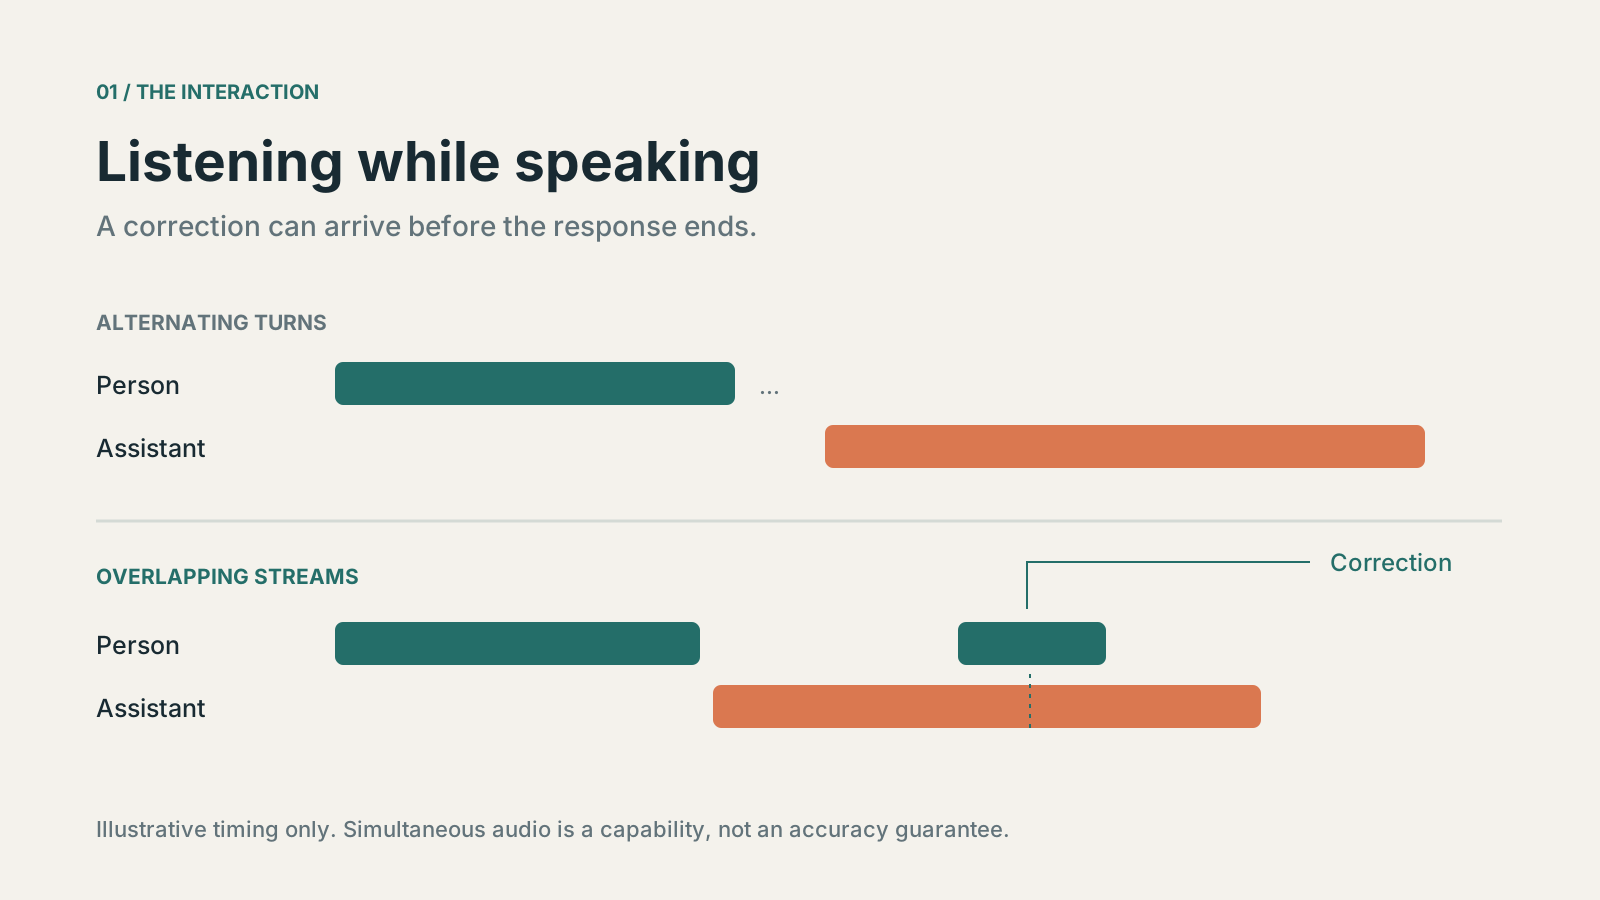
Apenas tempo conceitual; as barras não representam a latência medida. Full-duplex descreve entrada e saída simultâneas, enquanto o tratamento útil de interrupções ainda depende do modelo e da aplicação.
Tradução ao vivo e assistente de voz têm papéis diferentes
O anúncio de junho da Google descreve a tradução contínua de fala em mais de 70 idiomas. O modelo gera fala traduzida enquanto ouve, equilibrando a necessidade de mais contexto com a necessidade de permanecer perto do locutor. Google diz que permanece alguns segundos atrasado, o que é uma expectativa mais útil do que imaginar atraso zero. O lançamento do desenvolvedor foi uma prévia pública. Descrição de lançamento de Google, 9 de junho de 2026.
Os números de escala desse anúncio são específicos. A tradução de fala no Google Meet vai passar de cinco idiomas compatíveis para mais de 70, e de traduzir apenas de e para o inglês para mais de 2.000 combinações de idiomas em uma mesma reunião. O recurso começa como prévia privada para clientes empresariais selecionados do Workspace, com uma distribuição mais ampla ainda em 2026. A Grab está testando o modelo nos encontros de embarque entre motoristas e passageiros, um caso de uso com mais de 10 milhões de chamadas de voz por mês. O anúncio cita elogios de parceiros à qualidade, à precisão e à baixa latência, sem publicar nenhuma pontuação numérica. Números do lançamento do Google, 9 de junho de 2026.
Há uma distinção que vale a pena manter visível. O guia de tradução ao vivo do Google descreve um intérprete que processa um fluxo de áudio continuamente, com configurações específicas de tradução e sem suporte para ferramentas ou instruções gerais. GPT-Live-1 é um modelo conversacional que pode funcionar com um agente separado. Um ajuda a transportar o significado do falante para outro idioma; o outro participa da troca. Não devem ser apresentados como serviços intercambiáveis. Guia de tradução ao vivo de Google, documentação do modelo de OpenAI, verificado em 11 de setembro de 2026.
| Marco | O que foi anunciado | O que não estabelece |
|---|---|---|
| Google, 9 de junho de 2026 | Gemini 3.5 Live Translate; tradução contínua de fala; visualização pública do desenvolvedor | Qualidade igual para todos os pares de idiomas ou acesso imediato em todos os produtos Google |
| OpenAI, 8 de julho de 2026 | Implementação de GPT-Live em ChatGPT, com audição e fala simultâneas | Precisão universal em nível de intérprete |
| OpenAI, 10 de setembro de 2026 | Acesso à API GPT-Live-1 para construção de aplicativos de voz | Integração automática em todas as reuniões ou serviços de anotações |
O escopo do lançamento vem dos três anúncios vinculados acima. Esta é uma linha do tempo, não uma classificação de desempenho.
Tomados em conjunto, estes desenvolvimentos tornam visível uma direção convincente: a tradução pode tornar-se mais contínua e a interação com um assistente pode tornar-se menos rígida. Conectar esses recursos a uma experiência de reunião multilíngue confiável continua sendo um trabalho de aplicação. Alguém ainda precisa decidir de quem é o áudio que está sendo interpretado, para onde vai o resultado, como as correções são tratadas e o que os participantes veem.
Os números publicados: US$ 0,05 por minuto e nenhuma pontuação de precisão
Um minuto de voz do GPT-Live-1 custa US$ 0,05 na API, cobrado por segundo, sem arredondar para o minuto inteiro. Esse preço cobre apenas a camada de voz do front-end; o modelo de back-end e as ferramentas para os quais a sessão delega trabalho são cobrados à parte, pelas tarifas normais. Documentação do modelo da OpenAI, verificada em 11 de setembro de 2026.
A conta é fácil de fazer e fácil de interpretar mal. Uma sessão de 30 minutos custa US$ 1,50 em tempo de camada de voz, uma hora custa US$ 3,00 e 100 horas por mês chegam a US$ 300, antes de qualquer raciocínio no back-end. Um aplicativo que abre uma sessão separada para cada participante da reunião multiplica esses valores pelo número de sessões. O anúncio de junho do Google não informa preço para o Gemini 3.5 Live Translate, por isso este texto não compara os dois em custo.
| Dado | Valor | Fonte e data | O que mede |
|---|---|---|---|
| Preço do GPT-Live-1 na API | US$ 0,05 por minuto, cobrado por segundo | OpenAI, 10 de setembro de 2026 | Só a camada de voz; modelo de back-end e ferramentas cobrados à parte |
| Full Duplex Bench | +30 pontos percentuais em relação ao GPT-Realtime-2.1 | OpenAI, 10 de setembro de 2026 | Pausas, alternância de turnos e interrupções, não tradução |
| Tau3 | Primeiro lugar, com GPT-6 Astra (esforço médio) | OpenAI, 10 de setembro de 2026 | Sucesso em tarefas faladas (Pass@1), incluindo 97 tarefas bancárias |
| Avaliação inicial da Speak | Quase 80% menos interrupções nas pausas para pensar | OpenAI (citação de parceiro), 10 de setembro de 2026 | Comportamento de interrupção em comparação com sistemas anteriores baseados em turnos |
| Uso de voz no ChatGPT | Mais de 150 milhões de pessoas por semana | OpenAI, 8 de julho de 2026 | Uso de Voz e Ditado, não qualidade |
| Gemini 3.5 Live Translate | 70+ idiomas, detectados automaticamente | Google, 9 de junho de 2026 | Cobertura, não qualidade por par de idiomas |
| Tradução de fala no Google Meet | 5 → 70+ idiomas; 2.000+ combinações por reunião | Google, 9 de junho de 2026 | Atualização planejada, começando por prévia privada |
| Atraso da tradução | “Apenas alguns segundos atrás de quem fala” | Google, 9 de junho de 2026 | Descrição do fornecedor, não um valor medido |
Todos os dados são informados pelos próprios fornecedores e vêm dos anúncios e documentações citados neste texto. Nenhum deles é uma pontuação numérica de precisão de tradução, como uma avaliação humana ou uma métrica automática para um par de idiomas.
Essa lacuna pesa mais para quem está escolhendo uma ferramenta para reuniões multilíngues. Benchmarks de interação mostram se um sistema espera, escuta e se recupera bem; não mostram se a “segunda-feira” chegou intacta ao coreano. A ressalva de julho da OpenAI sobre sotaques não nativos em alguns idiomas e a ausência de pontuações por par de idiomas por parte do Google levam à mesma regra prática: teste os pares de idiomas que sua equipe realmente usa antes de confiar em qualquer um deles para tomar decisões.
Reduzir a barreira do idioma começa por facilitar a participação
Considere uma hipotética reunião de projeto de 30 minutos com quatro pessoas que se sintam mais confortáveis em três idiomas diferentes. O benefício de uma melhor tradução falada não é apenas que cada pessoa ouça mais palavras. É que o grupo pode fazer perguntas complementares antes que uma incerteza se torne um mal-entendido. Uma ideia experimental pode ser expressa sem primeiro ser polida em uma segunda língua.
Isso muda a economia da participação num sentido muito comum: contribuir exige menos esforço. A pessoa quieta e com experiência relevante tem outra forma de entrar na discussão. A pessoa que lidera a reunião pode gastar menos tempo reconstruindo uma frase interrompida. Um esclarecimento pode acontecer quando for útil, enquanto todos ainda se lembram do ponto que está sendo discutido.
Espero que isso seja importante em equipes remotas, discussões em sala de aula, conversas com clientes e trocas informais durante viagens. Estas são expectativas sobre onde a tecnologia pode ajudar, e não afirmações de que a mesma experiência já está disponível para todos. O par de idiomas, o sotaque, o vocabulário, a qualidade do microfone e o produto ao redor continuam fazendo parte do resultado.
Uma voz natural deve ser avaliada separadamente da precisão do significado. Na apresentação de julho, a OpenAI mencionou sotaques não nativos e limitações de fluência em alguns idiomas. Por isso, é preciso avaliar os idiomas realmente usados, sem generalizar a partir de uma boa demonstração em inglês. Era uma ressalva do lançamento, não uma avaliação atual de todas as implementações de setembro. Introdução ao GPT-Live e advertência de idioma de OpenAI, 8 de julho de 2026
A ambição certa é uma participação mais ampla com uma forma fácil de esclarecer. Uma data, um valor, o nome de uma pessoa ou uma promessa condicional devem permanecer fáceis de verificar. Um sistema pode parecer confiante enquanto um participante ainda precisa dizer: “Por favor, mostre-me essa frase”. Mostrar o texto e reter o original, onde os participantes concordaram em gravar, dá a esse pedido um lugar para onde ir.
Uma reunião fluida também precisa registrar suas decisões
Voltemos à reunião hipotética. Alguém propõe publicar na sexta-feira se a revisão de segurança estiver concluída. Outra pessoa prefere segunda-feira para dar mais tempo de preparação à equipe de suporte. O grupo escolhe segunda e define um responsável, mas um pré-requisito continua pendente. Um resumo que registra apenas a sexta-feira proposta no início perde a decisão da reunião.
Nenhuma melhoria no ritmo de conversação elimina a diferença entre uma sugestão, uma condição e uma decisão. As pessoas que trabalham na mesma língua já precisam distingui-las. A interacção multilingue torna mais valioso preservar o caminho desde a declaração original até ao texto traduzido e à acção final acordada.
Para um registro prático da reunião, gostaria que um leitor que perdeu a chamada descobrisse rapidamente três coisas: o que o grupo decidiu, quem é responsável pela próxima etapa e quais questões permanecem em aberto. Um prazo deve ser descrito como acordado somente quando for acordado. Se a fonte não for clara, o registo deve levar essa incerteza adiante em vez de a transformar numa conclusão falsa.
Isso não exige transformar cada conversa em um arquivo exaustivo. Uma breve nota de decisão pode ser mais útil do que páginas de transcrição indiferenciada. A relação importante é entre o relato conciso e o material de apoio: o texto original relevante, a gravação quando disponível e autorizada, e o documento que o grupo estava discutindo.
Essa ligação também facilita corrigir erros. Um participante pode indicar a frase original, ajustar o resumo e compartilhar a decisão corrigida. Sem esse vínculo, a próxima pessoa pode resumir o resumo e transformar o mal-entendido inicial em um fato aparentemente confirmado. Uma interação de voz melhor facilita a conversa; bons registros permitem conferir seu resultado depois.
Ideias compartilhadas precisam das suas fontes
Uma ideia útil raramente começa e termina dentro de uma ligação. Alguém encontra um artigo, salva um trecho, faz uma pergunta sobre ele e leva a questão para uma reunião. Outra pessoa adiciona um contraexemplo de um vídeo ou artigo de pesquisa. A próxima etapa depende de ser capaz de reconectar essas peças após o término da conversa.
É por isso que salvar fontes da web continua útil, mesmo com uma excelente IA de voz. A URL permite voltar ao original, o trecho selecionado identifica o que importa e uma nota pessoal explica por que aquilo foi salvo. São informações com funções diferentes. Juntas, ajudam a compartilhar uma ideia melhor do que um parágrafo isolado gerado por IA.
“Precisamos mudar a experiência inicial dos novos usuários” oferece pouco contexto a quem vai retomar o assunto. “Este artigo levantou uma dúvida sobre os primeiros cinco minutos; aqui estão o trecho, nossa discussão e o experimento combinado” fornece uma base para análise. O exemplo é hipotético, mas a diferença é concreta: só a conclusão pede confiança; o raciocínio e a fonte permitem continuar a conversa.
A mesma disciplina protege a fonte de ser confundida com comentários. Uma citação deve permanecer identificável como uma citação. Uma tradução é uma interpretação dessa fonte, e um resumo de reunião é outra visão derivada. Manter esses papéis visíveis permite que as pessoas discordem de forma produtiva, sem primeiro ter que reconstruir o que alguém disse originalmente.
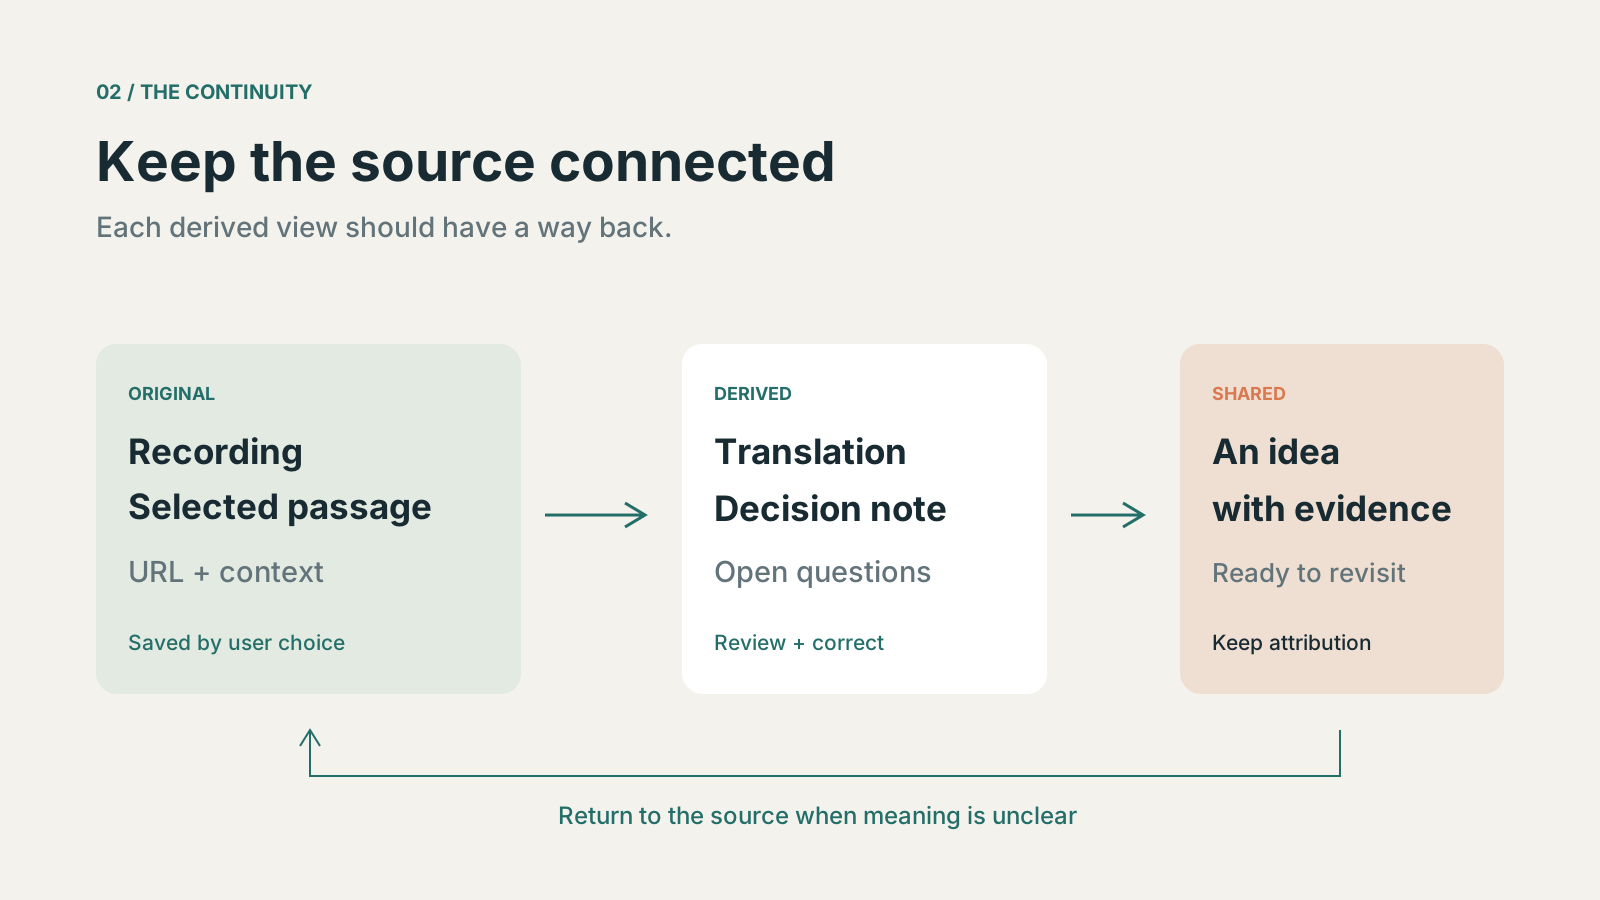
Um fluxo de trabalho proposto original. Preserve o material de origem autorizado, torne o texto derivado corrigível e mantenha a conexão visível ao compartilhar. O diagrama não afirma que todo link seja um recurso automatizado hoje.
O contexto precisa continuar acessível depois da chamada
Os sistemas de voz também estão começando a separar a conversa do trabalho que acontece por trás dela. A documentação de delegação do OpenAI explica que a fala ao vivo e o trabalho delegado podem continuar de forma independente; uma resposta de backend completa não estabelece que o usuário ouviu a resposta. Este é um lembrete útil de engenharia sobre um problema mais amplo do produto: uma experiência falada e um resultado duradouro são coisas distintas a serem verificadas. Documentação de delegação de OpenAI, verificada em 11 de setembro de 2026.
Para usuários comuns, a questão é mais simples. Quando uma chamada terminar, posso encontrar a decisão amanhã? Um colega pode entender por que fizemos isso? Posso voltar ao artigo que desafiou nossa suposição, sem pesquisar no histórico de bate-papo, no navegador e na gravação? Essas questões permanecem mesmo que cada frase seja interpretada lindamente.
Há motivos para estarmos otimistas quanto à possibilidade de as barreiras linguísticas se tornarem menos dominantes. Deveríamos acolher ferramentas que permitam que mais pessoas contribuam confortavelmente. Minha expectativa é que uma conversa mais fácil aumente o valor de conectar o que dizemos com o que guardamos, compartilhamos e, eventualmente, fazemos. A reunião não precisa durar para sempre; seu resultado útil deverá sobreviver à chamada.
A direção que queremos dar ao Telli.sh
Para o Telli.sh, essa é a direção: transformar conversas e descobertas em conhecimento que as pessoas possam recuperar e usar. Hoje o produto reúne notas, gravações, traduções e Clips em um só espaço. Queremos fortalecer a ligação entre esses materiais para que a ata, a ideia e sua fonte não voltem a ficar espalhadas.
Queremos um fluxo contínuo: registrar uma conversa com a autorização necessária, revisar seus pontos importantes, deixar claras as decisões e compartilhar uma ideia junto das referências que a sustentam. Se o debate começa em uma página, o Clip deve ajudar a preservar a URL e o contexto escolhido pelo usuário. Se uma tradução ajuda na compreensão, o original deve continuar disponível para comparação e correção.
Esta é uma direção de produto, não o anúncio de que o Telli.sh já integrou GPT-Live-1 ou Gemini 3.5 Live Translate. As futuras funções de voz deverão oferecer utilidade real entre idiomas, registros confiáveis e controle claro sobre o que é salvo. Queremos que os avanços dos modelos melhorem o espaço de trabalho sem fazer o conhecimento de uma pessoa depender de um único modelo.
Quanto mais fácil for conversar entre idiomas, mais queremos ajudar a preservar o valor dessas trocas. Comece por uma reunião para lembrar, uma ideia para compartilhar ou uma fonte que você vai precisar consultar de novo.